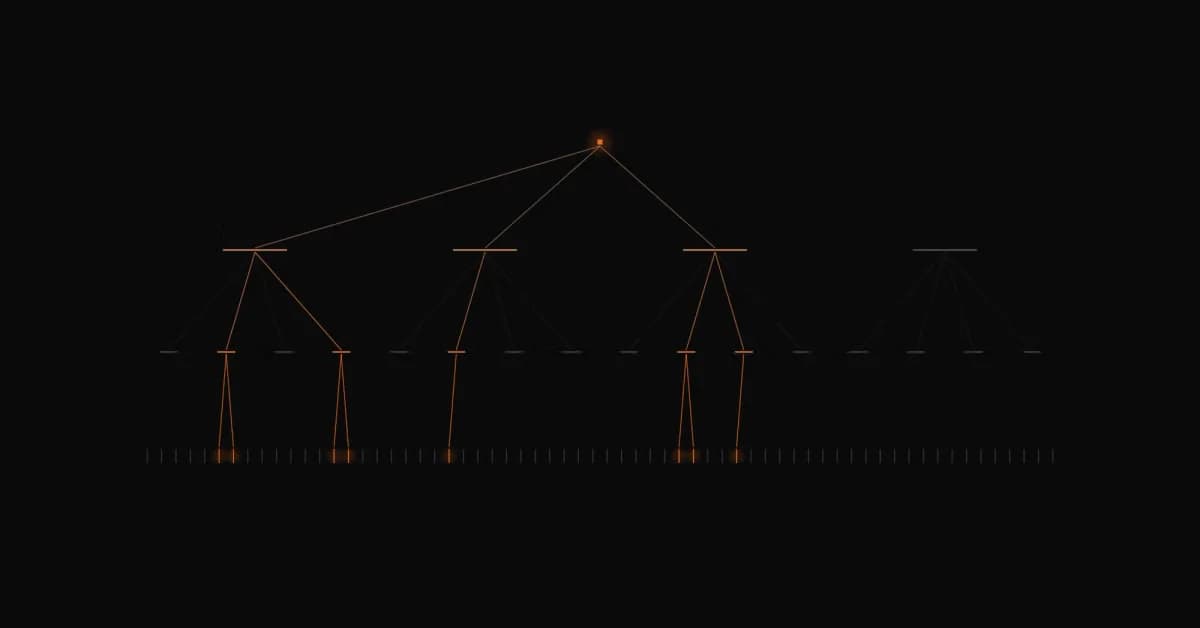
Мы представляем иерархическое внимание Zyphra (ZHA) — метод разреженного внимания, который строит иерархическое дерево и выполняет поиск по нему для определения релевантного набора токенов для каждого запроса. ZHA достигает субквадратичной сложности при подходящем выборе пороговых значений top-p для маршрутизации, превосходя существующие методы разреженного внимания, в которых используется квадратичный индексатор. Мы демонстрируем, что можем адаптировать существующие предобученные модели к ZHA посредством фазы дистилляции с использованием всего нескольких миллиардов токенов, и что ZHA сохраняет производительность на сложных бенчмарках рассуждений на длинных контекстах, агентного программирования и извлечения данных при высоких уровнях разреженности. Наша модель производительности показывает, что ZHA драматически превосходит методы разреженного внимания по скорости и вычислительным затратам на сверхдлинных контекстах.
Почему эффективное внимание — это так сложно?
Одно из самых замечательных свойств трансформеров — их способность извлекать информацию из любого места в последовательности.
Когда языковая модель генерирует следующий токен, механизм внимания позволяет ей оглянуться на все, что было до этого, и решить, какие фрагменты информации имеют значение. Например, модели для работы с кодом может потребоваться извлечь определение функции из тысяч строк назад, в то время как модели для рассуждений может потребоваться вернуться к промежуточному выводу из длинной цепочки мыслей.
Крайне важно, что модели не нужно заранее решать, какая именно информация будет важна. Каждый новый запрос может независимо извлекать те части контекста, которые ему необходимы.
Эта гибкость чрезвычайно мощна, но она также и стоит дорого.
В стандартном внимании каждый токен сравнивается с каждым предшествующим токеном. Это приводит к квадратичной сложности. Удвоение длины контекста поэтому увеличивает общие вычисления внимания примерно в четыре раза. Во время генерации каждый дополнительный токен также требует чтения все возрастающего кэша ключей-значений (KV-кэша), содержащего представления предшествующего контекста модели.
По мере того как мы продвигаемся к контекстам в десятки миллионов токенов, вычислительные затраты быстро становятся непомерно высокими.
Поэтому значительный объем исследований был сосредоточен на повышении эффективности внимания. Тем не менее, существующие подходы обычно делятся на две широкие категории, каждая из которых имеет существенное ограничение.
Первый подход заключается в сжатии прошлого в состояние фиксированного размера.
Модели пространства состояний (SSM), варианты линейного внимания и механизмы внимания на основе скользящего окна могут достигать высокоэффективного масштабирования за счет поддержания ограниченного представления предшествующей последовательности. Проблема заключается в том, что объем потенциально полезной информации в последовательности не перестает расти.
Представьте, что вы читаете все возрастающую коллекцию книг, имея при этом возможность вести лишь фиксированное число заметок. Поначалу ваши заметки могут отражать большую часть того, что имеет значение. Но в конечном итоге новая информация должна будет перезаписать более старую информацию или вступить с ней в конфликт, независимо от того, насколько полезной эта информация может оказаться впоследствии.
Второй подход — разреженное внимание.
Методы разреженного внимания сохраняют способность извлекать произвольную информацию путем выбора небольшого подмножества KV-кэша для каждого запроса. Вместо того чтобы вычислять внимание ко всему предшествующему токену, модель может обращать внимание только на наиболее релевантный 1%.
Однако здесь есть подвох: как модель определяет, какой именно 1% токенов является релевантным?
Многие подходы разреженного внимания используют легковесный индексатор, который оценивает каждый предшествующий токен, чтобы определить подмножество, заслуживающее извлечения. Хотя финальная операция внимания является разреженной, сам индексатор все равно должен выполнять поиск по всему контексту. Это фактически переносит квадратичные вычисления из механизма внимания в индексатор. Удешевление индексатора может дать значительные улучшения с постоянным множителем, но фундаментальная проблема масштабирования остается.
Некоторые методы решают эту проблему путем индексирования сжатых блоков, а не отдельных токенов. Тем не менее, поиск по каждому блоку с единым разрешением все равно требует работы, которая растет линейно с ростом контекста, что опять же дает лишь улучшение с постоянным множителем в асимптотическом масштабировании.
Эти ограничения предполагают, что эффективная замена внимания должна одновременно обладать двумя свойствами.
Во-первых, извлечение должно зависеть от запроса. Разные вопросы требуют разной информации, поэтому мы не можем просто отбросить фиксированный набор якобы неважных токенов.
Во-вторых, объем активно извлекаемой информации должен иметь возможность расти с ростом длины контекста, но медленнее, чем сам контекст. Память фиксированного размера в конечном итоге станет недостаточной, в то время как линейно растущая активная память возвращает нас к квадратичному вниманию.
Наша работа исходит из наблюдения, что естественный язык, по-видимому, обладает именно этим свойством. Когда мы изучаем распределения внимания в предобученных LLM, мы обнаруживаем, что количество токенов, на которые приходится фиксированная доля вероятности внимания, имеет тенденцию расти сублинейно с ростом длины последовательности. В наших экспериментах с длинной художественной прозой эта зависимость часто хорошо описывается степенным законом.
Другими словами, по мере того как документ становится длиннее, объем информации, которую модели необходимо извлечь, растет, но он необязательно растет так же быстро, как сам документ. Это открывает важную возможность: возможно, мы сможем сохранить гибкость внимания, не платя за это стоимостью поиска по каждому токену.
Иерархическое внимание: поиск по контексту с помощью дерева
Ключевая идея, лежащая в основе ZHA, заключается в том, что поиск релевантной информации не должен требовать изучения каждого фрагмента информации по отдельности.
Рассмотрите поиск определенного отрывка в очень большой книге. Вы бы вряд ли стали читать каждое предложение, чтобы определить, где искать. Вместо этого вы бы начали с оглавления, определили перспективную главу, просмотрели ее разделы и, наконец, нашли нужный абзац.
Такова базовая интуиция, лежащая в основе иерархического внимания. Вместо того чтобы поддерживать плоский индекс по всем предшествующим токенам, ZHA строит дерево все более сжатых представлений KV-кэша.
Построение дерева
На самом низком уровне мы начинаем с исходных ключей из KV-кэша модели.
Мы делим эти ключи на непрерывные группы, или блоки, и конструируем сжатое представление каждой группы. Затем мы группируем эти сводки вместе и снова сжимаем их, повторяя этот процесс рекурсивно для построения более высоких уровней дерева.
Например, при размере блока, равном четырем, один уровень суммирует четыре исходных ключа, два уровня суммируют 16 ключей, а шесть уровней могут суммировать области размером в 4096 токенов.
В результате получается иерархия, в которой самые высокие уровни описывают большие области контекста, в то время как более низкие уровни обеспечивают прогрессивно более высокую детализацию.
Важной задачей является сделать эти сводки полезными для извлечения информации.
Простое усреднение ключей в блоке привело бы к потере большей части информации, необходимой для определения того, релевантен ли этот блок конкретному запросу. Различные запросы могут касаться совершенно разных аспектов одного и того же блока.
Вместо этого ZHA строит резюме с использованием небольшого набора обученных эталонных запросов. Каждый эталонный запрос предоставляет свой способ анализа ключей в блоке. Эти эталонные запросы позволяют ZHA приближенно оценить, сколько общего внимания будущий запрос уделит этому блоку.
Интуитивно понятным образом, вместо того чтобы заставлять резюме представлять всё внутри определенной области, мы обучаем его отвечать на гораздо более конкретный вопрос:
Насколько эта область будет релевантна запросу, на который я в данный момент пытаюсь ответить?
Затем эти резюме рекурсивно объединяются для построения более высоких уровней дерева, в то время как исходный кэш KV сохраняется. ZHA сжимает ключи с целью поиска, а не заменяет навсегда ту информацию, которая может понадобиться для извлечения позже.
Маршрутизация по дереву
После построения дерева извлечение информации превращается в поиск от грубого к точниму.
Когда поступает новый запрос, ZHA сначала сравнивает его с резюме на самом верхнем уровне дерева. Вместо того чтобы изучать все токена, представленные этими резюме, модель определяет, какие области кажутся наиболее релевантными, и разворачивает только их. На следующем уровне этот процесс повторяется: запрос сравнивается с более детализированными резюме внутри выбранных областей. Это продолжается до тех пор, пока поиск не дойдет до исходных элементов KV, после чего модель выполняет обычное внимание над выбранным подмножеством.
Важно отметить, что ZHA не просто следует по одной ветке дерева. Модель может разворачивать несколько веток, расположенных в любых частях контекста, что позволяет ей извлекать информацию из далеко отстоящих друг от друга областей. Решение о том, какие ветки разворачивать, принимается с помощью механизма, называемого top-p маршрутизацией. Вместо выбора фиксированного числа узлов, top-p выбирает наименьшую группу узлов, на которую приходится заданная доля предполагаемой вероятности внимания.
Благодаря этому объем извлечения адаптируется под конкретный запрос. Если запрос ищет один конкретный факт, распределение внимания может быть сильно сконцентрированным, и ZHA исследует лишь несколько веток. Если запрос требует синтеза информации из множества разных частей контекста, распределение внимания может быть более размытым, и ZHA развернет значительно больше веток.
Адаптивное извлечение имеет решающее значение. При фиксированном бюджете top-k мы сталкиваемся со строгим компромиссом между необходимостью иметь достаточно большой k для ответа на размытые запросы и пустой тратой вычислительных ресурсов, когда требуется лишь небольшое высокосконцентрированное подмножество. Top-p, в свою очередь, позволяет объему вычислений естественным образом адаптироваться к задаче.
Как это обеспечивает субквадратичное масштабирование?
Самое главное преимущество иерархического индекса заключается в том, что нам больше не нужно искать по всему индексу с одинаковым разрешением. На каждом уровне крупные области контекста могут быть исключены из рассмотрения без анализа их содержимого по отдельности. При условии, что количество исследуемых областей растет сублинейно по отношению к длине контекста, как вычисления маршрутизации, так и финальные вычисления внимания могут оставаться сублинейными для каждого запроса. Это кардинально отличается от методов разреженного внимания, которым по-прежнему необходимо сканировать плоский индекс по всему контексту. Древовидная структура делает сам процесс поиска релевантных токенов разреженным.
Это также кардинально отличается от состояния фиксированного размера. ZHA не накладывает фиксированного верхнего предела на объем информации, которую можно сохранить или извлечь. Активное состояние может продолжать расти вместе с контекстом, оставаясь при этом существенно меньше полной последовательности. Более того, полный кэш KV поддерживается на уровне листьев дерева, так что исходные ключи и значения остаются доступными для извлечения.
Дистилляция ZHA в предобученные модели
Особенно привлекательное свойство ZHA заключается в том, что она не требует обучения новой языковой модели с нуля. Вместо этого мы можем взять существующий предобученный трансформер и обучить легковесный иерархический индексатор приближать его исходное плотное поведение внимания.
Мы делаем это с помощью короткой фазы KL-дистилляции. Исходная модель остается замороженной на протяжении всего обучения. Мы наблюдаем, как ее плотное внимание распределяет вероятность по различным областям контекста, и обучаем эталонные запросы ZHA воспроизводить эти вероятности на каждом уровне дерева.
По сути, предобученная модель учит индексатор искать в собственной памяти. Поскольку единственными обучаемыми компонентами являются эталонные запросы, количество дополнительных параметров чрезвычайно мало. Для наших экспериментов с Qwen3.6-35B-A3B ZHA добавляет всего 81 920 обучаемых параметров, что составляет приблизительно 0,00024% от количества параметров базовой модели.
Мы обнаруживаем, что обучения всего на нескольких миллиардах токенов при длине контекста 32K достаточно для получения высокой производительности, включая оценки на гораздо более длинных контекстах. Это особенно важно, поскольку означает, что иерархическое внимание потенциально может быть развернуто поверх существующих мощных моделей без повторения их дорогостоящего процесса предобучения и без изменения весов, отвечающих за их способности к рассуждению и языку.
Сохраняется ли качество модели при использовании ZHA?
Эффективные методы внимания часто оценивались главным образом на относительно простых задачах извлечения, таких как поиск одного скрытого факта в длинном документе. Однако эти бенчмарки не полностью отражают требования, предъявляемые к современным моделям рассуждений.
Задача рассуждения или написания кода с длинным контекстом может требовать многократного возвращения к разным частям контекста, объединения информации из множества мест и поддержания согласованности на протяжении десятков тысяч сгенерированных токенов.
Поэтому мы оцениваем ZHA на гораздо более широком и сложном наборе задач, включающем математические рассуждения AIME 2026, MMLU-Pro, GPQA Diamond, SWE-bench Verified, Terminal-Bench 2.1, RULER и LongBench v2.
Мы сравниваем исходную плотную модель с двумя конфигурациями ZHA: широким одноуровневым деревом и глубоким шестиуровневым деревом.
Результаты обнадеживают.
На бенчмарке RULER-13 при 256K токенах наша модель ZHA с широким деревом достигает точности 96,2% по сравнению с 96,0% у исходной плотной модели. Гораздо более глубокое шестиуровневое дерево достигает 93,3%, несмотря на то, что задействует лишь малую часть исходного кэша KV.
На LongBench v2 модель с глубоким деревом набирает 63,4% по сравнению с 58,0% для плотного внимания, при этом во время декодирования задействуется примерно 1,1% кэша KV.
А на SWE-bench Verified, требовательном бенчмарке агентного программирования, включающем реальные задачи программной инженерии, ZHA достигает производительности, сопоставимой с плотным базовым уровнем: 67,4% для глубокого дерева и 68,4% для широкого дерева по сравнению с 67,4% для плотного внимания.
Мы также проводим сравнение с MiniMax Sparse Attention (MSA), в котором используется фиксированное число блоков, выбранных обученным индексатором. Индексатор MSA прошел только фазу KL-разогрева на 40 млрд токенов в соответствии с процедурой обучения, описанной в статье по MSA.
Хотя MSA сохраняет конкурентоспособность на нескольких бенчмарках рассуждений, она демонстрирует значительно большую деградацию при извлечении информации из длинного контекста. Например, на RULER-13 MSA достигает 77,1% по сравнению с 93,3% и 96,2% для наших конфигураций глубокого и широкого ZHA.
На LongBench v2 наш глубокий маршрутизатор превосходит MSA примерно на 12,7 процентных пункта при сопоставимой доле обслуживаемых ключей внимания, несмотря на то, что для индексатора требуется в десять раз меньше токенов обучения.
Эти результаты особенно значимы, поскольку они демонстрируют, что иерархическая маршрутизация позволяет сохранить производительность на задачах, требующих гораздо большего, чем просто извлечение одного изолированного факта.
Мы также тестируем ZHA на модели Nemotron-3.5-Lightning-30B-A3B, которая не использует позиционное кодирование (NoPE) в своих слоях внимания. Метод продолжает отлично работать на задачах рассуждений и агентного программирования, хотя производительность извлечения на RULER снижается более заметно, что согласуется с результатами других работ по разреженной адаптации внимания NoPE.
В целом наши эксперименты показывают, что иерархическое внимание способно сохранить большую часть выразительной силы плотного внимания, избегая при этом необходимости обрабатывать бо́льшую часть контекста.
Устойчивость к геометрии дерева и потенциал для драматического ускорения
Естественное опасение при использовании иерархического внимания заключается в том, что само дерево может создать новое узкое место. Если информация должна проходить через несколько уровней сжатия, не станут ли все более глубокие деревья менее точными?
Это важнейший вопрос, поскольку подквадратичное масштабирование ZHA в конечном итоге зависит от нашей способности увеличивать глубину дерева по мере роста длины контекста. Чтобы исследовать это, мы обучаем и оцениваем 28 различных конфигураций дерева, варьируя количество ссылочных запросов, количество токенов, представленных каждым блоком, и глубину дерева.
Примечательно, что мы обнаруживаем высокую устойчивость ZHA в широком диапазоне этих параметров. При умеренных уровнях разреженности производительность извлечения схожа для самых разных конфигураций дерева. Более удивительно то, что при фиксированном общем коэффициенте сжатия более глубокие деревья часто работают лучше, чем более мелкие, при том же уровне разреженности.
Это предполагает, что последовательное уточнение поиска через несколько уровней абстракции может быть эффективнее, чем принятие одного агрессивного решения о сжатии.
Насколько быстрым может стать ZHA?
Сокращение числа токенов с вниманием — это лишь часть картины производительности.
Фактическая производительность графического процессора также зависит от стоимости построения дерева, маршрутизации по его различным уровням, выбора узлов и, наконец, выполнения внимания над извлеченными токенами. Чтобы изучить эти затраты, мы разрабатываем подробную модель производительности GPU по аналогии с методом roofline, учитывающую вычисления, пропускную способность памяти, накладные расходы на запуск ядра и аппаратный параллелизм.
Мы используем эту модель для сравнения прогнозируемой производительности ZHA с плотным вниманием и репрезентативным методом разреженного внимания с квадратичным индексатором.
Результаты показывают, почему изменение асимптотического масштабирования имеет значение. Для легковесной конфигурации ZHA наша модель предсказывает, что иерархическое внимание становится быстрее плотного примерно при 48 тыс. токенов и быстрее MSA примерно при 480 тыс. токенов.
За пределами этих точек пересечения преимущество продолжает расти по мере увеличения контекста. При длине контекста в десять миллионов токенов модель прогнозирует ускорение примерно в 32–35 раз по сравнению с плотным вниманием и в 4,7–5,1 раза по сравнению с MSA. При одном миллиарде токенов эти прогнозируемые ускорения достигают примерно 373–417 раз и 52–58 раз соответственно.
При достаточно длинном контексте даже очень большие улучшения с постоянным множителем становятся менее важными, чем полное избежание квадратичного масштабирования.
Узкий путь к поистине сверхдлинным контекстам
Помимо непосредственной архитектуры и результатов экспериментов, наша работа поднимает более фундаментальный вопрос:
Что на самом деле требуется от языковой модели для эффективного использования произвольно длинного контекста?
Возникает искушение рассматривать масштабирование длинного контекста исключительно как вычислительную проблему. Если бы мы смогли сделать плотное внимание достаточно быстрым и недорогим, возможно, мы могли бы просто продолжать бесконечно расширять контекстное окно.
Однако наш анализ показывает, что ситуация может быть более сложной. Чтобы понять почему, полезно рассмотреть два противоположных режима сбоя.
Внимание становится слишком рассредоточенным
По мере роста контекста плотное внимание должно сопоставлять запрос с возрастающим числом токенов. Но не все эти токены содержат полезную предсказательную информацию. По мере добавления все большего числа нерелевантных или слабо релевантных токенов их совокупный вклад в распределение внимания может становиться все более значительным.
Предыдущие работы предполагали, что softmax-внимание может становиться дисперсным при больших длинах последовательностей: вероятность распределяется по все большему числу отвлекающих факторов, потенциально затмевая информацию, которая действительно имеет значение.
Другими словами, даже если бы мы могли позволить себе вычислить плотное внимание на огромном контексте, это не обязательно гарантировало бы, что модель сможет извлечь из него правильную информацию.
Это предполагает, что разреженность может быть полезна не только для вычислительной эффективности. Отфильтровывая нерелевантные части прошлого, разреженное внимание может действовать как форма шумоподавления, позволяя модели точнее сосредоточиться на важной информации.
Внимание становится слишком разреженным
Однако излишнее разреживание внимания порождает противоположную проблему.
Если модель извлекает слишком мало информации, в конечном итоге она отбросит полезный контекст. Это особенно актуально для иерархического внимания, поскольку разреженность накапливается по мере спуска по дереву.
Предположим, мы сохраняем фиксированную долю вероятности внимания на каждом уровне. По мере добавления новых уровней доля исходной массы внимания, сохраняемая после полного прохождения, может постепенно уменьшаться до нуля.
В пределе это может привести к тому, что активное состояние извлечения фактически сожмется до фиксированного размера.
Тогда мы воссоздадим то же фундаментальное ограничение, что и в архитектурах с фиксированным состоянием: модель больше не сможет сохранять возрастающий объем релевантной информации по мере роста последовательности.
Можно попытаться решить эту проблему, проявляя все большую консервативность на каждом уровне и сохраняя почти всю вероятность внимания по мере углубления дерева. Но это ведет к противоположной проблеме. Если верхние уровни дерева сохраняют почти каждую ветвь, иерархия перестает обеспечивать значимое прореживание, а вычислительные затраты приближаются к затратам на плотное внимание.
Таким образом, мы сталкиваемся с узким путем между двумя нежелательными крайностями:
Слишком мало разреженности — и внимание становится непосильным в вычислительном отношении и потенциально подавляется нерелевантной информацией. Слишком много разреженности — и информация, необходимая модели для рассуждений, теряется.
Согласование сжатия с предсказательной информацией в данных
Мы считаем, что выход из этого компромисса заключается в понимании того, что надлежащая степень сжатия должна определяться статистической структурой самой последовательности.
Длинная последовательность на естественном языке содержит значительную избыточность. Миллионный токен все еще может нести полезную новую информацию, но объем дополнительной предсказательной информации, которую он вносит, может оказаться значительно меньше, чем у более ранних токенов.
Таким образом, общий объем релевантной информации может продолжать расти без необходимости линейного роста вместе с общей длиной последовательности. Это тот режим работы, к которому мы в конечном итоге стремимся:
- Активное состояние продолжает расти, предотвращая информационное «бутылочное горлышко» памяти фиксированного размера.
- Оно растет сублинейно, позволяя избежать непомерно высокой стоимости плотного внимания.
- Поиск остается зависящим от запроса, поэтому разные вопросы могут обращаться к разным частям всей истории.
Достижение этого режима асимптотически потребует более сложного контроля разреженности, чем просто применение фиксированного порога top-p на каждом уровне дерева. В частности, порог маршрутизации должен изменяться в зависимости от глубины дерева и длины контекста, чтобы кумулятивное сжатие соответствовало информации, действительно необходимой для предсказания. Крайне важно, что такое масштабирование не гарантируется самой архитектурой внимания. Оно зависит от распределения исходных данных.
Более широкое следствие заключается в том, что по-настоящему сверхдлинный контекст может потребовать чего-то более фундаментального, чем просто ускорение плотного внимания.
При достаточно больших масштабах задача заключается не только в хранении или обработке большего числа токенов. Необходимо определить, какая часть прошлого остается полезной, и извлечь именно эту информацию, не утонув во всем остальном.
Наши результаты показывают, что иерархическое внимание предоставляет перспективную архитектурную основу для этого. Объединяя поиск на основе запроса с динамически растущим сублинейным активным состоянием, ZHA демонстрирует, что внимание не обязательно должно ограничиваться либо памятью фиксированного размера, либо квадратичными вычислениями.
Мы верим, что наиболее захватывающая возможность заключается в том, что правильная форма разреженности способна одновременно решить как вычислительные, так и информационные проблемы чрезвычайно длинных контекстов.
Если мы научимся соотносить рост активного внимания с ростом предсказательной информации в реальных последовательностях, контексты из сотен миллионов или даже миллиардов токенов со временем могут стать практичными. Будущее языкового моделирования с длинным контекстом, следовательно, может зависеть от того, удастся ли наделить модели способностью находить именно то, что важно, на любом масштабе.