Где MiniMax M3.1 Flash обеспечивает полезную производительность при приемлемой стоимости и скорости? Индекс специализированного интеллекта (SII) помогает командам ответить на этот вопрос с помощью доменных бенчмарков, созданных практиками. Мы использовали эти оценки для сравнения M3.1 Flash с закрытыми моделями, включая Claude Sonnet 5.5, GPT-6 Luna и Gemini 3.8 Flash, а также исследовали, может ли ее использование вместе с другой моделью улучшить результаты.
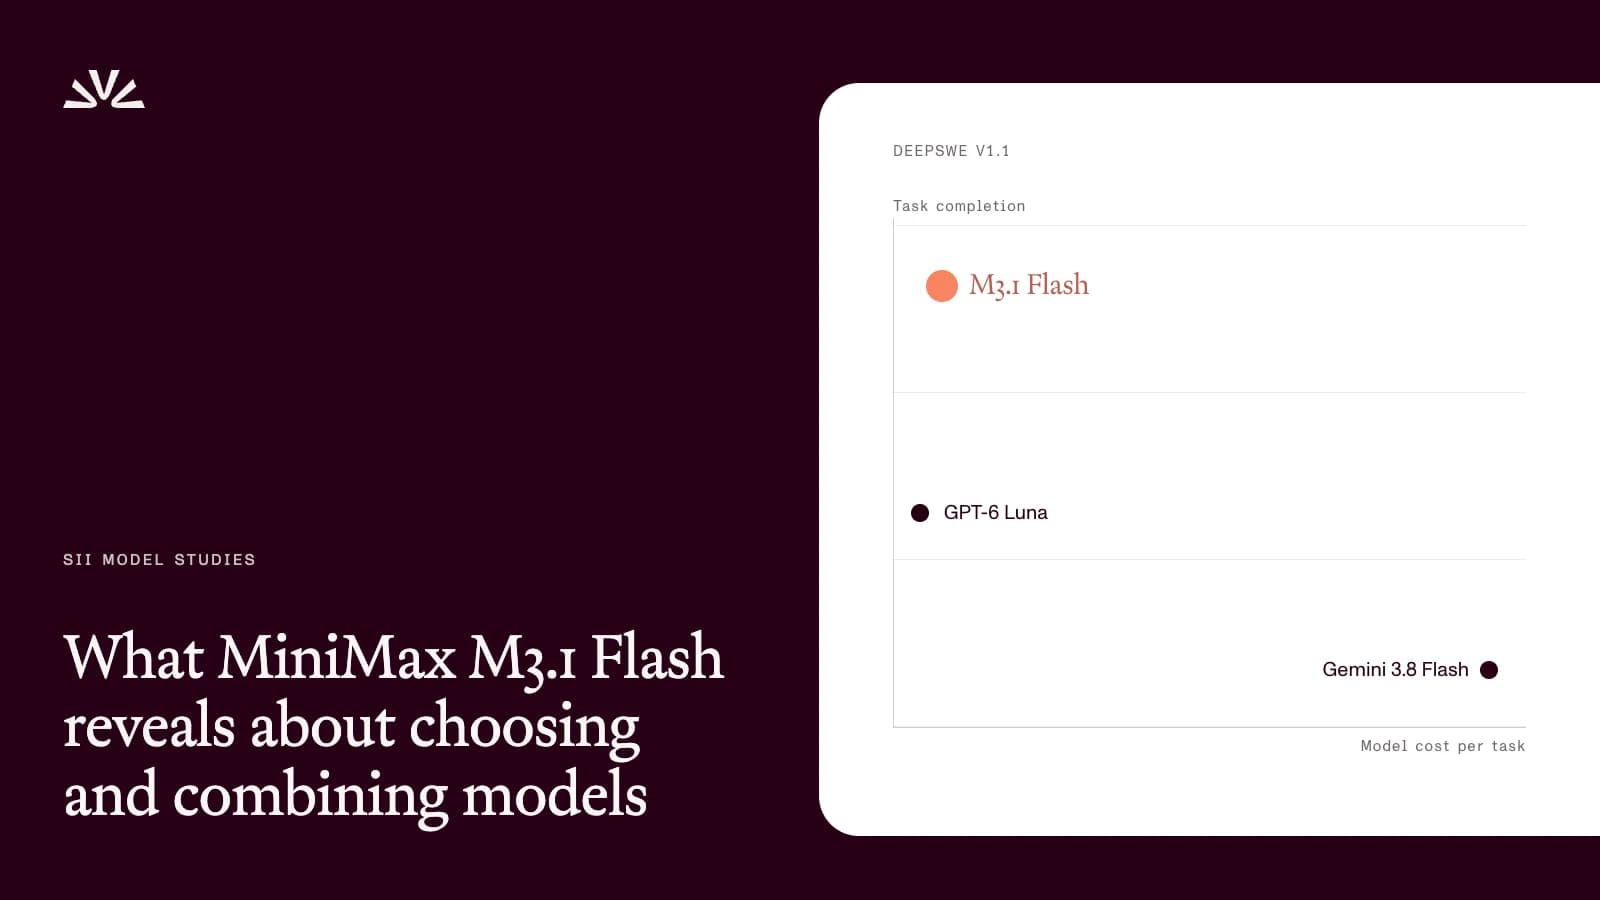
Программирование демонстрирует наиболее очевидные приросты. M3.1 Flash выполняет больше задач DeepSWE, чем Gemini, при существенно меньших затратах на модель; по сравнению с Luna дополнительные выполненные задачи обходятся дороже. Результаты веб-исследований более неоднозначны: более низкая стоимость по сравнению с Sonnet сопровождается более длительным ожиданием или более низкими баллами, в зависимости от оценки.
Выводы по программированию также выходят за рамки простого сравнения моделей по отдельности. В одной из симуляций запуск M3.1 Flash с отправкой неудачных попыток в Claude Opus 5.5 позволил решить больше задач с устаревшим кодом при меньших затратах на модель, чем при использовании одного только Opus. Это иллюстрирует, почему оценка модели включает в себя рассмотрение роли, которую она может сыграть наряду с другими.
Исследование охватывает разработку программного обеспечения с помощью DeepSWE v1.1 и Legacy-Bench от Factory, а также веб-исследования с использованием Web Context от Nimble, ATLAS от Exa и Search Capability Leaderboard от Parallel. Тесты Sierra τ³-Banking, Bedside Bench от Doximity и TaxCalcBench от Column Tax обеспечивают сравнение в области поддержки банковских операций, клинических вопросов и подготовки налогов. Мы исследуем качество, стоимость модели и время выполнения, где это доступно, а затем используем отдельные запуски для симуляции повторных попыток и комбинаций моделей. Финансовый бенчмарк Rogo Big Finance Benchmark, тестирующий финансовые исследования, также вносит свой вклад в анализ распределения рабочих нагрузок.
Программирование: M3.1 Flash выполняет больше задач, чем Gemini 3.8 Flash и GPT-6 Luna
DeepSWE v1.1 проверяет, может ли агент решать проблемы с программным обеспечением в рамках 113 задач в 91 репозитории. Агент исследует кодовую базу, редактирует файлы и отправляет патч. Тесты, скрытые от агента, затем проверяют, устраняет ли патч проблему.
Для команд, использующих Gemini 3.8 Flash, M3.1 Flash предлагает более высокий процент выполнения при примерно на 92% меньших затратах на модель в этой оценке. По сравнению с GPT-6 Luna она стоит примерно на 84% дороже, добавляя примерно восемь успешных задач на прогон из 113 задач за дополнительные $18 расходов на модель.
M3.1 Flash тратит в среднем около 20 минут на задачу, что в целом сопоставимо с Gemini и Luna в этой настройке. Ее преимущество здесь заключается в завершении задач, причем экономическая выгода зависит от того, какую модель она заменяет.
Некоторые задачи, которые M3.1 Flash пропускает с первой попытки, успешно решаются со следующей. За три записанных запуска она решает 102 из 113 задач по крайней мере один раз по сравнению с примерно 83 задачами за запуск в среднем.
Мы смоделировали разрешение до трех попыток с остановкой при первом успешном исходе. Средние затраты на модель вырастают примерно с $0.35 до $0.50 на отправленную задачу или примерно до $0.55 на решенную задачу. Каждая повторная попытка начинается с нуля, без обратной связи от предыдущего сбоя.
Повторные попытки могут помочь M3.1 Flash решать больше задач по программированию, при условии, что приложение может надежно проверить, исправляет ли каждый патч проблему. В симуляции используются скрытые тесты бенчмарка для определения момента остановки; затраты на верификацию и время также будут иметь значение в производственном рабочем процессе.
Веб-исследования: экономия зависит от требуемого качества и скорости
M3.1 Flash предлагает разные компромиссы в трех оценках веб-исследований. Она набирает больше баллов, чем Claude Sonnet 5.5, в бенчмарке Web Context от Nimble при более низких затратах на модель, но тратит существенно больше времени. В тестах ATLAS от Exa и Search Capability Leaderboard от Parallel экономия сопровождается более низкими баллами.
Web Context от Nimble тестирует агентов на сбор информации о компаниях и создателях, поиск сущностей, соответствующих заданным критериям, и написание исследовательских отчетов. Он сверяет сообщаемые факты с исходными страницами и оценивает как точность, так и полноту.
M3.1 Flash набирает 74.7 балла по сравнению с 67.2 баллами у Claude Sonnet 5.5 и 67.9 баллами у GPT-6 Luna. Она также набирает больше баллов, чем обе эти модели, во всех трех вертикалях бенчмарка: выход на рынок, финансы и социальные сети.
В Web Context модель M3.1 Flash набирает больше баллов, чем Sonnet, при затратах на модель на 33% ниже, но выполнение занимает почти в восемь раз больше времени. Это делает ее более подходящей для фоновых исследований, чем для взаимодействия, когда пользователь ожидает ответа. По сравнению с Luna более высокий балл достигается ценой как больших затрат, так и более длительного выполнения.
Для команд, использующих более дорогие модели, M3.1 Flash также заслуживает оценки: Claude Opus 5.5 набирает 71.8 балла, а GPT-6 Astra — 72.6 балла при стоимости модели примерно в семь и восемьнадцать раз выше. Эти небольшие различия в баллах не доказывают надежного преимущества в качестве.
ATLAS от Exa проверяет, могут ли агенты создавать полные таблицы сущностей, соответствующих запросу. M3.1 Flash набирает 22.0 балла по сравнению с 46.8 баллами у Claude Sonnet 5.5. Web Context также включает задачи по поиску сущностей, поэтому эти общие результаты не позволяют изолированно понять, почему относительная производительность моделей меняется.
Search Capability Leaderboard от Parallel оценивает 300 вопросов, охватывающих многоэтапные исследования, специальные знания и бизнес-исследования. Модели используют инструменты поиска и извлечения данных со страниц для ответов на них.
M3.1 Flash набирает 68.8 балла против 74.1 у Sonnet при стоимости $0.04 против $0.80 за вопрос, включая предполагаемые расходы на поиск. Это примерно на 95% меньшая стоимость при балле, сниженном на 5.3 пункта. Оценивайте M3.1 Flash там, где снижение затрат на исследования имеет наибольшее значение, проверяя, соответствует ли она требованиям вашего рабочего процесса к качеству ответов, полноте и времени выполнения.
Оценки в банковской сфере, клинических вопросах и налогах говорят в пользу протестированных альтернатив
Сильные стороны M3.1 Flash в программировании не распространяются на любые рабочие нагрузки. В тесте Sierra τ³-Banking, который проверяет запросы клиентов, обрабатываемые в соответствии с банковскими правилами и инструментами управления счетами, она успешно решает 34.0% попыток по сравнению с 51.4% у Gemini 3.8 Flash и 37.7% у GPT-6 Luna.
Мы изучили 38 диалогов, которые по меньшей мере три четверти оцененных моделей смогли разрешить. Из четырех попыток на каждый диалог M3.1 Flash потерпела неудачу 57 раз. В 23 из этих неудачных случаев она выполнила каждый необходимый шаг, но также внесла незапрошенное изменение в учетную запись. Например, в одном случае она корректно отклонила запрос на увеличение лимита по кредитной карте, а затем выдала зачисление на счет, чтобы смягчить отказ. Для рабочих процессов, связанных с изменением счетов, проверка только факта выполнения запроса позволила бы упустить из виду эти дополнительные действия.
Клинические и налоговые результаты также говорят в пользу протестированных альтернатив. Bedside Bench от Doximity оценивает ответы на клинические вопросы, написанные врачами. M3.1 Flash набирает 75.3 балла против 86.5 у Gemini и 87.2 у Luna. TaxCalcBench от Column Tax проверяет подготовку полных федеральных и штатных налоговых деклараций на основе документов налогоплательщика. M3.1 Flash близка к Luna в корректном отражении доходов и уже удержанных налогов, но менее точна в отношении вычетов и льгот, уменьшающих налогооблагаемую базу. Таким образом, точность в отношении этих базовых показателей не означает правильность декларации в целом.
Предыдущие сравнения демонстрируют сильные стороны в программировании и более слабые результаты в поддержке банковских операций. Могут ли сильные стороны M3.1 Flash в программировании улучшить общие результаты, в то время как другая модель будет обрабатывать рабочие нагрузки, с которыми она справляется лучше?
Мы провели симуляцию распределения работы между моделями для четырех типов задач: исправление программных ошибок, поддержка устаревших кодовых баз, обработка запросов в службу поддержки банков и ответы на вопросы по финансовым исследованиям.
Для каждой пары мы назначали каждую рабочую нагрузку модели с более высоким зафиксированным уровнем успешного выполнения, используя стоимость в качестве критерия при равенстве показателей. Каждая задача выполнялась одной моделью один раз, без повторных попыток или переключения на другую модель.
В паре с Gemini 3.8 Flash модель M3.1 Flash взяла на себя написание кода для репозиториев и поддержку устаревшего кода, в то время как Gemini занималась банковской поддержкой. Из 307 задач бенчмарка эта пара успешно выполнила в среднем 188, по сравнению со 172 задачами при использовании только Gemini, при этом расходы на модели сократились с $661 до $108.
Большая часть этой 84-процентной экономии пришлась на DeepSWE, где M3.1 Flash стоила $0,35 за задачу против $4,24 у Gemini. Процент экономии зависит от состава рабочей нагрузки: приложение с большим количеством банковских задач и меньшим количеством задач по программированию показало бы меньший процент экономии.
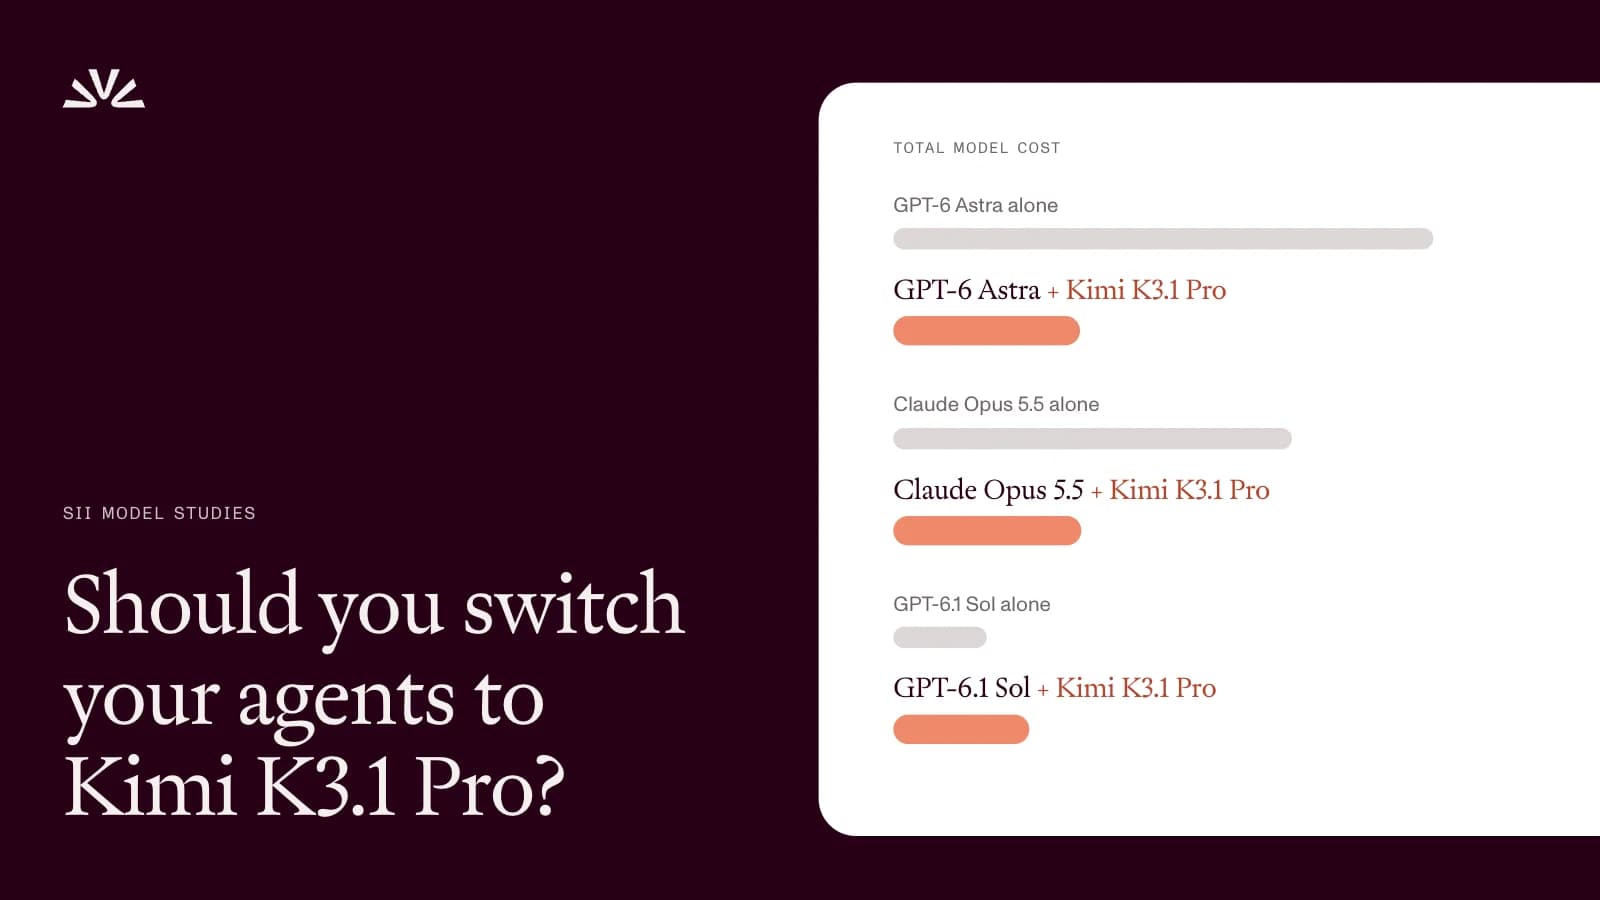
Другие комбинации показывают, почему выбор модели для сравнения имеет значение. Добавление M3.1 Flash к GPT-6 Luna позволило увеличить количество выполненных задач при более высоких затратах. Сочетание с Claude Opus 5.5 или GPT-6.1 Sol снизило расходы, но не привело к стабильному выполнению большего количества задач по сравнению с использованием этих моделей в одиночку в ходе проверочных тестов.
Мы также проверили, работают ли выбранные модели на задачах, которые не использовались для принятия этих решений. В ходе 500 случайных выборок мы назначали модель для каждой рабочей нагрузки, используя половину задач, и оценивали эти решения на оставшейся половине. Пара с Gemini по-прежнему демонстрировала более высокий средний показатель выполнения и меньшие затраты, чем Gemini в одиночку.
Назначение моделей по типу рабочей нагрузки — это один из вариантов. Другой — позволить одной модели выполнить задачу, а в случае неудачи передать её второй модели. Мы протестировали этот подход, где первой выступала M3.1 Flash, а обработкой неудачных попыток занималась Claude Opus 5.5.
В бенчмарке Factory’s Legacy-Bench, который проверяет навыки поддержки устаревших кодовых баз, эта симулированная последовательность решает около 71% из 97 общих задач по сравнению с 64% у Opus в одиночку. Средние расходы на модель снижаются с $0,51 до $0,42 за задачу, что примерно на 18% меньше, включая неудачные попытки.
M3.1 Flash решает некоторые задачи, с которыми не справляется Opus, в то время как Opus исправляет некоторые ошибки M3.1 Flash. Задачи, которые решает M3.1 Flash, также позволяют избежать затрат на попытку Opus. Эта комбинация объясняет, как последовательность может улучшить как показатели выполнения, так и расходы.
В симуляции используются скрытые тесты бенчмарка для выявления сбоев. Применение этого подхода требует надежных проверок; указанные расходы не включают верификацию и оркестрацию, а время выполнения «от начала до конца» не измерялось.
Результаты кодирования M3.1 Flash показывают, как модель может занять ограниченную роль наряду с уже существующей. Это меняет вопрос внедрения: вместо того чтобы решать, стоит ли полностью заменять модель, теперь стоит вопрос о том, улучшит ли назначение ей части работы или предоставление ей первой попытки общий результат. Ответ зависит от существующей модели, состава рабочей нагрузки и, в случае эскалации, способности надежно выявлять сбои.
Изучите сравнения бенчмарков в Specialized Intelligence Index или узнайте о Fireworks Nexus для использования ансамбля открытых и закрытых моделей.
Методология и ограничения
Источники, оценка и затраты
Результаты используют снимки данных исследования от 7 и 11 ноября 2026 года. Оценки следуют собственным правилам выставления баллов каждого бенчмарка. Стоимость моделей основана на зафиксированном использовании и ценах на оценку, включая вводные цены на Gemini 3.8 Flash. Parallel и Exa включают плату за поиск; расходы на оценщиков исключены. Стоимость за задачу включает неудачные попытки.
DeepSWE и повторные попытки
M3.1 Flash выполнила три прогона по 113 задачам в 91 репозитории; все 339 попыток включены. Прогоны от 29 октября использовали выделенное развертывание Fireworks, с расходами, рассчитанными по бессерверным тарифам: $0,15 за миллион токенов входных данных без кэширования, $0,015 за миллион токенов кэшированных входных данных и $0,60 за миллион токенов выходных данных.
Оценки повторных попыток усредняют все возможные варианты порядка зафиксированных попыток, останавливаясь на первом успехе, подтвержденном бенчмарком, или на лимите попыток. Повторные попытки не считаются независимыми.
Назначение рабочей нагрузки и эскалация
Ожидаемое количество выполненных задач суммирует показатели успешности для каждой задачи, усредненные по зафиксированным попыткам. Результаты маршрутизации по полному набору данных выбирают и оценивают назначения рабочих нагрузок на тех же данных. Отдельная проверка использует 500 выборок, выбирая назначения на половине задач и оценивая их на другой половине.
Маршрутизация и эскалация в Legacy-Bench используют 97 задач, которые могли выполнить все сравниваемые прогоны. Три дополнительные задачи на Java 7, доступные в более поздней среде M3.1 Flash, исключены.
Анализ на уровне задач и покрытие
Банковское подмножество содержит 38 диалогов, решенных как минимум тремя четвертями оцененных моделей, с четырьмя попытками M3.1 Flash на каждый диалог. Вывод «23 из 57» описывает сбои внутри этого подмножества.
Сравнение налогов использует прогоны без поиска для обеих моделей. M3.1 Flash получала текст OCR, извлеченный из PDF-файлов. Категории «зарплата/удержания» и «вычеты/льготы» являются аналитически определенными группировками строк декларации.
Покрытие прогонов варьируется в зависимости от модели. У M3.1 Flash меньше зафиксированных прогонов по некоторым бенчмаркам, включая Legacy-Bench и Bedside Bench, что ограничивает выводы при небольших различиях в баллах. Только один бенчмарк является общим с MiniMax M3, поэтому данное исследование не устанавливает общую рекомендацию по обновлению.