Существует два взгляда на будущее: мир, где весь интеллект принадлежит нескольким закрытым передовым лабораториям, или мир, где каждая компания владеет интеллектом, делающим ее уникальной.
Fireworks Forge создана для тех, кто строит это второе будущее. Наша первая ежегодная конференция открывается сегодня, объединяя лидеров ИИ-ориентированных стартапов, мировых корпораций, разработчиков моделей с открытыми весами и многих других.
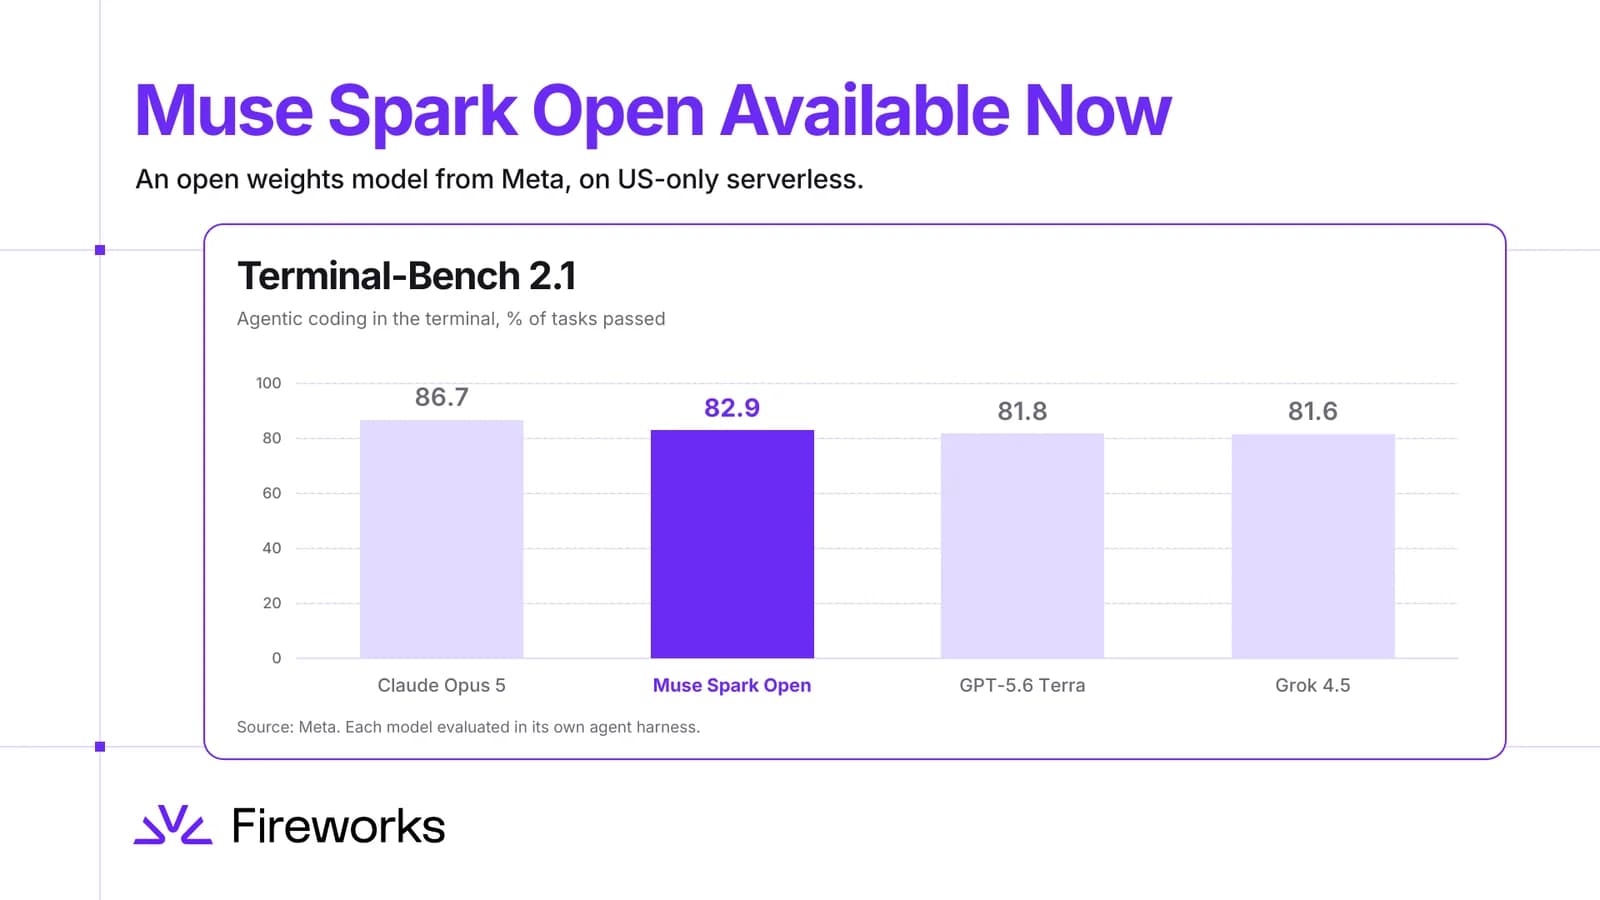
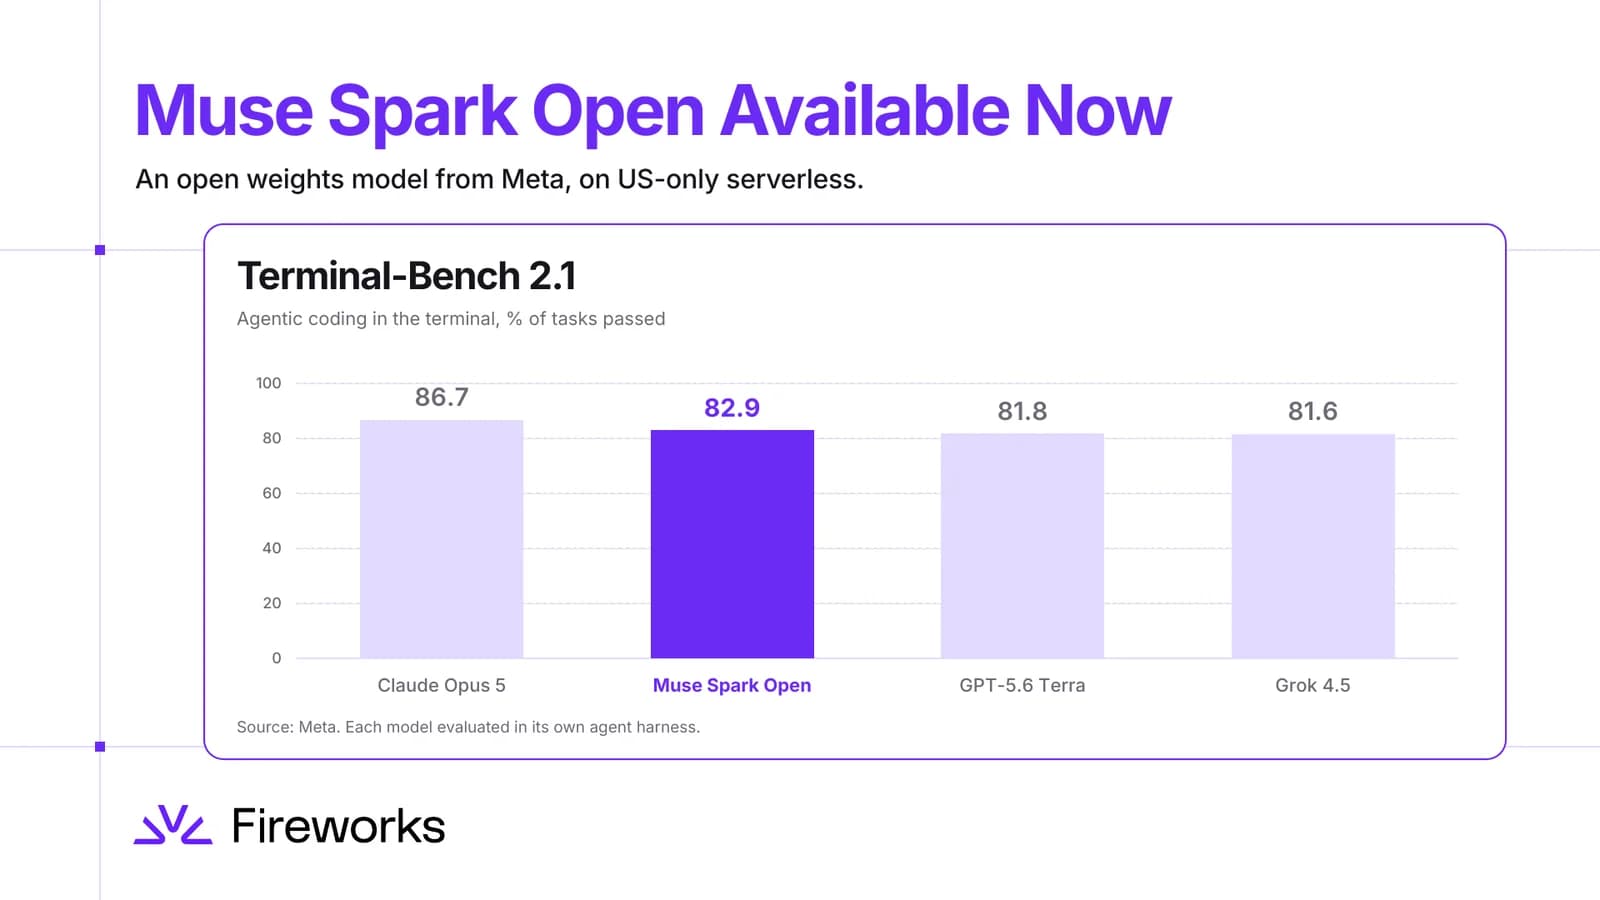
Достижения в области моделей с открытыми весами, включая модели от NVIDIA, Meta и Reflection AI, доступные на Fireworks, дают компаниям больше возможностей для выбора того, как строить ИИ. На конференции мы представили новые продукты, помогающие компаниям превращать достижения в открытых моделях в интеллект, построенный вокруг их собственной экспертизы, данных и задач.
Эти запуски решают практические проблемы, с которыми сталкиваются команды при внедрении ИИ в повседневную работу: агенты, которым требуется слишком много времени на отклик, модели, которым необходимо лучше справляться со специфическими для компании задачами, и инфраструктура, которая должна соответствовать корпоративным требованиям к стоимости, контролю и безопасности.
ИИ-агенты часто делают несколько запросов к моделям для выполнения одной задачи. Каждый запрос увеличивает время ожидания результата клиентом или сотрудником, в то время как одновременный запуск большего числа агентов усиливает нагрузку на мощности и увеличивает затраты. Командам требуется скорость для работы, чувствительной ко времени, и более экономичные варианты для задач, которые могут подождать.
Сверхбыстрый режим Fireworks Ultra-fast, работающий на базе графических процессоров NVIDIA Blackwell, ускоряет такие рабочие нагрузки, чувствительные ко времени. Теперь он доступен в режиме публичного предварительного просмотра (public preview) и обеспечивает скорость до 1 500 токенов в секунду, как было продемонстрировано на DeepSeek V4.1 Flash. Эта скорость особенно важна, когда задержки суммируются на нескольких этапах: в протестированной задаче агента из 30 шагов время выполнения сократилось с 1 минуты до 8 секунд в сверхбыстром режиме.
Для рабочих нагрузок, где стоимость важнее немедленного завершения, Background Mode предоставляет командам более дешевый вариант рантайма за полцены. Этот режим снижает стоимость одной задачи для подходящей работы, которая может подождать, например, для генерации данных для оценок и ночных исследований. Кэширование промптов на протяжении нескольких дней (Multi-day Prompt Caching) снижает затраты на повторяющийся контекст, в то время как более высокие лимиты запросов (rate limits) поддерживают большее число одновременных агентов.
Специализированные модели также могут повысить экономичность инференса. Ember-1, модель Fireworks, доступная для бессерверных (serverless) и выделенных развертываний, использовала примерно на 40% меньше токенов при сохранении сопоставимого с Kimi K3 качества в наших оценках.
В совокупности эти возможности помогают командам соотносить производительность инференса и расходы с требованиями каждой рабочей нагрузки.
Сотрудники все больше полагаются на ИИ в написании кода и повседневной работе, но переключение между моделями может означать отказ от привычного инструмента или добавление еще одной подписки для управления. Компаниям необходимо предоставить людям более широкий выбор моделей при сохранении прозрачности расходов.
Fireworks Nexus переносит открытые модели в инструменты для написания кода и совместной работы с ИИ, которые люди уже используют, наряду с их существующими подписками на ИИ. Она объединяет открытые и закрытые модели с персонализированным выбором моделей и учетом кэша, помогая людям использовать модели, подходящие для их работы, и предоставляя организациям централизованный контроль и прозрачность расходов.
Сегодня мы запустили Nexus Desktop в дополнение к Nexus CLI. Теперь Nexus работает в приложениях Codex, Claude Desktop и OpenCode, расширяя возможности персонализированного выбора моделей с кодинга на повседневную работу со знаниями. Новые тарифные планы Pro начинаются от 8 долларов в месяц, а планы Teams — от 10 долларов за место в месяц. Корпоративные планы добавляют единый вход (SSO), управление (governance), общие бюджеты и контроль доступа.
По мере роста рабочей нагрузки более высокие лимиты бессерверных запросов, которые теперь общедоступны (generally available), позволяют командам выполнять больше работы одновременно без резервирования выделенных мощностей. Elastic Burst, также общедоступный, позволяет клиентам превышать обычный лимит использования при наличии свободных мощностей, без каких-либо изменений в коде или ценообразовании.
Выбор правильной модели может улучшить результаты и снизить затраты. Обучение идет дальше, показывая модели, как выглядит хороший результат для вашей конкретной задачи. Это может означать превышение качества существующей модели или получение необходимой производительности от меньшей и более быстрой модели. Часто это и то, и другое. На Forge мы упростили получение этих результатов и их вывод в производство.
Это начинается с понимания того, что именно нужно улучшить. No Eval, доступный сейчас в закрытом предварительном превью (private preview), помогает превратить производственные трейсы и сигналы продукта в специфические для задач оценки, чтобы команды могли определить, где модели не дорабатывают, и измерить, устраняет ли обучение этот разрыв. Это решает одну из главных преград на пути к обучению собственной модели, поскольку самостоятельное написание оценок может занять недели разметки данных с последующей их проверкой.
Инференс специализированных моделей (Specialized Model Inference), доступный теперь в публичном предварительном превью, распространяет бессерверный подход на обслуживание адаптеров LoRA, начиная с GLM 5.3 Flash. Команды могут оценивать обученную модель и обслуживать ее через API Fireworks Serverless с ценообразованием за токен, без необходимости выделять ресурсы под размер развертывания и без платы за обслуживание в режиме простоя. Они могут продолжать использовать модель, экспериментируя со следующей версией.
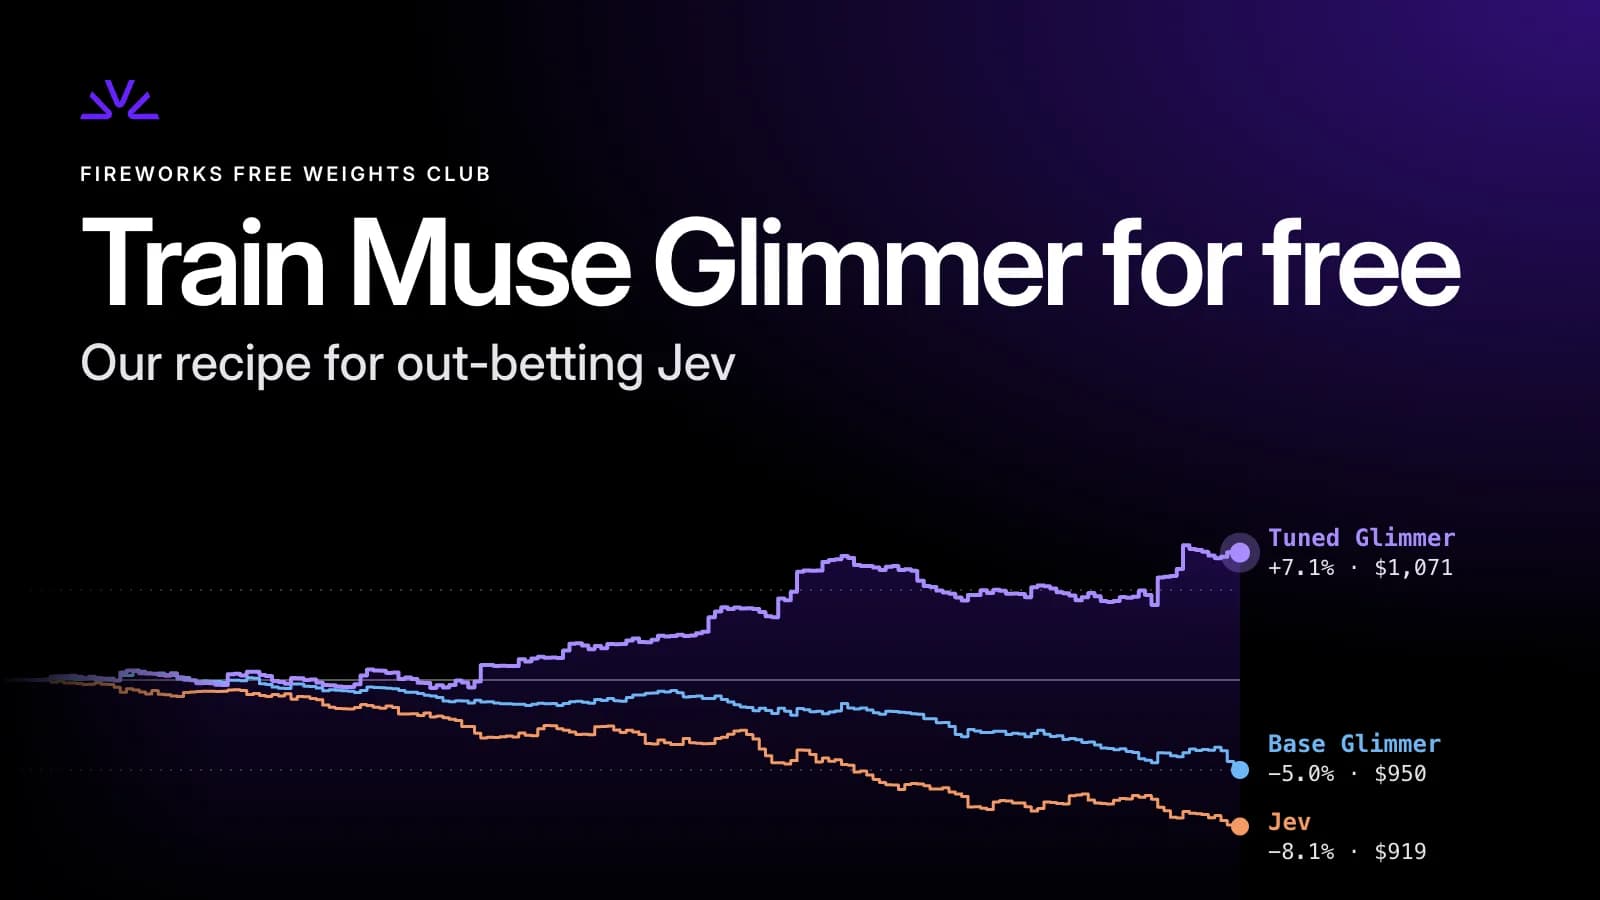
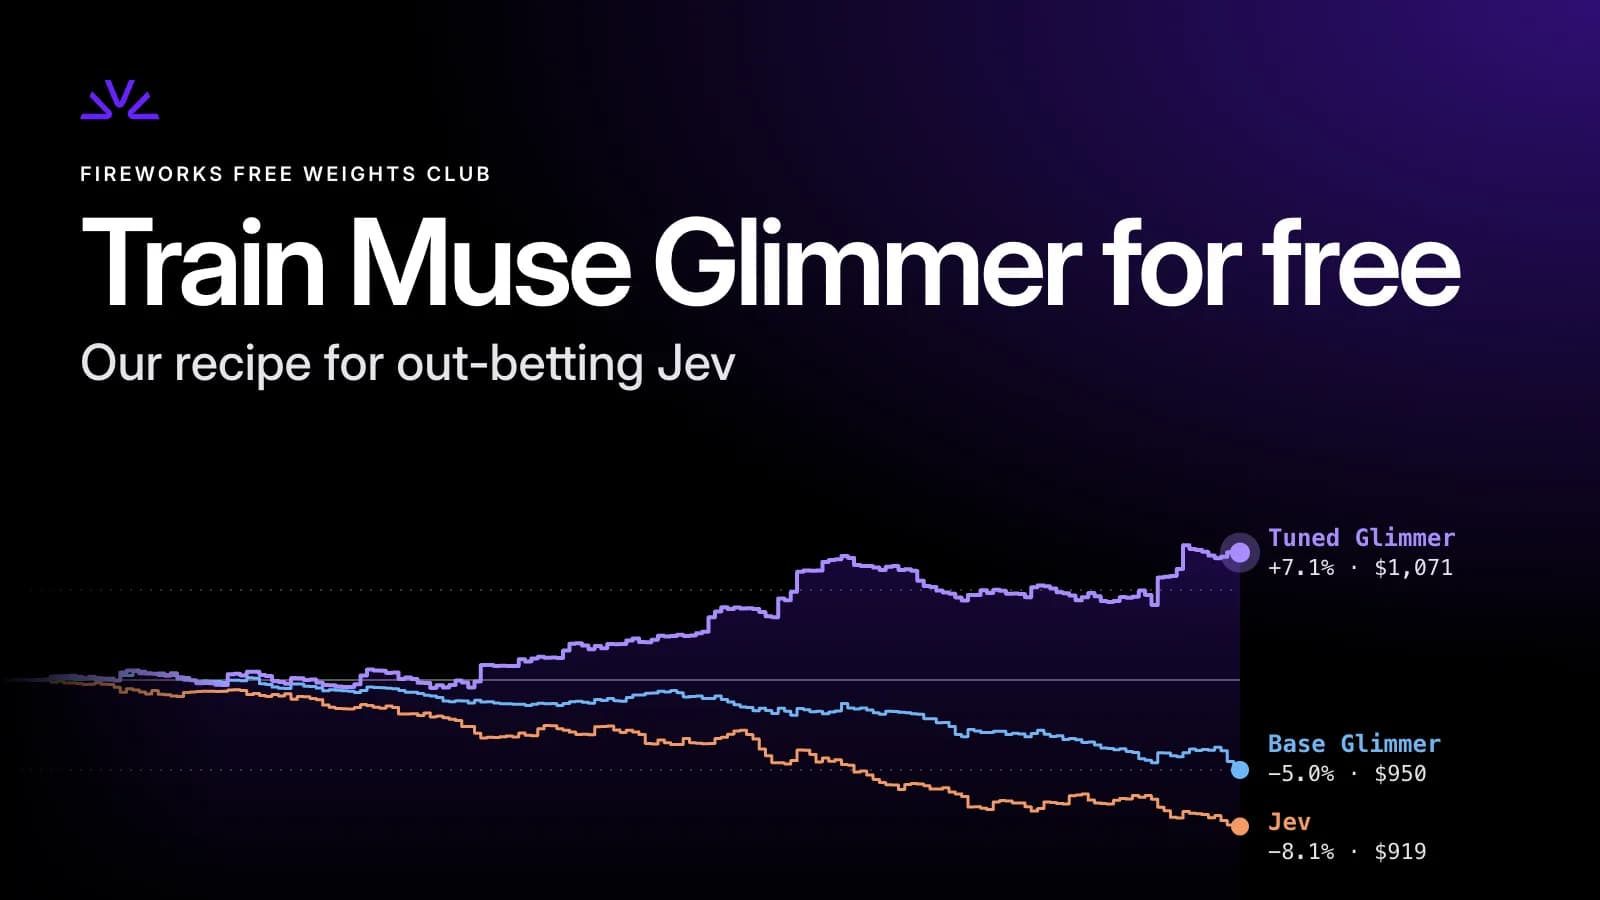
Команды могут начать работу с бесплатного обучения на Muse Glimmer 30B до 30 ноября, включая обучение с учителем (supervised fine-tuning), прямую оптимизацию предпочтений (direct preference optimization) и обучение с подкреплением (reinforcement learning).
По мере перехода ИИ в критически важные бизнес-процессы предприятиям необходимо управлять использованием моделей, контролировать расходы и вести учет активности. Некоторым также требуется больший контроль над тем, где работает их инфраструктура ИИ и как защищены их данные.
Fireworks теперь предлагает общедоступные инструменты управления моделями, контроля расходов и экспортируемые журналы аудита (audit logs). Предварительные версии централизованного управления учетными записями, регионального контроля данных и шифрования, управляемого клиентом, расширяют эти возможности для организаций с более жесткими требованиями к эксплуатации.
Для предприятий, которые хотят использовать собственную инфраструктуру, Fireworks Sovereign, доступная теперь в закрытом предварительном превью, переносит инференционный движок компании в облако, неоклауд или дата-центры клиентов. Она объединяет технологии, способные удвоить (или увеличить еще сильнее) количество токенов на доллар графического процессора, с экспертным управлением, снижающим совокупную стоимость владения, что помогает клиентам запускать открытые модели в выбранной ими инфраструктуре.
Инференс и обучение выполняются внутри среды клиента в соответствии с уже действующими там политиками безопасности и контроля изменений. Регулируемые предприятия могут соответствовать требованиям к локализации данных и доступу к моделям на инфраструктуре, которой они управляют, а вычислительные мощности ИИ остаются в выбранных ими юрисдикциях. Поскольку клиенты владеют инфраструктурой и выбирают модели, изменение цен провайдером или вывод модели из эксплуатации не смогут нарушить их дорожную карту. Fireworks уже управляет более чем 25 000 графических процессоров в клиентских средах.
В совокупности запуски на Forge делают создание, улучшение и развертывание специализированного интеллекта более практичным. Более быстрый инференс поддерживает работу отзывчивых агентов; Nexus приносит выбор моделей в повседневную работу сотрудников; возможности обучения помогают компаниям улучшать производительность при решении собственных задач; а корпоративные средства контроля поддерживают развертывание в масштабе.
Чтобы присоединиться к Fireworks Forge виртуально, зарегистрируйтесь на прямую трансляцию.