Кратко
- •Muse Glimmer 30B доступна для бесплатного обучения с помощью контролируемой донастройки (SFT) до 30 ноября, что дает старт нашему клубу Free Weights Club.
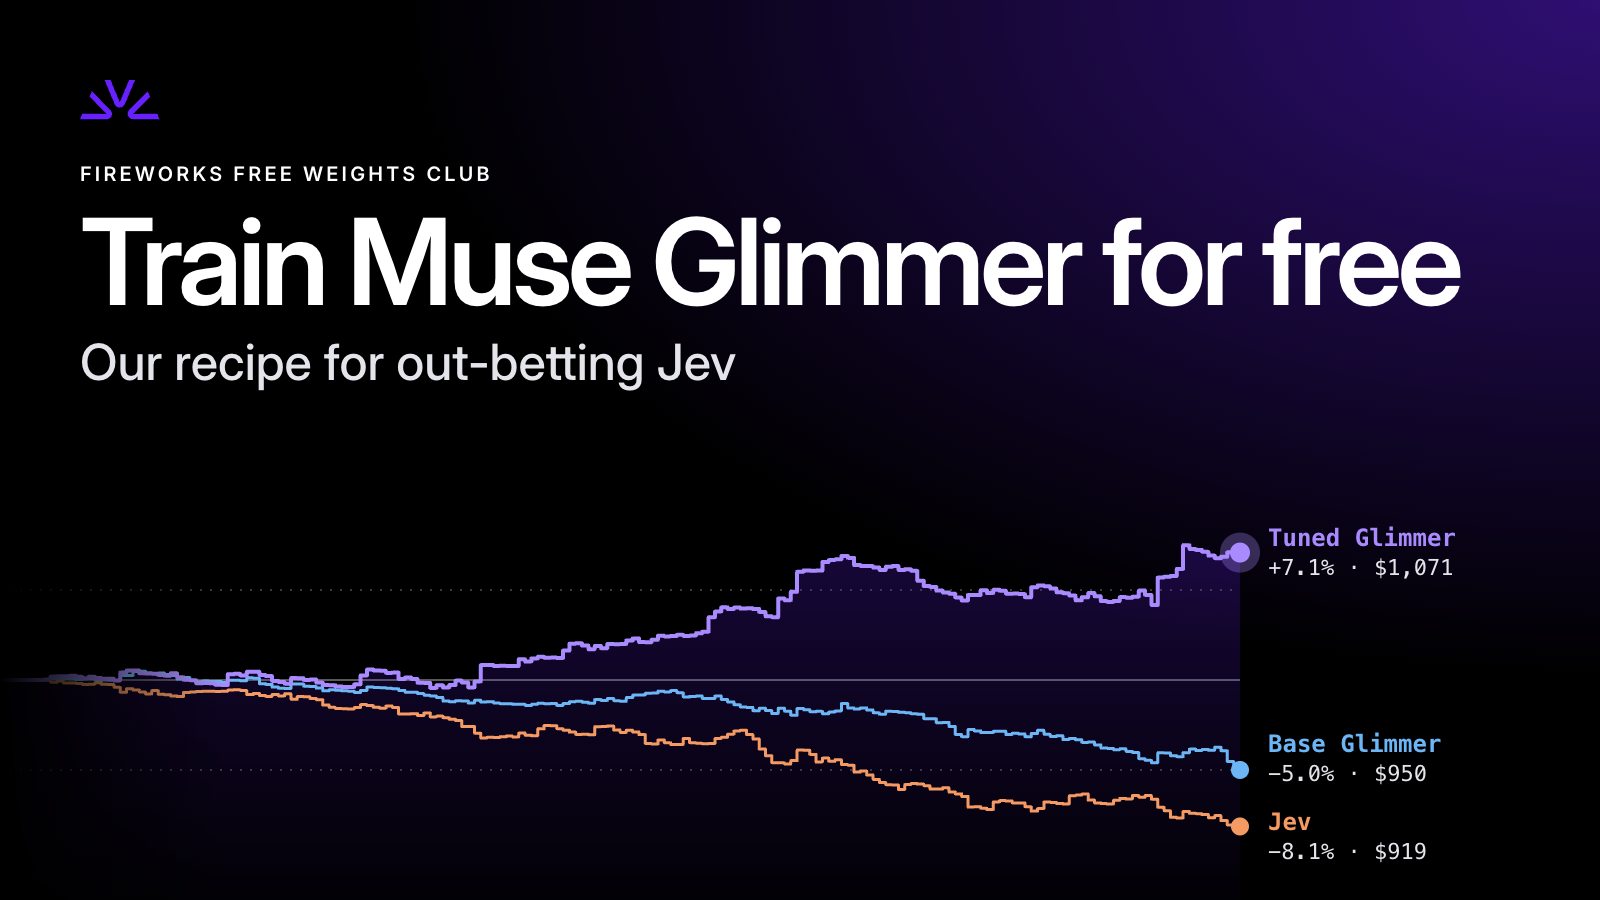
- •Донастроенная Muse Glimmer превзошла Jev на 11,2 процентных пункта по точности прогнозирования на ранее не встречавшихся темах, достигнув 58,3% против 47,1%. В историческом бэктесте она также превратила гипотетическую 1 000 долларов в 1 071 доллар после учета смоделированных торговых комиссий, в то время как и Jev, и базовая Glimmer понесли убытки.
- •Оптимизированный стек обслуживания System One от Fireworks обеспечил в 2–3 раза более высокую медианную скорость обработки сервером по сравнению со стандартными чат-ответами BF16 в отдельном синтетическом бенчмарке. В обоих случаях использовались один и тот же адаптер и один GPU B200; различались точность и время выполнения.
- •Попробуйте наш эксперимент с помощью поваренной книги Kalshi. Для ваших собственных проектов Managed Training выполняет задачу SFT на основе ваших примеров, в то время как Serverless Training API дает вам контроль над циклом обучения.
Добро пожаловать в Fireworks Free Weights Club. Ограниченное время мы будем делиться новыми исследованиями в области пост-обучения, рецептом, который вы можете использовать для создания собственных решений, и бесплатным обучением избранной модели, чтобы вы могли проводить собственные эксперименты.
Первая на очереди: Muse Glimmer 30B с бесплатным SFT-обучением до 30 ноября. Она мультимодальна, предлагает отличную производительность за свои деньги и служит прекрасной отправной точкой для создания персональных агентов.
Для нашего первого эксперимента мы задались вопросом, может ли обучение Muse Glimmer на исторических рынках Kalshi дать ей преимущество в прогнозировании исходов. Мы оценили ее прогнозы по сравнению с Jev и исходной моделью на рынках, исключенных из обучающей выборки.
Обученную нами версию мы называем настроенной Glimmer, а исходную модель — базовой Glimmer. Настроенная Glimmer опередила обе сравниваемые модели по точности прогнозирования. В историческом бэктесте она превратила гипотетическую 1 000 долларов в 1 071 доллар после учета смоделированных комиссий, в то время как обе сравниваемые модели ушли в минус.
Ниже рассказывается о том, что именно мы обучили, как мы это протестировали и как вы можете попробовать это сами.
Начните обучение бесплатно.
Создание датасета
Jev предоставил нам модель, которую нужно было превзойти; Kalshi предоставил способ вести счет.
Завершившиеся рынки имеют ключ к разгадке: возьмем вопрос «Превысит ли максимальная температура в Нью-Йорке 80 °F?». Как только рынок закрывается, появляется результат, с которым можно сверить прогноз. Задача заключается в том, чтобы извлечь знания, которые пригодятся для следующего вопроса.
Каждый пример содержал название рынка, описание, правила и дату, а в качестве метки выступал завершенный исход. Модель не видела рыночных цен или новостей.
Мы разделили данные на обучающую, калибровочную и оценочную выборки:
- •Обучение: 20 051 вопрос из 6 461 события, завершившегося до 4 января 2026 года.
- •Калибровка: 6 232 вопроса из 2 000 событий, открывшихся 11 января или позже и завершившихся до 1 апреля 2026 года.
- •Оценка: 33 712 вопросов из 8 765 событий, открывшихся 8 апреля 2026 года или позже.
Внутри оценочного набора 3 567 вопросов относились к 113 семействам тем, исключенным как из обучения, так и из калибровки. Мы публикуем результаты для полного тестового набора и этого подмножества новых тем, чтобы проверить, насколько хорошо Glimmer справляется с более поздними событиями и незнакомыми темами.
Мы удалили почти дублирующиеся входные данные, правки правил, сделанные после открытия рынков, и добавленные позже выигрышные варианты, которые могли бы раскрыть результаты. Каждое тестовое событие оценивалось один раз.
Один проход обучения — лучшие прогнозы
У этих вопросов уже есть набор возможных ответов. Мы использовали Fireworks Training API с K-way функцией потерь перекрестной энтропии, чтобы обучить Glimmer присваивать большую вероятность правильному исходу. Функция потерь учитывает только варианты ответов на данный вопрос, а не весь словарный запас модели.
Мы обучили LoRA-адаптер с помощью SFT, сделав один проход по обучающим данным.
На полном тестовом наборе настроенная Glimmer достигла точности 64,8% по сравнению с 56,4% у базовой Glimmer и 45,9% у Jev.
На новых темах настроенная Glimmer достигла 58,3%, опередив базовую Glimmer с ее 53,2% и Jev с 47,1%. Это на 11,2 процентных пункта выше, чем у Jev, на семействах тем, с которыми модель не сталкивалась во время обучения.
Эталон общего ответа всегда выбирает «Нет» для вопросов типа «да/нет» и позицию наиболее частого правильного варианта для вопросов с множественным выбором. Он использует ответы оценочной выборки для установления этого эталона, поэтому он задает контекст, а не представляет собой обученный предиктор.
Немного уверенности имеет большой вес
Прогноз с вероятностью 51% и прогноз с вероятностью 90% могут оба указывать на «Да», но мы бы хотели относиться к таким выводам по-разному. Прежде чем использовать вероятности настроенной Glimmer для выбора и определения размера ставок, мы откалибровали ее уверенность по наблюдаемым исходам.
Мы подобрали отдельную температуру калибровки для каждого типа вопросов, используя отложенный калибровочный набор. Это пересчитывает вероятности настроенной Glimmer без переобучения ее весов. Цель: прогнозы, которым присвоена вероятность 80%, должны сбываться примерно в восьми случаях из десяти.
Только настроенная Glimmer прошла этот этап калибровки, базовая Glimmer не получила ни специального обучения под задачу, ни калибровки. Мы использовали вероятности Jev напрямую из ее API без дополнительной калибровки, что соответствует ее предполагаемому использованию «из коробки».
На графике показана разница между точностью и уверенностью на оценочных данных. Чем ближе к нулю, тем лучше; отрицательные значения указывают на излишнюю самоуверенность, а положительные — на недостаток уверенности.
Уверенность настроенной Glimmer не была пустой бравадой. Когда она присваивала ответу вероятность не менее 80%, она была права в 86,8% случаев как на всем тестовом наборе, так и на подмножестве новых тем.
Она также была избирательна: этот порог преодолели 14,4% вопросов из полного теста и 6,1% из подмножества новых тем. Фильтрация по уверенности дала нам меньше прогнозов, но значительно более высокий процент попаданий.
В этих уверенных прогнозах прослеживается закономерность. Многие из них были ответами «Нет» на связанные пороговые вопросы, например, превысит ли значение 100, 110 или 120. Эти исходы часто движутся синхронно, поэтому правильные прогнозы не являются полностью независимыми успехами.
Поставили бы вы на это?
Уверенный прогноз все еще нуждается в выгодной цене. Если ставка приносит 1 доллар при выигрыше, а модель оценивает вероятность выигрыша в 80%, ее ожидаемая выплата составляет 80 центов. Наше правило требовало, чтобы цена покупки плюс смоделированные комиссии были как минимум на 5 центов ниже этой оценки.
Мы выделили каждой модели по 1 000 долларов в виде гипотетических денег для распределения между подходящими ставками. Каждая модель использовала одно и то же правило и тот же набор доступных исторических котировок. Исход должен был иметь прогнозируемую вероятность выигрыша более 50%, причем большим вероятностям соответствовали более крупные суммы.
Мы использовали последнюю завершенную котировку спроса/предложения за два часа до или ровно через два часа после открытия каждого рынка. Модели никогда не видели эти цены; мы использовали их позже, чтобы решить, какие ставки подходят под критерии.
Распределение настроенной Glimmer завершилось с результатом 1 071 доллар (+7,1%) по сравнению с 950 долларами у базовой Glimmer (−5,0%) и 919 долларами у Jev (−8,1%) после учета смоделированных торговых комиссий. Мы были рады оставить последние два убытка гипотетическими.
Бэктест распределял фиксированный бюджет между историческими ставками, включая пересекающиеся, а не симулировал реинвестирование денежных средств с течением времени. Он допускал дробные контракты и не моделировал ликвидность, проскальзывание или изменения исторических комиссий.
Насколько результат зависел от того, какие именно события случайно попали в тест? Мы оценили неопределенность путем повторной выборки целых событий, сохраняя связанные ставки вместе. 90-процентный интервал бутстрэпа для событий настроенной модели Glimmer составил от +1,6% до +12,4%.
Только на ранее неизученных темах отдельное распределение в размере 1000 долларов принесло 15,2%, однако его более широкий интервал (от −2,9% до +33,5%) по-прежнему допускает убытки. Эти интервалы отражают разброс по событиям, а не все источники неопределенности при выборе модели или исполнении сделок.
У нас есть основания продолжать тестирование. Сохранится ли этот результат при использовании реальных денег, остается открытым вопросом.
Более быстрое принятие решений с System One
Для этой задачи нам потребовались вероятности для фиксированного набора ответов. Генерация письменного ответа добавляла лишнюю работу, которую можно было пропустить.
API System One от Fireworks считывает вероятности вариантов напрямую, без генерации текста ответа. Кроме того, этот API упаковывает несколько вопросов об общем контексте в один запрос. Каждый вопрос может использовать этот контекст независимо от ветвлений других вопросов, поэтому мы можем повторно использовать контекст, разделяя принятие решений.
В отдельном синтетическом бенчмарке System One обеспечила в 2–3 раза более высокую среднюю скорость обработки сервером по сравнению со стандартными чат-комплишенами BF16 при использовании того же адаптера и одного графического процессора B200. При обработке от 16 до 32 вопросов за запрос производительность достигала 3,6-кратного увеличения количества решений в секунду.
Точность и время работы различались, поэтому данные результаты сравнивают стеки обслуживания в сборе. Этот бенчмарк не связан со сравнением с Jev на платформе Kalshi.
В руководство (cookbook) включены инструкции по развертыванию обученной модели через /inference/v1/systemone.
Чему вы обучите Muse Glimmer?
Вам вовсе не обязательно стремиться к торговле, чтобы попробовать это. Ваш первый эксперимент может начаться с ошибки, которую вы исправили уже слишком много раз.
Возможно, ваш агент постоянно выбирает неподходящий инструмент. Если вы сохраняете его запуски, успешные вызовы и исправленные ошибки могут стать примерами для SFT (обучения с учителем). Обучайте на одних данных, тестируйте на других и проверяйте, стали ли вы реже совершать эту ошибку.
Попробуйте провести эксперимент с Kalshi самостоятельно. Руководство содержит код, результаты оценки и методологию, а также пошагово описывает эксперимент с использованием Training API.
Для вашего собственного эксперимента:
- • Поручите выполнение задачи Fireworks. Загрузите свои примеры в Managed Training и начните работу в приложении или через API.
- • Управляйте циклом обучения. Используйте Serverless Training API, чтобы написать собственный цикл SFT.
- • Задействуйте своего агента-программиста. Установите навыки обучения Fireworks с помощью руководства по навыкам агентов (Agent Skills), а затем опишите, чему именно вы хотите обучить модель.
Обучение Muse Glimmer 30B с помощью SFT является бесплатным до 30 ноября, кредитная карта не требуется. Инференс, включая запросы для оценки, тарифицируется отдельно.