Мы не следовали готовому руководству по ЖЦПО на базе ИИ. Мы создавали его методом проб, ошибок и итераций. Вот чему нас научил каждый этап жизненного цикла программного обеспечения.
В Части 1 мы рассказали о том, как разработка с помощью ИИ помогла нам выпустить обязательный перезапуск PubHub (платформы публикации документации DevNet) на 3,5 месяца раньше срока. Эта статья — взгляд на те же события с технической стороны: что именно мы делали на каждом этапе жизненного цикла разработки ПО (ЖЦПО) и чему нас научил каждый шаг.
Сегодня существует множество руководств по ЖЦПО, изначально созданных с расчетом на ИИ. Когда мы только начинали, были лишь смутные идеи, но готового руководства не существовало. К своим практикам мы пришли тернистым путем, и было отрадно видеть, что новые руководства во многом приходят к тем же выводам.
ИИ помогал неравномерно. Вот где от него была наибольшая польза и где было труднее всего:
В следующих статьях этой серии каждый этап будет рассмотрен подробно. Эта статья — карта нашего пути.
Начинайте до постановки требований
Прежде чем кто-либо смог сформулировать требования, нам нужно было понять, чем мы располагаем. Платформа PubHub развивалась годами и насчитывала более 15 репозиториев (сервисы на Python, Node.js, Go и React), а инженеры, написавшие большую часть кода, уже сменились. Краевые случаи были зафиксированы в коде, а не в документации. Более ранняя попытка выполнить миграцию вручную показала, насколько это дорого, и мы отказались от этой затеи.
Поэтому первой задачей ИИ было вовсе не написание кода. Мы подключили ИИ к устаревшим репозиториям и попросили его составить то, чего у нас никогда не было: документацию по архитектуре, рабочим процессам и модулям для каждого сервиса. Эксперты в предметной области проверили ее, и она стала общим справочником для продакт-менеджеров, дизайнеров и инженеров. При перезапуске системы первый успех ИИ заключается в понимании, а не в коде. То, как мы этого добились, заслуживает отдельной статьи в нашей серии.
Требования: меньше значит лучше
После документирования старой системы мы написали требования (разумеется, с помощью ИИ). Первые черновики выглядели впечатляюще. Затем они начали расти. Пользовательская история могла занимать десятки страниц и скатываться в дизайн: предлагаемые компоненты, потоки данных, даже JSON-структура схемы. Бизнес-потребность где-то там присутствовала, но чтобы заставить всех прийти к согласию по ее поводу, приходилось продираться через страницы деталей, о которых никто не просил.
Мы сделали шаг назад и установили простую форму: требование описывает бизнес-потребность, целевую аудиторию (персонаж пользователя) и критерии приемки (как мы поймем, что задача выполнена). Дизайн должен оставаться в проектной документации. ИИ по-прежнему составляет черновики и проверяет наши истории, но теперь — в рамках этой формы.
Вывод закрепился: ИИ позволяет делать длинные документы дешево. В дефиците же — согласие всех участников по поводу того, что действительно важно.
Работающий пользовательский интерфейс раньше дизайна
Наша команда UX только начинала осваивать ИИ, когда инженерам потребовались экраны. Поэтому мы перевернули привычный порядок: для первой итерации ИИ создал рабочий пробный интерфейс прямо на основе требований.
Этот прототип стал основой для команды UX. Исходя из этого, они опробовали два подхода: классический дизайн в Figma и рабочие HTML-макеты, которые они создали сами.
Ранние интерфейсы, сгенерированные ИИ, выглядели неплохо, но не соответствовали стандартам дизайна Cisco. Поэтому команда UX превратила эти стандарты в навыки ИИ и MCP-сервер, и теперь сгенерированный интерфейс соответствует требованиям с первого дня, не требуя доработки. У команды UX есть своя история, в том числе о том, как сравнить эти два подхода.
От автодополнения к полноценным функциям
Инструменты наших инженеров развивались по ходу проекта:
- Сначала: автодополнение кода в VS Code с помощью GitHub Copilot и в Cursor. Это помогало, но ранняя генерация кода с помощью ИИ была недостаточно надежной, чтобы полностью на нее полагаться.
- Как только инструмент Claude Code стал доступен нашей команде в Cisco: агент, пишущий полноценные функции с тестами на основе требований.
Учитывая масштаб кодовой базы (новое ядро на Go, новый движок сайтов на Go и новый интерфейс администратора), именно этот сдвиг принес наибольшую экономию времени. Возможность передавать в работу целые функции, а не просто быстрее набирать текст, сыграла решающую роль.
Безопасность была причиной перезапуска, и в этом вопросе компромиссы не допускались. Каждый новый сервис следует современным рекомендациям для Go и опирается на тот же безопасный базовый образ, который мы используем для всех наших новых защищенных сервисов.
Проверка стала «узким местом»
Каким бы качественным ни был сгенерированный код, наша политика ревью не изменилась: любое изменение требует проверки человеком. На раннем этапе именно здесь мы и замедлились. Код поступал быстрее, чем люди успевали его проверять.
Поэтому мы привлекли ИИ и на сторону проверяющих. Мы создали навыки рецензирования для Go, Python и React, а также двух агентов проверки: одного, которого инженеры запускают локально перед открытием pull request, и другого, который проверяет сам pull request. Они находят проблемы и объясняют их. Окончательное решение и одобрение по-прежнему остаются за человеком.
Это был не последний раз, когда ускорение одного этапа переносило «узкое место» на следующий.
Тестирование: самая пугающая часть
Тестирование не давало нам спать по ночам. PubHub публикует сотни проектов документации, созданных тысячами технических писателей, архитекторов API, инженеров и инженеров по техническому маркетингу (TME). Если бы новая платформа создавала или отрисовывала контент хотя бы немного иначе, кто-нибудь обязательно заметил бы это на публичной странице. И дело не только в контенте: авторы ежедневно зависят от рабочего процесса сборки, проверки и публикации.
ИИ помог нам создать систему безопасности для обоих направлений:
- Контент: фреймворк сравнения, который проверяет десятки тысяч страниц, собранных в результате перезапуска, с производственной версией, чтобы ни одно отличие не стало для читателей неожиданностью.
- Рабочие процессы: агенты ИИ, управляющие headless-браузером при выполнении сложных сценариев интерфейса, что многократно сократило объем ручного тестирования.
Инженеры проверяли то, что сгенерировал ИИ. Фреймворки выполняли рутинную проверку в масштабах, с которыми ни одна команда не справилась бы вручную.
Результат проявился после запуска: с тех пор не было зарегистрировано ни одной критической или высокоприоритетной проблемы. При появлении мелких недочетов отладка с помощью ИИ позволяет гораздо быстрее находить исправления. Инженеры, создавшие эти фреймворки, подробно расскажут о них в следующих публикациях серии.
Наше руководство по ЖЦПО на базе ИИ
Ничто из этого не задумывалось как готовое руководство. Каждая практика начиналась как способ исправить то, что мешало работать. В совокупности они выглядят так:
- Сначала документируйте устаревшую систему. Позвольте ИИ прочитать старый код, а экспертам — проверить то, что он написал.
- Сокращайте требования. Бизнес-потребность, персонаж, критерии приемки. Дизайн создается в другом месте.
- Создайте рабочий прототип, затем займитесь дизайном. Заложите систему дизайна в правила ИИ, чтобы его результаты соответствовали стандартам с самого начала.
- Поручайте ИИ функции целиком, а не отдельные строки. Требования к безопасности не подлежат обсуждению.
- Дайте проверяющим ИИ-помощников. Одобрение каждого изменения по-прежнему остается за человеком.
- Тестируйте в машинном масштабе. Сравнивайте десятки тысяч страниц и автоматизируйте рабочие процессы.
- Будьте готовы к смещению «узких мест». Перестраивайте планы, когда это происходит.
Практики, доказавшие свою эффективность, превратились в многократно используемые навыки. К моменту запуска команда создала или внедрила более 20 навыков и двух агентов рецензирования:
Две области пока не имеют выделенного навыка: само кодирование (где инженеры работают с агентом напрямую) и операционная деятельность.
Что дальше
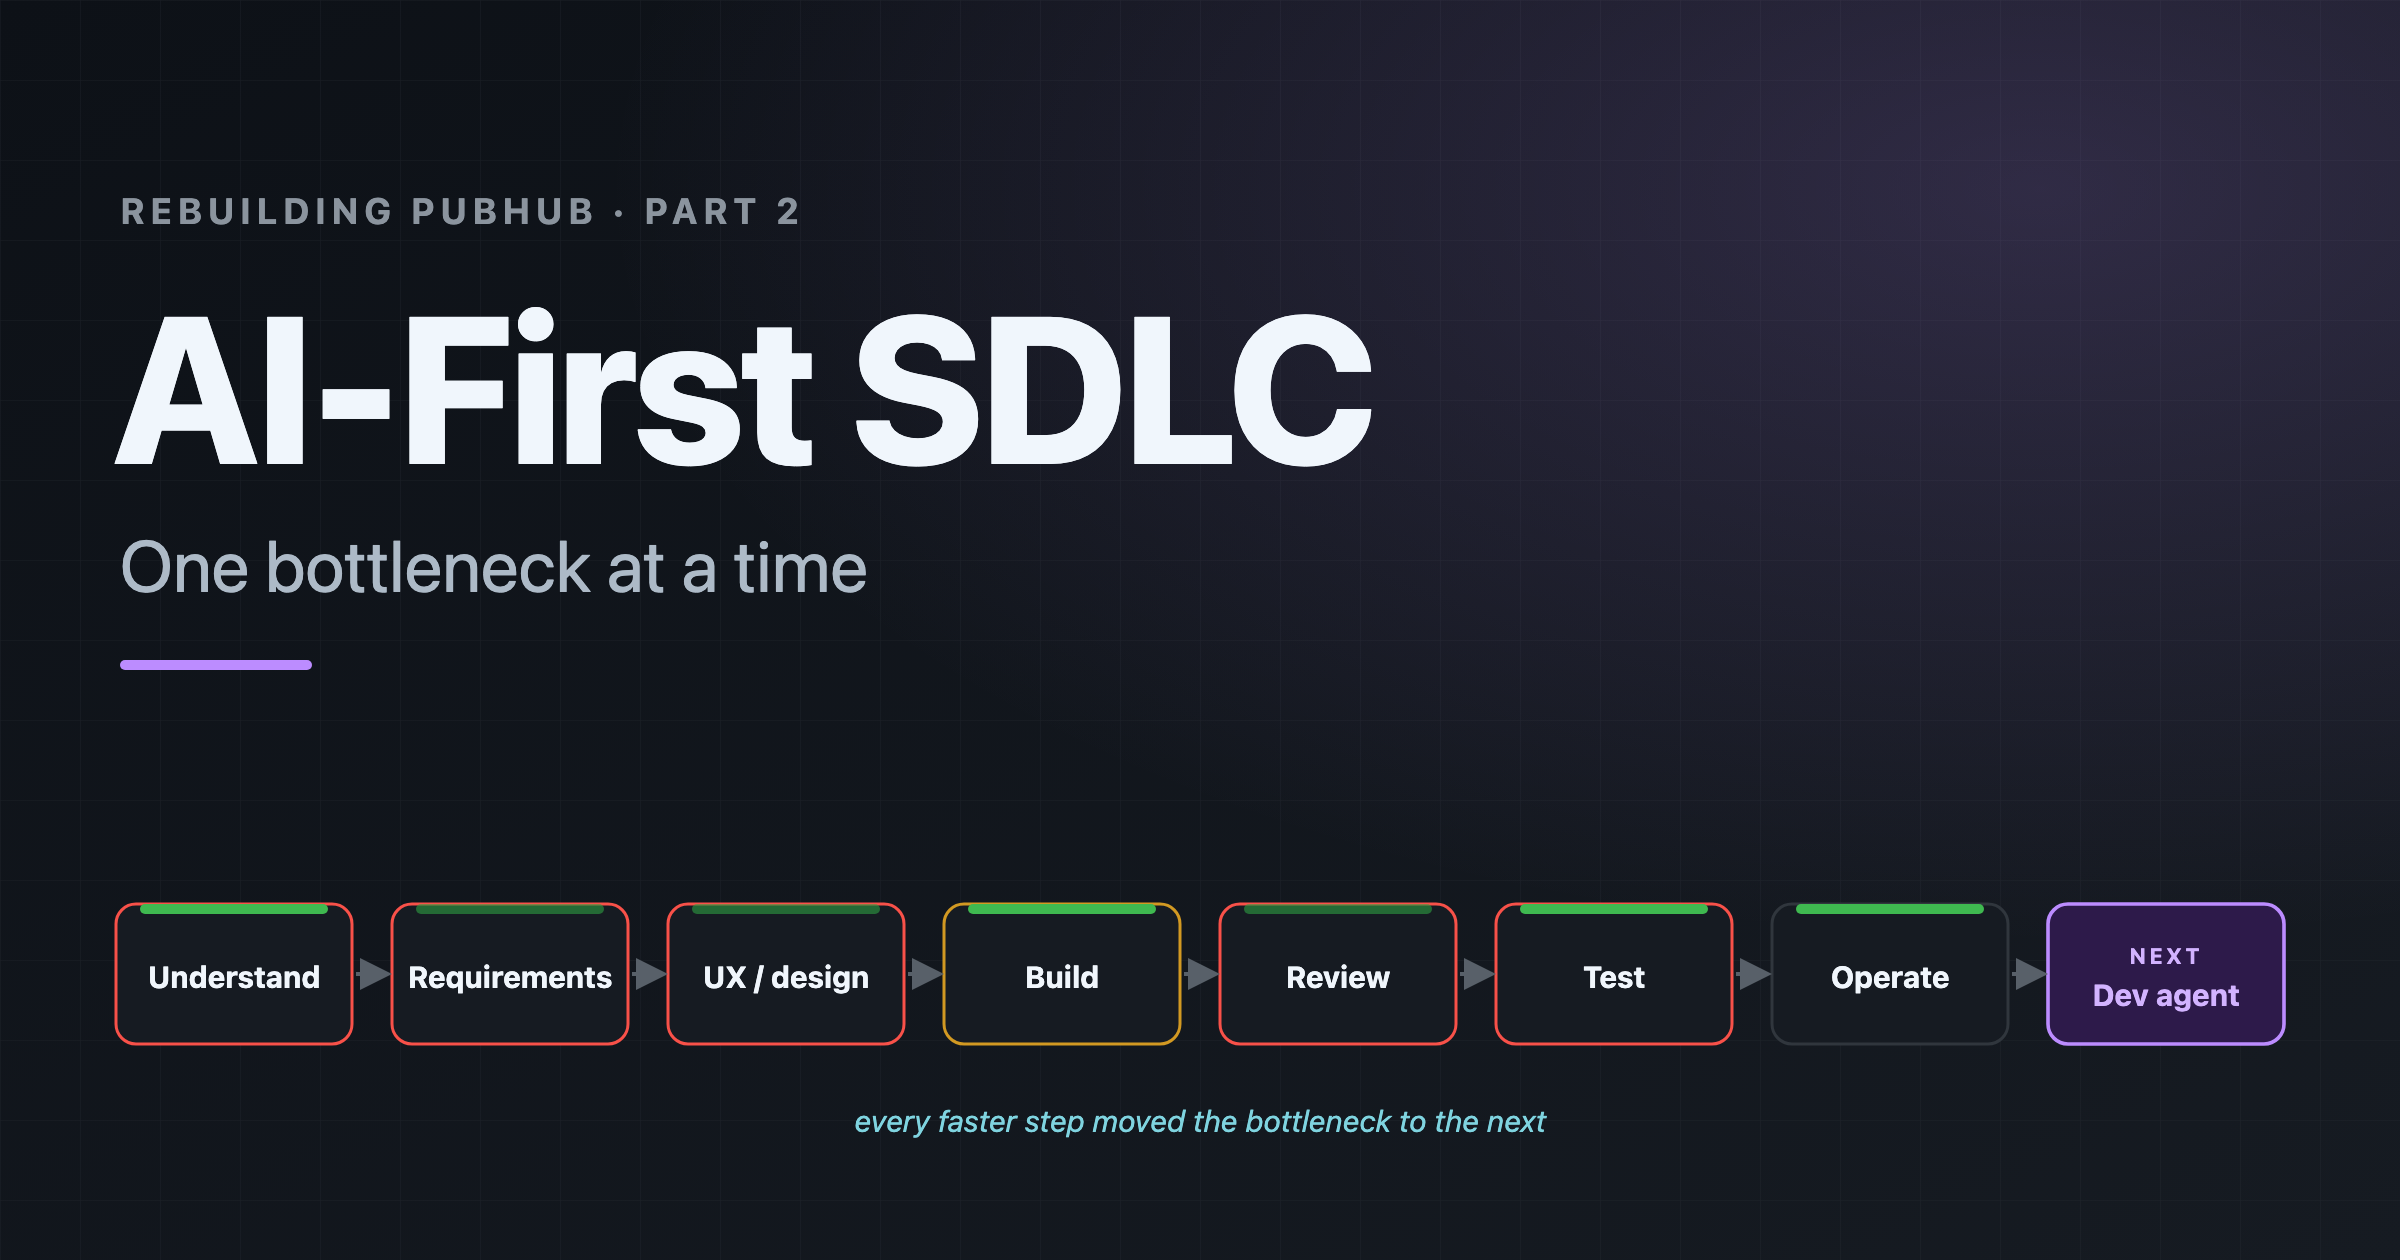
Взгляните на тепловую карту, и в глаза бросится одна закономерность: каждый раз, когда мы ускоряли какой-то этап, узкое место смещалось на следующий. Теперь, когда почти каждый этап нашего AI-first SDLC стал быстрее, узкое место находится в промежутках между ними. Файлы памяти проекта помогают в рамках одного репозитория, но при работе с более чем 15 репозиториями и многолетней историей контекст, связывающий требование с его проектированием, кодом, ревью и тестами, по-прежнему хранится в головах людей.
Именно над этой проблемой мы работаем дальше: агент-разработчик PubHub, который знает проект так же хорошо, как и давно работающий член команды, включая его архитектуру, историю, правила и нерешенные задачи. Он создан для того, чтобы выполнять работу от задачи до пул-реквеста по тому же правилу, что и все мы: человек одобряет каждое изменение. Мы покажем, как это работает, в конце этой серии.
А пока следите за тем, как каждая команда подробно разбирает свой этап. И расскажите нам: куда ИИ сместил узкое место в вашем SDLC?