Почему созданный ИИ код не попадает в продакшен?
В этом году многое изменилось: инженерные команды перестали просто экспериментировать с ИИ-программированием и начали использовать его на системном уровне. Согласно данным «State of Code Developer Survey 2026» от компании Sonar, сегодня разработчики оценивают объем создаваемого или поддерживаемого с помощью ИИ кода в 42% от всех фиксируемых ими коммитов, а к 2027 году этот показатель, по их прогнозам, достигнет 65%.
Хотя ИИ значительно ускорил генерацию кода, именно этап приемки стал источником основных трудностей. Самая свежая отраслевая телеметрия наглядно это подтверждает: Faros AI's 2026 AI Engineering Report, опираясь на данные 22 000 разработчиков ПО, зафиксировала рост медианного времени ревью pull request (PR) на 441%, увеличение размера pull request на 51.3%, рост числа багов на одного разработчика на 54% и увеличение инцидентов на один PR на 242.7%, даже несмотря на то, что пропускная способность задач выросла на 33.7%. Время, сэкономленное на генерации кода, тратится заново на последующих этапах — при ревью, тестировании и исправлении того, что создал агент.
Это и есть разрыв приемки, и его преодоление — главная задача современной разработки с использованием ИИ.
Почему pull request'ы от ИИ объединяются (merge) дольше?
Попадание pull request в очередь означает запрос на принятие ряда решений: принять его, интегрировать, проверить и запустить в продакшн без ущерба для системы. Ошибка заключается в том, чтобы воспринимать его как готовое к поставке ПО.
Эти два понятия постоянно путают. Фраза «Агент сгенерировал 3 000 строк» звучит как прогресс, однако реальным мерилом является то, были ли эти строки успешно объединены, выдержали ли они нагрузку в продакшене и не породили ли три дополнительных исправления.
Противоречие очевидно: генерация происходит со скоростью машины, в то время как приемка — со скоростью вашего цикла проверки кода. Когда эти две скорости расходятся, сгенерированный код превращается в дорогую очередь, а не в готовую ценность. LinearB's 2026 Engineering Benchmarks приводит конкретные цифры: pull request'ы, созданные с помощью ИИ, мержатся примерно в два раза реже написанных людьми, оказываются примерно в 2.5 раза больше по размеру и ждут ревьюера примерно в 5 раз дольше.
Что мешает созданному ИИ коду пройти путь до продакшена?
Если проследить за зависшими изменениями от ИИ, обычно обнаруживаются одни и те же узкие места:
- Циклы переработки (доработки). 2026 empirical study of AI-authored commits показала, что более 15% коммитов от каждого исследованного ИИ-помощника содержали хотя бы одну проблему, а 24.2% отслеженных проблем, внесенных ИИ, дожили до последней ревизии репозитория. Каждая из таких проблем требует повторного прохождения пути.
- Очередь ревью и перегрузка. Люди следуют советам ИИ примерно в 80% случаев, даже когда они ошибочны (Shaw and Nave, Wharton, 2026). Изменения, сгенерированные агентами, могут поступать в больших объемах и быстрее, чем процессы ревью способны их обработать, из-за чего многое либо одолевается автоматически («для галочки»), либо застревает.
- Нестабильные и падающие тесты. Сбой сборки или поломка теста возвращают изменения в самое начало цикла: обратно в локальную среду, обратно к агенту, обратно к исходной точке.
- Запоздалое обнаружение уязвимостей. GitClear's June 2026 Maintainability Gap report, охватывающая 623 миллиона изменений кода, показывает рост копирования/вставки в рамках одного коммита на 41%, дублирования блоков кода на 81% и конструкций, маскирующих ошибки, на 47%. Именно такие паттерны всплывают как проблемы с безопасностью и надежностью уже после слияния веток.
- Проблемы интеграции. Конфликты слияния, дрифт окружения и несоответствие контрактов возникают именно потому, что у агентов отсутствует архитектурный контекст вашей кодовой базы.
Здесь стоит заметить одну закономерность: практически все это — симптомы поздней верификации, а не проблемы генерации. Это проблемы, которые обнаруживаются уже после того, как агент завершил работу и момент для их дешевого исправления упущен.
Какие метрики следует отслеживать инженерным командам для созданного ИИ кода?
Если объем — это неверная метрика, то какая же правильная? Нужна небольшая общая система показателей, которая отслеживает, становится ли сгенерированный код работающим продуктом:
- Уровень приемки (Acceptance rate) — доля изменений, написанных ИИ, которые дошли до ветки main.
- Время до слияния (Time-to-merge) — сколько времени изменение ждет между созданием и слиянием.
- Уровень доработки (Rework rate) — частота изменений в файлах, созданных ИИ, в течение N дней после слияния.
- Пропущенные дефекты (Escaped defects) — баги и уязвимости, обнаруженные после слияния.
- Длительность CI (CI duration) — сколько времени требуется пайплайну для выдачи результата.
Эти показатели отлично согласуются с концепциями DORA, которые измеряют пропускную способность и стабильность, а не сырой объем результатов. 2026 DORA report приходит к тому же выводу: написание большего объема кода и более быстрый выпуск PR сами по себе не означают, что команда приносит больше ценности, а код-ревью — это именно тот этап, на котором ROI от ИИ либо реализуется, либо теряется. Узкое место сместилось с написания кода на доверие к нему, достаточное для его релиза.
Где пересекаются затраты и качество?
Разрыв приемки — это точка пересечения затрат на ИИ и качества ИИ-кода. Каждый запоздалый баг, найденная уязвимость, упавший тест или неясное изменение возвращают рабочий процесс в новый виток генерации, ревью и верификации кода. Именно поэтому проблема затрат не может быть решена только за счет бюджетов, а проблема качества — только за счет ручного ревью.
Как сократить объем доработок кода, созданного ИИ?
Разрыв приемки — это фундаментально проблема времени верификации, и ее решение заключается в том, чтобы перенести верификацию на более ранние этапы, сделав обратную связь быстрой, конкретной и действенной. Это означает внедрение проверок в IDE, на этап pre-commit и непосредственно в собственный цикл рассуждений агента.
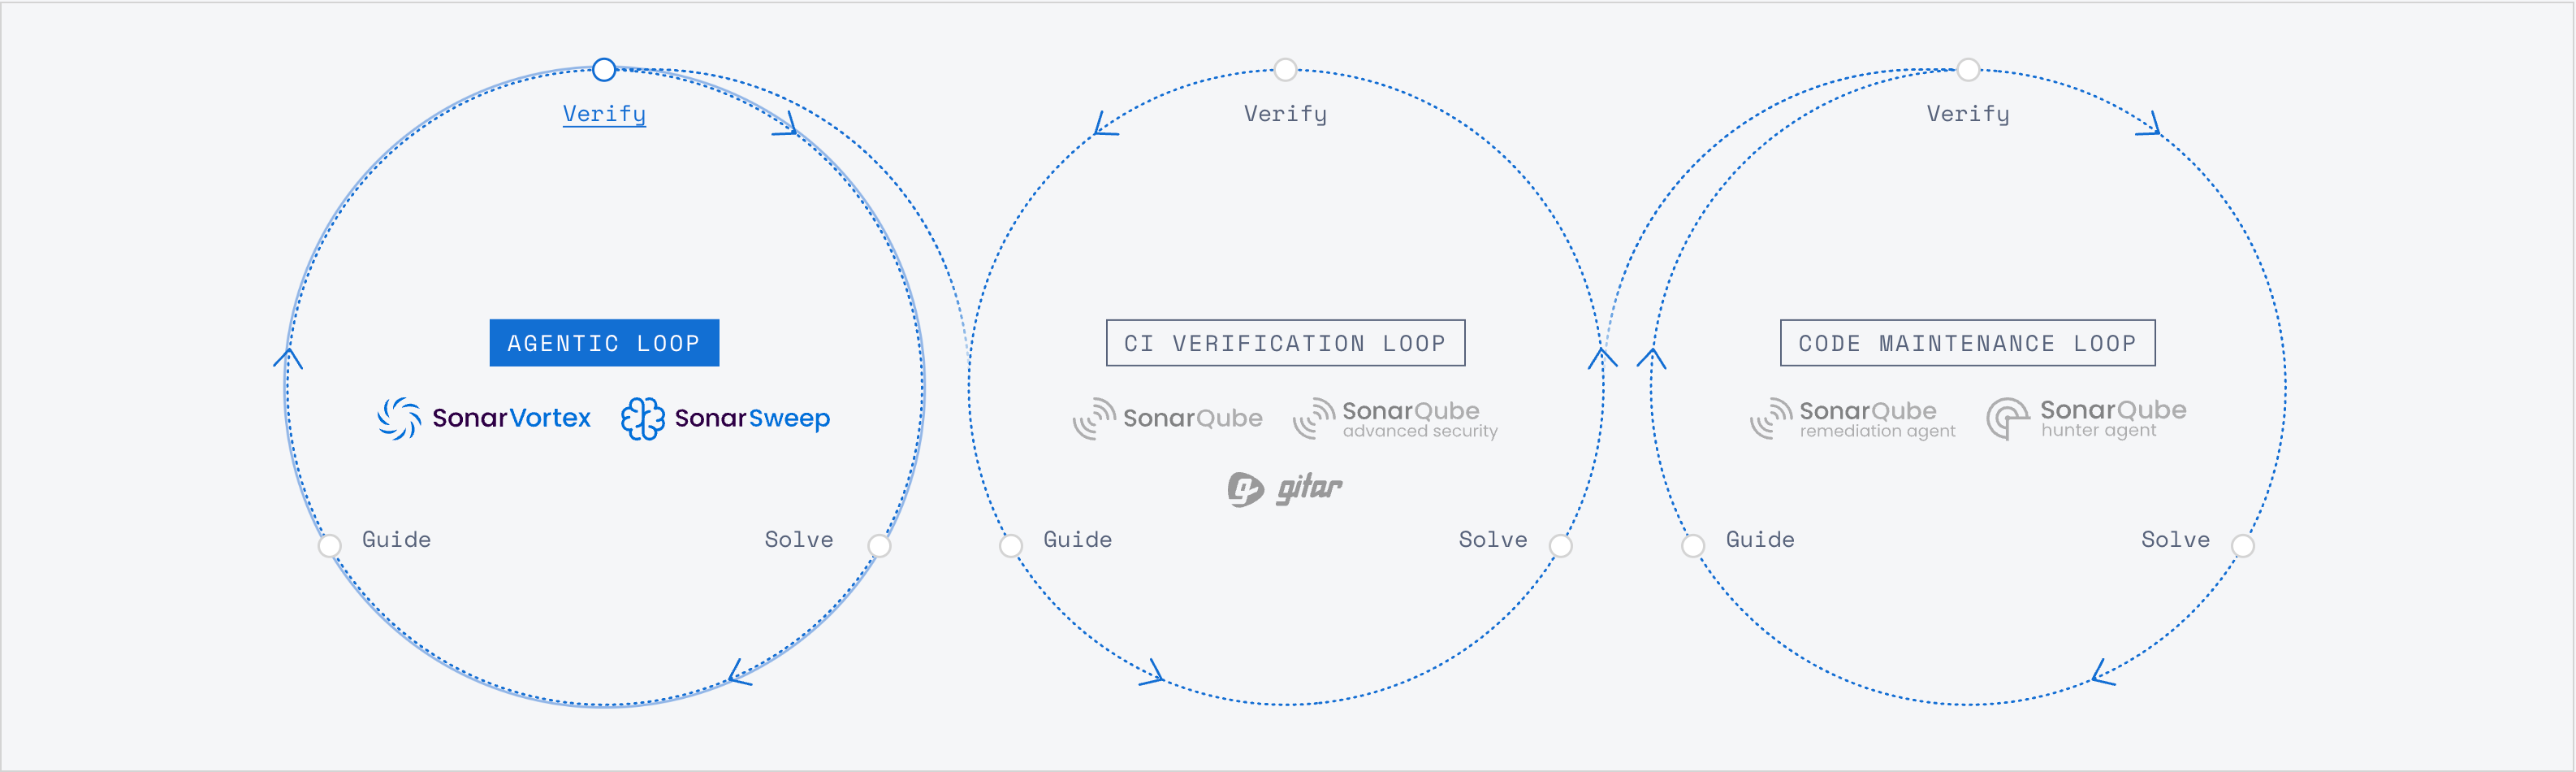
Именно здесь находят свое естественное применение концепция Guide-Verify-Solve от Sonar и цикл разработки с упором на агентов (Agent-Centric Development Cycle, AC/DC). Верификация кода перестает быть барьером в самом конце и становится постоянным процессом, сопровождающим всю работу:
- Направляйте (Guide). Предоставьте агентам правильный контекст и ограничения (архитектуру, стандарты, защитные механизмы) до того, как они начнут писать код, чтобы первый вариант с большей вероятностью был принят, а не отправлен на доработку.
- Проверяйте (Verify). Применяйте многоуровневую верификацию по принципу «нулевого доверия» (zero-trust) в отношении качества, безопасности и комплаенса, независимо от того, что именно сгенерировало код. Многоуровневая проверка объединяет детерминированный анализ с рабочими процессами на базе ИИ, помогая командам находить проблемы раньше, не полагаясь исключительно на саму модель.
- Решайте (Solve). Передавайте точные находки на этап исправления вместо расплывчатых запросов «попробуй еще раз», чтобы сократить количество повторных попыток, а люди могли проверять замысел (интент), а не синтаксис.
Цель состоит в том, чтобы сделать каждый цикл дешевле и лучше предыдущего, а не в том, чтобы заставить ревьюеров работать интенсивнее. Лучшее руководство означает меньше найденных проблем; меньше проблем означает более быструю верификацию; а то, чему вы научились в процессе решения, возвращается в качестве рекомендаций для улучшения следующего этапа.
Кумулятивный эффект работает в обеих направлениях. Исследование Sonar, посвященное более чистым кодовым базам, показало сокращение входящих токенов на 7.2%, исходящих — на 8.5% и снижение расчетных затрат на рассуждения примерно на 11% без какого-либо заметного влияния на выполнение задач. Экономия токенов достигается, по-видимому, за счет менее избыточного поиска: агенты реже возвращались к уже пройденным файлам, быстрее переходили к правкам и тратили меньше усилий на логику при работе с качественным кодом. Параллельно с этим исследование Sonar Vortex выявило снижение потребления токенов и затрат на один запуск до 36% при выполнении сложных задач рефакторинга с интенсивной навигацией, в ходе которых агенты в противном случае тратили бы токены на повторяющийся поиск, чтение файлов и восстановление структурных связей. Если пренебрегать верификацией, накопится обратный эффект: исследователи из Университета Карнеги — Меллон зафиксировали трех- пятикратный всплеск добавленных строк в первый месяц использования Cursor, который сошел на нет через два месяца, сменившись постоянным ростом предупреждений статичного анализа на 30% и увеличением сложности кода на 41%.
Как измерить рентабельность инвестиций (ROI) в инструменты программирования на базе ИИ?
Единственный важный вопрос об окупаемости заключается в том, позволяет ли ваш цикл верификации превращать результаты работы ИИ в реальную ценность или же они уходят впустую из-за переделок и лишних затрат токенов.
Рассматривайте это через призму трех категорий:
- Затраты на токены и инструменты в сравнении с сэкономленным временем инженеров — меньше циклов проверки, меньше переделок, меньше запросов на полную регенерацию кода.
- Предотвращенные издержки на качество — меньше пропущенных дефектов, меньше исправлений, снижение рисков взломов и сбоев.
- Полученная бизнес-ценность — более быстрая доставка принятых изменений, меньше блокировок релизов и высвобождение инженерных ресурсов для более важных задач.
И это не просто теория, это работает в реальных корпоративных условиях. Cisco использовала автоматизированную верификацию для исправления 27 000 проблем в коде в рамках одной программы за три месяца. Некоторые команды Cisco сообщили о росте производительности до 3 раз, и, что критически важно, их метрики показывают, что по мере увеличения скорости плотность дефектов фактически снижалась. Именно так на практике выглядит устранение разрыва в принятии кода: верификация работает синхронно с разработкой при поддержке ИИ, поэтому увеличение объема поставляемого кода не означает увеличение рисков.
Как инженерным командам устранить разрыв в принятии ИИ-кода?
Устранение разрыва в принятии — это кросс-функциональная задача. Объедините команды разработки, платформенных инженеров, безопасности и финансов вокруг единой системы показателей: уровень принятия, время до слияния (time-to-merge), объем переделок, количество пропущенных дефектов и стоимость одного принятого изменения.
Примерный план на 30/60/90 дней:
- Первые 30 дней: Настройте систему показателей. Установите базовые значения для уровня принятия, времени до слияния, переделок и пропущенных дефектов в изменениях, созданных ИИ.
- Следующие 30 дней: Перенесите верификацию на более ранние этапы. Внедрите проверки в IDE и агентский цикл, чтобы агенты получали быстрые и конкретные сигналы еще до создания PR.
- Последние 30 дней: Замкните цикл с помощью автоматизированного исправления и последовательных шлюзов качества, а затем отслеживайте, снижается ли стоимость одного принятого изменения.
Итог
ROI от ИИ-инструментов программирования определяется не тем, сколько кода было сгенерировано, а тем, насколько эффективно этот код проходит верификацию, принимается и поставляется. Роль Sonar заключается в том, чтобы сделать этот цикл принятия более ранним, дешевым и надежным.
Своевременная верификация кода — это то, что превращает код, созданный ИИ, в готовое программное обеспечение. Без нее генерация кода становится лишь более дорогостоящей очередью.
Оцените рабочий процесс разработки ПО с ИИ в вашей команде
Готовы узнать, где ваш разрыв в принятии кода наиболее широк? Есть два способа начать:
- Посмотрите на SonarQube в действии — запустите пробную версию и настройте базовые показатели уровня принятия, времени до слияния, переделок и пропущенных дефектов за один день.
- Свяжитесь с нашей командой — разберите ваш текущий рабочий процесс разработки с ИИ вместе с экспертом Sonar и определите, где быстрее всего можно внедрить верификацию на ранних этапах.