Краткий обзор
Перевод агента SonarQube Remediation Agent на Claude Opus 5.5 улучшил каждый отслеживаемый нами показатель качества и снизил стоимость каждого исправления примерно на 58%.
- Полностью решенные проблемы, не требующие ручной доработки: рост на 11,9%
- Изменения, признанные готовыми к слиянию в исходном виде: рост на 15,8%
- Стоимость одного исправления: снижение примерно на 58%
- Процент прохождения функциональных тестов: рост на 0,3%, то есть без изменений
- Затраченное время на одну проблему: рост на 4%
Сокращение затрат такого масштаба обычно сказывается где-то в другом месте — в виде увеличения объема доработок или исправлений, которые незаметно что-то ломают. Но не в этот раз. Улучшился каждый показатель качества, а единственным значением, которое немного отклонилось, стало время выполнения (рост на 4%), что настолько мало, что фактически означает стабильность.
SonarQube Remediation Agent работает с бэклогом. Вы назначаете ему проблемы со страницы проблем SonarQube или настраиваете его запуск по расписанию для вашей основной ветки. После этого он работает самостоятельно. Никаких подсказок и диалогов.
Сами исправления пишутся с помощью LLM, причем вашей, а не нашей. Вы добавляете в свою организацию SonarQube Cloud API-ключ OpenAI или Anthropic (можно до трех) и выбираете, какой из них будет использовать агент. Сервис исправления от Sonar отправляет затронутый фрагмент кода этому провайдеру, поэтому запрос выполняется под вашей собственной учетной записью и в соответствии с пользовательским соглашением вашего провайдера, а инференс выставляется вам напрямую, а не включается в вашу подписку.
Вы выбираете только провайдера. Модель, стоящую за ним, выбирает Sonar и поддерживает ее в актуальном состоянии, чему и посвящен данный пост. Для Anthropic этой моделью теперь является Claude Opus 5.5.
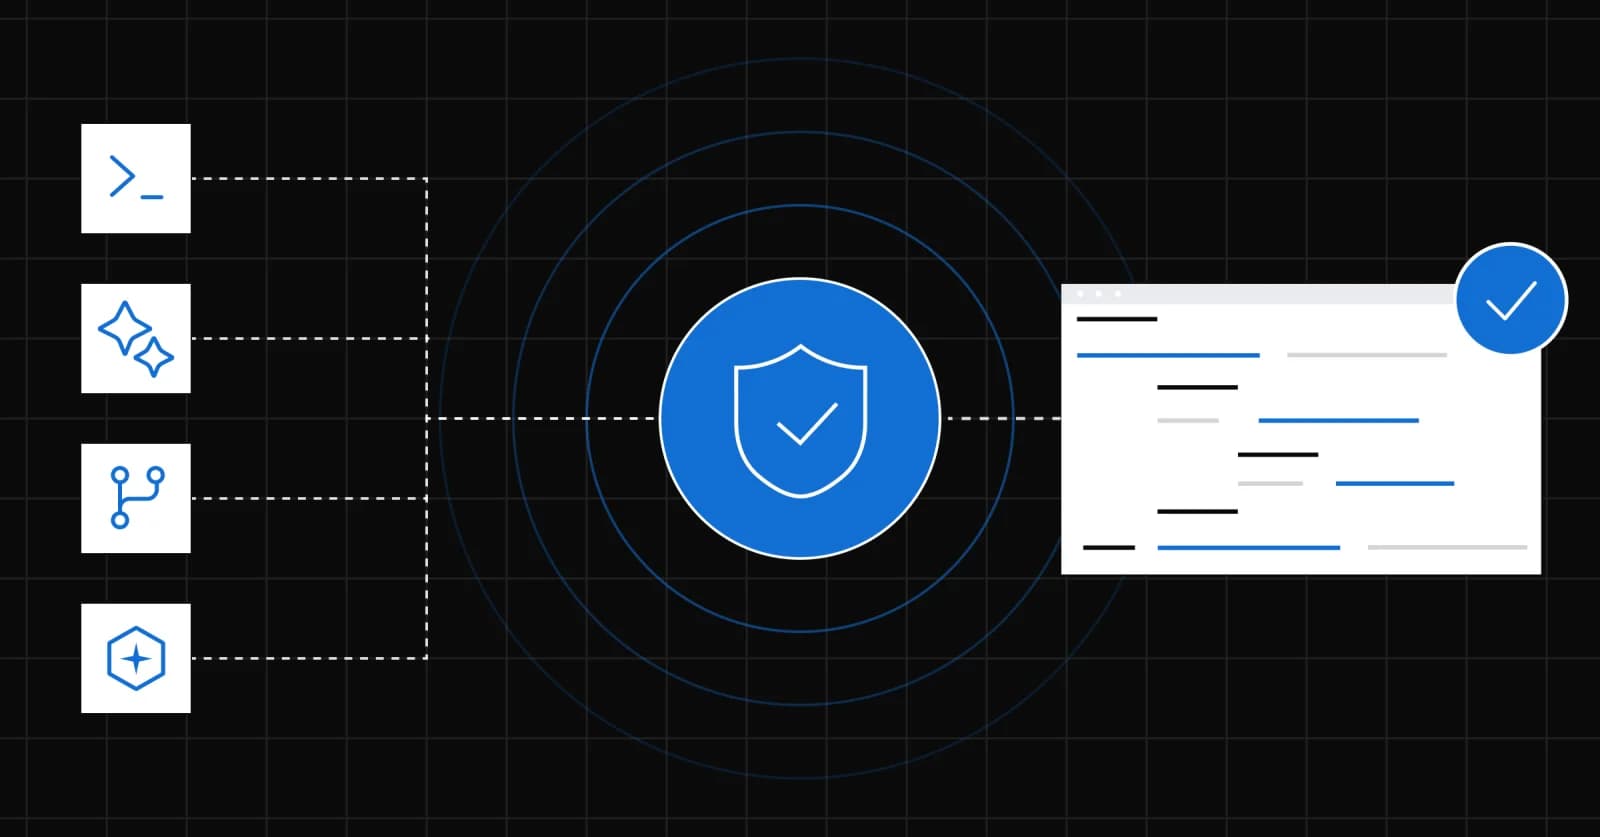
Самое важное для данной оценки происходит до того, как вы что-либо увидите. Агент генерирует исправление, применяет его в песочнице и повторно запускает анализ Sonar для полученного результата. Если проблема все еще на месте или исправление создало новую, эта попытка отбраковывается, и выполняется повторная попытка. Только те исправления, которые прошли проверку, превращаются в пул-реквесты, которые ваша команда затем проверяет и объединяет в рамках стандартного рабочего процесса.
Именно этот цикл объясняет, почему качество модели так проявляет себя в этих цифрах. Модель, которая выдает результаты «почти попавшие в цель», тратит попытки внутри песочницы и в итоге исчерпывает их лимит, что со стороны выглядит как проблема, с которой агент не справился. Поэтому вопросы, которые мы задаем новой модели, весьма конкретны. Завершила ли она работу? Принял бы ревьюер результат? Не сломало ли это что-нибудь? Какова цена?
Может ли агент на базе ИИ решать проблемы SonarQube без участия человека?
Доля проблем, решенных агентом от начала и до конца, выросла на 11,9%.
Opus 5 оставляла небольшой хвост не до конца решенных проблем. Кому-то приходилось возвращаться к результатам запуска и устранять их вручную. Opus 5.5 закрывает этот хвост, а это значит, что запуск больше не требует ручной доработки вслед за агентом.
Это результат, который волнует нас больше всего, и причина этого очевидна. Неразрешенная проблема возвращается на стол к человеку независимо от того, насколько быстрым и дешевым был этот подход. Стоимость одной попытки имеет значение только тогда, когда эта попытка обычно работает.
Больше исправлений, которые ревьюер может принять как есть
Именно здесь мы увидели наибольший прирост — 15,8%.
Мы хотим внести ясность в то, как мы это измеряем. Мы не считаем, сколько пул-реквестов ревьюеры в итоге объединили. Мы оцениваем каждое изменение автоматически по одному вопросу: принял бы ревьюер это как есть или отправил бы на доработку? Это дает нам одинаковое понимание каждой проблемы в тесте, чего нельзя добиться подсчетом реальных слияний в разных командах.
Поэтому мы рассматриваем это скорее как сильный индикатор, чем как процент слияний. Он говорит нам, что бóльшая часть того, что производит агент, — это не просто работающий код, а нечто близкое к изменениям, которые ревьюер написал бы сам.
Для нас это ценно так же, как и коэффициент устранения. Исправление, требующее трех раундов ревью перед принятием, уже стоило команде реального времени, независимо от затрат на его генерацию.
Процент прохождения функциональных тестов изменился на 0,3%, то есть остался прежним.
В этом и заключается суть. Процент устранения и готовность к слиянию выросли, и не потому, что агент начал вольно обращаться с поведением системы. Тесты подтверждают то, что код должен делать, и они проходят с тем же успехом, что и раньше. Полученные приросты реальны, а не являются компромиссом в отношении качества, замаскированным под улучшение.
Если бы этот показатель упал в то время как два других выросли, у нас был бы другой разговор о том, на что на самом деле была направлена оптимизация агента.
Средняя стоимость одного исправления снизилась примерно на 58%, и эта экономия достается вам, а не нам. Поскольку агент работает с вашим ключом провайдера, инференс оплачивается с вашего собственного счета OpenAI или Anthropic. Снижение на 58% — это скидка 58% в вашем инвойсе, а не на абстрактную цифру, которую вы никогда не видите.
Сопоставьте это с более высоким процентом устранения, и эффективная стоимость успешно решенной проблемы упадет еще сильнее, поскольку бóльшая часть того, за что вы платите, теперь приводит к готовому исправлению, а не к частичному.
Причина, почему это важно, заключается не в отдельной строке расходов. Дело в том, что сокращение затрат на 58% меняет то, как вы можете разумно использовать агента. При прежней стоимости запуск его по всему большому бэклогу был чем-то, что приходилось нормировать и тщательно оценивать. При стоимости значительно ниже половины этого значения нацеливание агента на весь бэклог перестает быть вопросом бюджета. Команды с годами накопленных результатов проверки ощущают это сильнее всего.
Среднее затраченное время на одну проблему выросло на 4%.
Это единственный показатель в оценке, который пошел в нежелательную сторону, и мы говорим о нем открыто, а не прячем в сноске. Значение в 4% можно считать стабильным показателем, и это легкая плата за снижение затрат на 58% и улучшение результатов по всем остальным параметрам.
Единственный случай, когда это имеет значение — это пути, чувствительные к задержкам, где от агента ожидается возвращение исправления в жестких временных рамках. Если вы планируете использовать его именно так, вам стоит следить за этим показателем. Для работы с бэклогом, для которой агент используется в большинстве случаев, 4% — это просто погрешность.
Что это значит, если вы используете агента
Ничего не меняется в том, как вы им пользуетесь. Модель, лежащая в основе агента, — это наш выбор, который мы поддерживаем в актуальном состоянии; это часть того, что вы получаете от управляемого агента, а не от того, который вы настраиваете самостоятельно. Вам не нужно оценивать модели, вести переговоры о ценах или что-либо мигрировать.
Меняется экономика, а вместе с ней и масштаб того, что стоит пытаться сделать. Больше проблем возвращается решенными. Больше результатов готовы к слиянию. Каждое исправление стоит меньше половины прежнего. Если раньше вы смотрели на свой бэклог и выбирали верхнюю его часть, разрешенную бюджетом, теперь этот расчет выглядит иначе.
Мы продолжим публиковать эти оценки по мере перевода агента на новые модели. В таблице лидеров Sonar LLM представлен наш независимый анализ Opus 5.5 и каждой другой измеряемой нами модели, включая качество кода и профиль безопасности того, что каждая из них пишет с нуля. Этот пост — вторая половина этой работы: то, что делает модель, когда ее задача заключается в исправлении кода, а не в его создании.
Посмотрите, как это повлияет на ваш бэклог
Каждая цифра выше измерена на нашем бенчмарке. Единственная цифра, которая имеет для вас значение — это та, которую вы получаете на собственном коде, с вашим собственным профилем качества и в ваших собственных репозиториях.
Если вы уже используете SonarQube Cloud, агент по устранению уязвимостей и технического долга (Remediation Agent) доступен в рамках Sonar Agent Essentials на планах Team и Enterprise. Добавьте ключ провайдера, назначьте категорию технического долга на странице проблем (Issues), и первые проверенные пулл-реквесты поступят без необходимости писать какой-либо промпт.
Если вы еще не используете его, самый быстрый способ оценить его в деле — посмотреть, как он работает с реальной кодовой базой.
Запросить демо · Узнать больше об агенте по устранению уязвимостей и технического долга · Читать документацию