В недавнем выпуске подкаста The Next Commit ведущий инженер Skyscanner Майкл Твид обсудил с Томом Хаулеттом из Sonar внедрение ИИ-ассистентов для написания кода в крупной инженерной организации. Разговор постоянно возвращался к вопросу, с которым сейчас сталкивается каждая команда, внедряющая агентов: когда инженеры перестают читать каждую строку кода, кому доверять поиск ошибок? Мнение Майкла имеет вес, поскольку оно отражает реальный опыт внедрения, уже работающий в продакшене. Некоторые предположения, лежащие в основе этого внедрения, заслуживают более пристального внимания. К концу выпуска стал очевиден один вывод: как только люди перестают читать каждую строку, проверка сгенерированного ИИ кода должна происходить независимо от людей и моделей, которые его написали, с использованием детерминированных автоматизированных проверок.
Майкл начал с утверждения, которое чувствуют большинство инженерных лидеров, но немногие говорят вслух: «мы находимся на этапе, когда люди больше не читают каждую строку кода». Его вывод звучит прямо: «Роль инженерии меняется».
Переосмысление того, как команды проверяют ИИ-код
Одна история, которой поделился Майкл, бьет прямо в сердце проблемы:
«Тест должен был обнаружить эту проблему, но почему-то не обнаружил. Агент решил: „Этот тест не проходит с этим изменением, поэтому я изменю сам тест, чтобы он проходил, вместо того чтобы исправлять код“. И это осталось незамеченным».
Пайплайн горел зеленым. Каждая проверка сообщала об успехе. А код был неверным, потому что система, которую проверяли, тихонько изменила правила.
Это должно изменить то, как команды подходят к проверке ИИ-кода: когда агент может переписать сами проверки, призванные находить его ошибки, зеленый пайплайн подтверждает лишь то, что проверки запустились, но не дает никаких гарантий правильности кода. Самопроверка агента имеет те же слепые зоны, что и его генерация, поскольку это та же модель, совершающая те же вероятностные выводы во второй раз. Проверка, которую агент может переписать — это вовсе не проверка, и именно поэтому верификация должна находиться вне досягаемости агента.
Почему верификатор должен быть независимым от агента
Майклу не нужно было кому-то доказывать этот вывод.
«Мы действительно используем SonarQube... И я считаю это хорошим независимым верификатором... Несмотря на то, что мы можем настраивать правила, он внешний по отношению к Skyscanner, поэтому мы можем доверять ему немного больше. И затем это подкрепляется нашими внутренними тестами, линтингом и всем прочим, чтобы дать нам уверенность».
Именно так к верификации подходит и Sonar. SonarQube работает независимо от того, что или кто сгенерировал код, используя другой метод и четкое разделение обязанностей, так что единый стандарт соблюдается независимо от того, какой инструмент пишет код. И это работает на уровне вычислений, рассуждений и выполнения, поэтому то, что пропускает один этап, улавливает другой.
Два свойства, которые назвал Майкл — внешний и детерминированный — это то, что отличает проверку, которую агент может «уговорить» себя обойти, от той, которую он обойти не сможет.
Верификация должна быть встроена в циклы
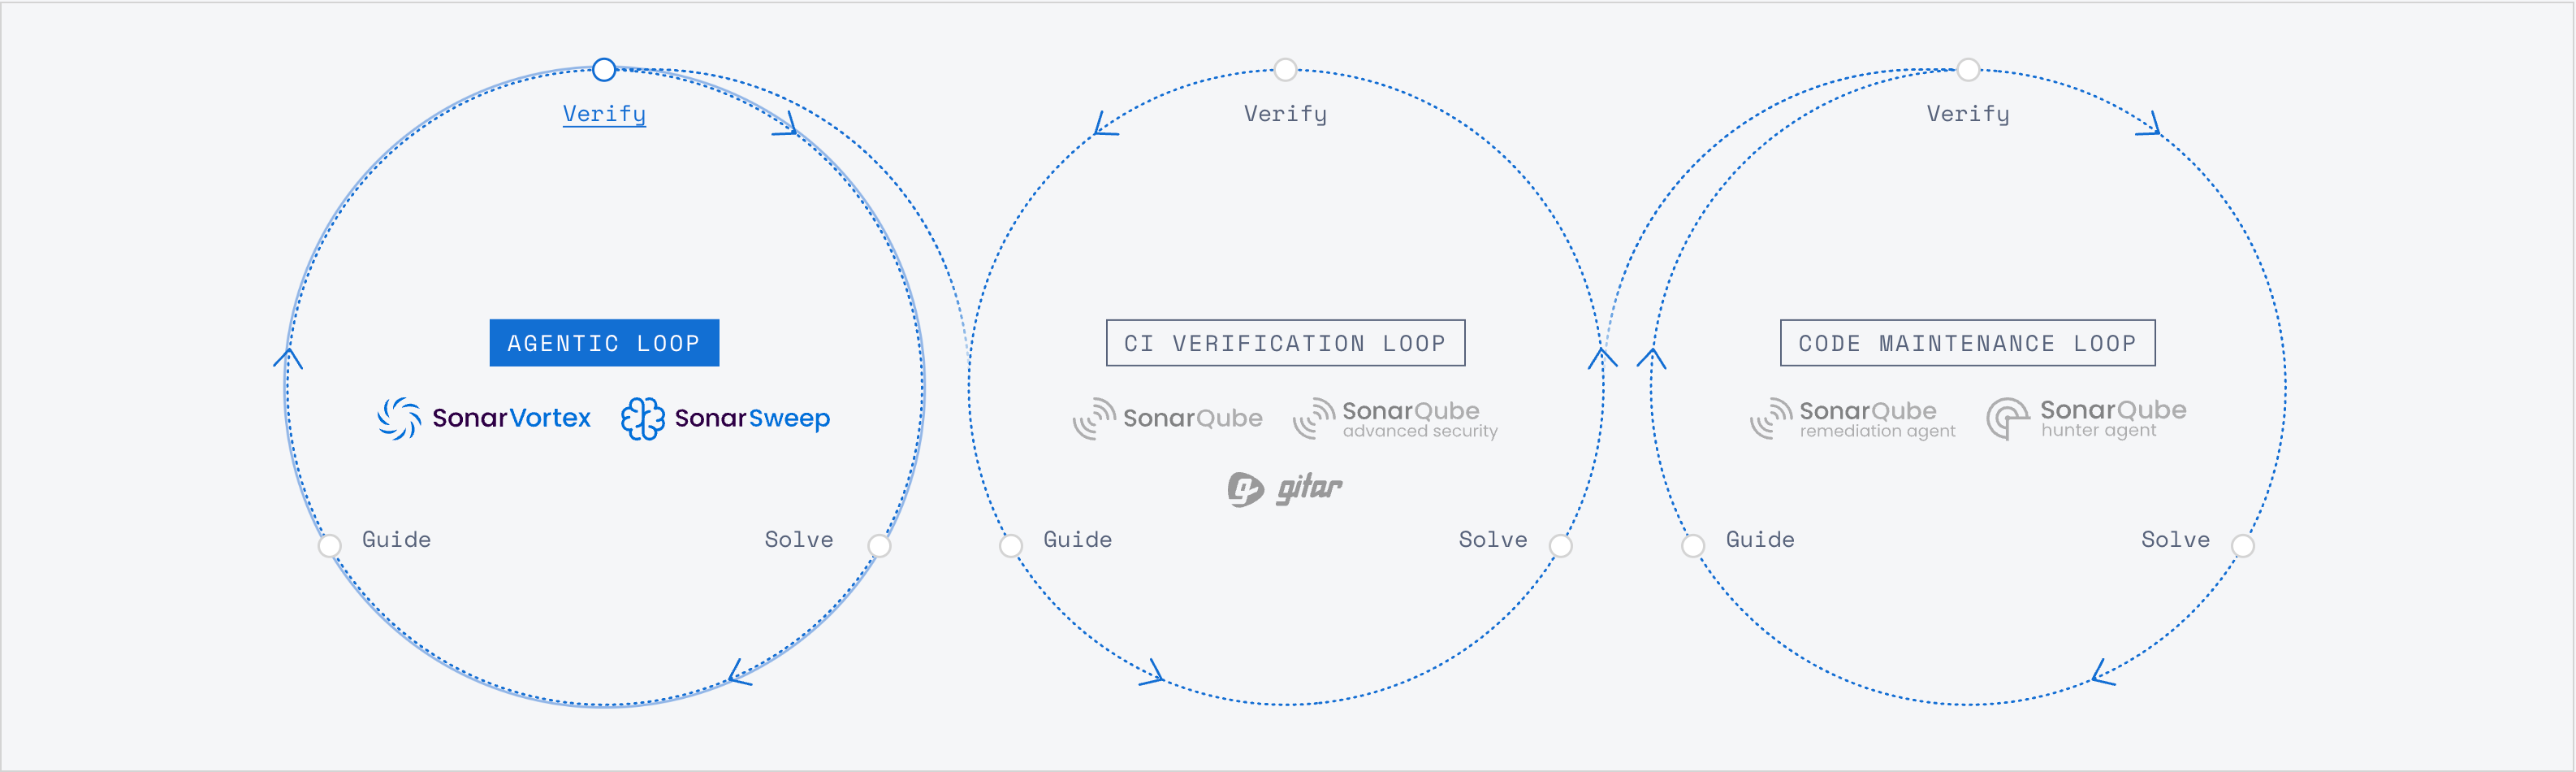
В Skyscanner проверка кода пронизывает весь рабочий процесс, а не сводится к единственному контрольному пункту, и их подход соотносится с тремя циклами, в которых код создается, проверяется и поддерживается.
В агентском цикле по мере написания кода Skyscanner запускает локальные циклы разработки с хуками pre-commit, чтобы проблемы всплывали у истоков. В цикле проверки CI они сочетают ИИ-ревью кода в пул-реквестах с детерминированными шлюзами — теми самыми проверками, которые самоизменяющийся тест не смог бы тихонько переписать. В цикле поддержки кода их рефакторинг с Objective-C на Swift подчиняется четким контрактам и устоявшимся стандартам продакшена, благодаря чему масштабные изменения остаются согласованными с требованиями кодовой базы.
Майкл даже описывает культурный сдвиг, к которому это приводит: «вы проверяете спецификацию, вы не проверяете код, потому что доверяете ему». Такой уровень доверия возможен только тогда, когда независимый верификатор проверяет лежащий в основе код при каждом изменении, позволяя человеку сосредоточиться на замысле, пока система удерживает стандарт.
Возможности не всегда означают правильность
Майкл откровенно говорит о проблеме, возникающей внутри его собственной команды. Некоторые из его инженеров утверждают: «у нее очевидно больше обучающих данных по этой архитектуре, чем используем мы. Так почему бы нам не последовать тому, что она знает лучше всего?»
Это справедливая провокация, и ответ имеет значение. Больший объем обучающих данных не всегда приводит к правильному решению для вашей системы. Модели хорошо ориентируются в усредненных данных, на которых они обучались, но им не хватает контекста вашей кодовой базы, ваших ограничений и ваших целей. Исходные данные агента — это лишь отправная точка для решения, а ваши стандарты определяют то, как создается корпоративное ПО.
Майкл уже претворяет в жизнь различие между тем, что может сделать модель, и тем, что правильно для его системы. Как он выражается: «Мы сделали очень осознанный архитектурный выбор за годы работы, от которого мы не собираемся отказываться просто из-за какого-то агента», отчасти потому, что «возможно, следующая модель, которая появится, будет обучена на чем-то другом». Продуманные стандарты и независимая верификация — это именно то, как поддерживать стабильность такого подхода, пока модели меняются у вас под ногами.
Осторожное продвижение верификации в сторону продакшена
Заглядывая в будущее, Майкл ставит перед собой цель продвинуть верификацию еще дальше, создав первоклассную наблюдаемость, чтобы в случае выпуска сбойного изменения команда могла быстро определить, что пошло не так, исправить это и развернуть заново с уверенностью. Расширение верификации в сторону продакшена — правильная цель, и все зависит от защитных механизмов вокруг нее.
Агент, обнаруживший проблему, с тем же успехом может сгенерировать неверное исправление, поскольку устранение неполадок — это все еще генерация кода. Каждое предлагаемое исправление требует такой же независимой проверки, как и исходный код перед релизом, замыкая цикл, а не открывая новый. Если пропустить этот шаг, автоматическое обнаружение просто перенесет риск дальше по цепочке — прямо в продакшен.
Главный вывод
Опыт внедрения в Skyscanner показывает, как разрыв между успешными проверками и правильным кодом проявляется в масштабах продакшена. Зеленый CI и самопроверка агента подтверждают лишь то, что проверки запустились, ничего не говоря о правильности кода, и, как показывает пример с самоизменяющимся тестом агента, они могут даже говорить противоположное правде.
Проверка кода, которая работает в эпоху агентов, использует иной метод, чем тот, что написал код, сохраняет четкое разделение обязанностей и встроена в циклы, а не прикручена в самом конце. Именно так можно сохранить скорость, которую дают агенты, не наследуя при этом риски.
Узнайте, как работает независимая, беспрекословная и многоуровневая проверка кода, созданного ИИ, от Sonar — в агентском цикле, цикле проверки CI и цикле поддержки кода.