По мере роста трафика запросов растут и затраты на вычисления для их эмбеддинга. На устройствах с низким энергопотреблением большая модель может не поместиться в память. Меньшая модель запросов могла бы снизить эти затраты, но переключение обычно означает необходимость повторного эмбеддинга всей коллекции.
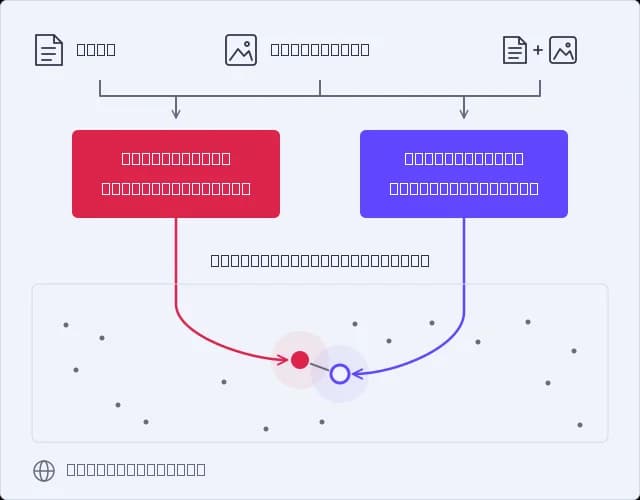
Constella позволяет вам выполнить такое переключение. Это семейство моделей на Hugging Face, построенное вокруг Stella, 400-миллионной англоязычной модели эмбеддинга. Stella кодирует ваши документы. Затем Zero, Nano или сама Stella могут кодировать ваши запросы, при этом все они выполняют поиск по одной и той же коллекции Qdrant.
Мы представляем Constella в качестве исследовательского превью с результатами по 15 наборам данных BEIR.
Один индекс, три модели запросов
Вектор документа может обслуживать тысячи поисковых запросов. Вектор запроса обычно обслуживает один. Constella тратит больше вычислительных ресурсов на стороне документа, где результат можно использовать повторно, и дает вам выбор на стороне запроса.
Мы обучили Zero и Nano воспроизводить эмбеддинги запросов Stella. Именно это делает модели взаимозаменяемыми: вы можете менять кодировщик запросов для каждого запроса, в то время как сохраненные векторы документов остаются неизменными.
Внутри Zero и Nano
Zero — это обученный «мешок токенов» (bag of tokens): он ищет вектор каждого токена, объединяет векторы и нормализует результат. Это весь кодировщик запросов. Это делает поиск дешевым, но теряет порядок слов: одни и те же токены с тем же количеством создают тот же вектор, даже если их перестановка меняет смысл.
Nano добавляет контекст: его трансформер моделирует взаимосвязь токенов друг с другом и их позиции. Он объединяет признаки из слоев 4, 8 и 12, а затем проецирует их в 1024-мерное пространство Stella. Мы обучили его на 199 999 721 примере, чтобы он соответствовал замороженным эмбеддингам Stella, используя примерно одну двенадцатую часть параметров Stella. Наш инструментарий для дистилляции и оценки доступен на GitHub, включая код обучения и записи экспериментов.
Цифры: 15 наборов данных BEIR
Мы оценили Zero, Nano и полную версию Stella на BEIR-15 — коллекции поисковых задач, охватывающей научные статьи, вопросы, утверждения и другой текст. Каждая модель запросов выполняет поиск по одним и тем же векторам документов Stella.
В таблице приведен показатель nDCG@10 для точного поиска, который измеряет, насколько хорошо релевантные документы ранжируются в первых 10 результатах. Чем выше значение, тем лучше. Каждый набор данных имеет равный вес в средних значениях; CQADupStack объединяет свои 12 форумов в одну оценку набора данных. Затенение показывает каждую оценку Zero и Nano как долю от полной версии Stella.
† Оговорка о загрязнении данных при обучении: Stella сообщает об использовании этих четырех наборов данных при обучении или оценке. Zero и Nano обучаются на основе Stella, поэтому рассматривайте эти оценки как сравнение внутри семейства, а не как тест на полностью невидимых данных. Полные сведения об оценке.
Nano сохраняет около 91% среднего балла полной версии Stella по всем 15 наборам данных, используя гораздо меньший трансформер запросов. Zero имеет более низкие общие показатели, но превосходит Nano в FEVER, HotpotQA и Climate-FEVER. Компромисс зависит от рабочей нагрузки, поэтому выбор модели запроса стоит протестировать на ваших собственных данных.
Мы рекомендуем сочетать Zero с BM25 для гибридного поиска. В наших тестах Zero получил больше преимуществ от этой комбинации, чем Nano, улучшив качество поиска без добавления трансформера в путь запроса. Наша карточка модели Zero содержит рекомендуемые настройки слияния и практические рекомендации для начала работы.
Насколько быстра сторона запроса?
На процессоре Apple M5 Pro полная версия Stella закодировала прогретый запрос из 20 слов за 38,95 мс. Nano потребовалось 3,13 мс, а Zero — 0,081 мс. Это примерно в 12 раз быстрее для Nano и в 480 раз быстрее для Zero, чем полная версия Stella.
В таблице разделены загрузка модели, первый запрос после загрузки и «прогретое» значение p50 — медианное время запроса.
Мы измерили все три показателя с помощью FastEmbed и ONNX Runtime на CPU, используя четыре потока и размер пакета, равный единице. Значения представляют собой медианы по трем новым процессам, каждый из которых включает пять прогревочных прогонов и 20 синтетических запросов из 20 слов. Stella получает необходимую инструкцию запроса в дополнение к этим 20 словам. Это время кодирования; поиск в Qdrant и сетевое время оплачиваются дополнительно.
Загрузка включает импорт и локальную инициализацию модели, при этом ресурсы уже загружены, а дисковый кэш операционной системы остается нетронутым. Держите модели загруженными, чтобы избежать затрат на запуск при переключении. Исходные данные по времени и полный протокол доступны для ознакомления.
Что можно создать с помощью этого
- Автономный поиск на устройствах с низким энергопотреблением. Закодируйте руководства или базу знаний с помощью Stella на сервере, а затем отправьте Zero или Nano вместе с векторами. Ищите локально, даже без подключения.
- API поиска с высокой нагрузкой. Используйте Zero для снижения вычислительных затрат на кодирование запросов, а Nano или Stella — для рабочих нагрузок, где их преимущество в релевантности оправдывает затраты. Все три ищут по одной и той же коллекции.
- Поиск при вводе. Используйте Zero для запросов при каждом нажатии клавиши, а затем Nano, когда пользователь делает паузу или отправляет запрос. Наша локальная демо-версия Pokémon использует этот шаблон.
- Агенты, которые выполняют поиск повторно. Агент может выполнять поиск несколько раз перед ответом. Попробуйте Zero или Nano для этих промежуточных поисков, чтобы сократить время, затрачиваемое на кодирование запросов.
- Гибридный поиск без трансформера. Соедините Zero с BM25, чтобы находить связанные концепции наряду с точными терминами во всем вашем контенте. Объединяйте оба набора результатов в Qdrant без запуска трансформера для каждого запроса.
Это стандартная настройка Qdrant + FastEmbed: внедрите свои документы, сохраните векторы и запросите коллекцию. Модели находятся на Hugging Face, а встроенная поддержка FastEmbed доступна в ветке research-preview.
Установите превью:
Создайте коллекцию и закодируйте свои документы один раз с помощью Stella:
Теперь выберите свою модель запросов. Чтобы переключиться с Zero на Nano, измените одно имя модели:
Та же коллекция. Тот же код запроса. Сохраненные векторы документов остаются точно там, где они были. См. карточку модели для получения информации о поддерживаемых путях запросов.
Что дальше
Constella находится на этапе внутреннего обзора перед полным выпуском. Это исследовательское превью — шанс опробовать модели и помочь сформировать то, что будет дальше. Мы будем рады узнать, где они работают, где они не справляются и что вы с ними создаете. Поделитесь своими отзывами и тем, что вы создали, в нашем сообществе Discord.