Рабочие нагрузки векторного поиска в реальном мире становятся все более масштабными и сложными. Предприятия используют векторный поиск не для того, чтобы время от времени просматривать пару PDF-файлов. Они индексируют и ищут миллиарды векторов при тысячах запросов в секунду (RPS) и задержке «хвоста» менее 50 мс. Крупные предприятия также не могут позволить себе полагаться на ошибочные предположения.
Слишком много бенчмарков используют закрытые проприетарные управляемые сервисы. Хуже того, данные в них синтетические, запросы скрыты, а движки заблокированы платными доступом.
Эти бенчмарки показывают 90% recall @ 10 на чисто синтетическом RAG-тесте, выдавая это за результат промышленного уровня. Но для компании в сфере электронной коммерции или маркетплейса, передающей более 1000 лучших результатов на второй этап переранжирования, этого недостаточно. Инженеры ведущих мировых команд по поиску требуют воспроизводимости, recall 95%+, большой глубины поиска, высокой пропускной способности и задержки p99 менее 100 мс. И мы тоже.
Почему эта проблема до сих пор не решена? Потому что generating benchmark datasets at billion-scale is incredibly challenging, а вычисление точных эталонных запросов (ground truth) требует огромных вычислительных мощностей и потенциально квадриллионов вычислений расстояний методом грубой силы.
Но мы любим сложные задачи. Поэтому мы взялись за это.
В партнерстве с Vultr мы взяли на себя экономические затраты на генерацию эмбеддингов экстремального масштаба и KNN методом грубой силы, чтобы предоставить научному и инженерному сообществу новый стандарт наборов данных для бенчмаркинга поиска: Qdrant-FineWeb-10B.
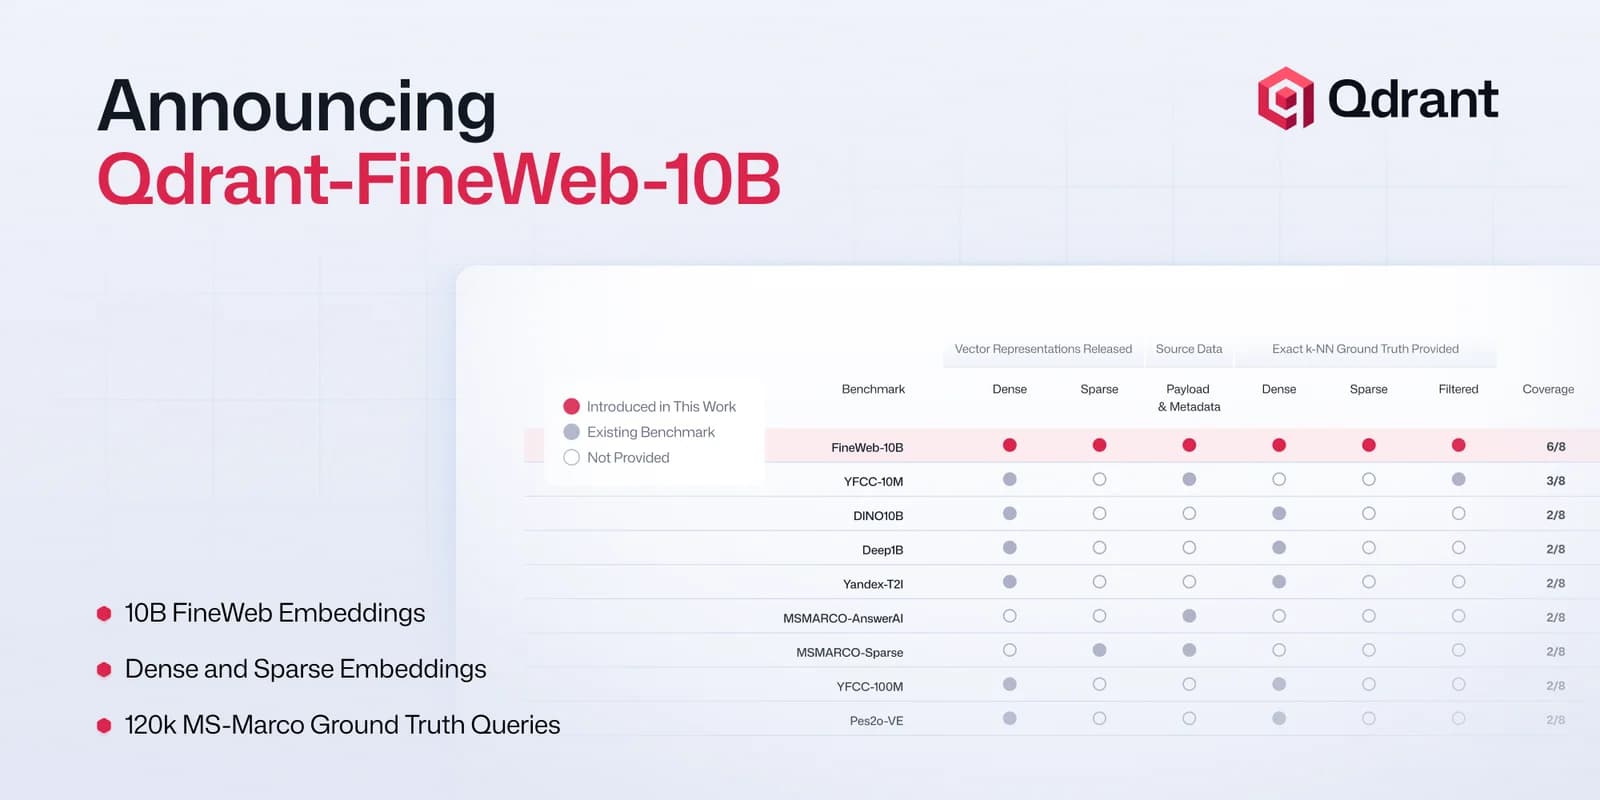
Этот колоссальный набор данных содержит около 25 ТБ только векторных данных, состоящих из плотных и разреженных векторов, сгенерированных с помощью gte-multilingual-base. Затем, используя наш движок для бенчмаркинга на базе GPU, мы вычислили точные эталонные значения top-1000 для 120 000 плотных, разреженных и отфильтрованных запросов — более квадриллиона вычислений расстояний по всему корпусу из 10 миллиардов документов.
Поскольку в отрасли в настоящее время не хватает наборов данных, которые хорошо адаптируются к мультимодальным форматам и сложной фильтрации, мы также выпускаем PubMed-Multi-Vector и Coyo-Vector-Embeddings. Эти наборы данных предоставляют сообществу плотные, разреженные и мультимодальные представления, которые действительно отражают современные производственные архитектуры.
Чтобы гарантировать, что эти наборы данных — не просто очередное заявление проприетарного вендора, мы открываем исходный код инструментов, которые использовали. Supernova — это наш высокопроизводительный распределенный фреймворк для бенчмаркинга, разработанный для того, чтобы сделать генерацию наборов данных огромного масштаба и поиск эталонных значений методом грубой силы доступными, воспроизводимыми и еще более экономически эффективными.
Эпоха опоры на наборы данных из 1 миллиона векторов, производственных слухов и синтетических аппроксимаций закончилась. Вот реальные данные, реальные эталонные значения и инфраструктура с открытым исходным кодом, необходимые для того, чтобы вы могли запустить это самостоятельно.
Qdrant-FineWeb-10B: бенчмаркинг в масштабах интернета
Qdrant-FineWeb-10B представляет собой основу этого релиза. Это крупнейший бенчмарк векторного поиска с открытым исходным кодом, доступный сообществу, включающий 24,47 ТБ векторов и 28,66 ТБ исходного текста и метаданных.
Созданный в сотрудничестве с Vultr с использованием gte-multilingual-base на корпусе FineWeb от Hugging Face, мы использовали Supernova для вычисления точных эталонных ближайших соседей top-1000 методом грубой силы для 100 000 запросов по всему пространству из 10 миллиардов векторов. В совокупности это составило более одного квадриллиона вычислений расстояний, выполненных параллельно на оборудовании с ускорением GPU.
Чтобы продемонстрировать универсальность Supernova в различных модальностях и предоставить дополнительные ресурсы сообществу, мы использовали Supernova для генерации двух дополнительных открытых наборов данных:
- PubMed-Multi-Vector: разработан для бенчмаркинга методов гибридного поиска при постоянных переменных корпуса. Он генерирует плотные, разреженные и мультивекторные представления в стиле ColBERT по одному и тому же текстовому корпусу, накапливая более 8,37 миллиарда мультивекторных токенов на почти 35 ТБ данных.
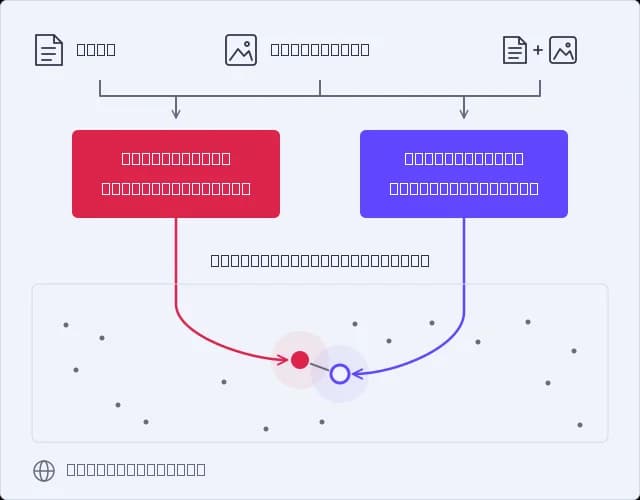
- Coyo-Vector-Embedding: фокусируется на мультимодальном поиске, используя 2048-мерный кодировщик «зрение-язык» (Qwen3-VL-Embedding-2B) для проецирования пар «изображение-подпись» из набора данных LLaVA в единое общее пространство эмбеддингов. Это представляет собой ультрасовременную рабочую нагрузку, использующую передовые методы генерации эмбеддингов и архитектуры моделей.
Мы планируем продолжать выпускать больше наборов данных для сообщества.
Supernova: движок для бенчмаркинга с открытым исходным кодом
Мы не хотели останавливаться на выпуске статического набора данных. Мы создали Supernova как бесплатный, полностью открытый фреймворк, чтобы широкое сообщество могло генерировать, манипулировать, определять эталонные значения и проводить бенчмаркинг наборов данных интернет-масштаба на своей собственной инфраструктуре, не полагаясь на Qdrant или какой-либо сторонний стек.
автоматизирует четыре основных этапа создания и запуска бенчмарка векторного поиска: 1) генерация эмбеддингов, 2) вычисление эталонных значений методом грубой силы, 3) загрузка базы данных и 4) оценочный бенчмаркинг.
Каждый этап управляется специализированным модулем, полностью настраиваемым через YAML-файлы и предназначенным для массово-параллельного выполнения:
- nova-embed (модульный конвейер эмбеддингов): объединяет разрозненные бэкенды (SentenceTransformers, FastEmbed, OpenAI API) и системы хранения (Hugging Face, S3, Cloudflare R2). Он работает без сохранения состояния, без центральной базы данных — каждый рабочий узел использует свой ранг и размер мира для независимого разделения входных данных, достигая линейного масштабирования в облачных и HPC-средах.
- nova-bf (эталонные значения на базе GPU): вычисляет точные ближайшие соседи top-k методом грубой силы для плотных, разреженных и мультивекторных представлений без исчерпания памяти. Он передает потоком разделы данных из удаленного хранилища, использует пользовательские объединенные ядра GPU для оценки позднего взаимодействия и заранее оценивает фильтры на CPU, чтобы отсечь нерелевантные строки перед передачей на GPU.
- nova-load & nova-storm (инжестирование и стресс-тестирование): обрабатывают последующую оценку по таким бэкендам, как Qdrant, Milvus и Elasticsearch. nova-load управляет параллельным инжестированием для проверки пропускной способности записи, а nova-storm запускает рабочие нагрузки поиска для отслеживания QPS, распределений задержки ($p_{50}, p_{95}, p_{99}$), времени сборки и точности recall относительно эталонных значений nova-bf.
Обзор фреймворка Supernova: стандартизированный конвейер для бенчмаркинга векторного поиска. Каждый модуль разработан для линейного масштабирования в облачных и HPC-средах, обеспечивая воспроизводимый бенчмаркинг в масштабах интернета.
Распределенные вычисления с SkyPilot
Чтобы обеспечить бесшовное масштабирование вычислений в распределенной инфраструктуре, Supernova интегрирует nova-dist, модуль только для контроллера, построенный на SkyPilot, который управляет выделением кластеров, планированием заданий, отказоустойчивостью и облачной абстракцией. Вместо жесткого кодирования логики инфраструктуры в отдельные модули конвейера, nova-dist отделяет выполнение заданий от управления оборудованием. Это позволяет nova-embed, nova-bf, nova-load и nova-storm линейно масштабироваться в кластерах AWS, GCP, Azure, Kubernetes и Slurm HPC с использованием идентичных конфигураций YAML — массово распараллеливая рабочие нагрузки на сотнях GPU без ручных накладных расходов на инфраструктуру.
Благодарности
Мы выражаем искреннюю благодарность Vultr за предоставление инфраструктуры для генерации начальных эмбеддингов FineWeb-10B, а также командам SkyPilot и Hugging Face за создание базовых инструментов с открытым исходным кодом, которые позволяют работать в таком масштабе.