Сокращение количества поисковых запросов и вызовов
Когда агент с генерацией, дополненной поиском (RAG), выполняет работу, ему часто приходится планировать поиск, проверять полученные данные и пробовать снова, если этих данных недостаточно. Эти неэффективности суммируются. Каждый дополнительный поиск и каждый лишний вызов модели увеличивают задержку, контекст и стоимость вывода.
Чтобы справиться с этими расходами, Minima создала агент с ограниченным поиском. Он планировал запрос, выполнял поиск в Qdrant, решал, достаточно ли полученных данных, и перефразировал запрос, если их было недостаточно. Затем он генерировал ответ со ссылками на источники с помощью Qwen3.6-27B. Qdrant выполнял гибридный поиск, применял фильтры полезной нагрузки и проводил повторное ранжирование с поздним взаимодействием. Minima обрабатывала каждый запрос на одном графическом процессоре NVIDIA RTX PRO 6000 Blackwell с 96 ГБ памяти.
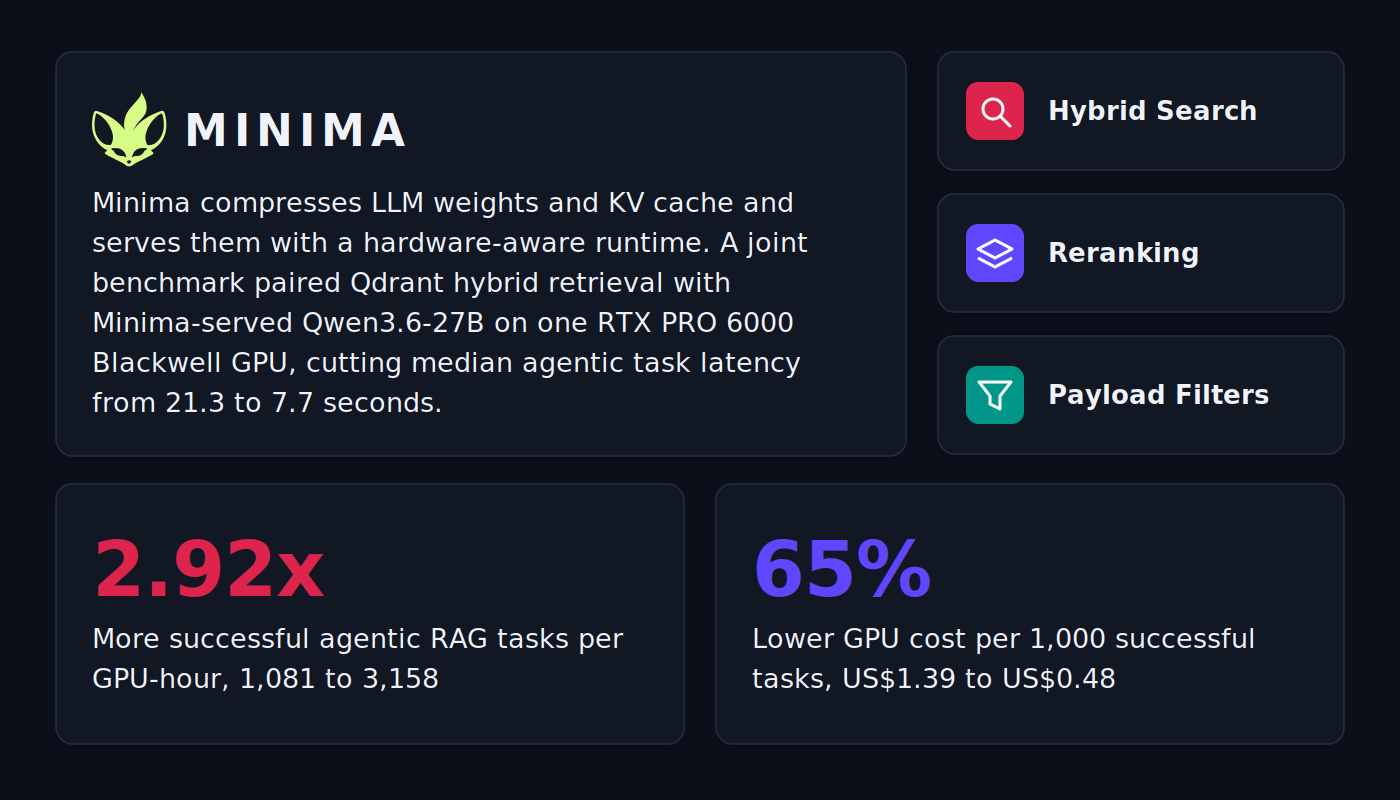
По результатам 1800 оцененных задач и 10 000 полных эпизодов работы агента совместный стек достиг показателя 3750 задач на GPU-час по сравнению с 1350 для плотного поиска с выводом в формате BF16. Медианная задержка выполнения задачи сократилась с 21,3 до 7,7 секунд, успешность выполнения задач с опорой на источники выросла с 80,1% до 84,2%, а пропускная способность успешных задач увеличилась с 1081 до 3158 на GPU-час.
Что мы тестировали
Minima выполнила 1800 многошаговых задач по трем публичным бенчмаркам: SciFact, FiQA и HotpotQA, а также по четвертому набору, созданному Minima для тестирования фильтрации полезной нагрузки. В этом четвертом наборе каждый фрагмент содержит идентификатор арендатора и версию документа в полезной нагрузке Qdrant, и для каждого запроса существует ровно один правильный срез «арендатор-версия». Любой результат, возвращенный извне этого среза, считается нарушением, поэтому набор оценивается по принципу «прошел/не прошел» без участия оценщика. Именно этот набор лежит в основе теста политики арендаторов из 50 000 запросов, о котором рассказывается далее в этой статье. В каждом запуске использовались один и тот же промпт агента, схема инструментов, правило остановки и максимум два вызова Qdrant на эпизод. Ответы были ограничены 256 выходными токенами. Затем Minima повторно прогнала 10 000 полных эпизодов по одному миллиону фрагментов по 400 токенов и провела отдельный тест состязательной фильтрации из 50 000 запросов для каждого условия поиска.
Во всех трех конфигурациях использовались одинаковые оборудование, чекпоинт Qwen3.6-27B, настройки сэмплирования, шаблон промпта агента, параллелизм и эндпоинт. Qdrant работал на отдельном хосте. Кодирование запросов выполнялось на отдельном CPU-сервисе FastEmbed с использованием ONNX Runtime и тех же моделей во всех трех конфигурациях: sentence-transformers/all-MiniLM-L6-v2 для 384-мерных плотных векторов с косинусным расстоянием, qdrant/bm25 для разреженных векторов и answerdotai/answerai-colbert-small-v1 для 96-мерных мультивекторов с поздним взаимодействием. Qdrant хранил и искал разреженные векторы и применял свой модификатор IDF. Ни один GPU не выполнял кодирование, поэтому RTX PRO 6000 Blackwell был полностью выделен под эндпоинт Minima Qwen3.6-27B. Задержка эпизода и пропускная способность задач измерялись от начала до конца, включая кодирование и поиск, в то время как показатели GPU-часов и стоимости GPU учитывают только этот выделенный для вывода графический процессор. Стратегия поиска и сжатие Minima были единственными переменными, которые менялись между запусками. Minima принимала конфигурацию только в том случае, если качество выполнения задач с опорой на источники оставалось в пределах 1 процентного пункта от BF16 при фиксированном поиске, качество ссылок сохранялось, а завершалось не менее 99,5% эпизодов. Векторы запросов были предварительно вычислены только для изолированного измерения задержки Qdrant. Сквозной запуск агента включал планирование, эмбеддинг, поиск, проверку доказательств и генерацию.
Почему первого вызова Qdrant обычно было достаточно
Плотный поиск хорошо справлялся с семантическим сходством. Minima добавила BM25 для восстановления имен, идентификаторов и строк версий, которые могут быть пропущены эмбеддингами. Qdrant объединял два набора результатов с помощью взаимного ранжирования (RRF), а затем переранжировал шорт-лист с помощью позднего взаимодействия на уровне токенов. Фильтры полезной нагрузки обеспечивали соблюдение ограничений по арендатору, языку, типу документа и версии во время запроса.
Приведенные ниже цифры охватывают поиск и цикл работы агента. Recall@10 и nDCG@10 используют один и тот же список оценки топ-10. Промпт агента затем обрезался до указанного бюджета контекста: топ-16 для плотного поиска или топ-8 для гибридного. «Достаточность доказательств с первого прохода» означает, что агент не вызывал дополнительный поиск. Задержка на вызов — это время запроса к прогретому Qdrant с предварительно вычисленными векторами запросов.
Время запроса p95 для Qdrant составило 43,2 миллисекунды, что составляет менее 0,3% от 20,8-секундного эпизода агента p95 BF16. Первый поиск был достаточным в 87% задач, а средний контекст сократился с 5,2 тыс. до 2,3 тыс. токенов. Еще до включения Minima медианная задержка выполнения задачи снизилась с 21,3 до 14,6 секунд, а пропускная способность успешных задач выросла с 1081 до 1669 на GPU-час, что составляет прирост в 54%.
«Внутри цикла работы агента слабый первый поиск стоит дороже, чем один дополнительный. Он запускает еще один раунд планирования, поиска и вывода, поэтому получение достаточных доказательств с первого прохода — один из самых простых способов сделать всю систему быстрее и эффективнее». — Сергей Козырев, соучредитель и генеральный директор Minima AI
«Внутри цикла работы агента слабый первый поиск стоит дороже, чем один дополнительный. Он запускает еще один раунд планирования, поиска и вывода, поэтому получение достаточных доказательств с первого прохода — один из самых простых способов сделать всю систему быстрее и эффективнее». — Сергей Козырев, соучредитель и генеральный директор Minima AI
Как Minima ускорила каждый вызов модели
Minima хранила веса Qwen3.6-27B в формате NVFP4 W4A4 и запускала их с помощью нативных ядер Blackwell. Недавние и опорные KV оставались в FP8. Устаревшие страницы перемещались на уровень TQ3 с 3-битным сжатием. Minima отключила квантование векторов Qdrant, чтобы эффекты поиска и вывода LLM оставались раздельными.
Сжатие сохранило качество задач. При фиксированном поиске Qdrant успешность выполнения задач с опорой на источники составила 84,3% для BF16 и 84,2% для Minima, F1-мера ссылок — 90,8% и 90,7%, а доля валидных вызовов инструментов — 99,8% для обоих случаев. Разница в качестве задач составила -0,1 процентного пункта (95% ДИ [-0,7, +0,5]), что прошло предварительно зарегистрированный порог нехудшего качества.
Совместный результат: в 2,92 раза больше успешных задач на GPU
При неизменном BF16 Qdrant увеличил «сырую» емкость с 1350 до 1980 задач на GPU-час. При фиксированном Qdrant, Minima увеличила этот показатель до 3750. Применение коэффициента успешности задач дает 3158 успешных задач на GPU-час, что в 2,92 раза больше базового уровня.
В таблице ниже представлены результаты работы агента при параллелизме 8, с ограничением финальных ответов в 256 токенов. Скорость выполнения задач — это количество завершенных задач в реальном времени на GPU-час.
При стоимости 1,50 доллара США за GPU-час, которую Minima использовала для учета затрат, стоимость GPU на 1000 успешных агентских задач снизилась с 1,39 до 0,48 доллара США, что составляет сокращение на 65%. Это сравнение только по GPU исключает хост Qdrant и сервисы эмбеддингов. Те же выделенные сервисы оставались онлайн во всех трех условиях, хотя гибридный конвейер увеличил нагрузку на них.
Minima не стала умножать показатели сжатия весов в 3,2 раза, сжатия KV в 3,5 раза и меньшего контекста поиска в единое утверждение о системе. Они влияют на разные «узкие места». Измеренные сквозные результаты показали в 2,78 раза большую «сырую» емкость задач и в 2,92 раза больше успешных задач на GPU-час.
Почему это важно для агентского RAG
Qdrant и Minima решают разные проблемы затрат внутри цикла. Qdrant сделал первый поиск более эффективным в большинстве случаев и сократил объем данных, передаваемых модели при каждой попытке. Minima снизила затраты памяти и вычислительных ресурсов на планирование, проверку и ответы.
Производительность агентской системы ограничена всем процессом выполнения в целом, а не только векторным поиском или пропускной способностью модели в отдельности. В этом тесте Qdrant улучшил качество данных, передаваемых модели, а Minima увеличила объем вывода, который может обслуживать один графический процессор. Вместе они обеспечили выполнение на 2,92 раза большего количества успешных задач без снижения валидности вызовов инструментов, обоснованности качества или точности цитирования.
Воспроизведите это на своем корпусе данных
Если вы используете агентский RAG на Qdrant, Qdrant и Minima готовы помочь воспроизвести этот бенчмарк на вашем корпусе данных и агентском цикле. Свяжитесь с Qdrant или свяжитесь с Minima, чтобы начать.
Технические ссылки
Руководство Qdrant по агентскому векторному поиску объясняет, почему задержка поиска, память, фильтрация и переранжирование важны в многошаговых рабочих процессах агентов.
Учебное пособие по агентскому RAG с использованием LangGraph и Qdrant охватывает выбор инструментов, повторный поиск и управление состоянием потока выполнения агента.
Документация Qdrant по гибридным и многоэтапным запросам описывает плотную и разреженную предварительную выборку, слияние RRF и DBSF, а также многоэтапное ранжирование.
Учебное пособие Qdrant по гибридному поиску с переранжированием описывает рабочий процесс с плотными, разреженными векторами и поздним взаимодействием в стиле ColBERT.
Учебное пособие Qdrant по мультивекторам и позднему взаимодействию охватывает нативные мультивекторные представления и оценку MaxSim.
Документация Qdrant по фильтрации описывает условия для полезной нагрузки и идентификаторов точек для ограничений, определенных приложением.
NVIDIA RTX PRO 6000 Blackwell product page перечисляет поддержку 96 ГБ памяти GDDR7 и Blackwell FP4.
Сайт Minima охватывает оптимизацию весов модели, KV-кэша и обслуживания.