Кратко
- Мы создали тест на готовность к ИИ-аналитике, чтобы помочь людям подобрать подходящие сессии на неделе ИИ-аналитики. Перед началом сессий его прошли 73 человека. Затем мы провели опросы среди участников, и вот что мы узнали. Это не отраслевой бенчмарк — у нас небольшая выборка, сильное влияние предвзятости отбора, а все ответы анонимны, — но в качестве обмена опытом мы решили честно рассказать о результатах. Назовем это замером общего настроя.
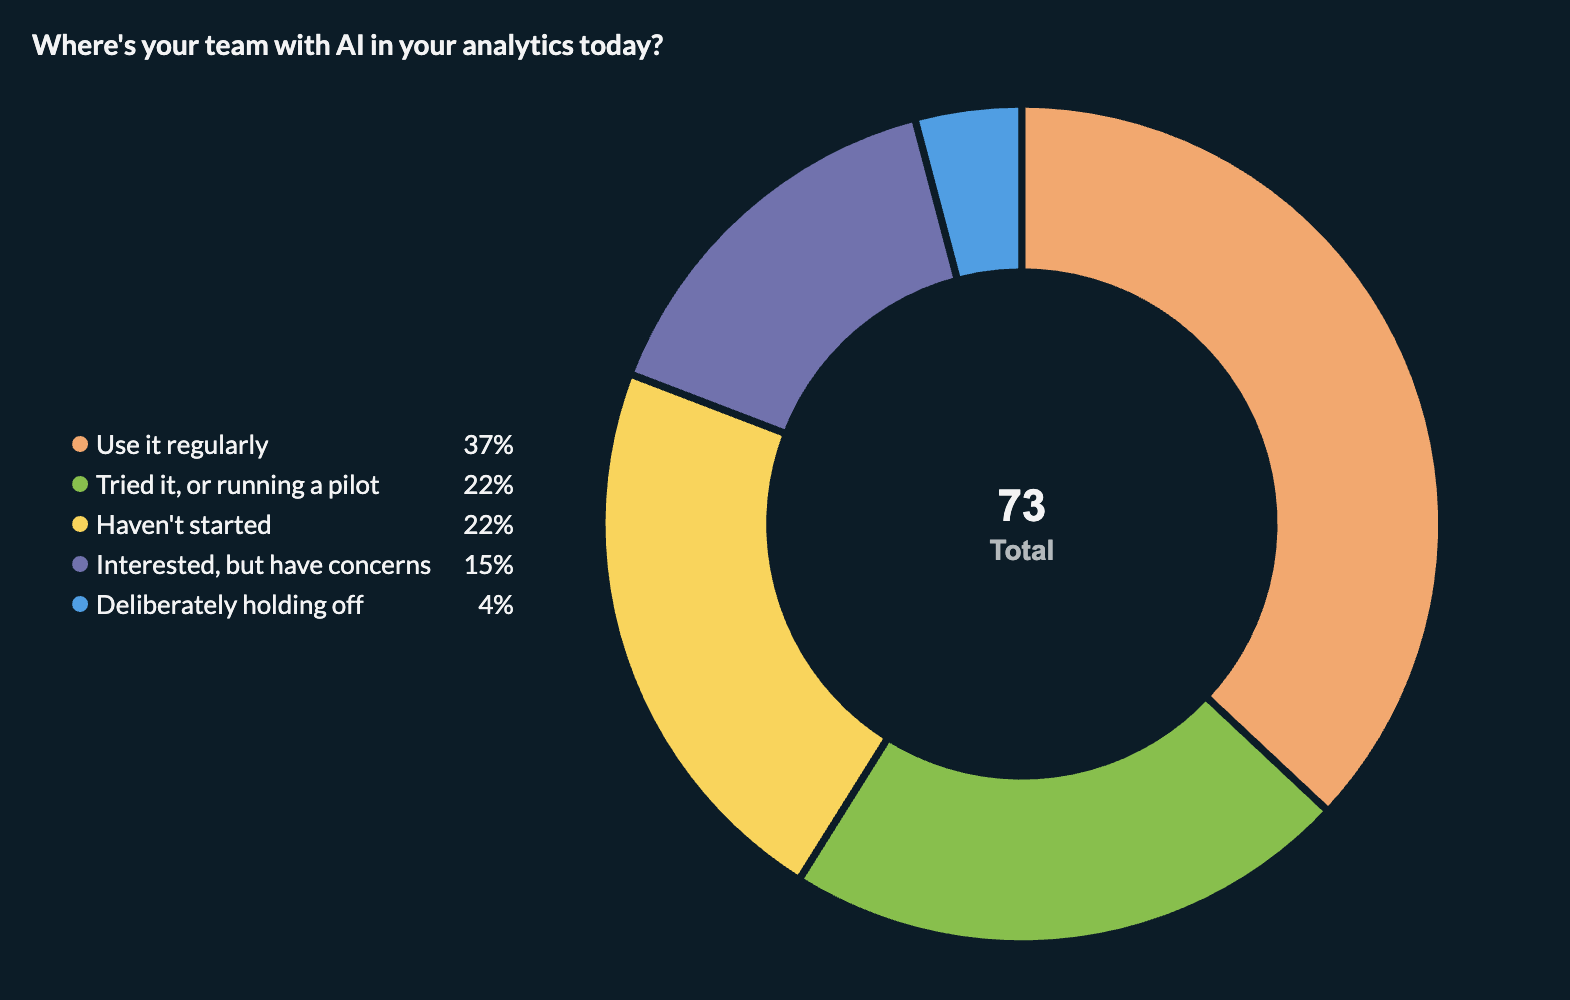
- Более половины респондентов регулярно используют ИИ для работы с данными или запускают пилотные проекты. Еще 22% еще не начинали, и большинство из них объяснили это тем, что они не знают, какие возможности уже есть в имеющихся у них инструментах.
- Люди хотят контролировать, где именно работает ИИ: 44% заявили, что всё должно оставаться на их собственных серверах, а 14% нужно использовать собственную модель. Примечательно, что эта потребность сильнее всего выражена именно среди тех, кто еще ничего не начинал.
- Тревожность по поводу ИИ находится на довольно низком уровне. Никто не переживает о том, как это повлияет на их работу. Беспокойство начинает проявляться в вопросах управления, но оно не является непреодолимым препятствием. Две трети тех, кто заявил, что ИИ не дает им спать по ночам, всё равно хотят предоставить агентам прямой доступ к своим данным.
- Половина всех участников теста хочет работать со своими данными через ИИ-агентов поверх протокола MCP. Среди тех, кто уже регулярно использует ИИ, этот показатель составляет 78%.
- И самый неожиданный факт: 31% ответивших заявили, что не знают, что такое семантический слой (спойлер: это фундамент для получения достоверных ответов от ИИ).
В августе мы провели неделю ИИ-аналитики в формате серии вебинаров. Наша цель заключалась в том, чтобы сделать ИИ-аналитику более понятной для команд, которые ее еще не внедрили, предложить четкую отправную точку для тех, кто уже готов, и дать фреймворки для масштабирования с учетом требований управления для тех, кто уже вовсю работает (вы можете посмотреть запись всех сессий и найти дополнительную информацию здесь). Мы также хотели воспользоваться возможностью и узнать общее настроение: как люди относятся к этому нововведению, на каком этапе внедрения они находятся, что их останавливает и что вызывает наибольший энтузиазм.
Тест на готовность к ИИ помогал подобрать сессию, которая соответствовала бы текущему уровню участника в вопросах ИИ-аналитики. Для этого нужно было ответить на пять вопросов: на каком этапе внедрения ИИ вы находитесь сегодня, что вам мешает, насколько жесткий контроль вам необходим в отношении места запуска ИИ, как вы предпочитаете строить работу и как вы относитесь к тому, что ИИ изменит вашу работу.
Обычно вокруг темы ИИ в аналитике витает атмосфера опасений и вопросов, на которые больше нет ответов, чем есть: могу ли я доверять цифрам? как защитить наше хранилище? не окажется ли кто-то под угрозой увольнения? Результаты нашего опроса показали совсем другую картину. Мы увидели массу любопытства, короткий список практических препятствий, а также людей, которые уже запускают ИИ на данных, еще не успевших пройти полную очистку, и горят желанием заняться оптимизацией.
Что мы спрашивали и кто отвечал
Неделя ИИ-аналитики состояла из трех живых вебинаров:
- ИИ-аналитика с пруфами — о создании надежного фундамента для формулирования вопросов на естественном языке и проверки результатов.
- ИИ-аналитика на ваших условиях и на вашей инфраструктуре — о внедрении ИИ-аналитики с соблюдением самых строгих требований безопасности, суверенитета и регуляторных норм.
- ИИ-аналитика с кнопкой сборки — об управлении аналитикой как кодом с использованием рабочих процессов на базе Git, создании решений с помощью агентов и предварительном обзоре нашей функции Data Apps.
Тест состоял всего из 5 быстрых вопросов. Он изначально задумывался как анонимный — без указания компании, ее размера, отрасли или электронной почты, — поэтому мы не можем сегментировать эти данные по фирмографическим признакам. Это небольшая самовыбранная выборка людей, которые согласились пройти тест на готовность к ИИ-аналитике во время серии мероприятий Metabase, посвященных ИИ-аналитике. Аудитория имеет технический уклон. В ней преобладают те, кто уже хорошо к нам относится. Это глубоко ненаучное исследование, но нам показалось, что результаты достаточно интересны, чтобы ими поделиться.
Мы также проводили опросы во время трех живых сессий — в течение недели в общей сложности 70 человек приняли участие хотя бы в одном голосовании. Эти опросы были необязательными, и активность различалась: кто-то не голосовал вовсе, кто-то ответил на один-два вопроса, а кто-то участвовал в каждом голосовании. Поэтому все показатели в процентах ниже отражают долю людей, проголосовавших по конкретному вопросу, а не общее количество присутствовавших. Количество проголосовавших в опросах варьировалось от 12 до 34.
На каком этапе команды находятся в вопросах ИИ-аналитики
Тест открывался очевидным вопросом: на каком этапе внедрения ИИ в аналитику находится ваша команда сегодня?
Итак, 59% уже преодолели стартовую линию, и лишь 4% решили отказаться от этой затеи. Те самые 22%, которые еще ничего не начинали, — это именно та аудитория, для которой мы подготовили сессию «с пруфами», и стоит разобраться, почему они до сих пор не приступили к работе.
В ходе сессии участникам был задан смежный вопрос: что именно мешает вам попробовать ИИ от Metabase (если мешает)? Среди проголосовавших 26% ответили, что уже используют его, 26% не были уверены в том, какие функции доступны (удар в самое сердце продуктового маркетолога — пожалуйста, вернитесь и срочно перечитайте все наши анонсы релизов по порядку), 21% выбрали вариант «другое», 18% сослались на нехватку времени, а 9% заявили, что их данные еще не готовы. Вариант «не были уверены, что доступно» делит первое место. Мы еще вернемся к этому.
Что мешает начать работу с ИИ-аналитикой
На вопрос о том, что именно сдерживает команды (если сдерживает):
Самый популярный ответ — «ничего», что коррелирует с 59% уже использующих ИИ. Достоверность результатов — главный реальный барьер, который проявляется во всем. Среди тех, кто регулярно пользуется ИИ, этот ответ по-прежнему занимает второе место с показателем 22%, уступая лишь стремлению «двигаться быстро».
Результаты опроса на сессии о том, что именно беспокоит людей в ответах, сгенерированных ИИ, тесно связаны с показателем достоверности. Среди проголосовавших 48% отметили неверные цифры, 37% указали на то, что невозможно понять, как ИИ получил ответ, 19% ответили, что не переживают, но им любопытно, как это доказать, а 11% пожаловались на отсутствие контроля над тем, что именно видит система. (В этом опросе можно было выбрать несколько вариантов, поэтому здесь указана доля людей, а не голосов.) Неверные цифры и невозможность проследить цепочку расчетов — это на самом деле не две разные проблемы: первое невозможно оценить без второго, именно поэтому каждый ответ Metabot отображает свой SQL-запрос.
Это подтвердило наши предположения, и именно поэтому мы решили посвятить первую сессию тому, как настраивать семантический слой в Data Studio для создания проверенного фундамента, из которого ИИ сможет извлекать ответы, и почему это лучше делать внутри Metabase.
Какой уровень контроля команд требуется для ИИ-аналитики
Именно вокруг этого вопроса мы выстроили сессию «на ваших условиях», и ответы оказались более категоричными, чем мы ожидали.
58% респондентов хотят использовать локальное развертывание (self-hosted) или свою собственную модель. Опрос о суверенитете данных, проведенный прямо во время сессии, привел к тому же результату, но с другой стороны: 58% проголосовавших заявили, что их данные не должны покидать корпоративную сеть, 21% должны соответствовать требованиям HIPAA, BAA или ISO 27001, 16% пока не уверены, 5% зависят от требований к локализации данных, и никто не выбрал вариант «не вызывает особого беспокойства». Два разных вопроса, заданных пересекающимся аудиториям, привели к абсолютно одинаковому результату. Тест анонимный, поэтому мы не можем сказать, насколько сильно пересекаются эти две группы, — мы знаем лишь то, что распределение ответов не изменилось при изменении формулировки вопроса.
Интересно взглянуть на результаты в разрезе опыта. Если разделить ответы о локальном развертывании в зависимости от степени готовности респондентов:
Стремление к контролю обратно пропорционально опыту. Те, кто еще не начал, настаивают громче всех на том, чтобы ничего не покидало пределы компании; те же, кто использует ИИ каждый день, в основном примирились с облаком, у которого есть защитные механизмы. Мы не можем объяснить причины на основе этих данных — возможно, команды с самыми строгими требованиями еще не нашли подходящего решения, либо незнание порождает максимальную осторожность, либо и то, и другое.
Стоит сопоставить с этим пару результатов из опросов. Концепция принеси-свою-модель (BYOM) оказалась жестким требованием для 27% респондентов и предпочтительным вариантом для 55%; лишь 9% ответили, что это не имеет значения. При этом каждый из тех, кто заявил, что данные не должны покидать их сеть, также проголосовал за BYOM, и ни один из них не выбрал вариант «не имеет значения» — эти два пункта воспринимаются как одно требование, а не как два. На вопрос о том, какая проблема ИИ-управления волнует больше всего, самым популярным ответом (44%) стал «что он может видеть», затем идут стоимость (22%), место запуска модели (15%), кто может ее использовать (11%) и след аудита (7%).
Это укладывается в более широкую тенденцию: все больше команд рассматривают суверенитет данных как отправную точку для разговора об ИИ-аналитике, особенно в регулируемых отраслях и организациях, заботящихся о безопасности, которым необходимо гарантировать, что ни байт данных никогда не покинет их сеть. ИИ не создавал эту потребность, но необходимость хранить все на собственной инфраструктуре, осуществлять жесткий контроль, надзор и аудит того, кто и что взаимодействует с вашими данными, стала еще более актуальной с появлением в чатах автономных агентов.
Об отраслях: половина проголосовавших указали, что не работают в регулируемой сфере, 29% выбрали другие регулируемые сферы, 14% — здравоохранение, 7% — финансовые услуги. Всего четырнадцать человек, так что к этому стоит относиться с осторожностью. Наличие или отсутствие регуляций не сделало никого заметно более расслабленным, если это имеет значение при таком размере выборки.
Как люди хотят создавать продукты с использованием данных и ИИ
На вопрос о том, как они хотят работать со своими данными и аналитикой:
Половина всех респондентов хочет использовать агентов. Среди тех, кто уже регулярно использует ИИ, этот показатель составляет 78%. Среди тех, кто еще не начинал, наблюдается почти равное разделение между кодом, MCP и пользовательским интерфейсом (UI).
Мы не можем сказать, что здесь является причиной, а что следствием — то ли регулярная работа с ИИ подталкивает людей к агентам, то ли те, кто изначально мыслит категориями агентов, внедрили его быстрее всех. В выборке из 73 самоотобравшихся участников оба варианта имеют право на жизнь. Можно сказать следующее: на старте предпочтения агентов практически нет, но оно становится подавляющим к тому моменту, когда люди начинают использовать ИИ ежедневно.
Сессия «кнопка сборки» (build button) затрагивала ту же тему. 53% проголосовавших уже подключили инструмент написания кода на базе ИИ к Metabase, 13% — к чему-то другому, а 33% ответили, что пока нет, но очень хотят. На вопрос о том, кто должен владеть дашбордами, если теперь это код: 58% ответили — аналитики, 25% — и те, и другие, 8% — инженеры, 8% — никто не вызвался добровольно. А на вопрос о главных трудностях при управлении дашбордами сегодня: 50% назвали дублирование дашборда между средами, 33% — внесение изменений в продакшен без этапа проверки, 8% — рассинхронизацию между средами, 8% — ничего существенного. В опросе по последним двум пунктам участвовало двенадцать человек, поэтому воспринимайте это скорее как общее настроение, а не точное измерение.
Что люди думают об ИИ-аналитике
Последний вопрос теста был посвящен человеческому фактору: что вы чувствуете в связи с тем, что ИИ меняет вашу роль или роль вашей команды?
Большинство респондентов находятся где-то посередине между любопытством и воодушевлением. Каждый восьмой теряет сон. Беспокойство сосредоточено в группе тех, кто описал себя как заинтересованного, но озабоченного вопросами доступа, безопасности или суверенитета — среди них 27% заявили, что это не дает им спать по ночам. И из всех, кто выбрал этот ответ, две трети все равно хотят подключить агентов к своим данным через MCP.
Еще два среза для протокола: те, кто хочет использовать собственные сервера (self-host), оказались самой оптимистичной группой в выборке — 72% воодушевлены, и всего один человек из 32 встревожен. Те, кто хочет управлять аналитикой как кодом, отстают совсем немного: 71% воодушевлены, один обеспокоен из 21.
Проблема семантического слоя
Семантический слой — это общий набор моделей, метрик и определений, который говорит ИИ, каким данным можно доверять и что они означают.
Это также то, о чем 31% участников нашего опроса никогда не слышали. Еще у 54% есть нечто частично созданное и адаптированное под конкретные задачи, и лишь 15% назвали свой семантический слой зрелым.
Это встречается чаще, чем кажется, и не является катастрофой. Обращение ИИ к «сырым» таблицам обычно работает отлично поначалу, или пока ваша организация и данные еще настолько малы, что у вас есть всего одна таблица с названием accounts. Этот сбой происходит тихо, а не громко: как только появляются accounts_v2 и accounts_final, и нет ничего, что могло бы подсказать агенту, откуда компания на самом деле выставляет счета, ответ по-прежнему возвращается с абсолютно уверенным видом. Чтобы ИИ работал эффективно по мере вашего роста, ему необходим контекст и защитные механизмы — именно поэтому мы считаем, что для ИИ-аналитики семантический слой нужен раньше, чем более совершенная модель.
В Metabase вы строите его в Data Studio, и поскольку мы верим, что каждый заслуживает достоверных ответов от ИИ, основные компоненты бесплатны и имеют открытый исходный код. Вот как создать семантический слой для ИИ-аналитики, если вы начинаете с нуля.
Где узнать больше
Права доступа, суверенитет данных, бизнес-контекст, контроль затрат и возможность аудита — вот те факторы, которые отличают убедительную демо-версию от того, чему действительно можно доверить работу в продакшене.
Пройдите тест самостоятельно, чтобы узнать, как соотносятся ваши ответы, и получить материалы, соответствующие вашему текущему этапу — от старта до масштабирования.
Если вы попали в те 31% или не уверены, является ли ваш семантический слой «зрелым» или «спонтанным», выделите 30 минут для общения с экспертом по продукту. Мы покажем, как выглядит семантический слой на ваших собственных данных.