Прогнозирование времени сквозного дообучения в общих кластерах GPU на основе 272 производственных запусков.
Анонс нашей предстоящей статьи «Прогнозирование времени сквозного дообучения для генеративных языковых моделей». Полная версия скоро появится на arXiv.
GPU сегодня являются одними из самых дорогих и дефицитных ресурсов в области ИИ. Любой, кто управляет общим кластером, должен каждый день решать, какие задачи запускать на каких GPU и в каком порядке. Этот план хорош лишь настолько, насколько точна оценка времени выполнения каждой задачи. Когда задача завершается на несколько часов раньше, GPU простаивают до запуска следующей. Когда она затягивается на несколько часов, все задачи в очереди сдвигаются, эксперименты простаивают, а сроки сдачи переносятся.
Более точные оценки длительности превращают это в планирование, а не в гадание: что запускать, когда и на каком количестве GPU, с меньшим количеством простоев между ними. Тем не менее, оценка, которую используют большинство команд, — это грубый расчет FLOPs «на салфетке». Он обещает девять часов, а задача завершается только на следующий день после обеда.
Мы хотели узнать, насколько сильно эти расчеты отклоняются от реальности и можно ли сделать лучше еще до того, как задача будет отправлена в очередь. Поэтому мы взяли 272 реальные задачи контролируемого дообучения (SFT) из нашего производственного пула GPU NVIDIA H200, что составило около 7 382 GPU-часов, и сравнили аналитические оценки с обученными предикторами.
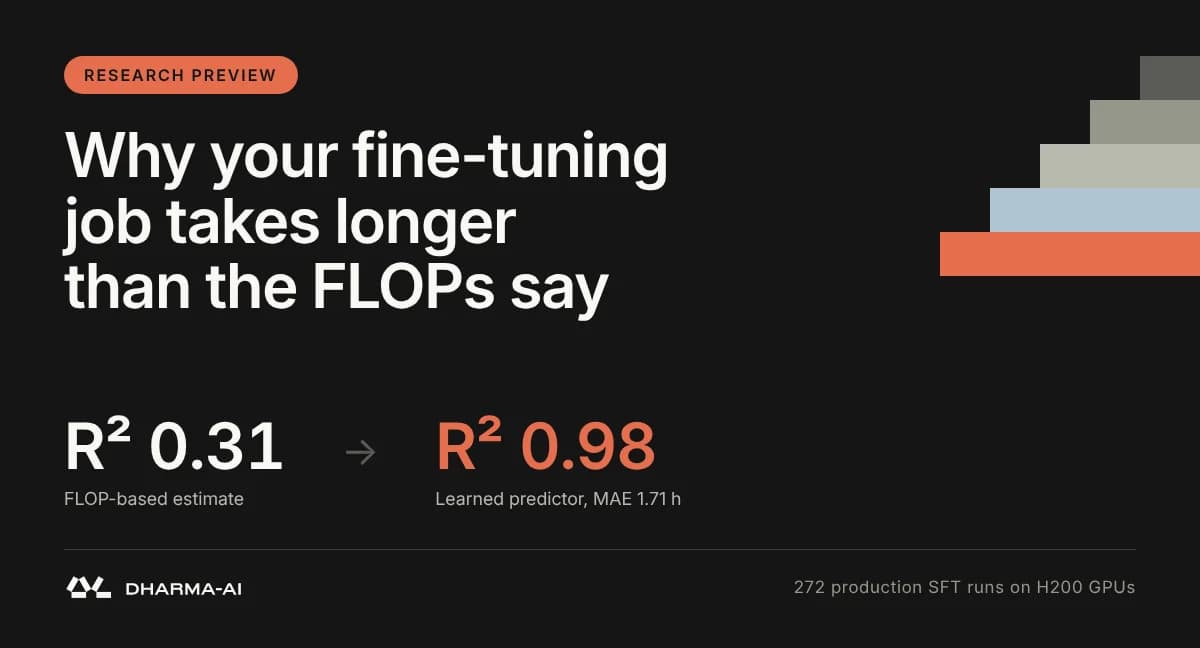
Краткий итог: обычная оценка на основе FLOPs почти не объясняет наблюдаемые результаты (R² = 0,31, MAE 12,41 ч). Регрессор CatBoost, который видит только информацию, доступную до запуска, достигает R² = 0,98 со средней абсолютной ошибкой 1,71 ч и медианной ошибкой 0,51 ч при 5-кратной кросс-валидации. Разрыв возникает из-за двух вещей, которые не может учесть аналитическая формула. Регрессор учитывает больше специфических для обучения сигналов, таких как частота оценки, политика сохранения чекпоинтов, нагрузка на GPU и режим дообучения, а также изучает нелинейные взаимодействия между ними на основе прошлых запусков.
Оценка, которую используют все, учитывает только вычисления
Для плотного трансформера обучение требует примерно 6·P·D операций с плавающей запятой, где P — количество параметров, а D — количество токенов обучения. Разделите это на производительность ваших GPU, и вы получите время цикла обучения:
Здесь N_GPU — количество GPU, FLOPS_peak — пиковая пропускная способность одного GPU согласно спецификации, а MFU (использование FLOPs модели) — доля этого пика, которую реально достигает обучение. Реальные задачи никогда не работают на пике из-за трафика памяти, коммуникаций и неэффективности ядер, поэтому MFU обычно составляет от 30% до 60%, а правильное значение для конкретной задачи заранее неизвестно.
Это хорошее описание цикла оптимизации. Однако задача — это не только цикл. Перед первым шагом происходит настройка среды, загрузка модели и токенизация. Во время обучения проводятся периодические оценки и выгрузка чекпоинтов. В конце финальная модель отправляется в объектное хранилище. В мультиарендном кластере всё это конкурирует с другими задачами за сетевой ввод-вывод и хранилище.
Эти накладные расходы зависят от конфигурации и не масштабируются линейно вместе с рабочей нагрузкой или количеством GPU. Две задачи с одинаковыми номинальными вычислениями могут завершиться с разницей в несколько часов.
Чтобы сравнение было честным, базовый показатель FLOPs, который мы тестируем, учитывает как запланированные токены оценки, так и токены обучения, и мы перебираем MFU в широком диапазоне.
Что мы создали
Мы рассматриваем сквозную длительность как задачу контролируемой регрессии. Имея вектор признаков, построенный на основе конфигурации задачи и метаданных модели, мы предсказываем время по настенным часам с момента получения GPU до завершения задачи. Время ожидания в очереди исключено.
Два проектных решения определили эту работу:
- Все известно до запуска. Каждый входной параметр берется из отправленной конфигурации: гиперпараметры, размеры наборов данных, идентификаторы моделей, распределение GPU. Никаких логов выполнения, никакого частичного прогресса. Именно это делает прогноз пригодным для планирования.
- Признаки, раскрывающие накладные расходы. Помимо исходной конфигурации, мы выводим такие величины, как num_eval_data (образцы, обработанные за все циклы оценки), num_saves и num_params_saved (ввод-вывод чекпоинтов), а также объемы токенов на GPU. Сама оценка FLOPs с фиксированным MFU 0,45 добавляется как еще один признак (baseline_time), поэтому модель начинает с чисто вычислительного числа и изучает поправки.
Мы сравнили линейную регрессию, Ridge, XGBoost и CatBoost. Отбор признаков объединил корреляционную фильтрацию, взаимную информацию и важность перестановок по 18 наборам признаков-кандидатов, за которыми последовал сеточный поиск с критерием MAE. Финальная модель CatBoost использует 24 признака.
Данные
- 272 запуска SFT из операционных логов корпоративной производственной среды, охватывающие несколько семейств моделей до 15 миллиардов параметров, как LoRA, так и полное дообучение, а также широкий спектр размеров наборов данных и гиперпараметров.
- Общая инфраструктура. Задачи выполнялись на 1, 2 или 4 GPU из пула от 8 до 32 H200 на 1–4 узлах, наряду с другими задачами обучения и вывода. Измеренное время включает реальную конкуренцию за ресурсы.
- Длительность от 1,6 до 172,4 часов, со средним значением 23,43 ч и медианой 15,29 ч.
- Стек: Hugging Face Transformers и Unsloth. Мы моделируем стек как категориальный признак и не делаем предположений о фиксированном ускорении между ними.
Распределение сквозной длительности по 272 запускам. Среднее 23,43 ч, медиана 15,29 ч.
Результаты
Все цифры получены в результате стратифицированной 5-кратной кросс-валидации. Первые четыре строки являются аналитическими и не требуют обучения.
Несколько моментов заслуживают внимания.
Ни одно значение MFU не исправляет базовый показатель FLOPs. Мы перебрали MFU от 0,25 до 0,65. Лучшая настройка, 30%, все равно оставляет среднюю ошибку выше 12 часов для задач, которые длятся в среднем 23 часа.
Более детальная аналитическая модель не закрывает этот разрыв. В качестве второй базы мы взяли Calculon (Isaev et al., SC '23), аналитическую модель производительности для обучения LLM из предыдущих работ. Она строит явный граф слоев и учитывает вычисления, трафик памяти и межпроцессорные коммуникации. Мы расширили публичную реализацию, чтобы охватить LoRA, grouped-query attention, fused attention, bfloat16 и SwiGLU. Ее оценки все еще соответствуют медиане лишь в 11% от наблюдаемого времени по настенным часам. Это не упрек Calculon как инструменту пошагового анализа, для чего он и был разработан. Это показывает, какая большая часть производственной задачи происходит вне шага оптимизации.
Линейные модели помогают, а затем останавливаются. Ridge снижает MAE до 7,23 ч. Связь между конфигурацией и длительностью плохо улавливается чисто линейной моделью.
Градиентный бустинг берет на себя основную нагрузку. CatBoost и XGBoost показывают результаты в пределах одного стандартного отклонения друг от друга по каждой метрике. Мы используем CatBoost, так как у него самая низкая средняя ошибка по всем показателям.
На что опирается предиктор
Важность признаков в CatBoost сосредоточена в нескольких ключевых параметрах. Как и ожидалось, среди них присутствуют переменные модели и рабочей нагрузки, но также переменные оценки и контрольных точек. num_eval_data, общее количество выборок, обработанных при оценке за время выполнения задания, занимает первое место, за ним следуют num_trainable_params, batch_eval_size_percent, num_all_params и num_gpus*batch_train_percent, а num_params_saved находится недалеко позади. Значения SHAP подтверждают это: большой объем оценки неизменно увеличивает прогнозируемое время, в то время как количество обучаемых параметров оказывает нелинейное влияние, которое становится значительным только для самых крупных моделей.
Средняя важность признаков модели CatBoost по фолдам (PredictionValuesChange).
Важность признаков не является утверждением о причинно-следственной связи. Тем не менее, закономерность совпадает с тем, как на самом деле расходуется время выполнения задания. То, как часто вы проводите оценку, насколько велик набор для оценки и сколько контрольных точек вы сохраняете, определяет время выполнения, наряду с масштабом модели и набора данных. Это выбор, который люди часто делают по привычке при написании конфигурации обучения.
Одно предостережение при чтении графиков: большие выделения GPU вносят положительный вклад в прогнозируемое время. В наших данных более крупные выделения ресурсов соответствуют более крупным заданиям, поэтому num_gpus частично выступает в качестве прокси-переменной для масштаба задания. Это не означает, что добавление GPU замедляет работу.
Насколько это неточно и где именно
Если посмотреть на все 272 прогноза вне выборки (out-of-fold), медианная абсолютная ошибка составляет 0,51 ч. 80% прогнозов находятся в пределах 2,20 ч, а 90% — в пределах 4,31 ч. В разбивке по длительности задания:
До 60 часов медианная ошибка остается на уровне около одного часа или меньше. Длинный «хвост» — это область, где модель испытывает трудности, и, имея всего 13 запусков длительностью более 60 часов, мы расцениваем это как ограничение данных.
Абсолютная ошибка вне выборки по отношению к реальной длительности, с цветовой кодировкой по диапазону длительности. Ошибки остаются низкими до 60 ч и увеличиваются в разреженном «хвосте».
Больше данных должно помочь. При фиксированной отложенной выборке в 20% MAE падает с 1,63 ч до 1,50 ч при увеличении обучающей выборки с 85% до 100%, без явного выхода на плато.
Для чего это полезно
На практике предсказатель дает планировщику длительность, на которую можно ориентироваться перед началом задания: какие задания запускать вместе, когда освободятся GPU и завершится ли выполнение задания к установленному сроку.
Ограничения
- Только SFT. Мы не включали другие стратегии обучения и согласования, такие как RLHF, DPO или RLVR.
- Один тип GPU. В каждом запуске использовались H200. Обученная модель откалибрована под эту инфраструктуру, и не следует ожидать, что она будет численно переносима на другие поколения GPU без переобучения. Предсказатель для смешанных пулов также потребует дескрипторов оборудования, таких как пропускная способность вычислений, объем памяти и пропускная способность шины, а также топология межсоединений.
- Мало очень длинных запусков. Ошибки увеличиваются после 60 часов.
Что переносится, так это метод: признаки с учетом накладных расходов, отбор с учетом мультиколлинеарности и протокол сравнения. В полной статье будут представлены формулы признаков, процедура отбора, пространства поиска и итоговые гиперпараметры, чтобы конвейер можно было воссоздать на любом наборе данных журналов выполнения с аналогичной структурой.
Следующие пункты в нашем списке: специфические для оборудования дескрипторы и валидация на других типах GPU, трансферное обучение для конфигураций с малым количеством наблюдений, другие цели обучения и больше данных по длительным запускам.
Что дальше
Полная статья скоро появится на arXiv. Подпишитесь на организацию Dharma-AI на Hugging Face, чтобы получить уведомление о выходе, и оставляйте свои вопросы в комментариях ниже. Мы хотели бы узнать, как вы оцениваете длительность заданий в своих кластерах.
Дополнительная литература
- Управление GPU: почему простаивающие GPU — это новые «заземленные» самолеты
- Тот же кластер, на 33 пункта больше утилизации: что изменилось, так это порядок
- Как специализация словаря SLM может сократить затраты на инференс на 77% в реальных приложениях
- Специализация важнее масштаба: стратегическая переменная, которую упускают из виду при принятии решений о закупках ИИ
- Почему специализация неизбежна
- Более новые модели, то же преимущество
- Оптимизация прямого предпочтения (DPO) за пределами чат-ботов
- Дегенерация текста: режим сбоя в продакшене, который не отслеживается большинством бенчмарков
Dharma-AI R&D · Мы делаем ИИ вашей моделью