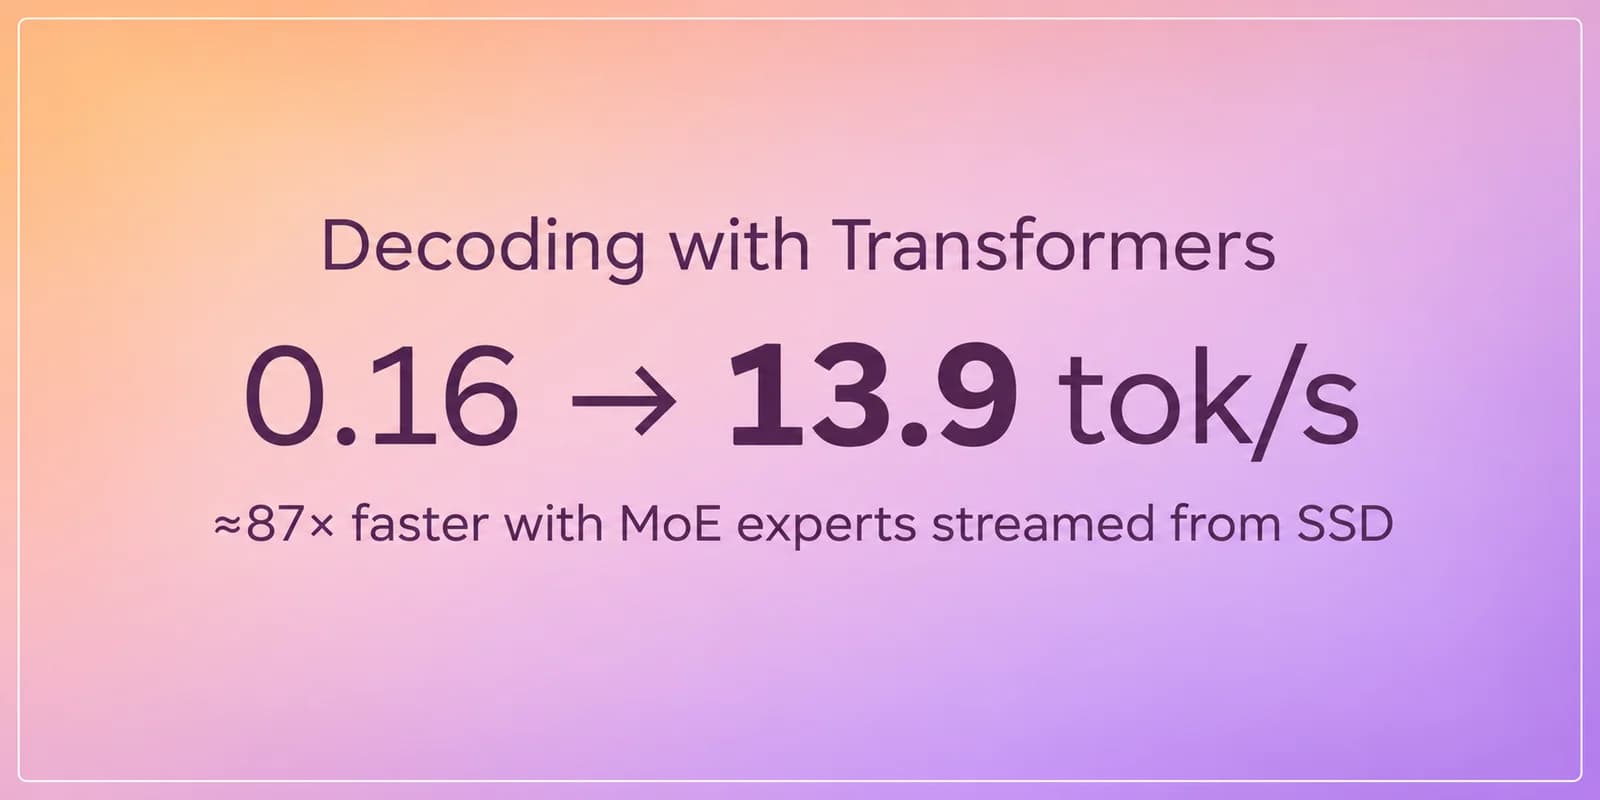
Потоковая передача экспертов MoE напрямую с SSD отстает от Strata в генерации токенов всего на 6%.
Я стараюсь меньше полагаться на онлайн-модели и запускать более крупные локально. Дома у меня есть ПК с двумя RTX 4090 (назовем его Ортрус — двуглавый пес из греческой мифологии), а для работы — MacBook M5 с 32 ГБ объединенной памяти.
Ортрус работает под управлением Windows 11, так как мои дети постоянно играют в игры. У меня стояла двойная загрузка с Ubuntu, но их игры в итоге заняли большую часть двух терабайт диска.
Я также большой поклонник концепции RMD (разработка в движении по комнатам): один час на кухне за чашкой кофе, два часа за рабочим столом в офисе, затем диван. Стационарный настольный ПК — это не для меня.
Моим первым экспериментом был запуск Qwen 3.8 27B с llama.app на Ортрусе и использование его с моего ноутбука через pi. Эта модель выполняет задачи по программированию, онлайн-модель вроде Opus занимается оркестрацией, а вторая карта RTX запускает модель FIM для автодополнения в Neovim.
Когда я рассказал об этом в социальных сетях, то получил множество откликов: используйте Strata с Qwen3.8-Flash-Next.
Что такое Strata?
Strata — это движок инференса для моделей MoE вроде Qwen. В VRAM остаются только горячие эксперты, остальное отправляется в RAM или даже на диски. На экспертов приходится 90%+ весов модели MoE, поэтому такая модель на 180B параметров может работать на GPU с гораздо меньшим объемом памяти. Например, как моя RTX 4090!
Он работает и на ноутбуке, и я наткнулся на эту статью в блоге, где делается именно это: Qwen3.8-Flash-Next на 32 ГБ Mac M4, быстрее, чем llama.cpp, со скоростью 13,5 токенов в секунду.
Это слишком медленно для того, как я использую агентов программирования, но зуд в руках присутствует. Целый ряд моделей MoE не помещается в объединенную память MacBook, но мог бы работать на приличной скорости.
Как выгружают другие движки?
Прежде чем остановиться на Strata, я посмотрел, что делают llama.cpp, vLLM и Transformers, когда модель MoE не помещается целиком. Важны три вопроса: где живут эксперты, где выполняются матричные умножения экспертов и что перемещается на каждом токене?
llama.cpp проецирует файл GGUF с помощью mmap и может удерживать экспертов в CPU (--cpu-moe, --n-cpu-moe N, -ot "exps=CPU" или --fit on, чтобы выбрать за вас). Эти эксперты также вычисляются на CPU, поэтому через PCIe передаются только активации, но никогда не весы. Это отлично, когда эксперты помещаются в RAM. Когда не помещаются, кэш страниц начинает буксовать. Недавно появился кэш экспертов GPU (--moe-cache-mib), но он фрагментирует граф (2 разделения на токен превращаются в 50) и теряет около 10% производительности, даже когда все помещается.
Параметр --cpu-offload-gb N в vLLM помещает N ГБ весов в закрепленную (pinned) оперативная память, а ядра читают их на месте по шине PCIe. Для слоя MoE это только маршрутизируемые эксперты, но ничего не кэшируется: горячий эксперт пересекает PCIe снова на каждом токене, а уровне дисков нет. По умолчанию выгруженные весы включают плотные слои, считываемые на каждом токене; параметр --cpu-offload-params experts ограничивает это только экспертами. Это подходит для больших батчей vLLM, которые в любом случае затрагивают почти каждого эксперта, но в меньшей степени для одного пользователя на одном GPU.
Transformers выполняет выгрузку через Accelerate (device_map="auto", offload_folder), по одному модулю за раз: хуки копируют его весы на GPU перед прямым проходом (forward). Для MoE этим модулем является весь банк экспертов слоя, поэтому каждый токен копирует каждого эксперта каждого выгруженного слоя, чтобы использовать из них 8 или 10. Никакого кэша, никакого понимания маршрутизации. А на Mac CPU и GPU используют одну и ту же память, поэтому «выгрузка на CPU» ничего не освобождает.
Я запустил их все на Qwen3.6-35B-A3B на одной A10G (24 ГБ) с большим объемом оперативной памяти, а Гарри Меллор перезапустил vLLM с лучшими флагами:
Выгрузка только экспертов удваивает скорость vLLM, а FP8 дополнительно помогает (половина байтов на эксперта, больше модели помещается на GPU). Второй бэкенд выгрузки vLLM, который заранее копирует группы слоев, работал со скоростью менее 1 токена в секунду.
Если эксперты помещаются в RAM, llama.cpp трудно превзойти. Если они не помещаются, вам нужно передавать в потоке только то, что выбирает маршрутизатор, через ограниченный кэш, достаточно быстро, чтобы узким местом был SSD, а не Python, и в идеале повторно используя быстрые ядра экспертов модели. Именно так работает Qwen3.8-Flash-Next на 32 ГБ Mac, и Transformers не могла сделать это «из коробки».
Заставляем Qwen3.8-Flash-Next работать на моем 32 ГБ Mac с помощью Transformers
Strata уже работала для меня на ноутбуке слишком медленно, и Transformers не собиралась ее скоро опережать. Но подход Accelerate был настолько далек от идеала, что я захотел попробовать исправить выгрузку в самой Transformers, ориентируясь на большую модель на моем ноутбуке, зная, что она, вероятно, останется слишком медленной для моего стиля работы.
Весь код был создан с помощью ИИ: PR для Transformers, специфический для модели пакет и ядра Metal. Моей задачей было выбирать, что попробовать, читать профили и решать, что оставить. Все находится в Space: tarekziade/moe-expert-streaming.
Начните с малого
Я начал с OLMoE-1B-7B, которая помещается в память, чтобы я мог сравнить каждый токен со стандартной версией Transformers.
Первая версия: эксперты на диске, кэш LRU на устройстве и цикл Python, выполняющий по одному эксперту за раз. Поскольку каждый эксперт уже был закэширован, скорость составила 10,1 токена/с. Стандартная выдавала около 32. Ввод-вывод был нормальным, а мой цикл — нет: стандартная версия использует grouped_mm, который запускает всех экспертов слоя в одном ядре.
Решением и ключевой идеей этого проекта было превратить кэш в пул слотов: один предварительно выделенный тензор устройства, общий для всех слоев, плюс таблица для каждого слоя, сопоставляющая идентификатор эксперта со слотом. Перепроецируйте идентификаторы экспертов маршрутизатора в слоты, и пул будет выглядеть как обычный банк экспертов, поэтому grouped_mm запускается на нем как есть. Пользовательское матричное умножение экспертов не требуется. Это подняло скорость до 34,6 токена/с против 38,1 у стандартной версии.
experts_offload
Затем я превратил автономный загрузчик в опцию from_pretrained в huggingface/transformers#50717. Чтобы попробовать, установите Transformers из этого PR:
Затем, переходя от OLMoE к реальной цели — Qwen3.8-Flash-Next:
Этот репозиторий содержит результат работы скрипта конвертации проекта: плотные весы, квантованные до 3 бит эксперты и таблицу n-граммов.
Эксперты, сопоставленные с «диском», проходят через потоковый путь вместо выгрузки Accelerate: загрузчик пропускает их тензоры, а слои MoE переключаются на реализацию с выгрузкой. Промахи считываются 8 потоками ввода-вывода, по одному непрерывному чтению на эксперта. Маршрутизаторы следующих двух слоев запускаются на текущих скрытых состояниях заранее, чтобы угадать, каких экспертов нужно предварительно загрузить. Эксперты могут быть квантованы офлайн, чтобы чтения занимали меньше места. Это работает для моделей MoE со стандартным расположением экспертов.
API все еще обсуждается с мейнтейнерами Transformers. Форма device_map выросла из этого обсуждения, и квантованные эксперты, вероятно, будут использовать план квантования для каждого слоя из #50245, а не собственную опцию.
Запуск 121 ГБ экспертов на 32 ГБ Mac
У Qwen3.8-Flash-Next 48 слоев по 512 экспертов (10 активных), что составляет 121 ГБ в FP8. Потоковой передачи недостаточно: есть также таблица встраивания n-граммов размером 51 ГБ, для которой нужен собственный дисковый путь. Итого:
- эксперты, квантованные до 3 бит: 49 ГБ на диске, 12 ГБ закэшировано на устройстве
- плотные слои в 8 битах (~5,4 ГБ, перплексия +0,2% по сравнению с BF16)
- таблица n-граммов остается на диске, строки считываются по мере необходимости
Конвертация занимает около 5 часов. После загрузки используется около 18 ГиБ, а промпт на 6 тыс. токенов достигает пика в 25,4 ГиБ. Это примерно предел: мне приходится закрывать браузер, иначе macOS начинает использовать подкачку.
Модельно-специфичные компоненты (таблица n-грамм, ядра Metal) находятся в небольшом пакете , поверх PR. Первая версия работала со скоростью около 10 токен/с.
Затем я установил Strata на том же M5, с теми же промптами:
В Strata 0.1.60 использовались эксперты IQ3_XXS. Обе системы работали в жадном режиме, с отключенными мышлением, MTP и спекулятивными черновиками, а также с блоками предзаполнения по 1024 токена. Полная конфигурация и «сырые» результаты приведены на странице деталей Space.
Я также попробовал vllm-metal, vLLM на графических процессорах Apple через MLX, где недавно появилась выгрузка экспертов. Она передает потоком маршрутизируемых экспертов из чекпоинта MLX через ограниченный кэш, как и этот проект. Но она не может запустить Qwen3.8-Flash-Next на 32 ГБ по указанной выше причине с n-граммами: потоком передаются только эксперты, а таблицы n-грамм остаются в памяти. Это 32 ГБ в чекпоинтах MLX на Hub, до добавления ~5 ГБ плотных слоев и любого кэша экспертов.
Сокращение разрыва
Большая часть времени уходила вовсе не на экспертов. Вот что помогло:
- Ранняя отправка работы на GPU. PyTorch на MPS удерживает небольшие ядра до следующей синхронизации, поэтому GPU простаивал, пока работал Python. Принудительная отправка после каждого блока дала +10%. На самом деле это стоит исправить в PyTorch.
- Ядра Metal для частей, не имеющих быстрого пути на macOS: Gated DeltaNet и гиперсоединения.
- Собственные веса Strata. Я перешел на веса GGUF от Strata, сократив объем трафика плотных весов с 5.4 ГБ до 3.9 ГБ на токен и размер отдельного эксперта с 2.15 МБ до 1.75 МБ, с отдельным пулом кэша для каждого размера эксперта.
- Предзаполнение: скорость выросла с 68 до ~228 токен/с за счет использования больших блоков и чтения экспертов следующего слоя во время вычисления текущего.
- Длинные документы: внимание только по выбранным индексатором блокам и KV-кэш, который растет на месте, а не копируется при каждом токене.
- Промахи: Strata их не скрывает, она ждет, как и я, и ни одна стратегия кэширования не превзошла LRU существенно. Помогло чтение всего одного предполагаемого эксперта на слой, в то время как SSD иначе простаивал бы.
Вот один слой MoE для одного токена в его текущем рабочем состоянии:
Вот конечные результаты после этих оптимизаций на том же M5 с теми же промптами:
Это примерно на 6% отстает от Strata на короткой генерации при немного более быстром предзаполнении, и все это средствами Transformers.
Большая часть оставшегося времени — это круговые обходы хоста, примерно 10 мс на токен. Возобновление работы после синхронизации занимает из этого всего лишь ~1 мс. Все остальное время GPU простаивает, пока Python ставит в очередь следующий слой. Strata заранее ставит в очередь работу для всего токена, а GPU ожидает общее событие Metal на каждом слое, пока хост читает экспертов. PyTorch этого не предоставляет. Я пытался имитировать это с помощью ядра, опрашивающего флаг, записываемый CPU, и GPU требовалось от секунды до бесконечности, чтобы увидеть запись. Реальным решением была бы нативная операция в потоке MPS от PyTorch с риском зависаний, поэтому я не стал ее реализовывать.
Заключение
Работа со скоростью ~14 токен/с близка к Strata, но этого все еще слишком мало для того, как я использую агентов для кодирования. Orthrus продолжает выполнять реальную работу.
Transformers не превзошли Strata, и для преодоления оставшихся ~6% потребовались бы более глубокие изменения в стеке, начиная с контроля над этой послойной синхронизацией, который PyTorch сегодня не дает. Самое интересное — это то, как удалось подобраться так близко: потоковая передача только маршрутизируемых экспертов, ограниченный кэш, с которым grouped_mm работает как есть, и несколько целевых ядер Metal. В проекте нет расширений на C++: только Python, ядра Metal, компилируемые во время выполнения с помощью torch.mps.compile_shader, и предсборные ядра из Hub. Все ядра Metal, написанные для этого эксперимента, теперь опубликованы на Hub, и проект загружает их оттуда.
Впрочем, превзойти Strata никогда не было единственной целью. Создание этого проекта стало отличным способом понять с системной точки зрения, как работают MoE и LLM: насколько разреженной является маршрутизация на самом деле, сколько дает кэш экспертов, куда уходит пропускная способность памяти на токен и сколько времени хост и GPU тратят на ожидание друг друга. Transformers позволяет легко исследовать все это по одному модулю за раз.
Общая реализация потоковой передачи экспертов находится в , а бенчмарки — в Space. Отзывы о подходе и API приветствуются.
Спасибо Педро, Лиззандру и Артуру за их отличные отзывы, а Гарри — за помощь в тестировании vLLM.
Наконец, спасибо Нико Вейту за . Strata задала планку для того, чего можно достичь с помощью потоковой передачи экспертов на потребительском оборудовании, и наличие этих цифр для ориентира подтолкнуло эту работу настолько далеко, насколько это удалось.