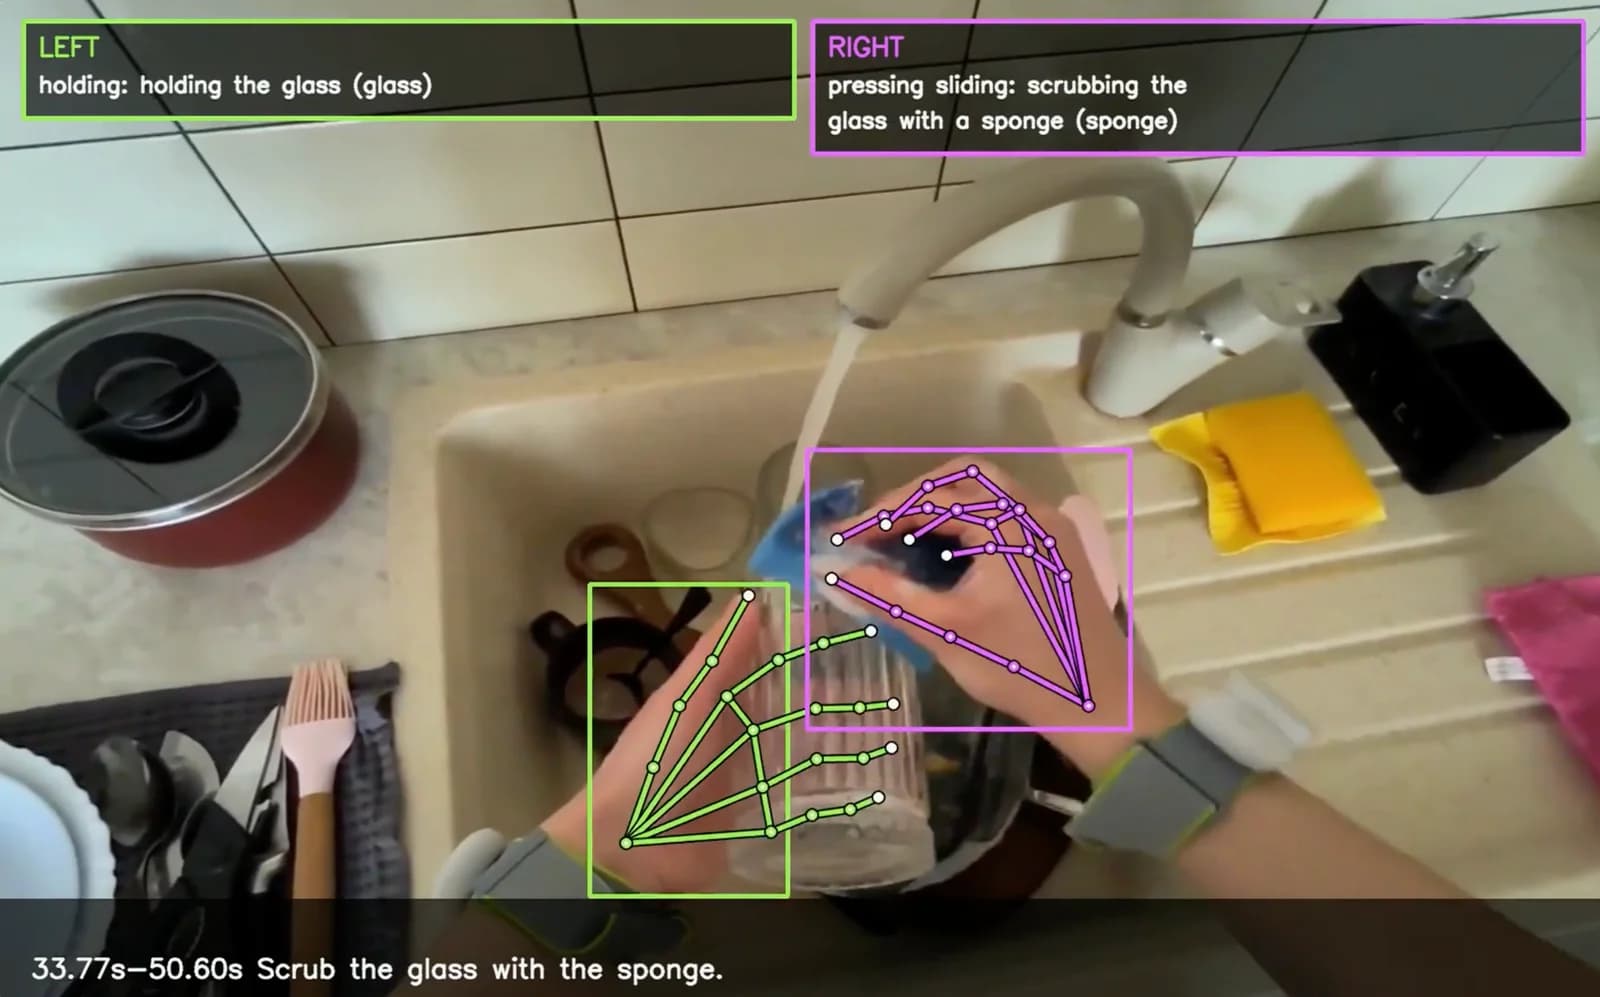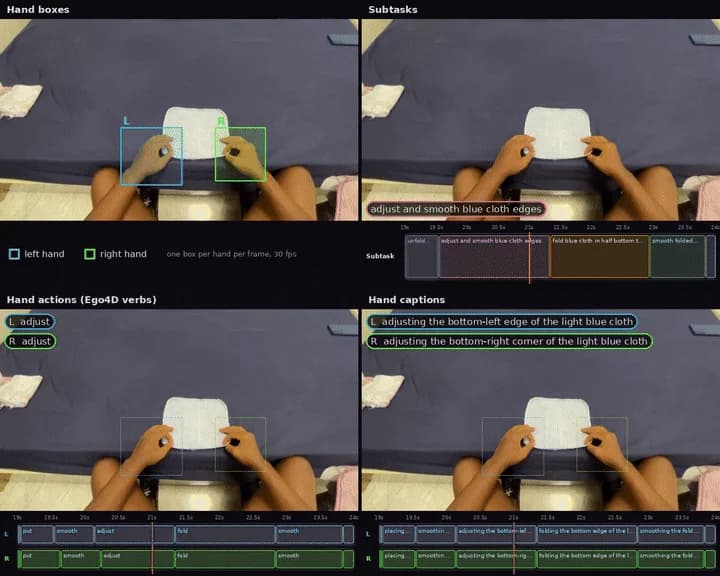
В рамках анонса Perceptron Egocentric 1.0 мы выпускаем в открытый доступ EgoHome — новый бенчмарк эгоцентрического видео с плотной ручной аннотацией: 137 клипов с людьми, выполняющими домашние дела, общей продолжительностью 2 часа.
Мытье посудыЧистка губкой коврика для сушки и раковины, затем ополаскивание коврика под краном.
Аннотации охватывают четыре различные категории:
- Ограничивающие рамки (bounding boxes) положения рук
- Аннотации подзадач
- Действия левой и правой руки (из схемы с закрытым словарем Ego4D)
- Описания (captions) для левой и правой руки.
Мы публикуем необработанные аннотации, а также код для метрик оценки, которые, по нашему мнению, лучше отражают присущую описанию видео с открытым словарем субъективность.
Новый стандарт эгоцентрических аннотаций
Недавние работы подтвердили, что большие объемы разнообразных данных для предварительного обучения необходимы для надежного управления: Physical Intelligence показала, что композиционная обобщаемость может возникать из разнообразных мультимодальных данных и условий [1], Generalist продемонстрировал, что мастерство в конкретных задачах может быть достигнуто путем масштабирования высокоточных данных о физическом взаимодействии [2], а Dyna — что масштабирование эгоцентрических данных является одним из жизнеспособных путей к управлению на человеческом уровне [3]. Богатая эгоцентрическая аннотация, в частности, представляет значительный интерес для мира робототехники благодаря своей масштабируемости [3].
Несмотря на существенные инвестиции в эгоцентрические данные, до сих пор не до конца понятно, какой набор аннотаций лучше всего подходит в качестве целей предварительного обучения и как лучше всего измерять качество синтетической разметки для этих задач.
Наиболее широко используемый эгоцентрический бенчмарк для сегментации подзадач, WGO-Bench [4], стал чрезвычайно полезным вкладом в экосистему и с тех пор превратился в стандарт де-факто для оценки качества моделей или систем при описании событий в эгоцентрическом видео. Несмотря на это, у WGO-Bench есть несколько пробелов в охвате.
Бенчмарк EgoHome от Perceptron устраняет пробелы в текущем состоянии эгоцентрического тестирования тремя способами:
- Четыре типа аннотаций: мы вводим тестирование для (1) положения рамок рук, (2) временных шкал подзадач, (3) классификации действий рук (из закрытого словаря Ego4D) и (4) описаний действий рук в свободной форме.
- Субсекундные аннотации: мы предоставляем большое количество аннотаций на субсекундном уровне. В частности, мы включили 3371 сегмент короче 1 с и 773 сегмента короче 0,5 с.
- Измерение Permissible subsegment Jaccard: мы представляем новую гибкую метрику под названием permissible subsegment Jaccard — метод на основе LLM-судьи, который учитывает тот факт, что существует множество допустимых способов детализации задачи.
Обзор бенчмарка
Наш бенчмарк — первый в своем роде, объединяющий все четыре типа аннотаций для каждого видео. Это выявило неравномерность возможностей передовых моделей: генерация временной шкалы подзадач дается лучшим моделям гораздо лучше, чем описание действий отдельных рук. Мы также предлагаем очень детальные временные аннотации, что позволяет нам анализировать, как снижаются возможности моделей на гораздо более быстрых последовательностях действий.
Четыре типа аннотаций
Аннотации подзадач
Как и в WGO-Bench, у нас есть описания высокоуровневой цели выполняемой задачи с открытым словарем, например, «чистка плиты». В среднем видео содержит 14,0 сегментов.
Положения рамок рук
Мы размечаем каждую рамку руки с помощью людей-аннотаторов с частотой 10 кадров в секунду, а затем применяем проприетарные алгоритмы сглаживания для экстраполяции до 30 кадров в секунду.
Действия рук
Аннотаторы выбирают точную метку действия руки из схемы действий Ego4D с закрытым словарем [5]; всего на выбор предлагается 118 действий (47 встречаются в релизе).
Описания действий рук
Аннотаторы пишут в свободной форме описания того, что делают руки во время видео.
Метрики оценки
Метрика рамок рук: доля попаданий центроида (centroid hit fraction)
Чтобы измерить точность предсказания рамок рук, мы просто просим каждую модель создать ограничивающие рамки с временными метками для положений рук на протяжении всего видео. Для каждого кадра с аннотированной человеком рукой мы проверяем, попадает ли центроид рамки модели для этой руки внутрь рамки человека, а затем делим на количество аннотированных кадров с руками плюс любые рамки, которые модель предсказывает вне аннотированного диапазона.
Модели, которые обрабатывают меньше кадров в секунду, все равно оцениваются по каждому аннотированному кадру: между двумя рамками модели мы линейно интерполируем ее предсказание. Таким образом, модель с частотой 1 кадр в секунду теряет баллы только в тех случаях, когда рука отклоняется от прямолинейной траектории между ее выборками.
Метрика для подзадач, действий и описаний рук: permissible subsegment Jaccard
Мы разработали нашу метрику корректности подзадач, пытаясь найти справедливый способ калибровки наших аннотаторов. Изначально мы использовали метрику, похожую на семантическую F1 в WGO-Bench, которая выполняет двудольное сопоставление (bipartite matching) между целью и предсказанием, а затем вычисляет F1 между наборами предсказаний и целей.
Двудольное сопоставление, распространенное в бенчмарках сегментации объектов, позволяет сопоставить каждый эталонный сегмент (ground truth) ровно с одним предсказанным сегментом. Другими словами, при оценке соответствие между предсказанным и эталонным является взаимно однозначным (one-to-one).
Однако мы обнаружили, что существует множество допустимых способов разделения временной шкалы в видео. Даже если показать одному и тому же аннотатору одно и то же видео, за один раз он может представить мытье посуды как одну задачу, а в другой раз — разбить ее на множество мелких сегментов.
Вместо того чтобы поощрять модели подстраиваться под конкретный выбор временной детализации, мы решили позволить эталонным и предсказанным сегментам сопоставляться друг с другом в формате «многие ко многим» (many-to-many), и адаптировали наш промпт для LLM-судьи так, чтобы предсказанные задачи могли быть подзадачами эталонных или наоборот.
Мы называем нашу метрику permissible subsegment Jaccard.
Пример: лестница
Допустим, в эталоне временной интервал от 0 до 5 с отмечен как один сегмент — «подметание лестницы».
В таблице ниже показано, как различные предсказания будут оцениваться с помощью нашей метрики permissible subsegment Jaccard («многие ко многим») в сравнении с семантической F1 из WGO-Bench («один к одному»).
Эталон (человек)
Модель
Эталон (человек)
Модель
Эталон (человек)
Модель
Эталон (человек)
Модель
При калибровке аннотаторов мы часто сталкивались со случаем B, как показано в таблице 2: валидная, более детальная разбивка получает нулевой балл при сопоставлении «один к одному» и полный балл — в нашей метрике. Случай C показывает, что мы все равно начисляем частичные баллы за ту часть, которую модель определила верно, в то время как фиксированный порог IoU не дает ничего. (Семантическая F1 в WGO-Bench сопоставляет сегменты «один к одному» и учитывает пару только тогда, когда ее временной IoU составляет не менее 0,75 и судья принимает метки).
Мы обнаружили, что эта метрика гораздо точнее соответствует субъективным критериям справедливости при оценке работы людей-аннотаторов во время калибровки, поэтому мы решили выпустить ее в качестве официальной метрики для бенчмарка.
Формальные определения обеих метрик приведены в приложении, а код для расчета баллов находится в нашем репозитории на GitHub.
Сравнение различных моделей
Мы сравниваем Perceptron Egocentric, в его стандартном режиме 4 кадра в секунду и варианте 8 кадров в секунду, с GPT-6 Astra, Gemini 3.8 Flash и Glimpse от Elorian, каждый по 4 кадра в секунду и 1 кадр в секунду, а также с Argus от Pantheon и FLORA от NVIDIA. Подзадачи, действия рук и подписи рук оцениваются с помощью допустимого Jaccard подотрезка, а боксы рук – с помощью доли попадания центроида; чем выше, тем лучше для обоих критериев.
Perceptron Egocentric достигает или превосходит все остальные системы по маркировке подзадач и почти сопоставим с GPT-6 Astra по боксам рук, но отстает в действиях рук и подписи. В целом большинство систем испытывают трудности с идентификацией отдельных действий рук, три части этого бенчмарка, связанных с руками, находятся далеко от насыщения.
Результаты EgoHome
Тонкоразмерные результаты по длине золотого сегмента
Наш бенчмарк является единственным, где достаточный масштаб аннотаций позволяет предложить разбивку производительности по разным временным масштабам. Это показывает, что специализированные системы, такие как FLORA от NVIDIA, работают значительно лучше на коротких временных масштабах, чем некоторые другие модели, которые хорошо справляются с общей метрикой.
Подзадача
Действие руки
Подпись руки
Как мы создали EgoHome
Методология аннотации
Мы начинаем с синтетической маркировки видео, а затем люди редактируют начальные аннотации. Далее один из членов нашей исследовательской команды проверяет каждый клип вручную. Благодаря качеству наших начальных аннотаций и нашему собственному пайплайну проверки мы смогли снизить среднее время повторной аннотации видео до 116 минут за минуту видео по всем четырем типам аннотаций.
Обеспечение качества аннотаторов
Каждый аннотаторм проходит калибровку, в которой он должен достичь высокого уровня согласия с клипом, помеченным членом нашей исследовательской команды. Затем ему разрешается повторить калибровочный клип до 3 раз, с обратной связью после каждой неудачной попытки. Он может увидеть, какие части его ответов были неверными, но не может увидеть истинную правду.
После начальной калибровки краудсорсинговые аннотаторы проходят 10‑клипную калибровку друг с другом, где они оцениваются по тому, насколько высоко их межаннотаточное согласие по сравнению с согласием с оригинальными метками. Через этот процесс мы выбрали 5 аннотаторов (из пула 50) для работы с нашим набором оценки, оставив менее эффективных членов пула для других задач.
Открытый выпуск
Данные можно найти по ссылке Hugging Face в заголовке страницы, а подсказки и метрики – в репозитории GitHub.
Лицензия. Набор EgoHome выпущен под Creative Commons Attribution-NonCommercial 4.0 лицензией (CC BY-NC 4.0). В качестве дополнительного разрешения любой, включая коммерческие организации, может использовать EgoHome для оценки моделей и публикации результатов. Другие коммерческие использования, такие как продажа данных или обучение коммерческих моделей на них, не разрешены.
Приложение
Формулы метрик
Доля попадания центроида
Математически это можно выразить как
CHF=∑(f,h)∈G1[Centroid(p^f,h)∈gf,h]∣G∣+∣Pout∣(1)\operatorname{CHF} = \frac{\displaystyle\sum_{(f,h) \in G} \mathbb{1}\left[\operatorname{Centroid}(\hat{p}_{f,h}) \in g_{f,h}\right]}{|G| + |P_{\text{out}}|} \tag{1}
Где GG – набор кадров, размеченных человеком, при 30 fps, а gf,hg_{f,h} – истинный бокс для руки hh на кадре ff. p^f,h\hat{p}_{f,h} – бокс модели для руки hh на кадре ff: либо прямой бокс, выданный для этого кадра, либо линейная интерполяция между двумя ближайшими боксами; кадры вне диапазона, покрытого моделью, считаются пропущенными. PoutP_{\text{out}} – набор кадров, для которых модель имеет бокс, но истинный бокс отсутствует. Индикатор в числителе равен 1, когда центроид p^f,h\hat{p}_{f,h} попадает внутрь gf,hg_{f,h}.
Допустимый Jaccard подотрезка
Математически это можно выразить следующим образом:
PSJ(P,T)=∑p∈Pm(p,T)+∑t∈Tm(t,P)∑p∈P∣I(p)∣+∑t∈T∣I(t)∣(2)\operatorname{PSJ}(P, T) = \frac{\displaystyle\sum_{p \in P} m(p, T) + \sum_{t \in T} m(t, P)}{\displaystyle\sum_{p \in P} |I(p)| + \sum_{t \in T} |I(t)|} \tag{2}
m(s,S)=∣ I(s)∩⋃s′∈SJ(s,s′)=1I(s′) ∣(3)m(s, S) = \Bigl|\, I(s) \cap \bigcup_{\substack{s' \in S \\ J(s, s') = 1}} I(s') \,\Bigr| \tag{3}
Пусть PP и TT – предсказанные и истинные сегменты. Каждый сегмент ss имеет временной интервал I(s)I(s) и метку, а ∣⋅∣|\cdot| – длительность. J(s,s′)∈{0,1}J(s, s') \in \{0, 1\} – решение LLM‑жюри о том, являются ли две метки допустимыми совпадениями: одинаковое действие или одно подзадачей другого. m(s,S)m(s, S) – часть длительности ss, которая перекрывается некоторым сегментом в SS, принятой жюри.
Жюри‑подсказка
Для подзадач и подписей рук жюри LLM (Gemini 3.5 Flash) решает, описывают ли две перекрывающиеся метки одну и ту же активность; действия рук сопоставляются по их глаголу Ego4D. Это подсказка жюри для подзадач. Для подписей рук «описания подзадач» читается как «подписи активности руки». Подсказки, которые получает каждый модель, находятся в нашем репозитории GitHub.
Дегенеративные базовые модели
Для того чтобы убедиться, что метрика не может быть легко обманута, мы выбрали несколько дегенеративных базовых моделей и определили, как они будут оценены метрикой. Мы выбрали три типа общих базовых моделей:
- Выбор общего ярлыка, например «делаю домашние дела», и применение его к всей временной шкале
- Выбор общего ярлыка и применение его в фиксированных окнах по 2,5 секунды
- Выбор наиболее распространённого/длинного истинного клипа из истинных данных и заполнение всей временной шкалы видео одним заданием.
Общие ярлыки не приносят ничего по подзадачам и подписи. Постоянный «hold» приносит 0,175 по действиям рук, доля времени, когда руки действительно держат. Эти дегенеративные базовые модели представляют собой минимум того, насколько хороша тривиальная базовая модель для задачи. В таблице ниже показано, какие модели превосходят тривиальную базовую модель по трем задачам.
Статистика аннотаций
Подзадачи
Распределение длительностей приведено ниже:
Боксы рук
Вот процент времени, когда правая и левая рука находятся на экране в корпусе:
Действия рук
Подписи рук
Цитирование
Если вы ссылаетесь на эту работу, пожалуйста, цитируйте её как:
Благодарности
Сырой материал для этих данных собран HumanSignal, поставщиком человеческих данных, специализирующимся на сборе и аннотации высококачественных данных для команд ИИ.
Ссылки
- Physical Intelligence. A Steerable Model with Emergent Capabilities. April 2026. pi.website/blog/pi07
Physical Intelligence. A Steerable Model with Emergent Capabilities. April 2026.
- Generalist. GEN-1: Scaling Embodied Foundation Models to Mastery. April 2026. generalistai.com/blog/gen-1
Generalist. GEN-1: Scaling Embodied Foundation Models to Mastery. April 2026.
- Dyna Robotics. Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models. August 2026. dyna.co/dyna-2
Dyna Robotics. Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models. August 2026.
- Macrodata Labs. Segmenting Robot Video into Actionable Subtasks. June 2026. macrodata.co/blog/annotating-robot-video-subtasks
Macrodata Labs. Segmenting Robot Video into Actionable Subtasks. June 2026.
- K. Grauman, A. Westbury, E. Byrne, et al. Ego4D: Around the World in 3,000 Hours of Egocentric Video. CVPR 2022. arXiv:2110.07058
К. Грауман, А. Вестбери, Э. Бирн и др. Ego4D: Вокруг света за 3000 часов эгоцентрического видео. CVPR 2022.