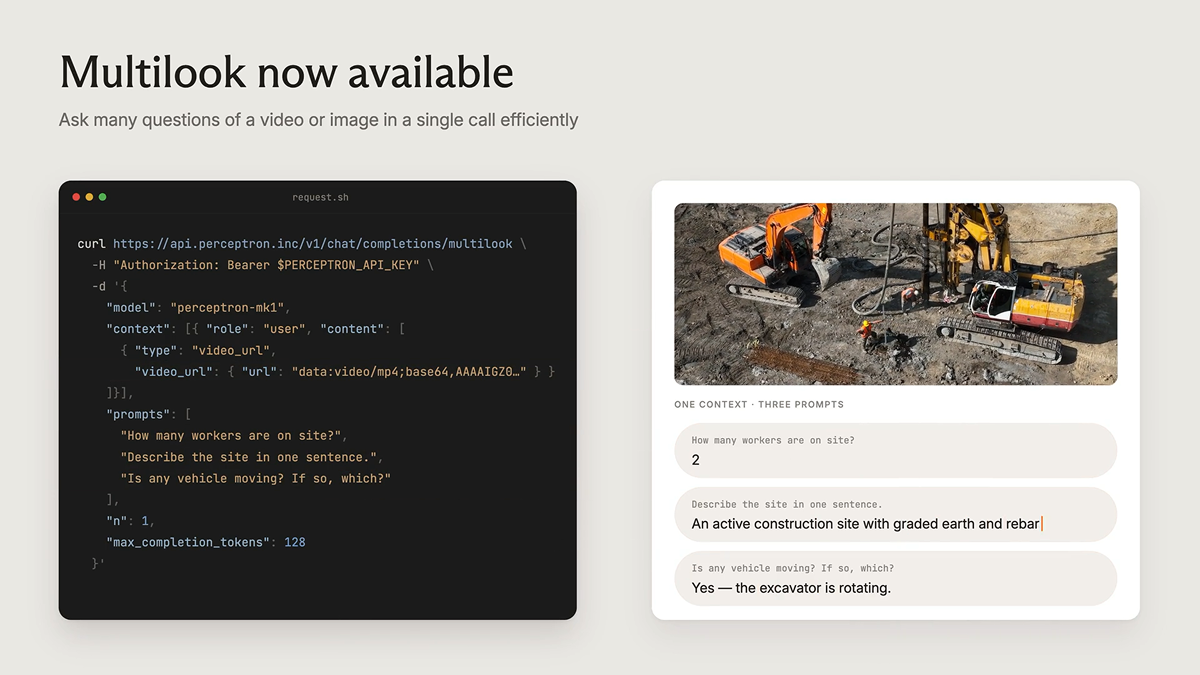
Снижение затрат на повторную отправку контекста
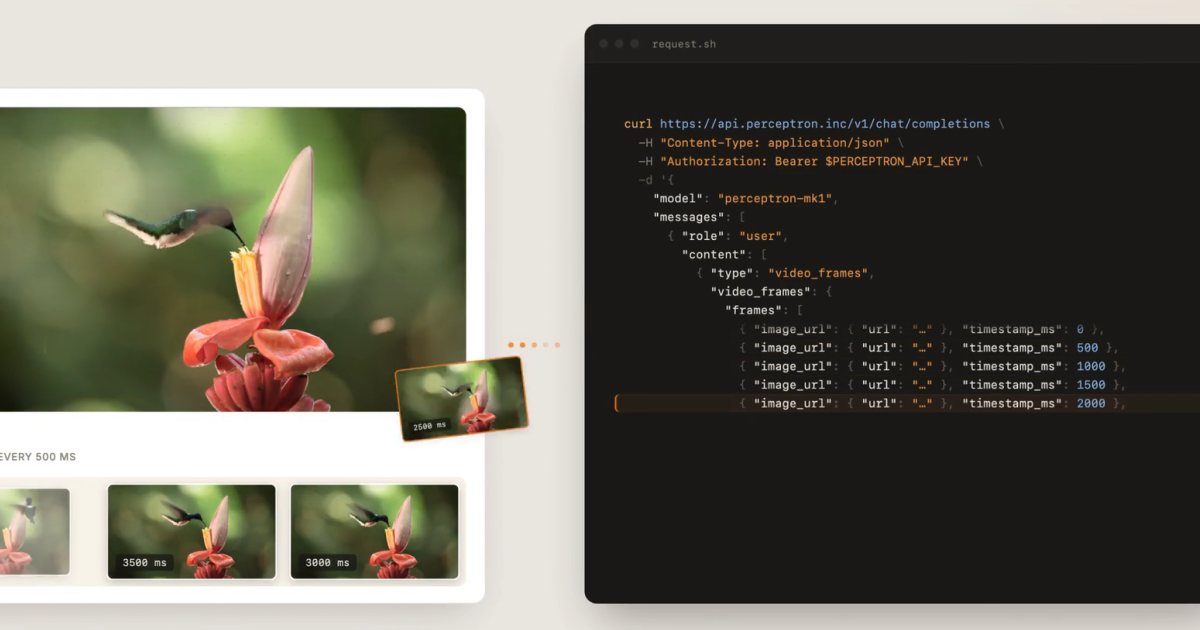
Стандартный способ задать несколько вопросов об одном видео — это несколько запросов. API Perceptron Files исключил передачу байтов из этого цикла: загружаете один раз, а затем ссылаетесь на file-abc123. Проблема предварительного заполнения (prefill) оставалась нерешенной:
- Модель повторно считывает медиа для каждого вопроса. Идентификатор файла экономит на загрузке. Он не экономит на прямом проходе по кадрам. Десять вопросов о десятиминутном ролике означают десять предварительных заполнений по одним и тем же кадрам.
Модель повторно считывает медиа для каждого вопроса. Идентификатор файла экономит на загрузке. Он не экономит на прямом проходе по кадрам. Десять вопросов о десятиминутном ролике означают десять предварительных заполнений по одним и тем же кадрам.
- Стоимость зависит от количества вопросов, а не от объема медиа. 60-кадровый ролик содержит примерно 8600 токенов контекста. Вопрос, который вы к нему прикрепляете, — это предложение. Добавление вопроса добавляет полный контекст, а не предложение.
Стоимость зависит от количества вопросов, а не от объема медиа. 60-кадровый ролик содержит примерно 8600 токенов контекста. Вопрос, который вы к нему прикрепляете, — это предложение. Добавление вопроса добавляет полный контекст, а не предложение.
Создано для двух конкретных рабочих нагрузок
Два шаблона составляют большую часть повторного использования медиа, которое мы видим в продакшене. В обоих случаях медиа фиксировано, а вопросы — нет.
- Фиксированный набор запросов к одному визуальному активу
Фиксированный набор запросов к одному визуальному активу
Наборы запросов часто фиксированы. Каждый эпизод телеуправления получает одни и те же двенадцать вопросов. Каждый кадр инспекции получает те же восемь. Каждый ролик в социальных сетях проходит предопределенную модерацию.
БАЗОВЫЙ МАРШРУТ · ЧЕТЫРЕ ЗАПРОСАMULTILOOK · ОДИН ЗАПРОСвидеоконтекст8624 токзапрос 1ответ 1видеоконтекст8624 токзапрос 2ответ 2видеоконтекст8624 токзапрос 3ответ 3видеоконтекст8624 токзапрос 4ответ 44 предварительных заполнения · 4 слота допуска35 612 ток по $0,15/Мвидеоконтекст8624 токпредварительно заполнено один раззапрос 1ответ 1запрос 2ответ 2запрос 3ответ 3запрос 4ответ 41 предварительное заполнение · 1 слот допуска9740 по $0,15/М + 25 872 по $0,0375/М46% от базовой стоимости ввода · в 2,2 раза дешевлеоплата по тарифу вводаповторно использовано, оплата по тарифу чтения из кэша
С Multilook первый запрос оплачивает контекст по тарифу ввода, а остальные P − 1 промптов оплачивают его по тарифу чтения из кэша. В ответах ничего не меняется.
- Фиксированный набор запросов к одному визуальному активу
Фиксированный набор запросов к одному визуальному активу
Модели Perceptron поддерживают обучение в контексте. Они могут изучить класс обнаружения изображений (например, логотип нишевого бренда, модель автомобиля) или класс обнаружения видео (например, нарушения OSHA, заранее записанные промышленные стандартные операционные процедуры) на основе визуальных примеров, а не текстовой метки. Эти визуальные примеры богаты токенами, но остаются идентичными по байтам при каждом вызове.
Повторное использование ограничено одним вызовом, поэтому экономия достигается за счет пакетной обработки ваших целей в одном запросе Multilook. Идентичный вызов секундой позже выполнит предварительное заполнение с нуля. Поместите набор примеров в контекст, а цели — в промпты, и примеры, которые составляют богатую токенами часть, будут вычислены один раз для всей партии.
БАЗОВЫЙ МАРШРУТ · ШЕСТНАДЦАТЬ ЗАПРОСОВMULTILOOK · ОДИН ЗАПРОСq1 · s1q1 · s2q1 · s3q1 · s4q2 · s1q2 · s2q2 · s3q2 · s4q3 · s1q3 · s2q3 · s3q3 · s4q4 · s1q4 · s2q4 · s3q4 · s4набор примеров отправлен 16 раз16 предварительных заполнений · 16 слотов допуска142 448 ток по $0,15/М3 примера8624 токпредварительно заполнено один разn = 4 образцазапрос 1запрос 2запрос 3запрос 4набор примеров отправлен один раз1 предварительное заполнение · 1 слот допуска9740 по $0,15/М + 25 872 по $0,0375/М11% от базовой стоимости вводаоплата по тарифу вводаповторно использовано, оплата по тарифу чтения из кэша
Поместите примеры в контекст, и они будут предварительно заполнены один раз для всей партии. Например, получение восьми образцов для голосования стоит одно предварительное заполнение, а не восемь, потому что n завершений на промпт не требуют повторной оплаты токенов промпта.
Четыре промпта по четыре образца каждый стоят около 11% от входных токенов, которые потребовали бы те же шестнадцать запросов. Ценообразование следует за тем, как обрабатывается вызов: общий контекст оплачивается по полному тарифу ввода один раз, каждый дополнительный промпт считывает его по 25% тарифу кэша, а дополнительные образцы стоят только их выходных токенов.
Как это работает
- Один общий префикс, предварительно заполненный один раз. Контекст использует тот же формат сообщений, что и запрос чата. Он предварительно заполняется один раз за вызов, и каждая запись в промптах расширяет его.
Один общий префикс, предварительно заполненный один раз. Контекст использует тот же формат сообщений, что и запрос чата. Он предварительно заполняется один раз за вызов, и каждая запись в промптах расширяет его.
- Промпты изолированы. Каждая запись в промптах — это содержимое неявного финального хода пользователя, либо простая строка, либо список частей содержимого. Ни один промпт не видит текст или завершения другого промпта.
Промпты изолированы. Каждая запись в промптах — это содержимое неявного финального хода пользователя, либо простая строка, либо список частей содержимого. Ни один промпт не видит текст или завершения другого промпта.
- Повторное использование ограничено вызовом. Соль для каждого запроса сохраняет предварительное заполнение приватным для вызова, который его создал. Идентичный вызов секундой позже сообщает cached_tokens: 0. Ничего не передается между запросами, ключами или организациями.
Повторное использование ограничено вызовом. Соль для каждого запроса сохраняет предварительное заполнение приватным для вызова, который его создал. Идентичный вызов секундой позже сообщает cached_tokens: 0. Ничего не передается между запросами, ключами или организациями.
- Повторное использование сообщается, а не выводится. usage.prompt_tokens_details.cached_tokens — это подмножество prompt_tokens, обслуживаемое из предварительного заполнения внутри запроса, и именно к нему применяется тариф чтения из кэша.
Повторное использование сообщается, а не выводится. usage.prompt_tokens_details.cached_tokens — это подмножество prompt_tokens, обслуживаемое из предварительного заполнения внутри запроса, и именно к нему применяется тариф чтения из кэша.
Результаты возвращаются в порядке запроса, по одной записи на промпт, с повторным использованием, указанным в конверте:
Производительность
Если ваша рабочая нагрузка задает несколько вопросов к одному и тому же изображению или видео, или требует нескольких образцов на промпт, Multilook делает за один вызов API то, что иначе потребовало бы множества параллельных запросов /v1/chat/completions, обеспечивая при этом лучшую задержку и стоимость.
Время выполнения на единицу при параллелизме=16
Формаp50 к p95, секунды
P=4, n=1
P=8, n=1
P=4, n=4
Базовый маршрутMultilookзаполненный маркер p50, полый маркер p95, общая ось от 0 до 44 с
Задержка одного вызова Multilook с количеством промптов (P)
ОбразцыP=2P=4P=8P=16
n=1
4,0 с
2,00 с / промпт
P=2, n=14,0 с для 2 завершений2,00 с на завершение
3,7 с
0,93 с / промпт
P=4, n=13,7 с для 4 завершений0,93 с на завершение
4,5 с
0,56 с / промпт
P=8, n=14,5 с для 8 завершений0,56 с на завершение
8,6 с
0,54 с / промпт
P=16, n=18,6 с для 16 завершений0,54 с на завершение
n=4
3,5 с
1,75 с / промпт
P=2, n=43,5 с для 8 завершений0,44 с на завершение
6,1 с
1,52 с / промпт
P=4, n=46,1 с для 16 завершений0,38 с на завершение
10,0 с
1,25 с / промпт
P=8, n=410,0 с для 32 завершений0,31 с на завершение
18,3 с
1,14 с / промпт
P=16, n=418,3 с для 64 завершений0,29 с на завершение
столбцы используют одну шкалу, от 0 до 20 с · время на промпт падает с 2,00 с при P=2 до 0,54 с при P=16
Что касается задержки, добавление промптов в один вызов обходится гораздо дешевле, чем добавление отдельных вызовов: общие медиаданные обрабатываются один раз, поэтому время на один промпт сокращается по мере увеличения количества вызовов, запросы с несколькими выборками возвращаются за долю времени, необходимого при использовании паттерна с отдельными запросами, а время отклика остается стабильным при нагрузке, в то время как параллельный паттерн создает очередь из-за дублирования работы.
Стоимость ввода в зависимости от количества промптов на вызов
ПромптыПри скорости вводаПри скорости чтения из кэшаСтоимость ввода по сравнению с отдельными запросами
P=29,1828,624
64% · в 1,6 раза дешевле
P=49,74025,872
46% · в 2,2 раза дешевле
P=810,85660,368
36% · в 2,7 раза дешевле
P=1613,088129,360
32% · в 3,1 раза дешевле
Отдельные запросыMultilookпунктирная линия обозначает нижний порог в 25% · только стоимость ввода
Что касается стоимости, общий контекст тарифицируется по полной ставке ровно один раз, а каждый дополнительный промпт считывает его из кэша за долю цены, при этом каждый промпт тарифицируется один раз независимо от того, сколько выборок вы делаете. Это создает экономию, которая растет вместе с количеством промптов и выборок. С точки зрения реализации, это заменяет задачу оркестрации на стороне клиента. Теперь при одном запросе медиаданные отправляются один раз, а один ответ группируется для каждого промпта.
Создано для продакшена
- Частичный сбой обрабатывается для каждого промпта отдельно. Промпт, который завершился с ошибкой, возвращает объект ошибки вместо своих результатов, а остальные остаются незатронутыми. Вызов возвращает 200, если успешно выполнился хотя бы один промпт. Если все они завершились с ошибкой, запрос возвращает статус первой ошибки.
Частичный сбой обрабатывается для каждого промпта отдельно. Промпт, который завершился с ошибкой, возвращает объект ошибки вместо своих результатов, а остальные остаются незатронутыми. Вызов возвращает 200, если успешно выполнился хотя бы один промпт. Если все они завершились с ошибкой, запрос возвращает статус первой ошибки.
- Отдельный лимит запросов. 150 запросов в минуту, независимо от /v1/chat/completions, поэтому пакетное задание Multilook не расходует ваш интерактивный бюджет.
Отдельный лимит запросов. 150 запросов в минуту, независимо от /v1/chat/completions, поэтому пакетное задание Multilook не расходует ваш интерактивный бюджет.
- Ограничено по дизайну. До 16 промптов, 64 результата и 256 изображений или видео на вызов, в пределах тела запроса размером 20 МБ и бюджета времени 300 секунд. При превышении времени ожидания повторите попытку с меньшим количеством промптов, меньшим значением n или меньшим параметром max_completion_tokens.
Ограничено по дизайну. До 16 промптов, 64 результата и 256 изображений или видео на вызов, в пределах тела запроса размером 20 МБ и бюджета времени 300 секунд. При превышении времени ожидания повторите попытку с меньшим количеством промптов, меньшим значением n или меньшим параметром max_completion_tokens.
Приложения
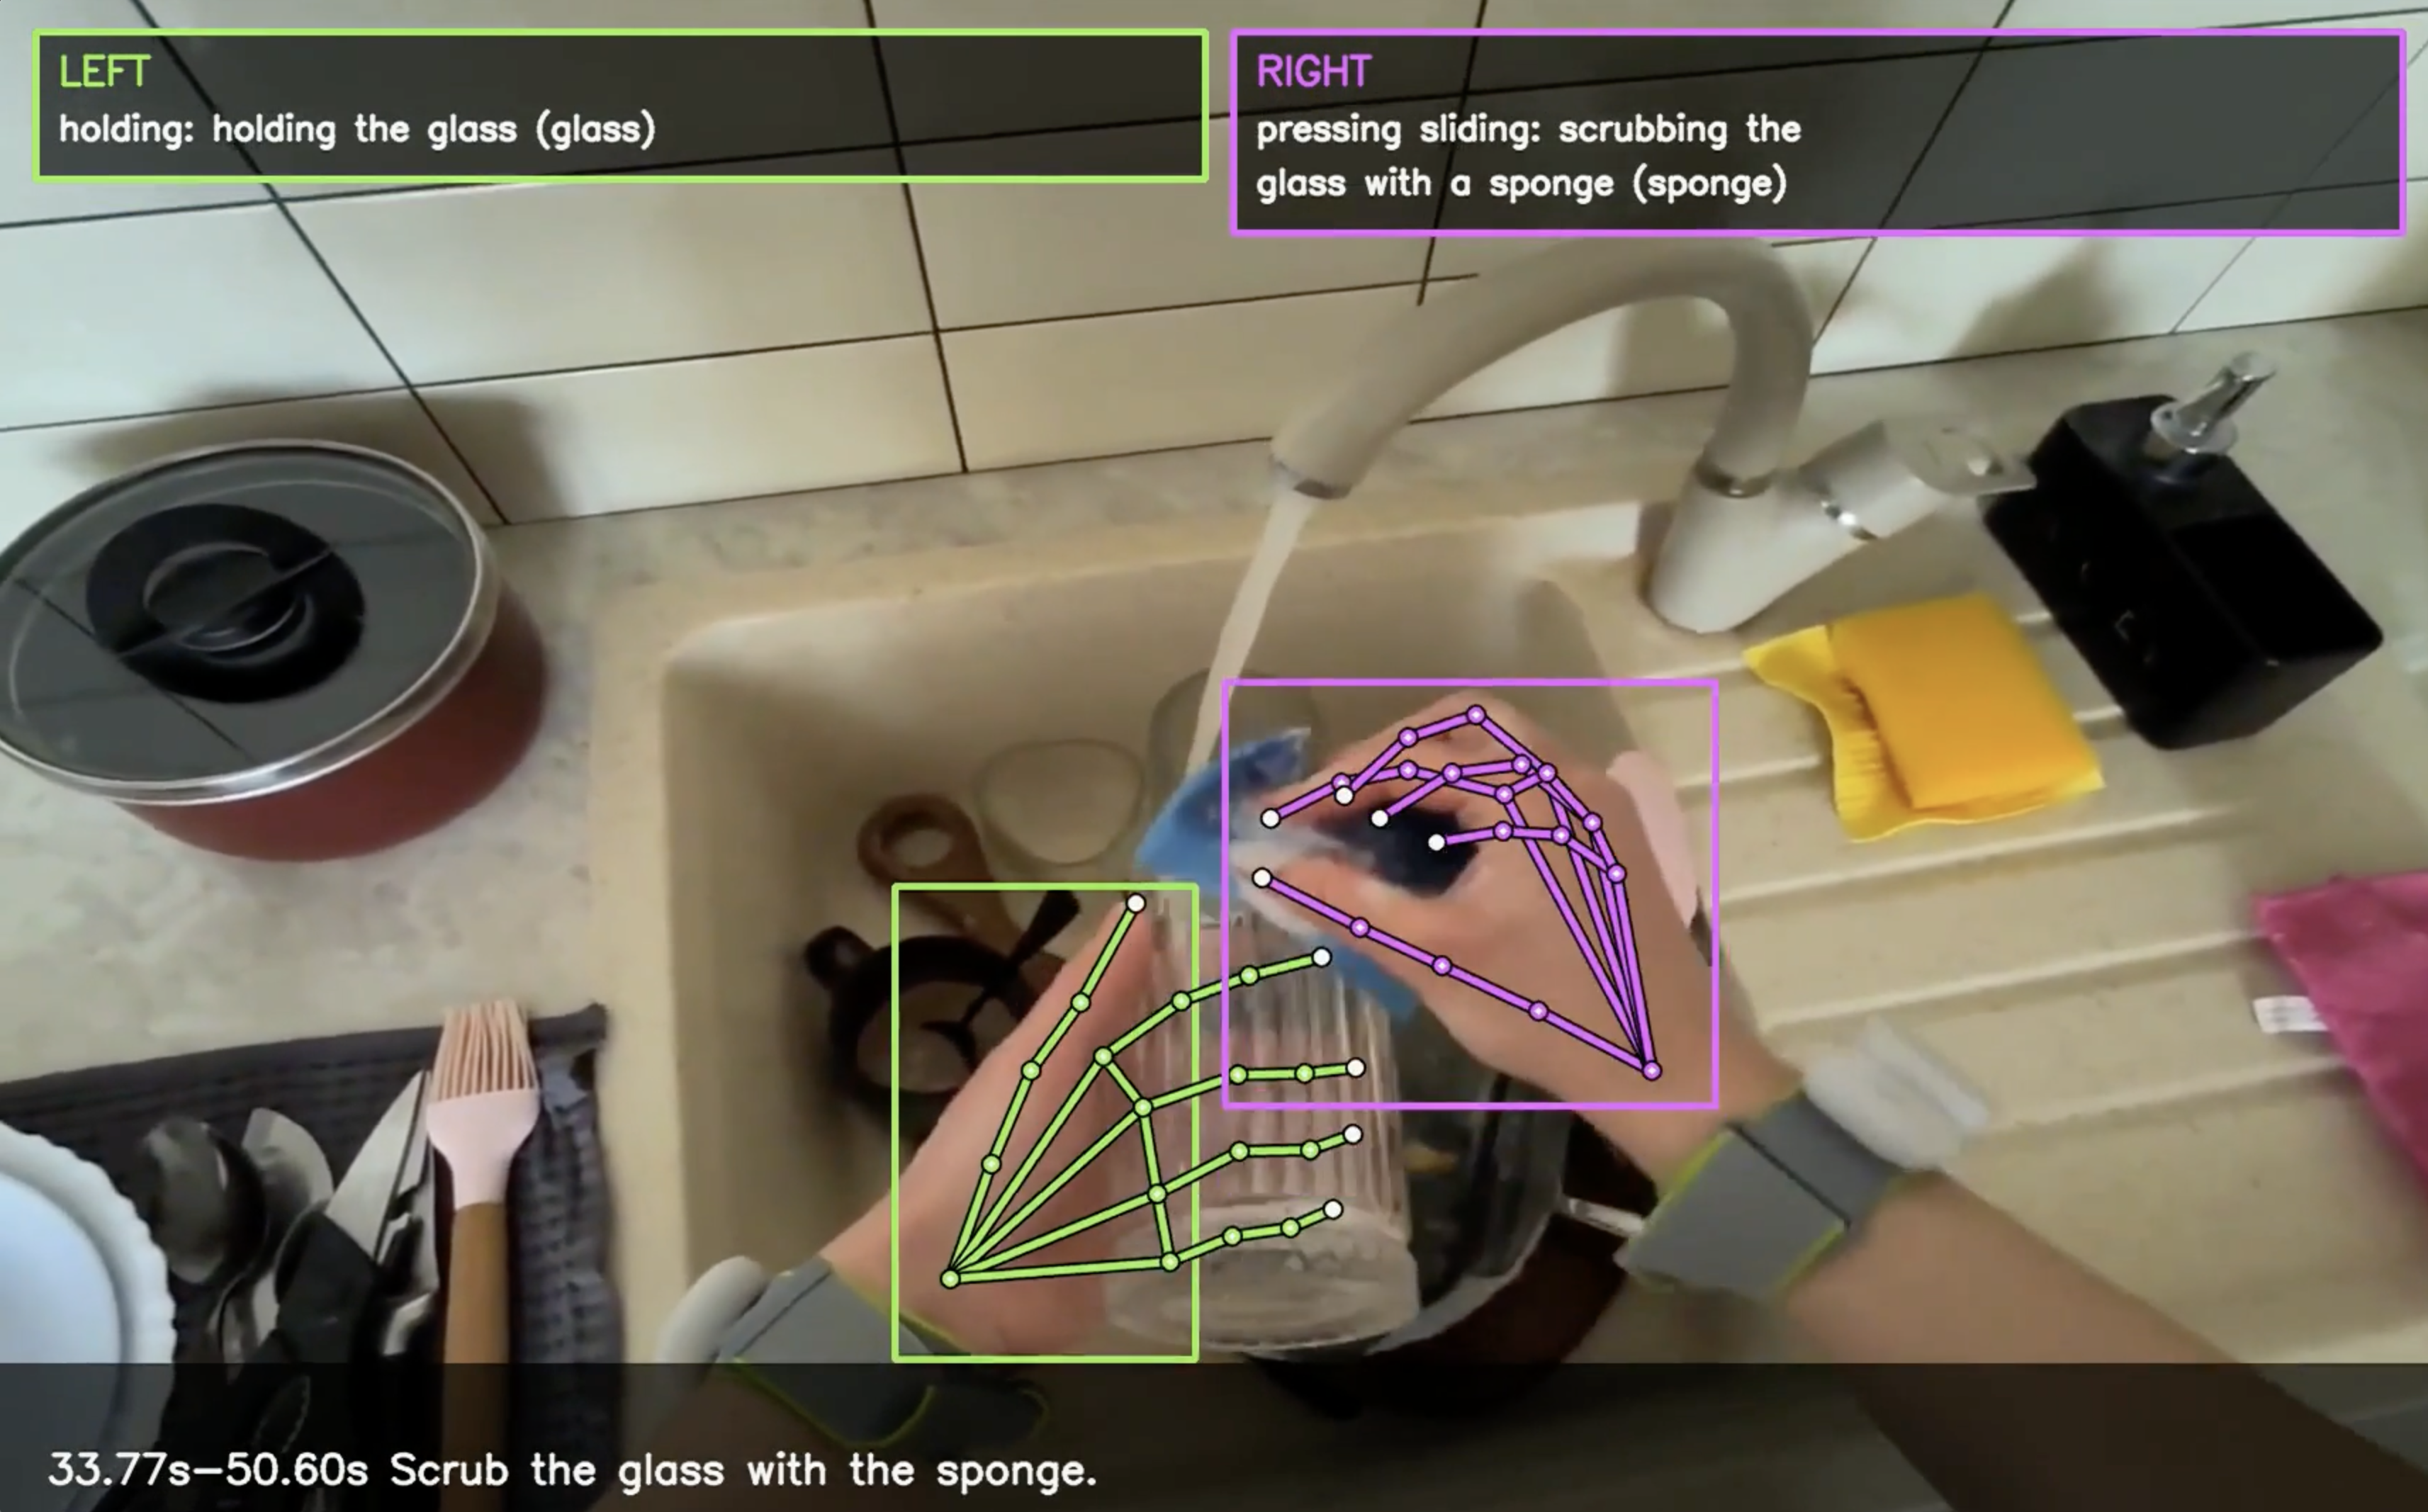
Робототехника и автоматизация. Телеуправление с аннотированием по заданному набору: границы подзадач, попытки захвата, успех или неудача, а также оценка качества эпизода для фильтрации.
Производство и промышленность. Непрерывный мониторинг процедур и безопасности на соответствие стандартным операционным процедурам (SOP) с использованием визуальных примеров в контексте, вместо дообучения (fine-tuning).
Медиа и контент. Модерация контента, где каждая загрузка требует полной проверки на соответствие политике (например, безопасность бренда, возрастной рейтинг, описание).
Геопространственные данные и критическая инфраструктура. Один вид с воздуха на коридор, запрашиваемый для нескольких характеристик, например, зарастание растительностью, состояние оборудования и состояние подъездных путей.
Безопасность и наблюдение. Мониторинг событий и сортировка, где каждое обнаружение требует детального анализа: что произошло, требует ли это действий и соответствует ли оно примерам прошлых ложных срабатываний.
Розничная торговля. Операционный мониторинг, где один снимок полки требует анализа нескольких атрибутов, например, отсутствия товара и читаемости ценников.
Начало работыMultilook доступен уже сегодня.
ЭндпоинтPOST api.perceptron.inc/v1/chat/completions/multilook
ID моделиperceptron-mk1
Ввод$0.15 / млн токенов
Чтение из кэша$0.0375 / млн токенов
Вывод$1.50 / млн токенов
Промптов на вызовОт 1 до 16
Результатов на вызов64 (промпты x n)
Медиавходов на вызов256, каждый кадр видео считается за один
Лимит запросов150 / мин, отдельный лимит
Бюджет запроса300 с