В наших экспериментах масштабирование общего видео с 1 000 до одного миллиона часов сократило объем телеуправления, необходимого для достижения хорошо откалиброванных потерь на отложенных действиях, с примерно 5 900 часов до 28.
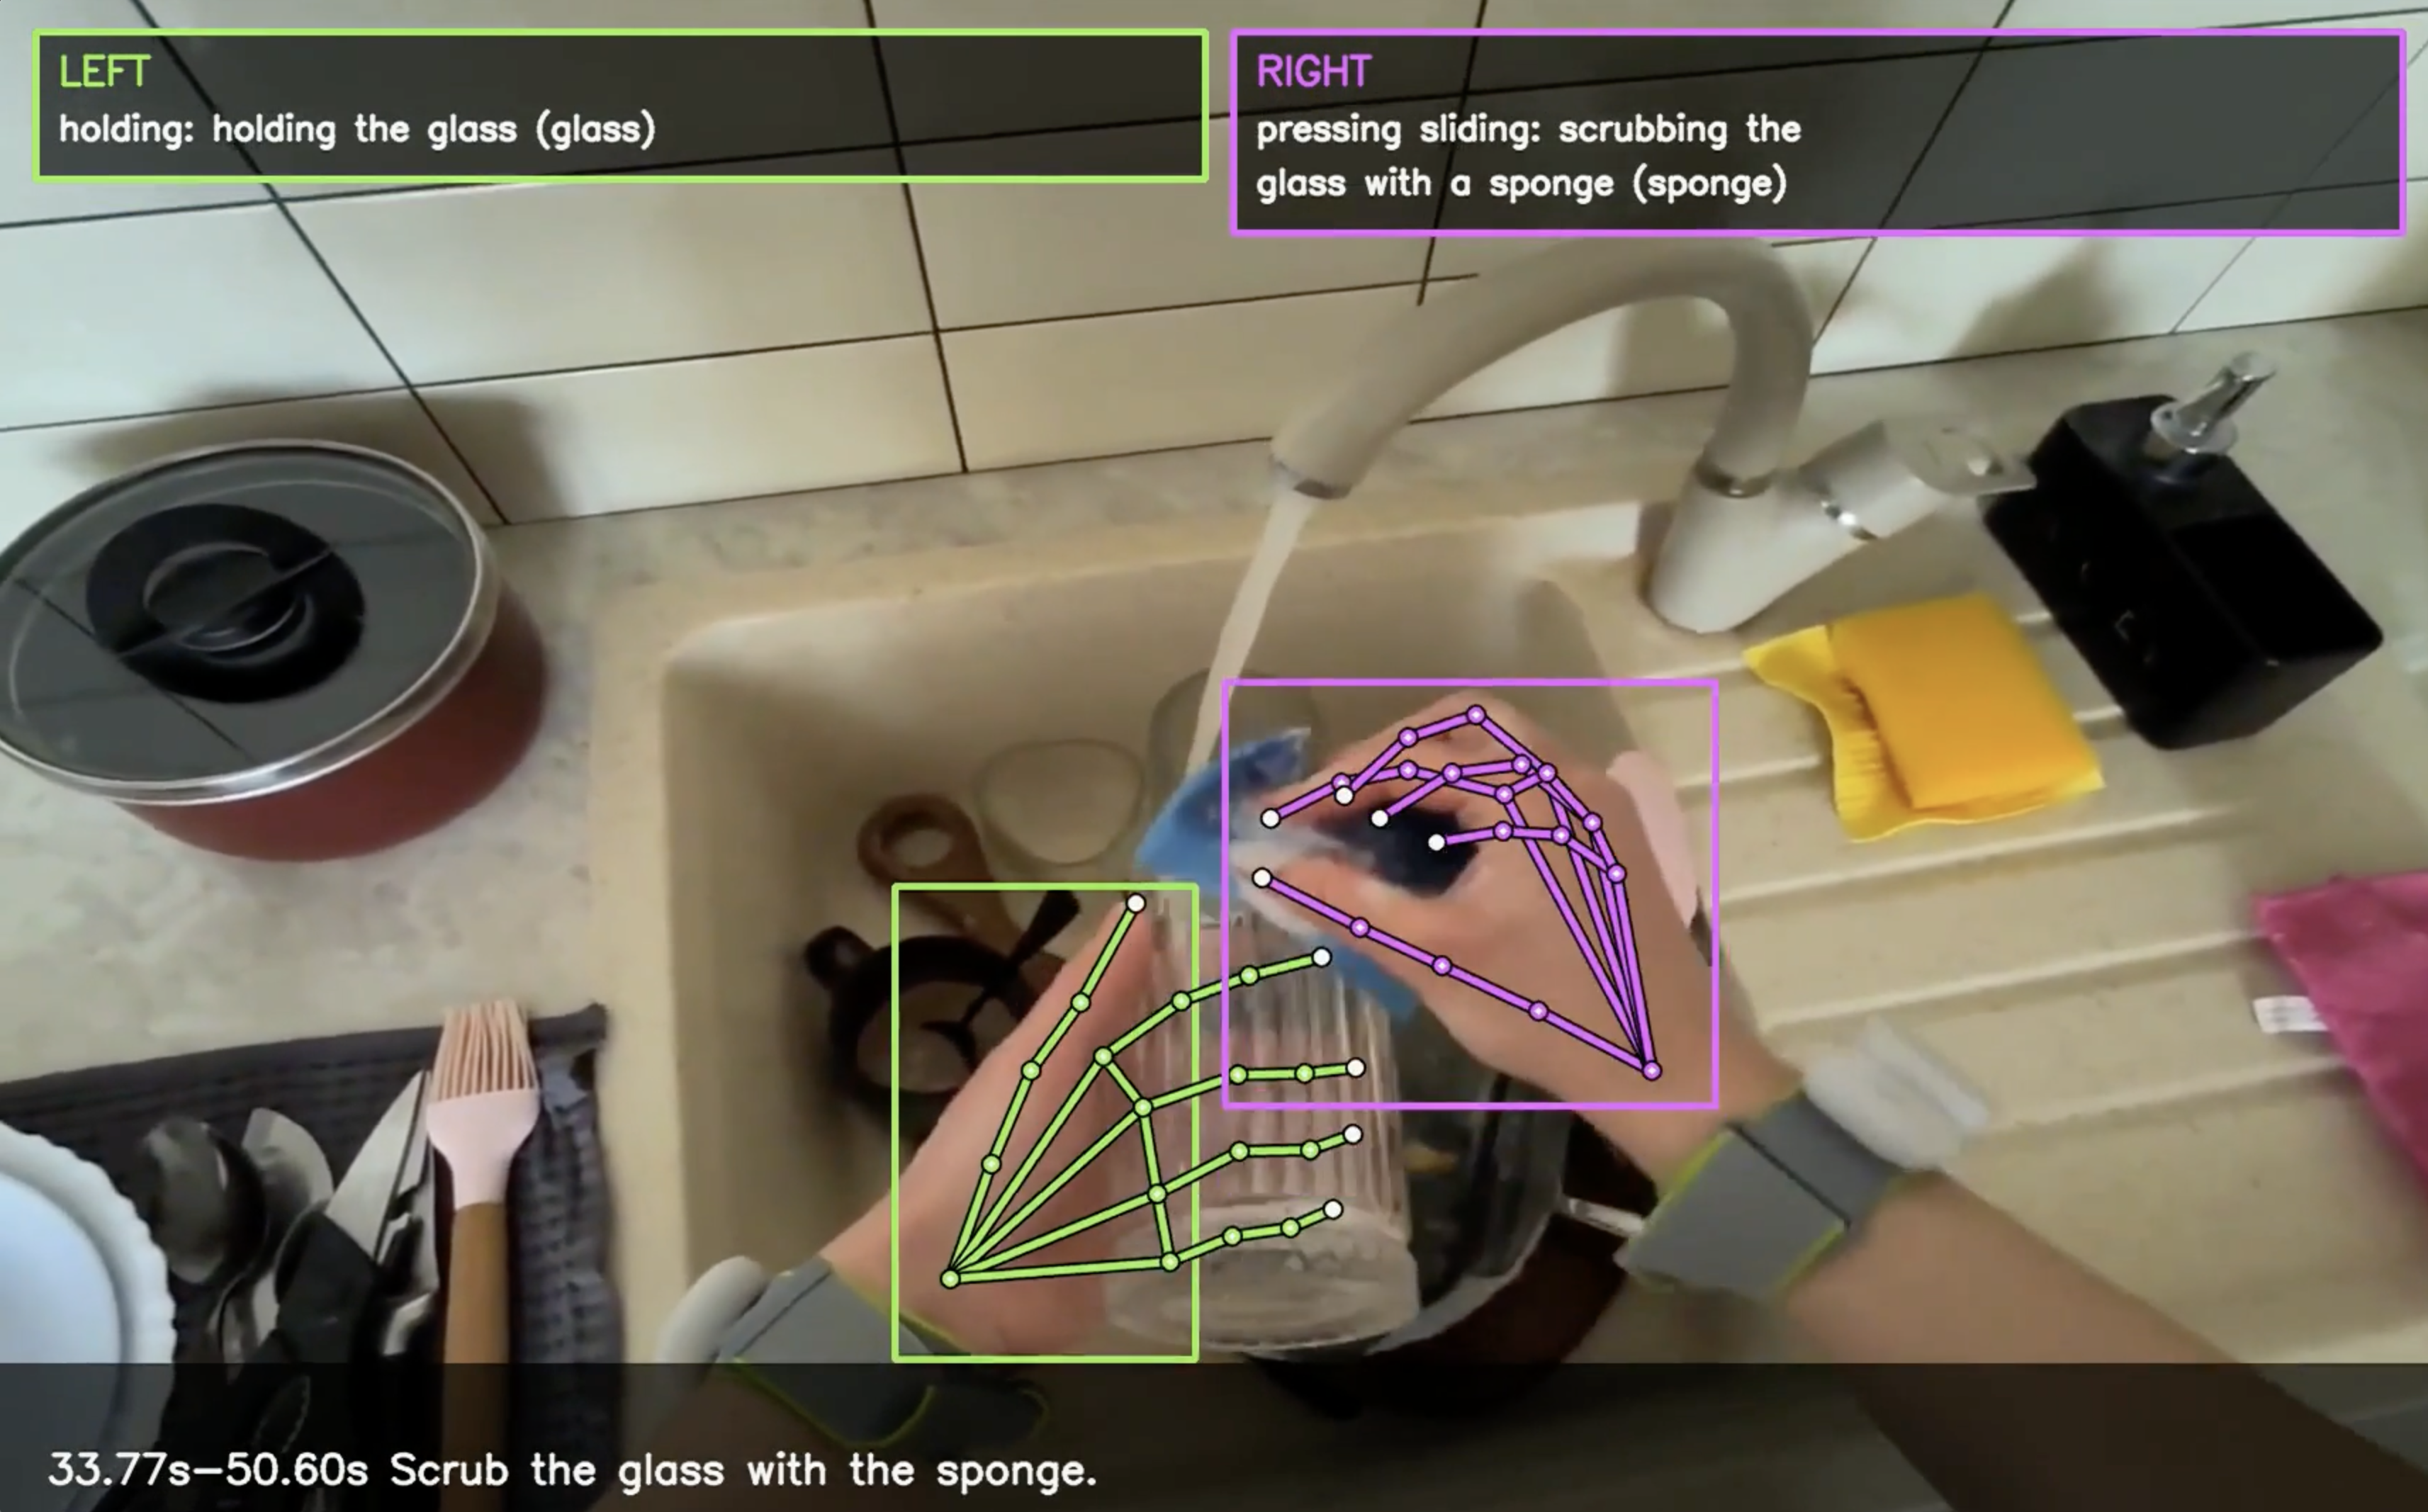
Isaac — это разреженная модель с 36 миллиардами параметров. Она считывает изображения, видео, языковые инструкции, состояние робота и предыдущие действия. Она может отвечать на вопросы о видео, указывать на объекты и их части, отслеживать их с течением времени, сообщать о прогрессе выполнения задачи и генерировать действия робота. Команды могут дообучать ее в качестве политики или использовать ее визуальные выходы внутри планировщика, контроллера или движка данных.
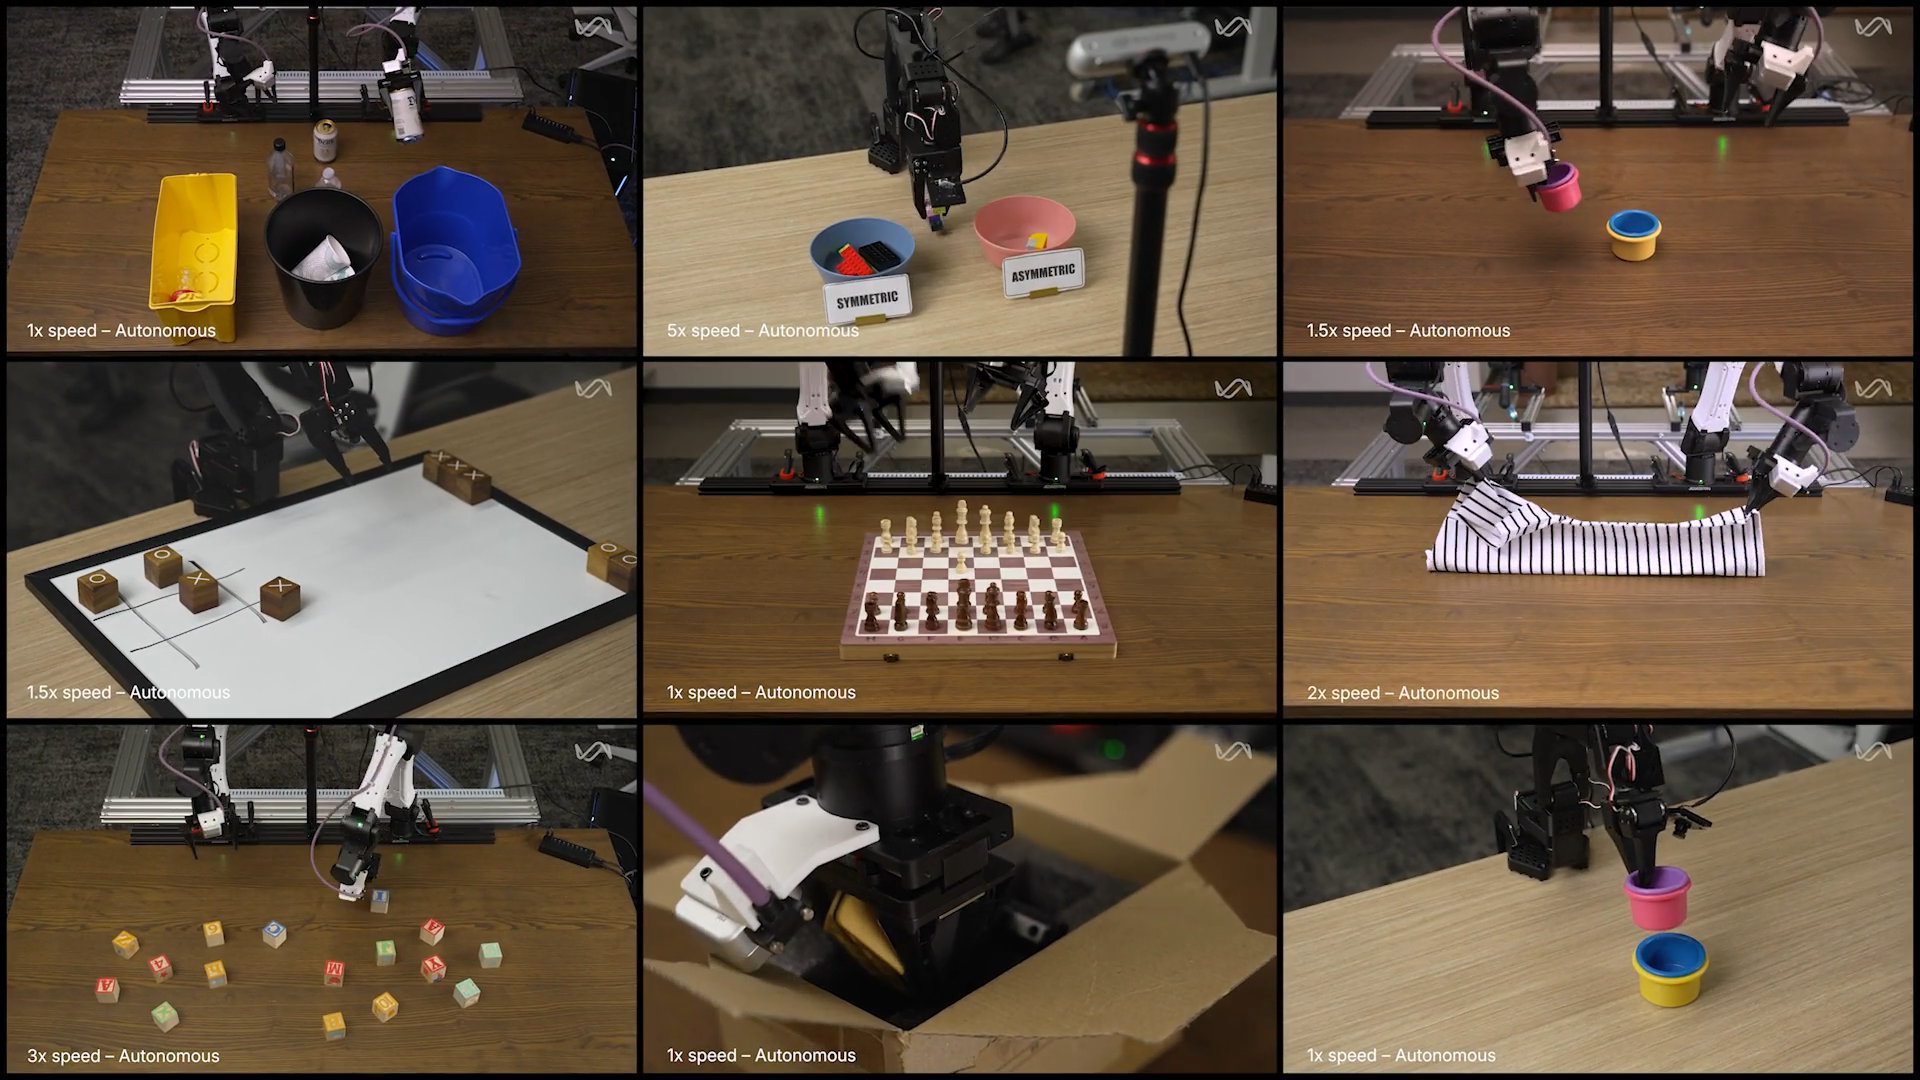
Мы обучили Isaac на данных более чем 35 робототехнических систем, 100 тыс. часов опыта работы роботов, 1 млн часов общего видео и 3 трлн мультимодальных токенов. Мы совместно обучали пониманию видео, пространственному обоснованию, прогрессу выполнения задач и действиям роботов с самого начала.
Сравнение рецептов управления
МОДЕЛЬ
ОБЛАСТЬ ОБУЧЕНИЯ РОБОТОВ
ШАГИ НАБЛЮДЕНИЯ
RTC- ОБУЧЕННЫЕ
ПРЕД. ДЕЙСТВИЯ
МОДЕЛИРОВАНИЕ ОШИБОК
НЕРОБОТОТЕХНИЧЕСКОЕ ВИДЕО
ЭКСПЕРТ ПО ПОТОКАМ
ОТКРЫТЫЙ ИСХОДНЫЙ КОД
Isaac 0.5
35+ воплощений
1–3
π0.7
несколько роботов
≤6 / камера
π0.5
~7 роботов
Qwen-VLA
~10 роботов
LingBot-VLA
9 роботов
MolmoAct2
~5 воплощений
SmolVLA
1 воплощение
Octo
25 наборов данных
OpenVLA
970 тыс. траекторий
Мы выпускаем Isaac как полноценную систему: чекпоинты, код обучения и код вывода через LeRobot. Технический отчет содержит полные сведения об обучении и оценке.
Закон масштабирования для данных видео и действий роботов
Недавние работы установили, что как объем, так и разнообразие предварительного обучения необходимы для надежного управления. Physical Intelligence показала, что композиционное обобщение может возникать из разнообразных мультимодальных данных и условий. Generalist доказал, что мастерство в конкретных задачах может быть достигнуто путем масштабирования высокоточных данных физического взаимодействия. Dyna продемонстрировала, что масштабирование эгоцентрических данных является одним из жизнеспособных путей к управлению человеческого уровня.
Как видео (т.е. общее, эгоцентрическое), так и опыт роботов (т.е. UMI, телеуправление) необходимы, но оптимальное соотношение между ними не было хорошо изучено в открытом доступе, если вообще изучалось.
Поддерживая фиксированное соотношение 80:30:30 общего видео, эгоцентрического видео и UMI, мы масштабировали предварительное обучение Isaac и измеряли потери при прогнозировании действий на отложенных траекториях роботов. Полученный закон показывает, что мы можем обменять дешевые видеоданные на дорогостоящее телеуправление.
Добавление большего количества видео к предварительному обучению снижает потребность в телеуправлении. При одном часе телеуправления десятикратное увеличение объема видео снижает потери при действиях примерно на 0,006. После примерно 100 часов телеуправления такое же увеличение снижает потери примерно на 0,21.
Это взаимодействие дает результат 210×. Чтобы достичь потерь при действиях 2,50, модели, обученной на 1 000 часах видео, требуется около 5 900 часов телеуправления. Модели, обученной на одном миллионе часов видео, требуется 28.
AКонтуры фиксированных потерь2.252.502.75210× меньше телеуправленияпри потерях 2.5028 ч≈5,900 ч2101001к10к1к10к100к1МЧасы телеуправленияЧасы общего видео
BИзменение эмпирических потерь от 10-кратного увеличения видео1101001к10к−0.20−0.100.00Часы телеуправленияИзменение потерь на 10× видео−0.006 при 1 чпримерно −0.21 от 100 ч и далее
Телеуправление показано на горизонтальной оси, а общее видео — на вертикальной. Каждый контур соединяет смеси для обучения, которые достигают одинаковых потерь на отложенных действиях.
Общее видео охватывает множество объектов, действий и сред. Эгоцентрическое видео добавляет крупный план, релевантные для задачи виды рук, движения и контакта. UMI связывает визуальные знания с манипуляцией. Телеуправление связывает все эти знания с полным воплощением и пространством действий. Мы обучаемся на этих источниках вместе, поэтому все четыре формируют представление, которое Isaac использует для действий.
Закон масштабирования дает командам практический способ планирования сбора данных при фиксированном бюджете.
AСтоимость фиксированного состава$100k$10M$1M1101001k10k1k10k100k1M1571.57k15.7k157kЧасы телеуправленияЧасы общего видеоH100 ч · одна эпоха
BПотери против бюджета$1M · 2.24$100k$1M$10M1.92.12.32.52.72.9Моделируемый бюджетПотери на отложенных действиях
Помимо смесей данных, Isaac 0.5 дает представление о влиянии цели обучения на масштабирование.
Семантическое моделирование мира для робототехники
Модели роботов могут научиться предсказывать различные виды будущего, и цель предсказания определяет, что переносится на управление. Модели диффузии и реконструкции пикселей генерируют будущие кадры. Модели совместного встраивания предсказывают изученные визуальные признаки. Модели прямого действия предсказывают действия.
Isaac 0.5 добавляет семантическое моделирование мира в качестве цели совместного обучения, обучаясь на видео путем предсказания будущих перцептов. Перцепт — это релевантное для задачи состояние или изменение, видимое в наблюдении: состояние объекта, пространственное отношение, аффорданс, фаза задачи, видимое изменение контакта или вероятное состояние задачи в ближайшем будущем.
Перцепты находятся между пикселями и действиями. Обучение не контролирует перцепты напрямую. Оно контролирует их семантические описания, построенные автоматически на основе будущих наблюдений, включая общее видео, не содержащее аннотированных человеком меток действий.
Учитывая наблюдения до момента времени t, Isaac предсказывает перцепт в более поздний момент времени t + Δ:
L_percept = E[ℓ(gθ(o≤t), zt+Δ)]
Здесь o≤t — история наблюдений, а zt+Δ — будущий перцепт. Это тренирует тот же бэкенд, который Isaac использует для генерации действий.
Хотя цель является проприетарной, это не единственная цель, которую мы используем. Мы совместно обучаем восприятию видео, воплощенному визуальному рассуждению, семантическому предсказанию будущих перцептов и управлению роботом. Каждая цель обучения обновляет общий бэкенд. Дискретные (FAST) и непрерывные (Flow) декодеры остаются отдельными, но оба считывают данные из одного и того же общего представления.
Одна модель, несколько полезных интерфейсов
Isaac 0.5 объединяет изображения, видео, время, состояние робота и прошлые действия в единую последовательность, совместно моделируя все модальности. Объединение этого мультимодального интерфейса в одну модель требует решения 3 задач: (1) разрешение параллельных потоков в единый типизированный формат, (2) наличие стека мультимодальных данных с высокой пропускной способностью для наборов данных масштаба ПБ и (3) новые архитектуры, допускающие динамические вычисления, а также совместное восприятие и действие.
СЕМЕЙСТВО ИСТОЧНИКОВТИПИЗИРОВАННЫЙ КОМПИЛЯТОРУПАКОВКАОБЩИЙ БЭКЕНДИНТЕРФЕЙСmHarmonyБэкенд Isaac 0.5Общее видеокадры, время, текст сценыЭгоцентрическое + UMIруки, контакт, движениеТелеуправлениекамеры, состояние, действияЯзык + пространственные инструкции, точкипроверка схемыснижение воплощениявыравнивание по часамСобытия TensorStreamтекстзрениевремясостояниеFASTвизуальный энкодер30 × GDN10 × полное вниманиеMLP с маршрутизацией nullобщий эксперт + MTPВосприятиетекст, координатыВоплощенное рассуждениесостояние, прогрессДискретное управлениеТокены FASTЭксперт Flow36-блочный DiTНепрерывное управлениефрагменты действийкаждый источник сохраняетпроисхождение, время ивоплощениетипизированная модальность, время,состояние, координаты,действияРисунок 4. От гетерогенного опыта к одной модели. mHarmony проверяет и снижает схемы источников до типизированных событий TensorStream перед упаковкой.
Эффективное моделирование мультимодальных входных данных, включая изображения, видео и траектории управления, требует сериализации в согласованный интерфейс. Мы разработали и выпустили mHarmony — типизированный компилятор на основе OpenAI’s harmony, который расширяет возможности моделирования потоков мультимодальных событий. mHarmony гарантирует, что во всех наших конвейерах данных, предварительного обучения, вывода и обучения с подкреплением (RL) данные остаются в согласованном и оптимизированном формате. Для обучения моделей мы преобразуем структуры mHarmony в TensorStream — упакованный формат мультимодальных тензоров.
Масштабирование до более чем 1 млн часов видео выходит за рамки возможностей NFS в центрах обработки данных. Выполнение эпохи по нашим данным больше не является локально осуществимым и требует облачного потокового решения, однако пропускная способность сети, ограничения хранилища и ресурсоемкая обработка процессором могут препятствовать MFU. Наш стек данных для обучения строит прогнозный план с учетом топологии, гарантируя, что мы можем эффективно выдавать пакеты во время обучения, планируя наперед и обеспечивая гранулярный контроль смеси на уровне набора данных.
a Уровни процессаREMOTETRAINER1/RANKWORKERN/RANKDECODER1/WORKERсреззагрузка шардовпакет + метаданныебайтыкадрыобъектное хранилищеS3 / GCS шардыПотоки данныхсмешивание + преобразованиеобучающий пакетStatefulDataLoaderрабочий планgenerate_work()узловая когерентность, панель bкэш шардоврасписание + выборкаRust планировщикДокументпонижение + преобразованиепростой, сжатыйрендеринг→ TensorStreamтипизированные событиясборкапаковка + предварительное вычислениепанель cсупервизорфорки + перезагрузкикодек дочернийродной кодек b Узлово-когерентный планпереименование выклw04719w125838 шардов для этого узлаузлово-когерентныйw03388w183832 шардовc Упаковка последовательностиотрендеренные документынаилучшее соответствиезаполнениеодна упакованная последовательность, 16 384 токена
Текущее состояние моделей управления было основано на небольших плотных моделях из-за требований реального времени, что препятствовало масштабированию моделей как эффективному решению для управления. Смесь экспертов (Mixture of Experts) дает нам возможность масштабировать общее количество параметров, контролируя вывод через количество активных параметров. Isaac 0.5 построен на расширении Mixture of Experts под названием Null Experts — новой парадигме, где токен способен выбирать переменное количество экспертов, что дает нашей модели возможность увеличивать или уменьшать вычислительные мощности в зависимости от сложности задачи. Визуализируя карты вычислений, мы видим четкие паттерны значимости для наших архитектур.
Реальные маршруты остаются сосредоточенными на узнаваемой визуальной структуре
доля нулевых патчей0% · 8 реальных→100% · 0 реальных
null 62.7%2.98 реальных
null 72.0%2.24 реальных
null 42.0%4.64 реальных
null 64.6%2.83 реальных
null 34.8%5.22 реальных
null 68.2%2.55 реальных
null 67.9%2.57 реальных
null 56.7%3.46 реальных
null 72.8%2.17 реальных
null 46.6%4.27 реальных
null 45.8%4.33 реальных
null 30.7%5.55 реальных
null 44.7%4.42 реальных
null 24.3%6.06 реальных
null 67.9%2.57 реальных
null 61.0%3.12 реальных
Карты распределения вычислений, а не карты значимости · 16 из 142 кандидатных рендерингов, выбранных для локализованного контраста, а не для баланса задач или распространенности
Isaac 0.5 поддерживает как дискретное, так и непрерывное управление из одного и того же общего бэкенда. Дискретный путь использует FAST для сжатия траекторий действий в токены, позволяя модели предсказывать действия робота с помощью того же авторегрессионного механизма, который она использует для языка и привязки к реальности (grounding). Параллельно выделенный эксперт Flow генерирует непрерывные фрагменты действий путем итеративного преобразования шума в траекторию, обусловленную представлением сцены в бэкенде. Поддержка обоих вариантов дает модели два взаимодополняющих интерфейса действий: FAST предоставляет простое, унифицированное представление на основе токенов, которое естественным образом интегрируется с VLM, в то время как Flow сохраняет точность и мультимодальность непрерывного управления роботом. Важно отметить, что оба считывают данные из одного и того же бэкенда восприятия и рассуждения, поэтому то, что модель узнает из изображений, видео и воплощенного рассуждения, может напрямую формировать ее действия.
Оценка восприятия и управления
Мы оцениваем одни и те же чекпоинты Isaac на задачах понимания мультимодального видео и пространственной привязки, предсказания действий на отложенных траекториях и управления роботом в замкнутом контуре. Вместе эти оценки связывают то, что модель видит и предсказывает, с тем, как она ведет себя в задаче.
В задачах привязки и подсчета Isaac 0.5 достигает 62.6 на ScreenSpot-Pro, 32.8 на LVIS Count и 19.1 на CARPK, против 54.8, 28.7 и 6.0 для сильнейшего прогона Qwen3-VL, измеренного с помощью той же системы тестирования. По всем пяти семействам задач, которые мы оцениваем — физическое и временное рассуждение, пространственное и воплощенное рассуждение, структурированное визуальное понимание, общий визуальный интеллект, а также привязка и подсчет — ни один открытый аналог не сравнится с ним, и он лидирует в каждом из них при стоимости вывода в 8.5 раз ниже, чем у сильнейшего из них: 26.9 TFLOP для одного запроса из трех изображений против 228.4.
Общие веса проявляются в том, как быстро Isaac осваивает новую задачу. На физическом бенчмарке манипуляции шахматными фигурами мы дообучаем каждую политику в течение одной эпохи на одном экспертном эпизоде и тестируем на отложенном эпизоде: измененная поза фигуры, другой ход, заданный шахматной нотацией, или другая ветка той же дебютной линии. Isaac 0.5 фиксирует наибольшее снижение потерь на всех трех уровнях: 10.5x на фиксированном ходе, 9.5x при условии нотации и 7.0x на защитной линии, при этом π0.5 ближе всего к 3.1x, 2.6x и 2.3x. Индивидуальные маржи близки к стандартной ошибке от сида к сиду, поэтому результат, который следует учитывать, — это порядок, который сохраняется на каждом уровне. Это те же самые веса, которые дают оценки восприятия выше.
Aодна эпоха на одном эпизоде0.40.20.10.050.025потери отложенного действияSmolVLAGR00T N1.7MolmoAct2π0.5Isaac 0.5фиксированный ходшахматная нотациязащитная линиякаждая пара: zero-shot → после одной эпохи · логарифмическая шкала, одно деление = 2×прирост адаптации от одной демонстрации8×4×2×1×× меньшая ошибка3.1×10.5×2.6×9.5×2.3×7.0×фиксированный ходшахматная нотациязащитная линияIsaac оранжевым, базовые модели серым · чем выше, тем лучшеCгде во фрагменте происходит прирост (нотация)не оцененосредний предсказатель действий100140047007100010120012мсH0.10.20.30.40.5потери отложенного действияzero-shotпосле одной эпохиSmolVLA50GR00T N1.716MolmoAct2н/дπ0.5н/дIsaac 0.550смещение предсказания (ряд действий, сетка 10 Гц) · оценено по Heval = 10, задержка RTC обучена до D = 12
Создание Isaac в открытом доступе
Мы рассматриваем модели с открытым исходным кодом как важнейшие драйверы прогресса в робототехнике. Именно поэтому мы продолжаем открывать исходный код наших работ.
Isaac 0.5 доступен сегодня как отправная точка для воплощенных систем. Вы можете дообучить его на своих собственных демонстрациях, использовать его визуальные выходы внутри более крупной системы и запустить его самостоятельно через LeRobot.
Если вы хотите узнать больше о развертывании Isaac на вашей инфраструктуре, пожалуйста, свяжитесь с support@perceptron.inc.