В наших экспериментах масштабирование общего видео с 1000 до одного миллиона часов позволило сократить необходимое время телеуправления для достижения хорошо откалиброванной потери действий на удерживаемом сегменте с примерно 5900 часов до 28.
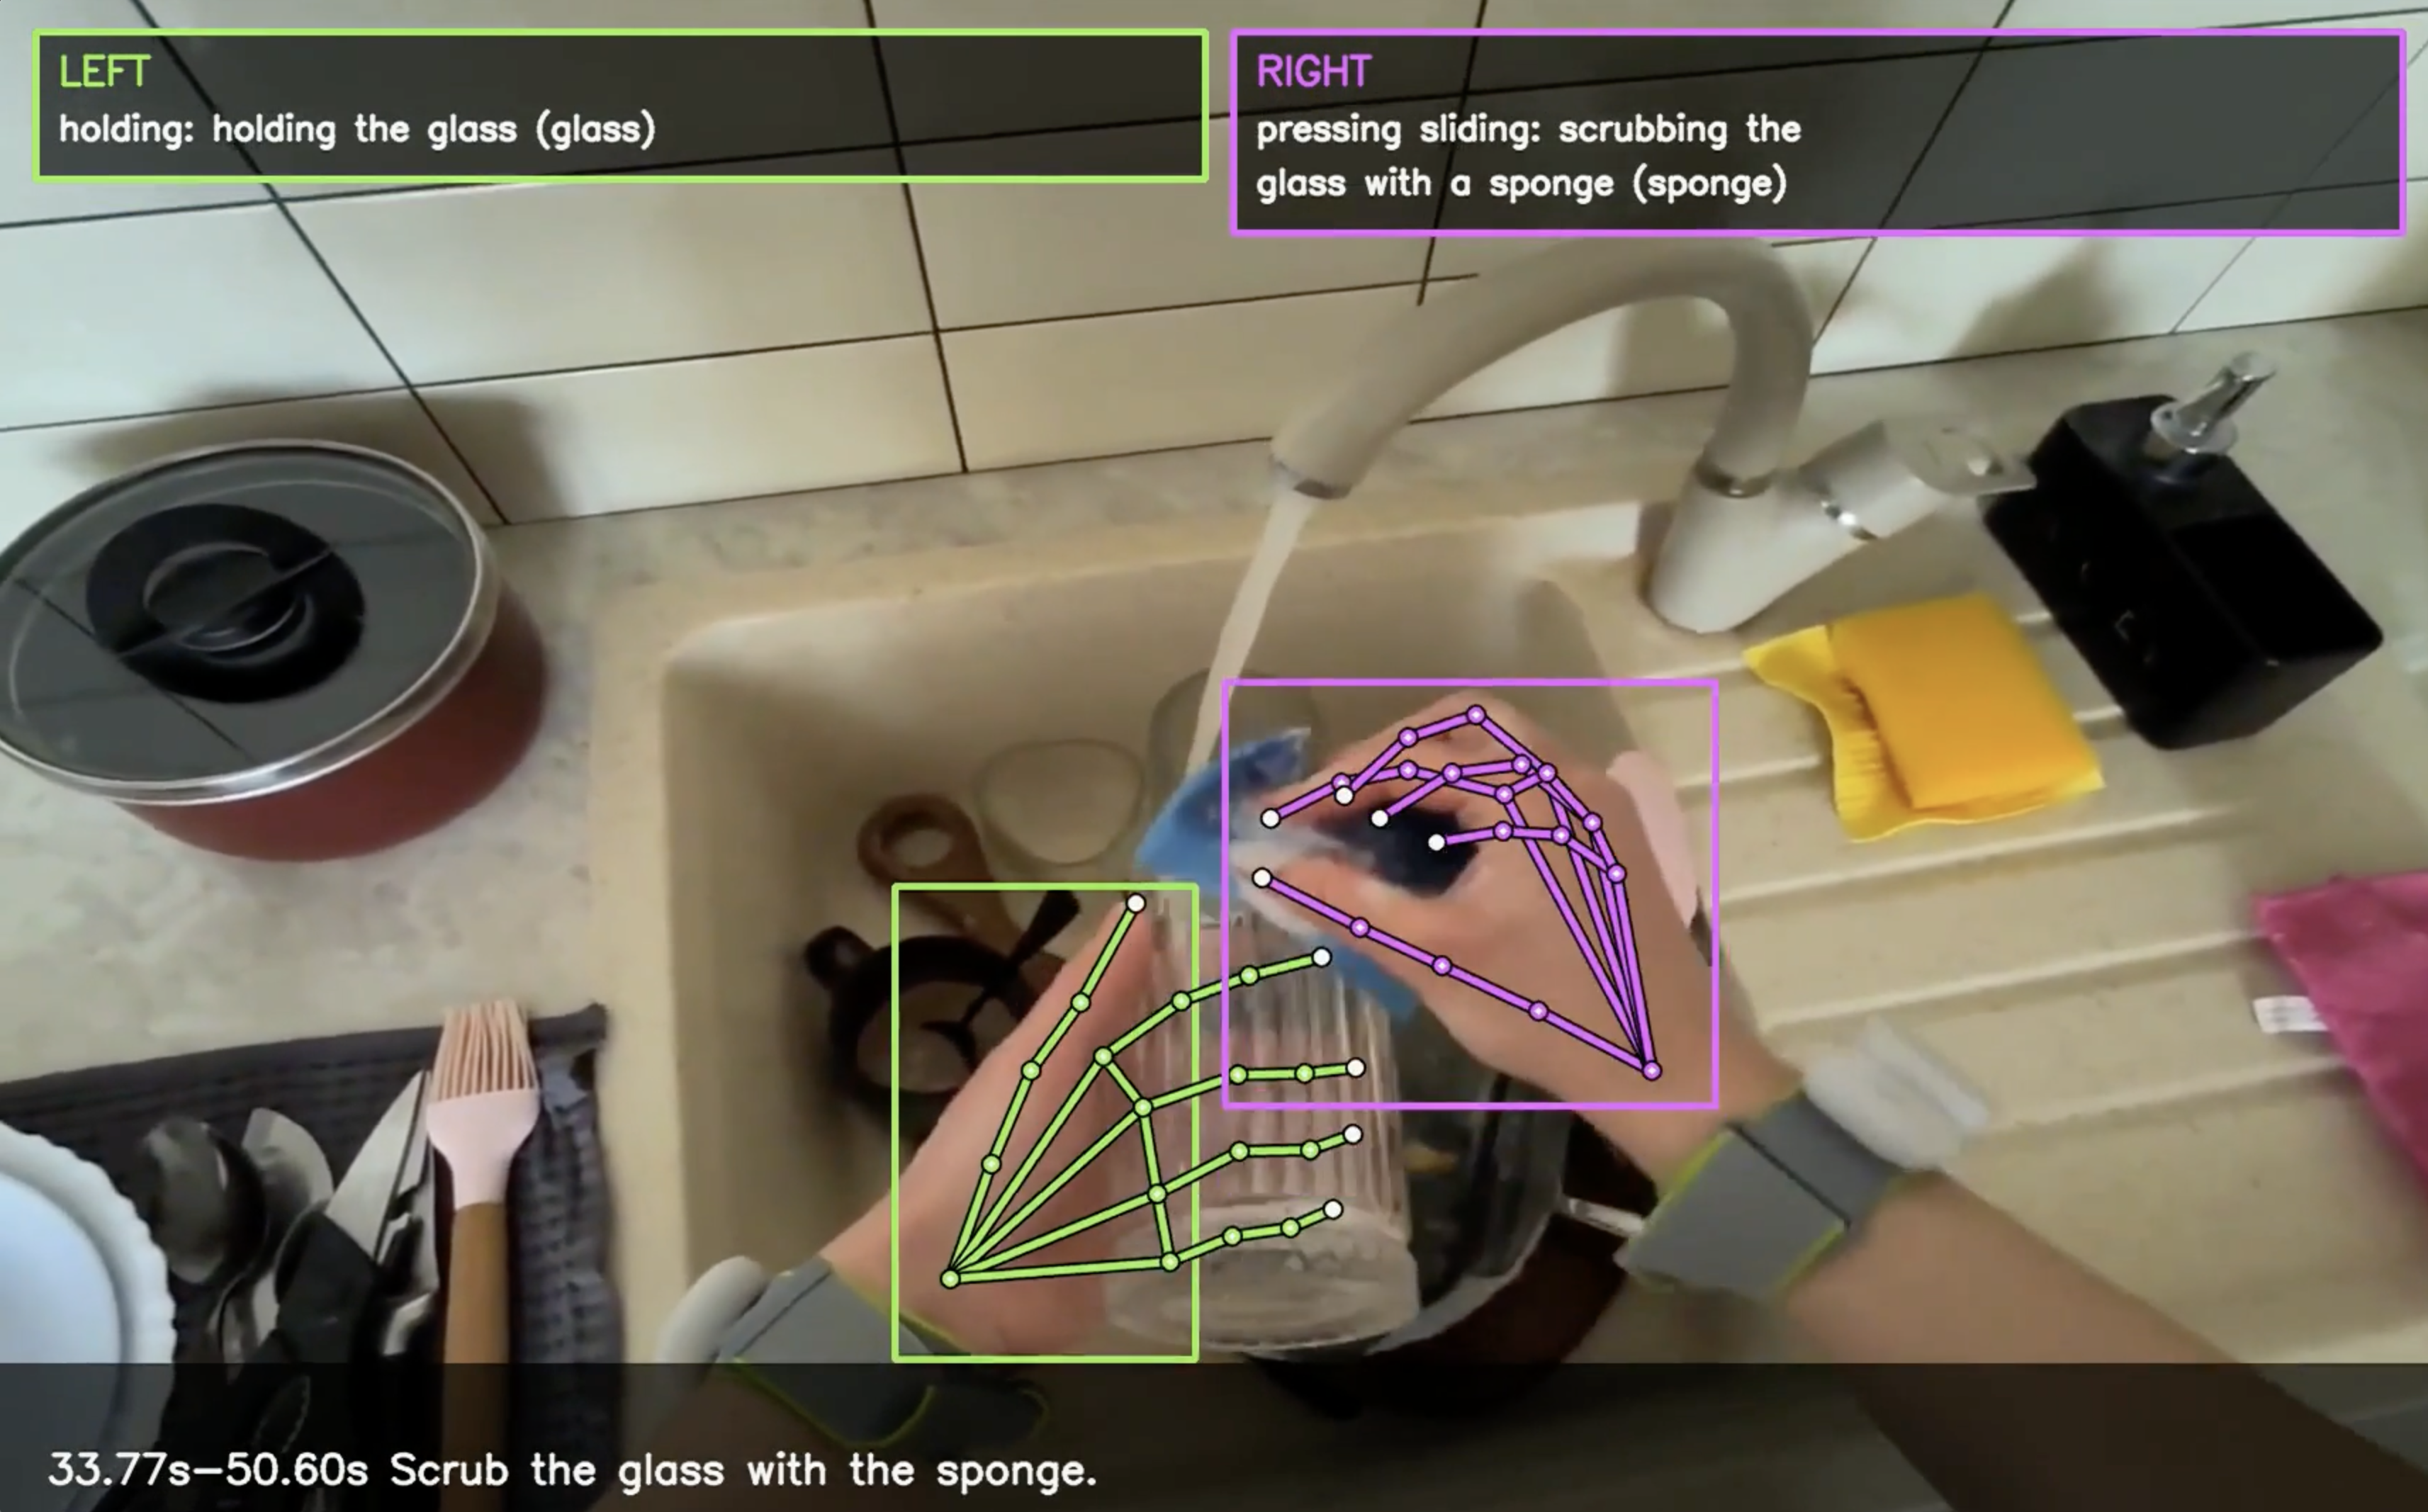
Isaac — это разреженная модель с 36 миллиардами параметров. Она обрабатывает изображения, видео, языковые инструкции, состояние робота и предыдущие действия. Она может отвечать на вопросы о видео, указывать на объекты и их части, отслеживать их во времени, сообщать о ходе выполнения задачи и генерировать действия робота. Команды могут дообучать её в качестве политики или использовать её визуальные выходы внутри планировщика, контроллера или движка данных.
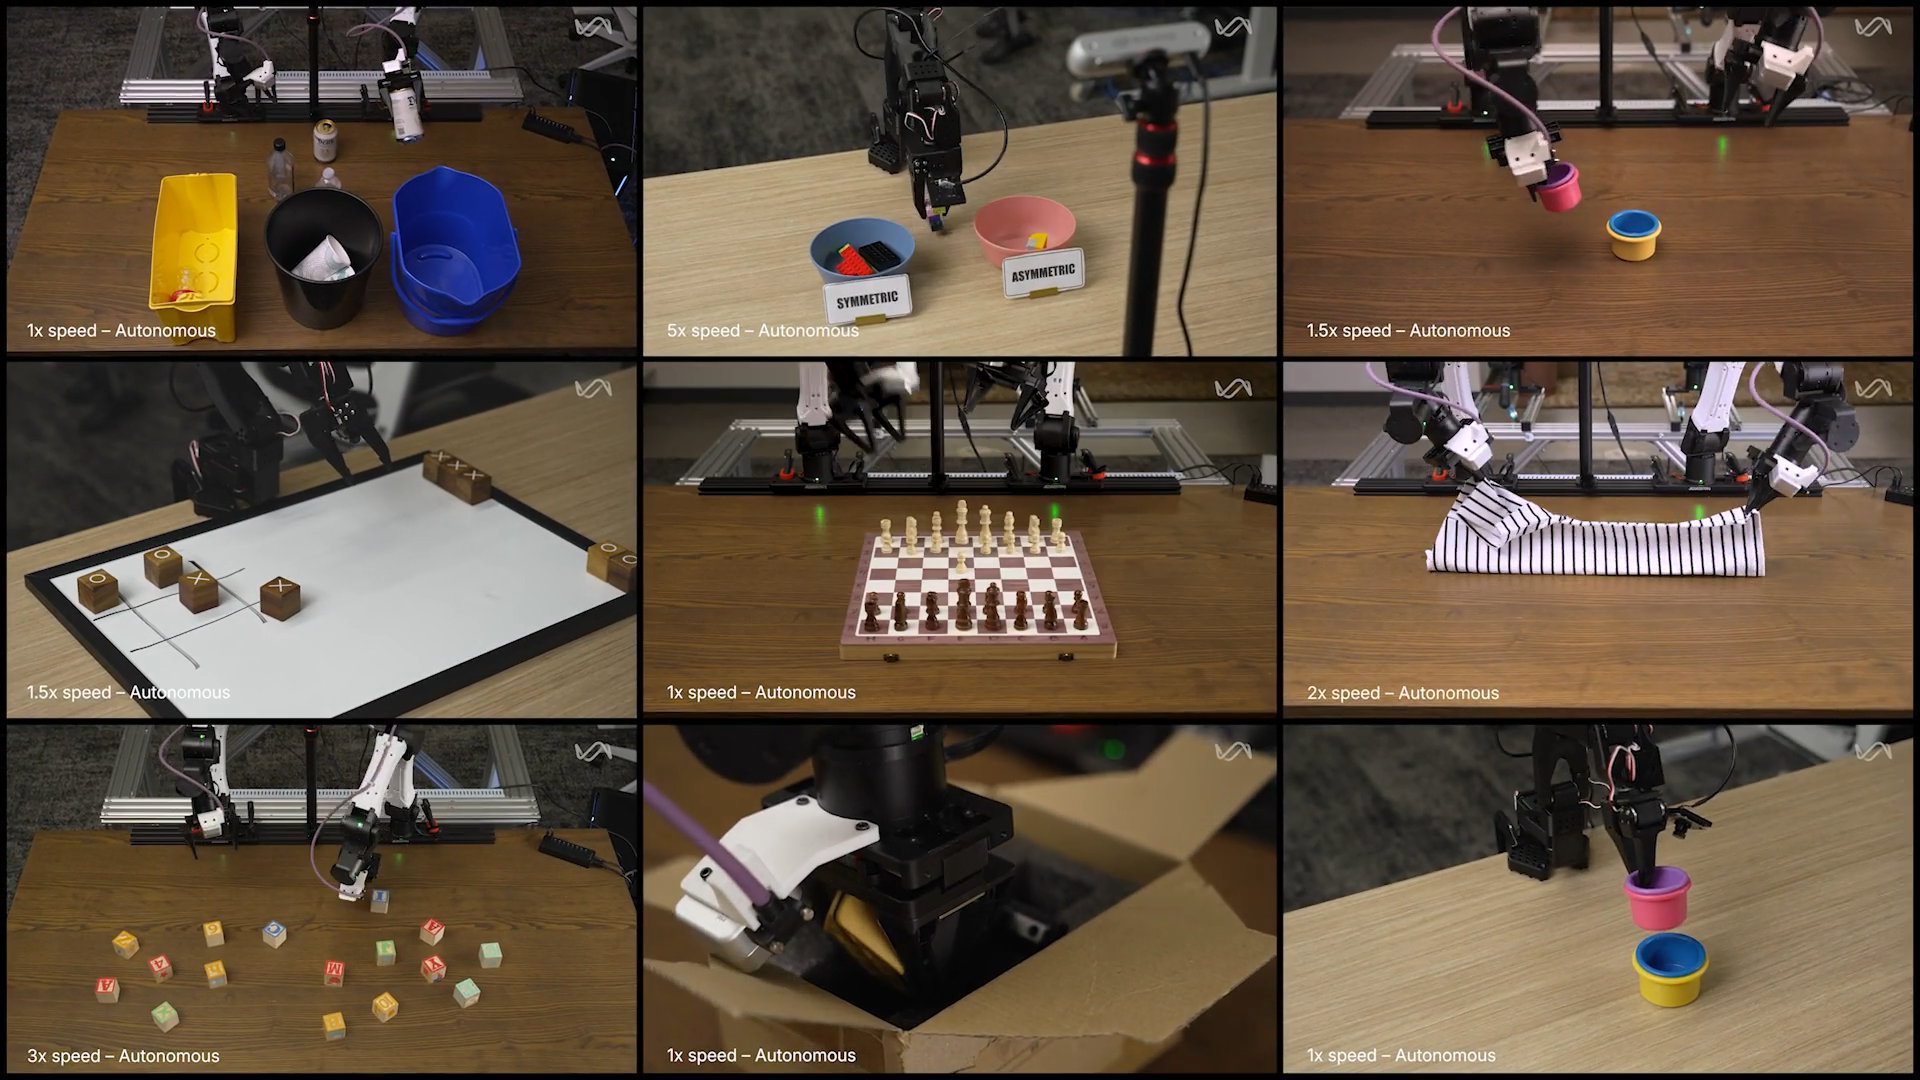
Мы обучили Isaac на данных более чем 35 роботизированных систем, 100 000 часов опыта робота, 1 млн часов общего видео и 3 трлн мультимодальных токенов. Мы одновременно обучали понимание видео, пространственное позиционирование, отслеживание хода выполнения задачи и действия робота с самого начала.
Сравнение рецептов управления
МОДЕЛЬ
ОБЛАСТЬ ОБУЧЕНИЯ РОБОТА
ОБС. ШАГИ
ОБУЧЕННАЯ RTC
ПРЕДЫДУЩИЕ ДЕЙСТВИЯ
МОДЕЛИРОВАНИЕ ОШИБОК
НЕРОБОТОВОЕ ВИДЕО
ЭКСПЕРТ ПО ТЕЧЕНИЮ
ОТКРЫТЫЙ ИСХОДНЫЙ КОД
Isaac 0.5
35+ воплощений
1–3
π0.7
несколько роботов
≤6 / камера
π0.5
~7 роботов
Qwen-VLA
~10 роботов
LingBot-VLA
9 роботов
MolmoAct2
~5 воплощений
SmolVLA
1 воплощение
Octo
25 наборов данных
OpenVLA
970k траекторий
Мы выпускаем Isaac в качестве полной системы: контрольные точки, код обучения и код инференса через LeRobot. Технический отчёт содержит полную информацию об обучении и оценке.
Закон масштабирования для видео- и роботизированных данных
Недавние исследования показали, что как объём, так и разнообразие предобучения имеют важное значение для надёжного управления. Physical Intelligence продемонстрировал, что композитная обобщённость может возникать из разнообразных мультимодальных данных и условий. Generaliste доказал, что мастерство выполнения конкретных задач может быть достигнуто за счёт масштабирования высококачественных данных физического взаимодействия. Dyna продемонстрировал, что масштабирование эгоцентричных данных является одним из возможных путей к управлению на уровне человека.
Как видео (т. е. общее, эгоцентричное), так и опыт робота (т. е. UMI, телеуправление) необходимы, но оптимальное соотношение между ними не было хорошо изучено в открытом исходном коде, если вообще было изучено.
Сохраняя фиксированное соотношение 80:30:30 общего видео:эгоцентричного:UMI, мы масштабировали предобучение Isaac и измерили потерю предсказания действий на удерживаемых траекториях робота. Полученный закон показывает, что мы можем обменять дешёвые видео-данные на дорогие телеуправляемые данные.
Добавление большего количества видео к предобучению снижает потребность в телеуправлении. С одним часом телеуправления увеличение видео в десять раз снижает потерю действий примерно на 0,006. После примерно 100 часов телеуправления то же увеличение снижает потерю примерно на 0,21.
Это взаимодействие дает результат в 210 раз. Для достижения потери действий 2,50 модели, обученной на 1000 часов видео, требуется около 5900 часов телеуправления. Модель, обученная на один миллион часов видео, требует 28 часов.
AFixed-loss contours2.252.502.75210× меньше телеуправленияпри потере 2.5028 h≈5,900 h2101001k10k1k10k100k1MЧасы телеуправленияЧасы общего видео
BEmpirical loss change from 10× more video1101001k10k−0.20−0.100.00Часы телеуправленияИзменение потери на каждые 10× видео−0.006 при 1 hпримерно −0.21 после 100 h
Телеуправление показано на горизонтальной оси, а общее видео — на вертикальной оси. Каждая контурная линия соединяет смеси обучения, которые достигают одинаковой потери действий на удерживаемом сегменте.
Общее видео охватывает множество объектов, действий и сред. Эгоцентричное видео добавляет близкие, относящиеся к задаче виды рук, движений и контактов. UMI связывает визуальные знания с манипуляцией. Телеуправление связывает все эти знания с полным воплощением и пространством действий. Мы обучаемся на этих источниках вместе, поэтому все четыре компонента формируют представление, которое Isaac использует для действий.
Закон масштабирования дает командам практический способ планировать сбор данных при фиксированном бюджете.
ACost of a fixed composition$100k$10M$1M1101001k10k1k10k100k1M1571.57k15.7k157kЧасы телеуправленияЧасы общего видеоH100 h · одна эпоха
BLoss versus budget$1M · 2.24$100k$1M$10M1.92.12.32.52.72.9Моделируемый бюджетПотеря действий на удерживаемом сегменте
Помимо смесей данных, Isaac 0.5 предлагает понимание влияния цели обучения на масштабирование.
Семантическое моделирование мира для робототехники
Роботизированные модели могут научиться предсказывать различные виды будущего, и целевая задача предсказания определяет, что передается в управление. Модели диффузии и пиксельной реконструкции генерируют будущие кадры. Модели совместного встраивания предсказывают изученные визуальные признаки. Модели прямых действий предсказывают действия.
Isaac 0.5 добавляет семантическое моделирование мира в качестве совместной цели обучения, обучаясь на видео путем предсказания будущих перцептов. Перцепт — это относящееся к задаче состояние или изменение, видимое в наблюдении: состояние объекта, пространственное отношение, аффорданс, фаза задачи, видимое изменение контакта или вероятное ближайшее состояние задачи.
Перцепты находятся между пикселями и действиями. Обучение не контролирует перцепты напрямую. Оно контролирует семантические описания их, построенные автоматически из будущих наблюдений, включая общее видео, не содержащее аннотированных человеком меток действий.
Учитывая наблюдения до времени t, Isaac предсказывает перцепт в более поздний момент времени t + Δ:
L_percept = E[ℓ(gθ(o≤t), zt+Δ)]
Здесь o≤t — это история наблюдений, а zt+Δ — будущий перцепт. Это обучает ту же основную архитектуру, которую Isaac использует для генерации действий.
Хотя цель является собственнической, это не единственная цель, которую мы используем. Мы одновременно обучаем видео-перцепцию, воплощённое визуальное рассуждение, семантическое предсказание будущего перцепта и управление роботом. Каждая цель обучения обновляет общую основную архитектуру. Дискретные (FAST) и непрерывные (Flow) декодеры остаются отдельными, но оба считывают данные из одного общего представления.
Одна модель, несколько полезных интерфейсов
Isaac 0.5 объединяет изображения, видео, время, состояние робота и предыдущие действия в одну последовательность, совместно моделируя все модальности. Объединение этого мультимодального интерфейса в одну модель требует решения трёх задач: (1) преобразование параллельных потоков в единый типизированный формат; (2) при наличии наборов данных масштаба PB — высокопроизводительная мультимодальная стопка данных; (3) новые архитектуры, которые позволяют динамическое вычисление и совместное перцептивное и акционное моделирование.
ИСТОЧНИКОВЫЕ СЕМЕЙСТВАТИПИЗИРОВАНИЕ КОМПИЛЯТОРАПАКЕТЫОБЩАЯ ОСНОВНАЯ АРХИТЕКТУРАИНТЕРФЕЙСЫmHarmonyIsaac 0.5 основная архитектураОбщее видеокадры, время, текст сценыЭгоцентричное + UMIруки, контакт, движениеТелеуправлениекамеры, состояние, действияЯзык + пространственныениструкции, точкипроверка схемыпонижение воплощениявыравнивание часовСобытия TensorStreamтекствидеовремя состояниеFASTвидео-кодировщик30 × GDN10 × полное вниманиенулевые маршрутизированные MLPобщий эксперт + MTPPerceptionтекст, координатыВоплощённое рассуждениесостояние, прогрессДискретное управлениеFAST-токеныFlow эксперт36-блочный DiTНепрерывное управлениекуски действийкаждый источник сохраняетпроисхождение, время ивоплощениетипизированная модальность, время,состояние, координаты,действияРисунок 4. Из гетерогенного опыта к одной модели. mHarmony валидирует и понижает исходные схемы до типизированных событий TensorStream перед упаковкой.
Эффективное моделирование мультимодальных входных данных, включая изображения, видео и траектории управления, требует сериализации в единый интерфейс. Мы разрабатываем и выпускаем mHarmony — типизированный компилятор на основе OpenAI’s harmony, который расширяется для моделирования потоков мультимодальных событий. mHarmony гарантирует, что во всех наших данных, конвейерах предобучения, инференса и обучения с подкреплением данные остаются в согласованном и оптимизированном формате. Для обучения модели мы преобразуем структуры mHarmony в TensorStream — упакованный мультимодальный тензорный формат.
Масштабирование до 1 млн+ часов видео выходит за пределы возможностей NFS в дата-центрах. Проход эпохи по нашим данным больше неосуществим локально и требует облачного стримингового решения, однако пропускная способность сети, ограничения хранилища и ресурсоемкая обработка на CPU могут снизить MFU. Наш стек обучающих данных строит топологически осведомленный предиктивный план, обеспечивающий эффективную выдачу батчей при обучении с заранее планированием и предоставляющий детальный контроль смеси на уровне датасетов.
a Уровни процессов REMOTETRAINER1/RANKWORKERN/RANKDECODER1/WORKER срез шард скачивание батч + метаданные байты кадры объектное хранилище S3 / GCS шарды DataStreams микширование + трансформации обучающий батч StatefulDataLoader план работы generate_work() node-coherent, панель b шард кэш расписание + выборка Rust планировщик Документ понижение + трансформация простаи сжаты рендер → TensorStream типизированные события коллация упаковка + предвычисление панель c супервизор форки + перезапуски кодек дочерний нативный код cb Node-coherent план перемаркировка выкл w04719 w125838 шардов для этого узла node-coherent w03388 w183832 шардов c Упаковка последовательности отрендеренные документы best-fit pad одна упакованная последовательность, 16 384 токена
Текущее состояние моделей управления построено на более мелких плотных моделях из-за требований реального времени, что препятствует масштабированию модели как эффективному решению для управления. Смесь экспертов (Mixture of Experts) дает нам измерение для масштабирования общего количества параметров, контролируя инференс через количество активных параметров. Isaac 0.5 построен на расширении Mixture of Experts, называемом Null Experts — новой парадигме, где токен способен выбирать переменное число экспертов, что дает нашей модели возможность масштабировать вычисления вверх и вниз в зависимости от сложности задачи. Визуализируя карты вычислений, мы видим яркие паттерны салиентности для наших архитектур.
Реальные маршруты остаются сконцентрированными на узнаваемой визуальной структуре
патч null fraction 0% · 8 реальных → 100% · 0 реальных
null 62.7% 2.98 реальных
null 72.0% 2.24 реальных
null 42.0% 4.64 реальных
null 64.6% 2.83 реальных
null 34.8% 5.22 реальных
null 68.2% 2.55 реальных
null 67.9% 2.57 реальных
null 56.7% 3.46 реальных
null 72.8% 2.17 реальных
null 46.6% 4.27 реальных
null 45.8% 4.33 реальных
null 30.7% 5.55 реальных
null 44.7% 4.42 реальных
null 24.3% 6.06 реальных
null 67.9% 2.57 реальных
null 61.0% 3.12 реальных
Карты распределения вычислений, а не карты салиентности · 16 из 142 кандидатов рендеринга, выбранных для локального контраста, а не баланса задач или преобладания
Isaac 0.5 поддерживает как дискретное, так и непрерывное управление от одного общего бэкбона. Дискретный путь использует FAST для сжатия траекторий действий в токены, позволяя модели предсказывать действия робота с тем же авторегрессионным механизмом, который она использует для языка и заземления. Параллельно выделенный эксперт Flow генерирует непрерывные фрагменты действий, итеративно преобразуя шум в траекторию, обусловленную представлением сцены бэкбоном. Поддержка обоих дает модели два дополнительных интерфейса действий: FAST предоставляет простое, унифицированное токенное представление, которое естественно интегрируется с VLM, в то время как Flow сохраняет точность и мультимодальность непрерывного управления роботом. Важно, что оба считывают из одного и того же бэкбона восприятия и рассуждений, поэтому то, чему модель учится на изображениях, видео и телесном рассуждении, может напрямую формировать её действия.
Оценка по восприятию и управлению
Мы оцениваем одни и те же чекпоинты Isaac на понимании мультимодального видео и пространственном заземлении, предсказании действий на заведомо исключенных траекториях и замкнутом цикле управления роботом. Вместе эти оценки связывают то, что модель видит и предсказывает, с тем, как она ведет себя в задаче.
В заземлении и подсчете Isaac 0.5 достигает 62.6 на ScreenSpot-Pro, 32.8 на LVIS Count и 19.1 на CARPK, против 54.8, 28.7 и 6.0 для самого сильного запуска Qwen3-VL, измеренного в том же тестовом наборе. Во всех пяти семействах задач, которые мы оцениваем — физическое и временное рассуждение, пространственное и телесное рассуждение, структурное визуальное понимание, общее визуальное интеллектуальное понимание, и заземление и подсчет — никакой открытый компаратор не сравнивается с ним, и он опережает каждый при в 8.5 раза более низкой стоимости инференса, чем самый сильный из них: 26.9 TFLOP на один запрос из трех изображений против 228.4.
Общие веса проявляются в том, как быстро Isaac осваивает новую задачу. На бенчмарке физической манипуляции шахматами мы дообучаем каждую политику за одну эпоху на одном экспертном эпизоде и тестируем на заведомо исключенном эпизоде: позе фигуры с возмущением, другом ходе, заданном в шахматной нотации, или другой ветке той же дебютной линии. Isaac 0.5 показывает наибольшее снижение потерь на всех трех уровнях: 10.5x на фиксированном ходе, 9.5x при условии нотации и 7.0x на оборонительной линии, при этом π0.5 ближе всего с 3.1x, 2.6x и 2.3x. Индивидуальные отступы близки к стандартной ошибке от сида к сиду, поэтому результат, который нужно читать — это порядок, который сохраняется на каждом уровне. Это те же веса, которые дают оценки восприятия выше.
A одна эпоха на одном эпизоде 0.4 0.2 0.1 0.05 0.025 потери действий на заведомо исключенных SmolVLA GR00T N1.7 MolmoAct2 π0.5 Isaac 0.5 фиксированный ход нотация оборонительная линия каждая пара: zero-shot → после одной эпохи · лог шкала, одна отметка = 2× B прирост адаптации от одной демонстрации 8× 4× 2× 1× × ниже ошибка 3.1× 10.5× 2.6× 9.5× 2.3× 7.0× фиксированный ход нотация оборонительная линия Isaac оранжевым, базовые серым · выше лучше C где в чанке попадает прирост (нотация) не оценено предиктор среднего действия 100 1400 4700 71000 101200 12 ms H 0.1 0.2 0.3 0.4 0.5 потери действий на заведомо исключенных zero-shot после одной эпохи SmolVLA 50 GR00T N1.7 16 MolmoAct2 n/d π0.5 n/d Isaac 0.5 50 смещение предсказания (строка действия, сетка 10 Гц) · оценено по Heval = 10, задержка RTC обучена до D = 12
Работа с Isaac в открытом доступе
Мы видим модели с открытым исходным кодом как ключевые драйверы прогресса в робототехнике. Именно поэтому мы продолжаем открывать исходный код нашей работы.
Isaac 0.5 доступен сегодня как отправная точка для телесных систем. Вы можете дообучить его на своих демонстрациях, использовать его визуальные выходы внутри более крупной системы и запустить его самостоятельно через LeRobot.
Если вы хотите узнать больше о развертывании Isaac на вашей инфраструктуре, пожалуйста, обратитесь в поддержку по адресу support@perceptron.inc.