Если бы вам приходилось каждое утро в течение шести месяцев провожать нового коллегу до принтера, вы бы начали беспокоиться. Если бы он мог безупречно воспроизвести в памяти каждую предыдущую прогулку, но все равно нуждался в сопровождении, его способность к припоминанию была бы отличной… но вам все равно пришлось бы вставать со своего рабочего места.
Память ИИ-агентов в настоящее время имеет свою версию такой бесконечной ходьбы к принтеру. Генеральный директор Letta Чарльз Пакер говорит в The New Stack, что бенчмарки памяти исчерпали себя, поскольку они измеряют способность к припоминанию, которую он считает решенной задачей. Открытой проблемой остается то, как агент улучшает свою работу за счет сохраняемого им контекста без какого-либо дообучения.
Его соосновательница Сара Вудерс сравнивает это с началом работы: бенчмарки предоставляют агенту весь необходимый контекст для задачи за задачей, не связанной с предыдущими, что совершенно не похоже на то, как работают люди. Новому сотруднику может потребоваться сопровождение до принтера. Но спустя три года вы надеетесь вручить ему однострочное техническое задание, не вставая с рабочего места.
Именно к такому стандарту мы стремимся, и эта цель лежит в основе Brain — нашей системы самосовершенствующейся памяти для Perplexity Computer, которая организует прошлые задачи и исправления в развивающуюся базу знаний (вики).
Мы рассмотрим, что именно должен запоминать агент и как проверить, помогает ли это ему выполнять работу лучше.
Что такое память ИИ-агента?
Память ИИ-агента — это информация, которую агент сохраняет от предыдущих взаимодействий и работы, а также механизмы ее обновления и использования. Постоянный контекст памяти переносит эту информацию между сессиями, поэтому закрытие диалога не означает, что следующую задачу придется начинать с нуля.
Большинство решений, выпускаемых под этим названием, запоминают пользователя. Ваши предпочтения, ваши контакты, вашу роль, тот факт, что вам нужны файлы PDF, а не PNG. Это легкая половина задачи.
Когда мы создали Brain — систему памяти, лежащую в основе Perplexity Computer, мы сосредоточились на самой работе. Какой подход оказался успешным? Какой источник потратил впустую двадцать минут? Что вам пришлось исправлять после того, как агент объявил о завершении работы? Эта история дает следующей задаче лучшую отправную точку.
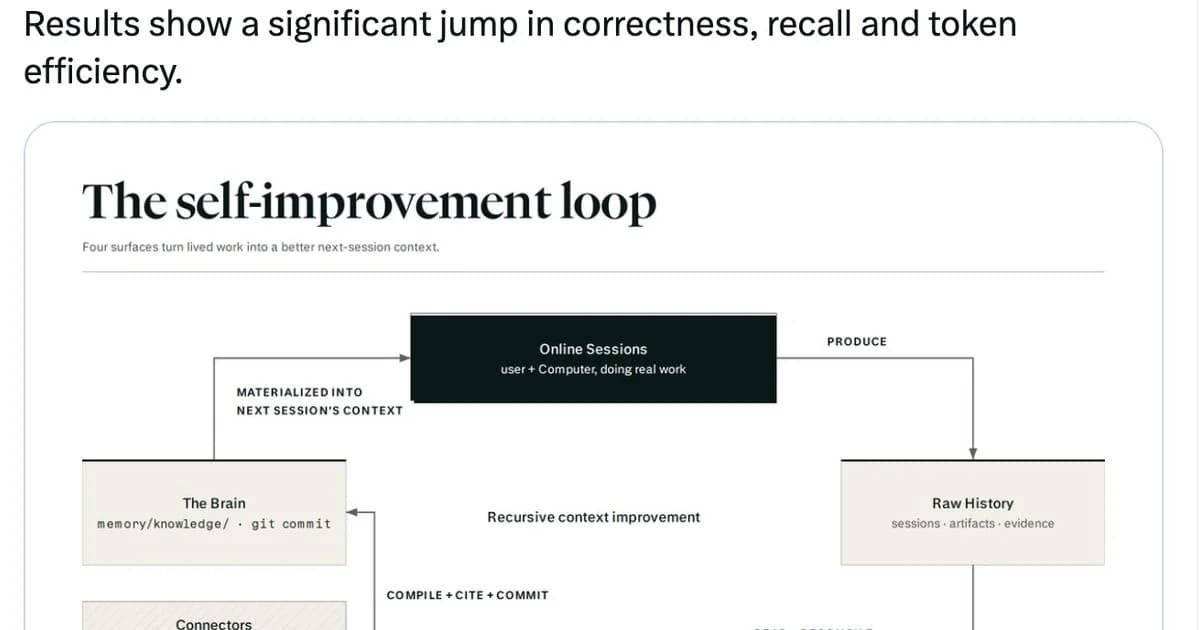
Brain сохраняет эту информацию в виде файлов в изолированной среде (песочнице) агента, организованных в три уровня:
- sessions/ содержит сырые стенограммы и их краткие содержания.
- notes/ содержит извлеченную информацию, организованную по темам.
- knowledge/ содержит саму вики; связанные страницы Markdown о людях, проектах и концепциях.
Ничто из этого не улучшается само по себе. По ночам фоновые агенты, которых мы называем «Dream» («Сон»), читают сессии прошедшего дня, суммируют их и перерабатывают вики везде, где картина изменилась. Мы подготавливаем и проверяем эти изменения перед тем, как зафиксировать их через Git, поэтому всегда есть diff (разница) для проверки, если что-то выглядит подозрительно.
Делает ли это агента лучше в работе? В нашей 30-дневной парной оценке сессии с поддержкой Brain улучшили показатель правильности на 9,3 процентных пункта, а припоминание — на 8,9, при этом расходуя примерно на 15% меньше токенов.
Каковы типы памяти агентов?
Существует два основных вида, и это разделение очень похоже на то, что вы применяете к человеку: то, что вы держите в голове прямо сейчас, и то, что вы все равно будете знать в следующем месяце.
Краткосрочная память
Краткосрочная память хранит контекст для текущего диалога или задачи. Ваш запрос, недавние сообщения, результат вызова инструмента, документ, который агент только что открыл. Достаточно информации, чтобы понять, что делать дальше.
Вы также можете встретить название «рабочая память». Для LLM контекстное окно хранит информацию, доступную во время конкретного вызова модели. Приложение может поддерживать дополнительное состояние задачи и решать, какие его части предоставлять на каждом шаге.
И краткосрочная не обязательно означает одноразовая. Фреймворк может сохранить состояние диалога и возобновить его завтра — оно все равно принадлежит этой ветке (тред). Но может ли другая задача использовать эту информацию — это отдельное проектное решение.
Долгосрочная память
Долгосрочная память делает информацию доступной в разных сессиях. В статье CoALA заимствованы три категории из когнитивных наук, что дало разработчикам агентов словарь для описания опыта и ноу-хау:
- Эпизодическая память — это то, что произошло: она включает в себя прошлые сессии, шаги, которые предпринял агент, и полученный им результат. В Brain папка sessions/ предоставляет эту историю через сырые стенограммы и их краткие содержания.
- Семантическая память — это то, что агент принимает за чистую правду: это могут быть факты о пользователе, его проектах и его мире, извлеченные из диалогов. Вики-папка knowledge/ в Brain хранит информацию такого рода со ссылками на доказательства.
- Процедурная память — это то, как делать вещи: это промпты, повторно используемые рабочие процессы, навыки (Skills), которые Perplexity создает, чтобы дать агентам инструкции и инструменты, необходимые для работы. Возможно, что-то из этого у вас уже есть, даже если вы не называете это памятью.
Самая интересная работа происходит между уровнями. Сессия фиксирует, что вы отклонили PNG. Ваша инструкция использовать PDF превращается в предпочтение, которое агент может перенести в будущее. Исправление процесса экспорта становится тем, чему он сможет следовать в следующий раз.
Это преобразование из «это произошло» в «это правда» и далее в «вот как мы это делаем» является частью проблемы обучения, с которой мы начали, и именно на это тратят свои усилия ночные агенты Dream в системе Brain.
Допустим, кто-то разогревает рыбу в микроволновке на общей кухне. Раздаются жалобы, открывается окно. В конце концов появляется вывеска: НИКАКОЙ РЫБЫ.
Шесть месяцев спустя нарушитель съехал, но вывеска осталась. Это постоянство (персистентность). Вы можете объяснить типы памяти через то, что переживает время:
- Рабочая память — это то, за чем вы следите, пока готовите обед, например, что суп нужно помешивать.
- Эпизодическая память — это инцидент с рыбой; запах, который последовал за всеми в коридор.
- Семантическая память — это знание, которое вы из этого вынесли: разогревание рыбы может оставлять затяжной запах на общей кухне.
- Процедурная память — это инструкция, определяющая, что делать дальше. Не разогревайте здесь рыбу. Вывеска позволяет следовать правилу человеку, который пропустил весь инцидент целиком.
Существует также еще одно различие, поскольку оно меняет то, что мы строим. В исследовании, впервые опубликованном в декабре 2025 года, «Память в эпоху ИИ-агентов», говорится, что деления на кратковременную и долговременную недостаточно — память также классифицируется по форме:
- На уровне токенов: это явный контент, который читает агент. Файлы, сохраненные записи, извлеченные фрагменты.
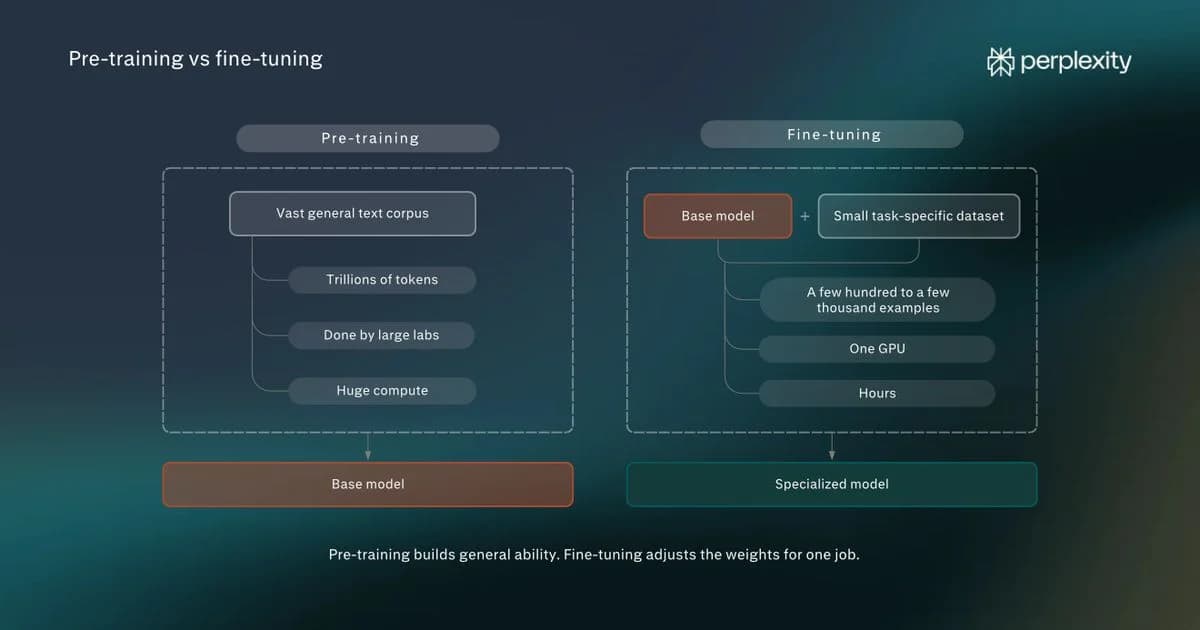
- Параметрическая: это информация, закодированная в выученных весах. Ее обновление требует обучения или методов редактирования моделей.
- Латентная: это информация, сохраняемая во внутренних представлениях без записи в виде удобочитаемого текста.
Здесь мы сосредоточены на памяти на уровне токенов; то есть на информации, хранящейся вне модели и считываемой в ее контекст при необходимости. Вики на Markdown в Brain — один из примеров.
Когда мы обновляем страницу, мы меняем то, что агент может прочитать при выполнении своей следующей задачи, но его базовые веса остаются прежними. В этом и заключается суть мысли Пакера из введения: улучшаться за счет сохраняемого агентом контекста без дообучения.
Как типы памяти агента работают вместе?
Агент может вернуться к более ранней попытке, увидеть, где он ошибся, и загрузить данные вам инструкции после этого. В одной и той же задействовано несколько видов памяти, и им не обязательно по очереди занимать очередь или использовать отдельную базу данных.
Здесь персистентность определяет, что остается доступным после завершения разговора, а извлечение определяет, увидит ли агент это снова.
Тип памяти
Что сохраняется между сеансами?
Что она хранит?
Как Brain / Computer переносит это в контекст?
Рабочая
Сохраненное состояние задачи может быть восстановлено, но модель видит только то, что приложение предоставляет для каждого вызова.
Текущий промпт, недавние шаги, результаты инструментов и извлеченная информация.
Индекс помогает агенту обнаружить доступную память; чтение файлов добавляет релевантный контент.
Эпизодическая
Сохраненные записи сеансов и сводки.
Что произошло: предыдущие попытки, действия, результаты и исправления.
Агент следует за цитатами для подтверждения фактов сеанса, когда ему нужны детали.
Семантическая
Поддерживаемые знания с историей версий, если она записывается.
Факты о людях, проектах, предпочтениях и связях между ними.
Агент читает страницы knowledge/, ищет файлы и следует по [[wikilinks]].
Процедурная
Сохраненные инструкции, навыки и рабочие процессы до их изменения или удаления.
Как выполнять задачу.
Computer загружает релевантные навыки и инструкции при необходимости.
В Brain мы сохраняем этот маршрут от урока к доказательству. Предположим, вы просите Computer продолжить проект с прошлой недели:
- Индекс Brain сообщает ей, какие страницы памяти существуют и где их найти.
- Brain открывает страницу проекта, чтобы прочитать сохраненные решения и инструкции.
- Если в заметке указано, что вы отклонили определенный подход, агент может перейти по ссылке на разговор и проверить причину.
Ссылки на связанные страницы позволяют ему находить задействованных людей или другие проекты. Агент делает это путем чтения и поиска по файлам. Например, grep позволяет находить упоминания проекта по имени.
Мы также протестировали, что дают агентам возможности исследования файлов. Во внутреннем бенчмарке из 150 вопросов по финансовым документам агент-исследователь с использованием стандартных файловых инструментов достиг точности ответов 0,627 по сравнению примерно с 0,37 для семантического поиска по тому же корпусу.
Как улучшить память ИИ-агентов?
В May 2026 paper by Orogat and Mansour выделяются четыре повторяющихся сбоя в памяти агентов: хранилище продолжает расти, устаревшие убеждения не пересматриваются, информация забывается при нехватке места, а извлечение читает данные, ничего не извлекая из этого опыта.
Предложенное ими решение заключается в том, чтобы перестать относиться к памяти агента как к хранилищу и рассматривать ее как «состояние», которое эволюционирует посредством четырех операций: прием, пересмотр, забывание, извлечение. Это наш контрольный список для данного раздела.
Будьте избирательны в отношении того, что запоминается
Как только «плохая» память попадает внутрь, каждый шаг наследует ее.
Workday AI Research протестировали выборочный подход примерно на 1500 кандидатах в память из бенчмарка LoCoMo, задавая пять вопросов перед сохранением любого из них:
- Полезно ли это? Будет ли это актуально снова?
- Достоверно ли это? Действительно ли это было сказано в разговоре или модель додумала это?
- Это новый факт или он уже сохранен?
- Является ли это свежей информацией?
- Является ли это долговечным фактом или временным состоянием?
Только для первого вопроса потребовался вызов модели. Остальные четыре выполнялись как правила в общей сложности менее чем за 65 миллисекунд. Этот метод позволил достичь на 12% более высокой точности при принятии решений о сохранении или удалении, сохранив при этом 97% релевантной памяти.
Наибольший вклад внес последний вопрос: при удалении разграничения между долговечной и временной информацией качество решений падало примерно на 18%.
Пересматривайте ответ, не теряя историю
Записывайте, когда факт стал актуальным, какой источник его подтверждает и что он заменил. Если источники расходятся во мнениях, сохраняйте это расхождение видимым до тех пор, пока не появится достаточно доказательств для его разрешения. Самый свежий документ тоже может быть ошибочным.
Brain обновляет вики, используя исходные документы, результаты коннекторов и исправления пользователей. Каждая запись памяти ссылается на свой источник. Нам нужно, чтобы агент находил текущий ответ и имел место для проверки, если этот ответ кажется подозрительным.
Забывайте намеренно
В документе один из режимов сбоя называется «забыванием из-за ограничений емкости»: информация удаляется для соблюдения лимита хранения, а не потому, что она перестала быть полезной.
Вернемся к общей кухне. Через шесть месяцев никого не волнует, кто разогревал рыбу в микроволновке и сколько времени окно оставалось открытым. Но табличка по-прежнему выполняет свою задачу.
Если следующий человек будет обедать, правило будет доступно. Вам нужно лишь архивировать жалобы.
Проверки свежести и типа информации в Workday начинаются до этапа хранения, отфильтровывая то, что заслуживает стать памятью. В Brain мы также пересматриваем существующие знания по мере изменения исходных документов и внесения пользователями исправлений. В обоих случаях контент требует вмешательства.
Сделайте так, чтобы извлечение данных питало следующее обновление
Агент извлекает факт, использует его и оставляет хранилище в точно таком же состоянии, в каком оно было найдено. Теперь, если система не фиксирует то, что произошло дальше, ничто не запишет, помог ли этот факт или привел агента в очередной тупик.
Записывайте результат, источник и любые исправления. Когда мы создавали Brain, мы сделали эту историю работы частью того, что она запоминает: какой подход сработал, какой источник завел в тупик и что исправил пользователь после того, как агент объявил о завершении работы. Brain учитывает этот опыт в своих периодических обновлениях вики, чтобы последующие задачи могли его использовать.
Однако ничто из этого не отображается в бенчмарках памяти. Способ узнать, работает ли этот цикл — дать агенту задачу, которую он может выполнить только с помощью памяти, и подсчитать, как часто он ее выполняет, с учетом затрат и задержки. Именно это делает DolphinBench, и именно поэтому лучшие показатели все еще находятся в районе семидесяти процентов.
Как создать агента с персистентной памятью с помощью Perplexity
Agent API от Perplexity не поставляется с самоподдерживающейся системой памяти, как Brain. Мы предпочитаем заявить об этом сразу. Но то, что она вам дает — это необходимые элементы памяти: место для хранения процедур, способ передачи контекста между шагами и инструменты для чтения и записи в контролируемое вами хранилище.
Начните с процедурной памяти
Пользовательский навык (Skill) упаковывает инструкции, процедуры и сопутствующие файлы под определенным номером версии. Команда платформы может один раз написать свои проверки развертывания, критерии отката и формат отчетности, а затем настроить приложения на использование одного и того же навыка. Когда процедура меняется, команда загружает новую версию.
Профиль поднимается на один уровень выше. Профили сохраняют модель агента, инструкции, инструменты, навыки, коннекторы и настройки выполнения под единым идентификатором с версионированием.
Мы добавили оба компонента в сентябре вместе с управляемыми коннекторами, чтобы администратор проекта мог один раз настроить утвержденное подключение к GitHub или Slack и позволить приложениям ссылаться на него вместо хранения отдельных учетных данных. При изменении доступа администратор обновляет подключение в одном месте.
Почему это считается памятью? И снова вернемся к кухне с микроволновкой для рыбы. Тот, кто придет следующим, сможет следовать правилу НЕТ РЫБЫ, даже не став свидетелем жалоб.
Навык выполняет ту же работу для агента, оставляя место для шагов, исключений и проверок, которые не поместятся на дверце микроволновки. Навыки зафиксированы письменно, имеют версии и доступны при следующем возникновении задачи.
Мы также используем навыки (Skills), чтобы направлять обновление памяти Dream. Но навык не способен обучаться самостоятельно. Инструкции меняются при загрузке новой версии — будь то человеком или в ходе автоматического процесса.
Если вы хотите, чтобы агент заметил, что проверка отката постоянно завершается сбоем на одном и том же сервисе, и адаптировался, это и есть тот самый цикл «сеансы — вики», о котором говорилось ранее.
Вам необходимо сохранять то, что произошло, определять, что именно должно измениться, и делать исправление доступным в следующий раз. Для этого требуются следующие два компонента.
Перенос рабочей памяти между шагами (turns)
Агент выполняет проверку развертывания. Вы спрашиваете: «Почему это упало?» Вполне разумный последующий вопрос, при условии, что агент всё еще видит, к чему относится слово «это».
Наш Agent API поддерживает два способа переноса контекста разговора дальше:
- Самостоятельное воспроизведение беседы: включите предыдущие сообщения во входной массив следующего запроса. Вы сами решаете, что сохранить, обобщить, отредактировать или отбросить перед отправкой.
- Продолжение с завершенного ответа: сохраните его ID и передайте его в качестве previous_response_id вместе со следующим сообщением. Мы сохраняем состояние разговора на стороне сервера, поэтому вашему приложению не нужно повторно отправлять предыдущие реплики. Вы можете продолжить с самого последнего ответа в цепочке.
Воспроизведение дает вам контроль над тем, что видит агент, а продолжение по ID избавляет от необходимости заново собирать разговор. В любом случае предоставьте все новые инструкции, инструменты или настройки модели, необходимые для следующего ответа.
Использование собственного хранилища эпизодической и семантической памяти
Это ту часть работы, которую Agent API оставляет вам.
Один из путей — вызов функций (function calling). Вы определяете инструменты, агент запрашивает вызов, а ваше приложение выполняет его и возвращает результат. Для памяти простой отправной точкой является операция чтения перед действием агента и операция записи после него.
Регистрируйте только сам факт извлечения данных агентом, и вы всё равно не узнаете, помогло ли это. Записывайте результат, источник и все исправления, внесенные пользователем, и вы получите основу для эпизодического слоя.
Наша поддержка MCP предоставляет вам еще один путь. Если совместимый удаленный сервер MCP предоставляет необходимые вам операции, агент может вызывать их без необходимости обертывать каждую из них как пользовательскую функцию.
Наши коннекторы (connectors) предоставляют агенту доступ к первоисточникам воспоминаний. GitHub, Slack, Google Drive, Datadog, Linear и Notion входят в наш управляемый каталог, и вы можете добавлять собственные коннекторы для внутренних систем.
Наконец, решите, когда история будет пересматриваться, а текущие данные — корректироваться.
Проверьте, что выживает в новом сеансе
Теперь закройте беседу. Начните новый запрос без повторного воспроизведения старых сообщений и без передачи previous_response_id, но предоставьте агенту доступ к тому же хранилищу памяти. Попросите его выполнить сопутствующую работу, не повторяя исправление.
Если ему требуется напоминание, значит, вы еще не закончили.
Для агента развертывания подготовьте несколько тестов на то, что должно переноситься в следующий сеанс:
- Исправление сохраняется: он находит и использует проверенную команду отката для проблемного сервиса.
- Исправление не выходит за рамки задачи: он не затрагивает процедуры других сервисов.
- Новая информация заменяет старые указания: когда команда снова меняется, он использует текущую версию и может проследить источник этого изменения.
Наша книга рецептов регрессионного тестирования показывает, как сохранять результаты работы агента и извлеченные данные, проверять их на соответствие ожидаемому поведению и сравнивать прогоны после изменения инструкций или моделей.
Фиксируйте версии модели, Profile и Skill при сравнении прогонов с памятью и без нее. Начинайте каждое сравнение с известного снимка (snapshot) хранилища; в противном случае один тест может научить агента ответу для следующего.
Когда что-то идет не так, сохраняйте этот кейс. Следующее изменение должно проходить эту проверку.
Или пропустите этап сборки: Brain in Computer
Если вам нужен готовый цикл, а не его составные части, это Computer. Под ним работает Brain, обучающийся из четырех источников: ваших сеансов, подключенных инструментов, созданных вами файлов и артефактов, а также ваших исправлений. Фоновые обновления Brain подкрепляют то, что по-прежнему актуально, пересматривают изменившееся и помечают устаревшую информацию.
Вам не нужно выстраивать этот цикл самостоятельно. Вы просто делаете свою работу.
Память сохраняет предпочтения и детали, которыми вы поделились. Brain связывает проекты, людей, решения и незавершенную работу с лежащими в их основе фактами.
Вы можете проверить то, чему он научился, в представлении Memory, проследить записи до их источников, а также отредактировать или удалить их. Brain использует вашу собственную активность, исключает сеансы инкогнито и имеет собственный переключатель.
Например, в компании Rho решения по проекту выставления счетов были разбросаны по Slack, Notion, Jira, Figma и Google Docs. Команда настроила Computer на проверку изменений в ночное время, выявление несоответствий и публикацию утренней сводки в Slack.
Их инженер-программист Октавиан Юркевич (Oktawian Jurkiewicz) заметил, что Computer также формирует память для проекта. «Мы это не задавали, — говорит он. — Computer сам понял, какие точки данных нужно сохранять из каждого источника».
Команда сообщает о сокращении времени еженедельных совещаний с 2,5 часов до 15 минут и оценивает экономию в 120 рабочих часов за 12-недельный проект.
Эти 120 часов приписываются всему рабочему процессу в целом: коннекторам, ночным прогонам и дайджесту в Slack. Какая доля сэкономленного времени приходится исключительно на память? Мы пока не можем это количественно оценить.
Но мы можем посоветовать следующее: для собственной разработки вернитесь к тесту из начала — запустите аналогичные задачи с включенным и выключенным слоем памяти, а затем сравните показатели успешности завершения, затраты и время, включая время, потраченное кем-либо на исправление результата.
Часто задаваемые вопросы о памяти ИИ-агентов
Могут ли ИИ-агенты иметь память?
Да. ИИ-агенты могут сохранять информацию между сеансами с помощью сохраненных разговоров, фактов, предпочтений и многоразовых процедур. Система должна извлекать эту информацию, когда она актуальна, и обновлять ее при изменении обстоятельств.
Например, Brain в Perplexity Computer формирует рабочий контекст на основе сеансов, подключенных инструментов, файлов и пользовательских исправлений.
Сколько оперативной памяти использует ИИ-агент?
Единого требования не существует. Если ваш агент вызывает размещенную в облаке модель через Perplexity Agent API, вам не нужно загружать эту модель в собственную оперативную память. Вашему приложению и локальным инструментам по-прежнему требуется память.
Запуск локальной модели — это другое. При четырех битах на параметр восемь миллиардов параметров составляют примерно 4 GB of raw weight data. Фактический объем необходимой памяти оказывается выше, если учесть накладные расходы на квантование, обработку контекста и ПО, управляющее моделью.
Какая память лучше всего подходит для ИИ-агента?
Наилучшая конфигурация зависит от того, что именно агент должен переносить в будущее. Состояние разговора поддерживает уточняющие вопросы; эпизодические записи сохраняют то, что произошло; семантическая память хранит актуальные знания; процедурная память предоставляет многоразовые инструкции.
Большинству долгосрочных проектов идет на пользу их комбинация. Для Brain мы используем связанную вики с поддержкой первоисточников. Для собственной разработки проверьте, помогает ли такая настройка агенту выполнять задачи, применять исправления и отказываться от устаревших рекомендаций.