TRL теперь поддерживает MOPD. AsyncDistillationTrainer направляет каждый промпт к собственному эксперту-учителю, а поддержка синхронного DistillationTrainer появится в #7215. Если вы уже знаете, что такое MOPD, и зашли ради примера с TRL, перейдите к разделу MOPD в TRL.
TRL теперь поддерживает MOPD. AsyncDistillationTrainer направляет каждый промпт к собственному эксперту-учителю, а поддержка синхронного DistillationTrainer появится в . Если вы уже знаете, что такое MOPD, и зашли ради примера с TRL, перейдите к разделу MOPD в TRL.
Одним из методов постобучения, который регулярно встречается в технических отчетах этого года, является дистилляция «он-полиси» от нескольких учителей (Multi-Teacher On-Policy Distillation, MOPD). Компания Xiaomi упомянула его в январе для MiMo-V2-Flash, и с тех пор такие компании, как DeepSeek, Moonshot, NVIDIA, Liquid AI и Mistral, использовали его для создания своих моделей.
Заставить одну модель хорошо разбираться во многих областях одновременно — например, в математике, программировании, использовании инструментов или следовании инструкциям — с помощью одного запуска RL сложно. В процессе обучения домены тянут модель в разные стороны, каждый из них получает лишь малую часть каждого батча, и то, что улучшает одну область, может незаметно навредить другой. С помощью MOPD лаборатории обходят эту проблему, обучая по одному эксперту для каждого домена, а затем объединяя экспертов обратно в единую модель.
Мы рассмотрели более общую картину того, как лаборатории используют дистилляцию, в материале «Дистилляция в 2026 году (на данный момент)».
Что такое MOPD?
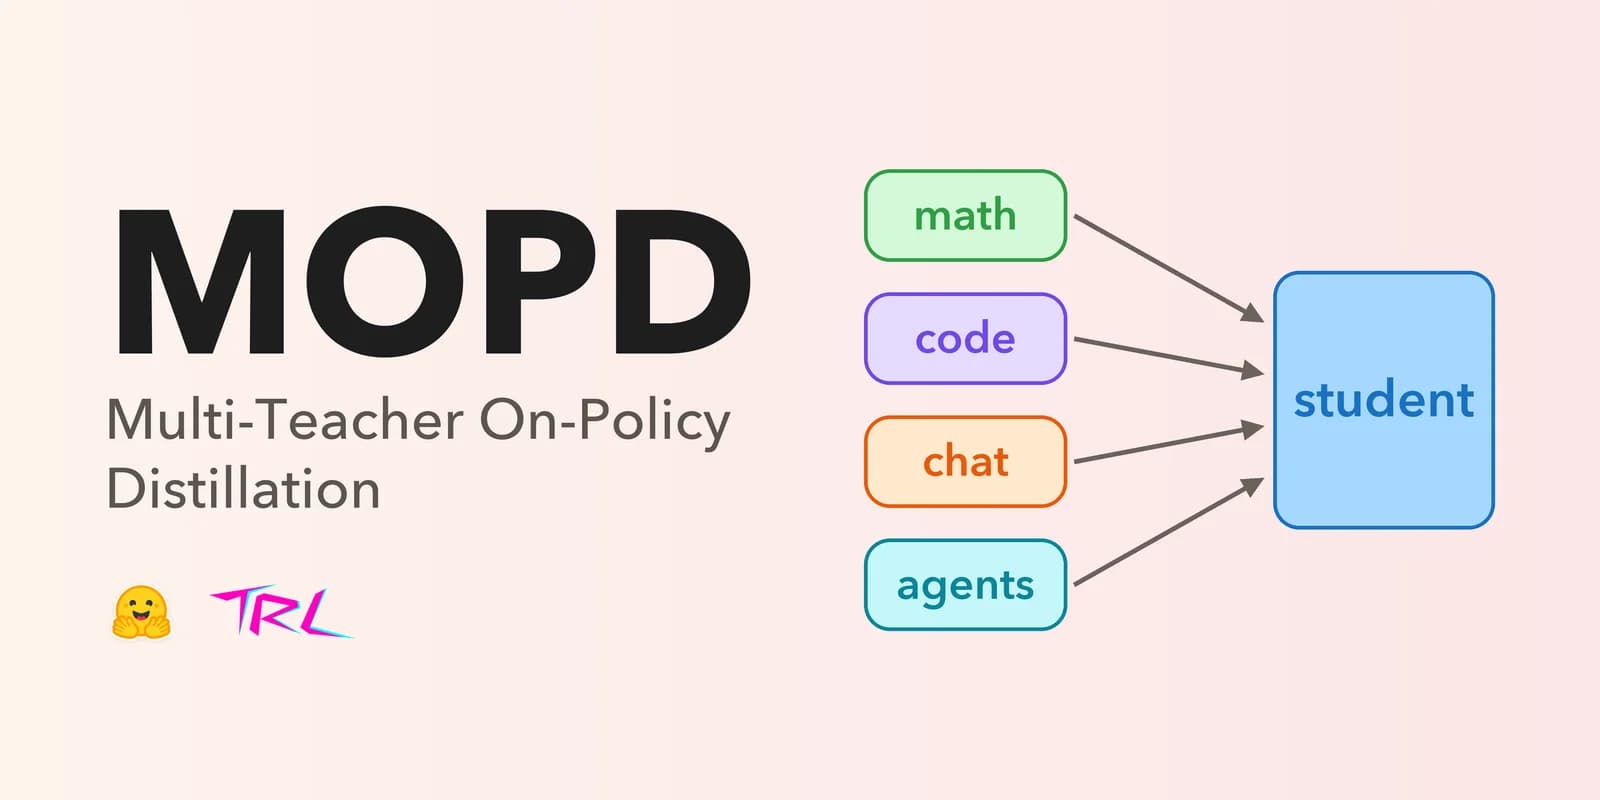
Дистилляция обучает модель (ученика) подражать другой модели (учителю). В MOPD учителей несколько — по одному на каждый домен, и ученик учится у всех них. Строго говоря, MOPD — это последний этап трехэтапного метода постобучения, хотя это название часто используют для описания всего процесса:
- Общий SFT: одна модель изучает основы каждого домена посредством регулярной контролируемой дообучки (SFT) на смешанных данных. Это общая отправная точка.
- Эксперты доменов: начиная с этой контрольной точки, для каждого домена отдельно обучается модель с помощью RL, например: одна для математики, одна для кода, одна для следования инструкциям и одна для агентных задач. Каждый эксперт должен быть действительно хорош только в чем-то одном.
- Слияние: ученик (обычно та же контрольная точка SFT) отвечает на промпты из каждого домена. Эксперт по домену конкретного промпта выступает в роли учителя и оценивает ответ токен за токеном, а ученик обучается приближаться к распределению этого учителя.
Метод MOPD: одна контрольная точка SFT, один эксперт RL на каждый домен, а затем цикл слияния, в котором каждый промпт оценивается экспертом своего домена.
MOPD — это дистилляция «он-полиси» с несколькими учителями. Ее работоспособность обеспечивают три свойства: первые два присущи самой дистилляции «он-полиси», а третье обусловлено наличием нескольких учителей:
- Ученик учится на собственных примерах. Учитель оценивает то, что ученик написал на самом деле. При обычном SFT на основе выводов учителя ученик обучается только на тексте, написанном учителем, но на этапе инференса ему приходится продолжать свой собственный текст, и одна ранняя ошибка может привести его туда, с чем он не сталкивался во время обучения. Обучение на собственных примерах позволяет избежать этого; в этом и заключается суть «он-полиси».
- Сигнал является плотным. Если в RL за каждый ответ дается одна награда, то здесь каждый токен получает обратную связь от учителя, а функцией потерь обычно выступает обратная дивергенция Кульбака — Лейблера (reverse KL) между учеником и учителем на токенах ученика, то есть показатель того, насколько учитель не согласен с каждым токеном, выбранным учеником. Учитель никогда ничего не пишет сам, он только читает ответ ученика. Лаборатории различаются по тому, какую часть распределения учителя они используют для каждого токена. Nemotron 3 Ultra и MiMo-V2-Flash используют только вероятность учителя для того токена, который написал ученик. Open-MOPD сравнивает 16 наиболее вероятных токенов. DeepSeek-V4 использует полное распределение по всему словарю, поскольку версия для одного токена давала им градиенты с высокой дисперсией и нестабильное обучение. Mistral Large 4 также использует полное распределение.
- Каждый промпт попадает к одному учителю. Математический промпт оценивается только математическим экспертом, промпт с кодом — только экспертом по коду.
В таких методах учителя обычно имеют тот же размер, что и ученик, и начинают с одной и той же контрольной точки. Они полезны в качестве учителей именно потому, что каждый из них был обучен в рамках одного домена.
Кто это использует
Метод Liquid AI проще всего для понимания. Общая линия ведет от SFT к MOPD, а в нее вливается линия специалистов, каждый из которых обучен с помощью SFT и RL.
Метод обучения LFM2.5-2.6B. Источник: Liquid AI.
MiMo-V2-Flash, статья, в которой было предложено название этого метода, более подробно описывает шаг слияния. Ученик генерирует ответ, и каждый учитель домена возвращает награду на уровне токенов.
Рисунок 3 из технического отчета MiMo-V2-Flash.
NVIDIA демонстрирует, как MOPD выглядит в масштабе. Для они используют более десяти учителей и запускают MOPD дважды. После первого раунда они обучают новых учителей, начиная с объединенной модели, и снова запускают MOPD.
Рисунок 10 из .
Компания NVIDIA также опубликовала пять из этих учителей на Hub: для STEM, соревновательного программирования, следования инструкциям, общих рассуждений и чата. Большинство лабораторий публикуют только финальную модель, поэтому контрольные точки экспертов все еще редкость, и мы ожидаем их появления в ближайшие месяцы.
Вот основные релизы, в отчетах или карточках моделей которых описывается MOPD:
MOPD опирается на обычную дистилляцию «он-полиси» с одним учителем, которую Thinking Machines подробно описала в конце 2025 года. С точки зрения исследований, в статье про MOPD этот метод изучается сам по себе, а проект Open-MOPD выпускает полный метод вместе со своими контрольными точками, который мы и используем в примере ниже.
MOPD в TRL
В TRL поддержка MOPD реализована в AsyncDistillationTrainer, который и используется в примере ниже. Вы развертываете каждого эксперта с помощью vLLM, передаете тренеру один URL для каждого учителя и добавляете колонку teacher_id, которая направляет каждый промпт к соответствующему эксперту. Генерация, оценка учителем и обучение выполняются асинхронно, поэтому ученик продолжает генерацию во время обучения.
Мы создали пример, чтобы продемонстрировать эту функцию с реальными экспертами, выпущенными вместе с Open-MOPD. Учеником выступает их контрольная точка SFT модели SmolLM3-3B, а учителями — три эксперта, обученные на ее основе с помощью GRPO для математики, программирования и следования инструкциям. Выпущенный набор промптов уже содержит разметку с указанием домена для каждого промпта.
При использовании обратной дивергенции Кульбака — Лейблера (beta=1.0) TRL задействует вероятность учителя только для того токена, который сэмплировал ученик (как в Nemotron 3 Ultra и MiMo-V2-Flash), поэтому данный пример не следует подходу сравнения top-16 из Open-MOPD. Параметр teacher_top_k=1 сохраняет ответы каждого учителя небольшими по объему. Top-k имеет значение только при прямой дивергенции KL (beta=0.0), где функция потерь сравнивает k наиболее вероятных токенов учителя плюс один бакет для остальной массы вероятностей. Потокенное сравнение учителя и ученика также объясняет, почему у каждого учителя должен быть тот же токенайзер, что и у ученика.
Полный скрипт доступен в примерах TRL.
Запуск на HF Jobs
Для MOPD требуется одновременный запуск пяти процессов: сервера vLLM для ученика, который генерирует ответы и получает обновленные веса после каждого шага; по одному серверу vLLM для каждого учителя (в этом примере их три), которые занимаются только оценкой; и процесса обучения. Вот как мы разместили их на одной машине с 4 чипами H200:
Работа на HF Jobs предоставляет вам один контейнер и одну команду, поэтому в примере поставляется launcher.py скрипт, который запускает четыре сервера, ждет, пока они ответят, а затем запускает скрипт обучения. Весь запуск состоит из одной команды:
Если вы запускаете это на собственной машине, скопируйте команды vllm serve из файла запуска. У каждого учителя --max-model-len больше, чем у ученика, поскольку оценка отправляет весь ответ ученика плюс один токен, а два учителя, разделяющие один GPU, запускаются один за другим, так как vLLM рассчитывает размер памяти на основе того, что свободно при запуске.
Эта схема — та, которую мы протестировали, и она зависит от имеющегося у вас оборудования. Например, с 8 GPU (h200x8) вы можете выделить каждому учителю собственный GPU, запустить сервер ученика на двух GPU для более быстрой генерации, а обучение проводить на оставшихся трех.
Наблюдение за дисбалансом токенов
Тренер записывает метрики для каждого учителя, поэтому вы можете видеть, как ученик учится у каждого из них. teacher_jsd/<id> показывает, насколько ученик далек от каждого учителя (меньшее значение означает ближе), а teacher_token_frac/<id> показывает, какая доля каждого шага обучения пришлась на этого учителя.
teacher_token_frac — это параметр, за которым стоит следить. Функция потерь усредняется по токенам, поэтому каждый домен весит столько, сколько токенов он производит, а не столько, сколько у него промптов. Ответ по математике или коду представляет собой длинную цепочку рассуждений, состоящую из тысяч токенов. Ответ на основе инструкций, например «напишите два абзаца, разделенных звездочками», составляет всего несколько сотен. Таким образом, следование инструкциям может составлять 20% промптов и при этом давать лишь 1 или 2% токенов, и ученик почти ничему не учится у такого учителя. Авторы Open-MOPD заметили это и подробно описали в своей статье вместе с вариантом решения.
Мы провели короткий эксперимент с описанной выше настройкой, чтобы проверить работоспособность реализации TRL и убедиться, что эти метрики отражают происходящее. Это короткий запуск на 60 шагов, что составляет около 1% от обучения, выполненного в статье. Дисбаланс проявляется уже на первых шагах. Следование инструкциям начинается с честной доли токенов, но как только ответы по математике и коду становятся длинными, она падает до нескольких процентов. На графике ниже ученик стабильно приближается к учителям по математике и коду, в то время как его расстояние до учителя по следованию инструкциям практически не меняется.
Метрики, записанные TRL за 60 шагов с экспертами Open-MOPD и разделением промптов 40/40/20. Вверху: доля обученных токенов на каждого учителя (teacher_token_frac/<id>): следование инструкциям составляет 20% промптов и получает от 1 до 3% токенов. Внизу: дивергенция для каждого учителя (teacher_jsd/<id>, скользящее среднее за 5 шагов по сырым значениям): математика и код приближаются к своим учителям, следование инструкциям практически не меняется.
Это также проявляется в оценке. Мы остановили запуск после 60 шагов и оценили модель с помощью наборов для оценки и оценщиков Open-MOPD, рядом с исходной контрольной точкой и финальной моделью из статьи, которая была обучена по полному рецепту, включая исправление этого дисбаланса:
AIME: 4 сэмпла на задачу. IFEval: строгая точность на уровне промптов. Мы не оценивали код.
Ученик улучшает показатели в обоих доменах за 60 шагов, чего достаточно для демонстрации работы примера. По математике он оказывается там же, где и финальная модель из статьи (при 4 сэмплах на задачу отклонение в несколько пунктов является шумом). Проблема наблюдается в следовании инструкциям — домене, который получил меньше всего токенов.
Контрольная точка, дашборд Trackio со всеми метриками запуска, а также модели и данные Open-MOPD находятся в этой коллекции.
В примере используются математика, код и следование инструкциям, потому что это эксперты, выпущенные Open-MOPD, но идея заключается в том, что вы можете подключить свои собственные. Если у вас есть RL-эксперты для интересующих вас доменов, обученные на одной и той же базовой модели, чтобы они использовали общий токенизатор, вам нужно лишь обслуживать их с помощью vLLM и пометить каждый промпт его доменом. После этого вы можете обучать дольше или дать промптам со следованием инструкциям больший вес в данных, а метрики для каждого учителя подскажут, помогает ли это.
Выводы
MOPD позволяет одной модели сохранять знания, полученные несколькими RL-экспертами, без необходимости для одного процесса RL балансировать все домены одновременно. Лаборатории уже используют это в больших масштабах, а с помощью некоторых выпускаемых ими экспертов, открытых данных и AsyncDistillationTrainer вы можете попробовать это самостоятельно. Если вы хотите пойти дальше, документация AsyncDistillationTrainer охватывает остальные его опции и метрики, а документация DistillationTrainer — синхронную версию.