Семейство открытых энкодеров размером от 55 млн до 538 млн параметров, которые читают текст по предложениям, анализируют каждое предложение и извлекают сущности, отношения и атрибуты фактов, заданные вами во время выполнения, без вызовов LLM и переобучения.
LLM может извлечь всё, что вы попросите, за один вызов API на сообщение. Теггер стоит недорого и работает локально, но он находит только то, для чего был обучен.
Памяти агента требуется гибкость первого варианта при стоимости второго.
В мае мы выпустили kniv v5 — каскад, который выдает лингвистический слой за один проход: части речи, именованные сущности, зависимости, семантические роли и иллокутивные акты. Он отлично справлялся с этой задачей. Но системы памяти, которые мы строили на его основе, продолжали запрашивать что-то новое, и следующим запросом стали факты. Кто где живет. Кто на кого работает. Каковы чьи-то планы, а не только то, что они сделали. Им нужны были эти факты в их собственной схеме, а не в нашей, и им нужно было знать, является ли каждый факт утвержденным, отрицаемым, желаемым или просто сообщаемым.
Поэтому сегодня мы выпускаем kniv v7 — семейство из шести моделей с одинаковыми выходными данными и временем выполнения: от модели с 55 млн параметров для небольших устройств до двух моделей с 500 млн параметров, которые задают уровень качества:
Все они распространяются под лицензией Apache-2.0, в комплект входит ONNX в трех вариантах точности. Каждая модель объединяет фиксированный лингвистический слой со слоем знаний, типы сущностей и отношения которого задаются на входе. Вы описываете на обычном английском языке то, что вам нужно, и модель выполняет поиск.
В этой статье рассказывается об инженерной стороне изменений: как мы научили общий энкодер читать схему, обучили его на неполной разметке, дистиллировали в меньшие модели и сделали полученный пайплайн пригодным для локального запуска.
Что делает v7
Один вызов возвращает два слоя.
Лингвистический слой фиксирован. Он охватывает части речи, морфологию, леммы, именованные сущности, деревья зависимостей, семантические роли, иллокутивные акты, тональность для каждого предложения, а также кореферентность.
Слой знаний следует вашей схеме:
- сущности, типизированные вашими именами типов;
- факты для указанных вами отношений;
- для каждого факта: его полярность (положительная или отрицательная); его модальность (утвержденная, гипотетическая, запланированная, желаемая, поставленная под сомнение или сообщенная); его держатель (кто это говорит); его время (когда это применимо).
- его полярность (положительная или отрицательная);
- его модальность (утвержденная, гипотетическая, запланированная, желаемая, поставленная под сомнение или сообщенная);
- его держатель (кто это говорит);
- его время (когда это применимо).
Думайте об этом как о бланке, пропуски в котором вы заполняете сами. kniv заполняет их на основе текста, а также отмечает, кто это сказал и имеет ли это силу.
Диалоги являются первоклассными объектами: каждый спикер — это сущность. Таким образом, фраза «Я живу в Берлине» превращается в (пользователь, живет в, Берлин), приписанную пользователю.
Измените список отношений — и вы измените то, что ищет модель. Никакого обучения и примеров с разметкой не требуется. Единственные зависимости — это onnxruntime, tokenizers и numpy. Каждая модель в семействе принимает вызов одинаково и возвращает эти два факта; меняется только имя репозитория.
Документы, а не предложения
Большинство открытых моделей извлечения работают по одному предложению или по одной паре сущностей за раз. Реальный текст не хранит свои факты в одном предложении. В наборе данных Re-DocRED около половины золотых фактов охватывают несколько предложений: сущность называется в одном, а факт о ней появляется в следующем, часто через местоимение.
kniv считывает целое окно (вплоть до страницы текста) как единое целое:
- ссылки кореферентности связывают упоминания по всей странице;
- проход разметки видит каждое упоминание каждой сущности одновременно и объединяет контекст отовсюду в окне, поэтому пара может быть связана свидетельством, находящимся на расстоянии двух предложений;
- проход поиска свидетельств при обучении учит классификатор отношений тому, какие предложения подтверждают каждый факт.
В результате расстояние между двумя сущностями стоит на удивление дешево. Тест Re-DocRED, эталонные сущности, в зависимости от того, где упомянуты две сущности:
Для DeBERTa факт, сущности которого разделены двумя или более предложениями, извлекается почти так же хорошо, как и факт внутри одного предложения. Учитывая текст «Ада Лавлейс родилась в Лондоне в 1815 году. Позже она работала с Чарльзом Бэббиджем над его Аналитической машиной», модель возвращает (Ада Лавлейс, работала с, Чарльз Бэббидж), прочитав «Она» во втором предложении.
Более длинные документы автоматически разбиваются на окна. Каждое окно считывается как единое целое, а факты не связываются между окнами (см. раздел «Где это ломается»).
Почему фиксированная схема была тупиком
Наша предыдущая исследовательская ветка (v6) достигла показателя 0,764 F1 на Re-DocRED — бенчмарке отношений на уровне документов — при наличии эталонных сущностей. Этого удалось добиться за счет переноса прохода разметки ATLOP: упоминания обертываются маркерами, а контекст объединяется локально вокруг каждой пары сущностей. Этот показатель держался ровно для одной схемы: 96 отношений Wikipedia и 6 типов сущностей из Re-DocRED. Для службы поддержки, CRM, кодовой базы или личной памяти это было бесполезно.
Первой попыткой было хирургическое вмешательство. Мы пересадили фиксированную голову отношений в голову, которая читает имена отношений. На нулевом шаге трансплантация прошла успешно, воспроизведя старые логиты, после чего мы продолжили обучение. Модель так и не восстановила паритет: 0,755 против 0,764, и всего 0,204 на невиданных отношениях FewRel (8 вариантов). Архитектура умела читать метки. Она просто не научилась этому.
Вывод, который изменил план, заключался в том, что разнообразие меток превосходит архитектуру. Наши собственные данные, размеченные учителем, какими бы большими они ни были, сужали поведение zero-shot до нашего собственного стиля разметки. Предварительное обучение на тысячах отношений из баз знаний, каждое из которых сформулировано по-разному, подняло показатель для невиданных FewRel с 0,204 до 0,480. Ни одно из опробованных нами архитектурных изменений даже близко не подошло к этому результату.
Вторым открытием стало то, что энкодер нужно было сдвинуть с места. Сохранение энкодера замороженным и добавление адаптеров оставляло лингвистический слой побитово идентичным. Но это ограничивало отношения примерно на уровне 0,76: представление просто не содержало того, что необходимо для отношений на уровне документов. Поэтому v7 выполняет эту задачу в два этапа. Этап А выполняет предварительное обучение самого энкодера для отношений и типов сущностей. Затем этап B обучает каждую голову на этом энкодере, причем лингвистические оценки подвергаются гейтингу при каждой оценке.
Два учителя, потому что победителя не было
Перед выделением вычислительных ресурсов мы провели состязательный тест: DeBERTa-v3-large, Ettin-400M и UltraBERT-380M. Каждая модель получила одинаковый бюджет, данные и рецепт: короткое предварительное обучение на знаниях, за которым следовал короткий лингвистический этап. Правило отбора было зафиксировано до начала любого запуска.
Ни один из энкодеров не победил в одиночку.
- DeBERTa лидировала в лингвистических задачах и отношениях с фиксированной схемой.
- UltraBERT опережала в задачах zero-shot на знания на 4,2 пункта и лучше обрабатывала более длинные окна.
- Ettin-400M отставала как по знаниям, так и на 2 пункта по синтаксическому анализу, поэтому мы исключили ее.
Поэтому мы обучили обе модели, каждую с настройкой на лучший результат, а не для сопоставимого сравнения. Это две модели xlarge: xlarge-u (UltraBERT) и xlarge-d (DeBERTa), а также учителя, у которых учатся меньшие модели:
Одна деталь стоила нам недели работы. Токенизатор UltraBERT разбивает больше слов на части, чем токенизатор DeBERTa, и делает это так, что в первой части остается меньше от самого слова (re|authorization). Поэтому чтение каждого слова с его первого субтокена, как это делалось в v6, стоило UltraBERT полноты (recall) семантических ролей на длинных словах: 0,652 против 0,780 у DeBERTa. Объединение по всем субтокенам слова решило эту проблему.
Архитектура: три прохода, один энкодер
kniv запускает один энкодер до трех раз за окно:
- Простой проход. Окно в виде текста. Его читают все лингвистические головы вместе с модулем кореференции и типизатором сущностей.
- Проход меток. Ваши имена отношений и типов вместе с их описаниями кодируются в векторы. Это происходит один раз для схемы, и результат кешируется.
- Проход маркеров. Снова окно, где отмечено каждое упоминание сущности и перед каждым ходом добавлен тег спикера. Каждая пара сущностей оценивается для каждого отношения, после чего каждый сохраненный факт получает свои атрибуты.
Почему проходы, а не отдельные модели? Небольшие адаптеры LoRA придают проходам меток и маркеров собственную емкость на одном общем энкодере. Простой проход использует сам обученный энкодер.
Отношения. Мы сохранили log-sum-exp упоминаний из ATLOP и локализованный контекстный пулинг. Поверх них располагаются экстракторы головы и хвоста, компактное представление пар, кросс-внимание от меток к документу и обучаемый столбец порога. Отношение прогнозируется, когда его оценка превышает собственный порог этой пары.
Типы сущностей. Отрезки-кандидаты содержат до 12 слов в пределах предложения. Каждый оценивается на основе векторов типов из того же энкодера меток, который читает отношения, благодаря чему типы и отношения используют единый способ чтения схемы.
Атрибуты фактов. Для каждого извлеченного факта (голова, отношение, хвост) небольшая голова читает проход маркеров и прогнозирует:
- полярность и модальность в виде фиксированных классов;
- держатель и время в виде указателей на сущности в окне.
Обучение на метках, которые, как мы знаем, неполны
Значительная часть контроля наших отношений исходила из нашей собственной разметки с помощью LLM разнообразного корпуса: прозы, диалогов, технического и делового текста. Мы измерили эти метки учителя по эталону. Они были точными, но неполными: точность 0,71, полнота 0,31 по эталонным сущностям.
Если обучать на этом наивным образом, вы учите модель тому, что каждый недостающий факт является ложным. Две трети истинных фактов стали бы отрицательными примерами.
Поэтому v7 обучает на положительных и неразмеченных данных повсеместно:
- Каждый элемент обучения несет в себе собственную схему.
- Столбцы отношений и типов за пределами схемы элемента маскируются. Они никогда не рассматриваются как отрицательные.
- Неразмеченные пары и отрезки имеют пониженный вес, а не учитываются как «нет отношения».
Отложенные выборки были зафиксированы до какого-либо обучения. 15 стандартных отношений FewRel в условиях zero-shot были удалены из каждого источника обучения, поэтому приведенные ниже показатели zero-shot являются реальными zero-shot.
Затем обучение проходило в этапы, каждый из которых зависел от лингвистических оценок:
- предобучение знаний;
- все головы совместно;
- добавление в смесь эталонных лингвистических данных;
- тонкая настройка голов с замороженным энкодером: голова роли SRL с учетом предикатов и голова NER на базе BiLSTM;
- проход только по знаниям;
- проход кореференции;
- проход свидетельств, который учит голову отношений тому, какие предложения подтверждают факт.
Каждый этап выполнялся на одном A100 40GB в формате bf16.
Калибровка оказалась важнее архитектуры
Самым удивительным числом проекта был ноль. На ранних этапах F1 в условиях zero-shot с пороговым значением составлял 0. Тем не менее ранжирование уже было правильным: правильное отношение обычно было тем, которое получало наивысшую оценку. Модель знала ответ. Ее оценки просто находились в неверном диапазоне для того, чтобы невидимое отношение преодолело порог.
Одно смещение, выбранное на отложенных данных, исправило это. Этот паттерн повторялся так часто, что калибровка теперь является частью модели: calibration.json поставляется вместе с весами и содержит
- пороги для каждого отношения, выбранные на выборке разработки;
- смещение для отношений, на которых модель никогда не обучалась;
- смещение отрезков сущностей;
- смещение связи кореференции;
- правило группировки упоминаний в сущности.
Вы можете изменить каждое из них во время выполнения.
Смещение отрезков — наиболее наглядный пример. Невиданным типам сущностей требуется более низкая планка, чем обученным. Перемещение смещения с 0 примерно до -2 дало прирост до 8 пунктов по каждому домену CrossNER без повторного обучения.
Калибровка также показала нам, где она не может помочь. На Re-DocRED порог, настроенный для каждого отношения на самом тестовом наборе (хитрость, используемая только в качестве верхнего предела), добавляет не более 1 пункта. Эталонное отношение занимает первое место для 72-73% фактов и входит в четверку лучших для 98%. Таким образом, остается выбор пар и ранжирование, а не пороговые значения.
Что имело больший вес, чем увеличение головы
Эксперименты, которые улучшили показатели, изменили контроль. Те, которые изменили голову при том же контроле, в основном — нет:
- Обучаемый связующий модуль сущностей. Группировка упоминаний в сущности с помощью обученного связующего модуля не превзошла точное сопоставление имен плюс кореференцию. Правило остается в силе.
- Дистилляция отношений одной модели в другую. Усреднение решений об отношениях двух учителей дает +2,7 по F1, поэтому мы попытались научить половину DeBERTa от UltraBERT. Модель прибавила 0,35 на Re-DocRED и потеряла 2-3 пункта в zero-shot. При замороженном энкодере голова отношений не может воспроизвести решения, которые получены в результате чтения текста другим энкодером. Если вам нужны наилучшие отношения, запустите обе модели и усредните их.
- Описания типов. Мы переписали описания типов сущностей в четырех стилях. Ни один стиль не помог надежно: UltraBERT изменился максимум на один пункт, а DeBERTa колебалась от +7 до -11 в зависимости от домена.
- Большие головы типизации. Голова отрезков на основе MLP и иерархические схемы типов изменили CrossNER менее чем на пункт и стоили 3 пунктов на Few-NERD.
- Контролируемые головы на замороженных векторах. Зондирование показывает, что информация для типизации сущностей содержится в представлениях. Но ни одна голова, обученная на замороженных векторах, не превзошла совместно обученную.
Урок, который проходит через весь проект: ограничением обычно были данные, а не голова. Более широкое и разнообразное управление (тысячи типов отношений, множество формулировок, неполные метки, обрабатываемые как неполные) — это то, что создало уровень знаний. Более умная голова при том же контроле — редко.
Дистилляция семейства
Две модели xlarge точны, но велики. Меньшие модели являются студентами: каждая учится у обоих учителей одновременно на 117 000 окнах разнообразного текста, который учителя разметяли всем, что они производят, плюс эталонными лингвистическими данными.
Два учителя лучше одного. Мы смешали результаты работы учителей для каждой задачи с весами, выбранными на данных разработки, перед тем как выполнять дистилляцию. Смесь превосходит любого учителя по каждой голове: +2,2 пункта по SRL, +2,7 по отношениям и от 1,3 до 2,2 по типам сущностей. Именно этой смеси, а не какому-то одному учителю, учатся студенты.
Чему учатся студенты. Копирования окончательных решений учителей недостаточно для открытой схемы. Студенты также учатся тому, как учителя ранжируют каждое отношение для каждой пары сущностей и каждый тип для каждого отрезка, а также векторам, которые учителя присваивают именам отношений и типов. Именно это позволяет студенту работать с отношением, которое он никогда не видел при обучении. Добавление слоев кросс-внимания к голове отношений студента поверх этого ничего не изменило.
Атрибуты также должны подвергаться дистилляции. Обученные исключительно на жестких метках корпуса учителя, где 1,7% фактов имеют отрицание, первые студенты вообще не предсказывали отрицание: F1 отрицания 0,00 для наименьшей и 0,30 для большой. Дистилляция прогнозов атрибутов учителей и повторение окон, содержащих факт с отрицанием, позволили большой модели достичь 0,72, сравнявшись с учителями.
Что дает более продолжительное обучение. Трехкратное увеличение времени обучения небольших студентов (30 000 шагов вместо 10 000) заметно улучшило показатели связей и zero-shot: tiny прибавила 4,7 балла на Re-DocRED с золотыми сущностями и 6,8 на 10-вариантном FewRel. Это никак не повлияло на NER, SRL или кореферентность. Последние ограничены емкостью небольшого энкодера, а не длительностью его обучения.
Кореферентность — это область, где размер имеет наибольшее значение. На модели tiny мы пытались обучать кореферентности на основе выборов антецеентов учителями, а затем добавили для головы кореферентности собственный адаптер на энкодере. Ни то, ни другое не изменило показатели LitBank (0.610, затем 0.608 и 0.606). При количестве параметров менее 70 млн кореферентность становится главной платой за меньший размер.
Калибровка еще важнее для студентов. Исходные оценки связей студента ниже, чем у его учителя. При порогах, выбранных на валидационной выборке, сквозная модель tiny Re-DocRED поднялась с 0.38 до 0.54 без дополнительного обучения.
Как сделать модель достаточно компактной для поставки
Каждый репозиторий поставляется с графами ONNX и kniv_v7 — небольшой средой выполнения, которая превращает текст в полный анализ с использованием numpy, onnxruntime и tokenizers. PyTorch не требуется. Графы в fp32 декодируют точно так же, как PyTorch, на любом проверочном тексте.
Сжатие оказалось самой сложной инженерной задачей этого релиза.
Обычный INT8 полностью разрушил UltraBERT: показатель Re-DocRED упал с 0.754 до 0.168. Причина кроется в огромных активациях. В 14-м слое UltraBERT входы в нисходящую проекцию MLP достигают примерно 8000 против типичного значения около 4. При использовании одной шкалы INT8 на тензор выбросы захватывают весь диапазон, и все обычные значения попадают в одни и те же несколько корзин. DeBERTa имеет ту же закономерность, но в более мягкой форме в своих выходах feed-forward.
У FP16 была своя ловушка. Преобразование экспортированных графов в половинную точность приводило к созданию не загружаемых графов. Экспорт энкодеров из PyTorch в половинной точности с сохранением нормализации в fp32 совпал с fp32 с точностью до 0.001 на каждой задаче.
SmoothQuant исправил INT8. Для каждого входного канала каждой нисходящей проекции feed-forward мы делим активации на масштабный коэффициент и умножаем веса на тот же коэффициент. Это точно в fp32 и переносит выбросы в веса, где с ними справляется поканальный INT8. Проход связей DeBERTa оказался наиболее хрупким, поэтому в нем сохраняется поканальный INT8 с нисходящими проекциями в fp32.
(Подмножества dev; DeBERTa INT8 выполняется за 0.58 с на 200 слов, что также укладывается в рамки.)
Небольшие модели распределяют свои веса иначе. В tiny слои трансформера содержат всего 3,9 млн параметров. Таблица встраивания слов содержит 12,9 млн, а головы — около 38 млн, при этом наш рецепт INT8, созданный для больших энкодеров, оставлял оба компонента в fp32. Квантование таблицы эмбеддингов строка за строкой и графов голов только по весам позволило уменьшить лингвистический граф tiny с 66 МБ до 28 МБ и сократить объем загрузки INT8 вдвое при ухудшении результатов на любой задаче не более чем на 0,4 балла.
Совпадение с fp32 — неверный критерий проверки. INT8 изменяет около 15% аргументов семантических ролей, выдаваемых моделью, что выглядит тревожно. При оценке по золотым стандартам цена составляет 0.2 балла: изменения касаются пограничных аргументов и оказываются неверными примерно с одинаковой частотой в любой точности. Шлюз INT8 теперь оценивает NER, SRL и кореферентность по золотым стандартам, а не по fp32.
Какой вариант использовать:
- FP16: меньший размер загрузки и для GPU.
- INT8: скорость на CPU, отклонение в пределах 0,7 балла от fp32 на любой задаче для каждой модели.
- fp32: эталон.
Результаты
Тестовые наборы, две модели xlarge в сравнении с нашими предыдущими версиями и опубликованными специализированными моделями:
- Кореферентность соответствует LingMess, специализированной модели кореферентности.
- Few-NERD значительно опережает GLiNER.
- Сквозные связи превосходят нашу версию v6 с фиксированной схемой (0.627 против 0.566) при чтении открытой схемы. При использовании золотых сущностей открытая схема уступает около 3 баллов.
- В чем мы отстаем: классификация связей в режиме zero-shot по сравнению с RE-Matching и CrossNER по сравнению с GLiNER-large.
О CrossNER: текст и его пять доменов никогда не использовались при обучении, а типы задаются только в виде имен во время выполнения. Многие из этих имен типов («политик», «политическая партия») присутствуют в нашем банке меток, на котором обучались модели, поэтому здесь измеряется типизация сущностей в новых доменах, а не для ранее не встречавшихся имен типов. Оценки представляют собой строгий F1 для спанов: точные границы и тип. Домен политики настраивает смещение спана и исключается из среднего значения.
Вся линейка. Одни и те же тестовые наборы для каждого размера:
- large — это модель, с которой стоит начать. Она отстает от лучшего учителя менее чем на балл в тегах, синтаксическом разборе, NER и SRL и на два балла — в связях на уровне документов, работая примерно в два раза быстрее.
- Студенты лучше справляются со связями zero-shot, чем их учителя. Каждый оцененный нами студент превосходит обоих учителей в 5-вариантном FewRel, а large лидирует в 15-вариантном. Мы предполагаем, что изучение ранжирования ансамбля по тысячам названий связей обобщает лучше, чем собственное обучение учителей; мы не проверяли причину этого.
- Быстрее всего сокращаются кореферентность и новые типы сущностей. Для них используйте large или модель xlarge.
Память. Мы провели проверку памяти на LongMemEval (150 вопросов), выполняя извлечение из сеансов с одной фиксированной общей схемой памяти. Ни одна LLM не отвечает на вопросы: проверка лишь определяет, попал ли ответ в извлеченное хранилище. Для UltraBERT ответ содержится в извлеченных сущностях для 0,69 вопросов и в фактах для 0,48. Темпоральные вопросы и вопросы по нескольким сеансам являются самыми слабыми местами.
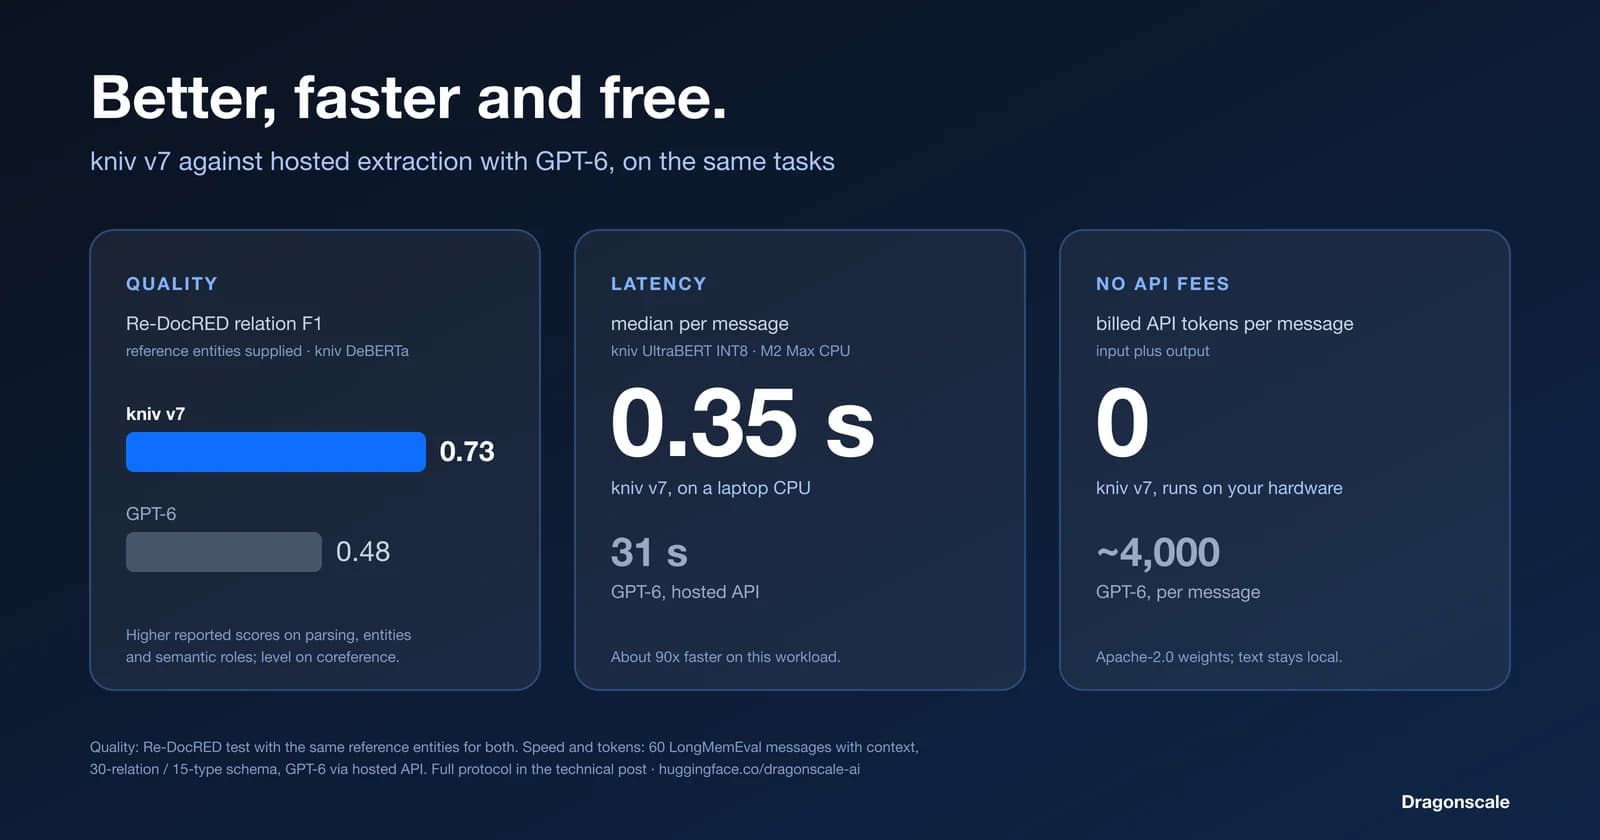
Лучше, быстрее и бесплатно: качество и задержка по сравнению с извлечением с помощью размещенных LLM
При создании v6 мы провели соревнование для выбора аннотаторов. Передовые LLM оценивались на тех же золотых тестовых наборах, на которых оценивается kniv. Вот сравнение GPT-6 и kniv v7 (лучшей из двух моделей xlarge для каждой задачи):
В строке SRL используется протокол v5, который оценивает корневой предикат каждого предложения; именно в этом режиме измерялись LLM. В таблице результатов выше приводится более сложный режим: все предикаты, обнаруженные сквозным методом (0.810). В строке связей обеим системам предоставляются эталонные сущности; полностью сквозная оценка kniv составляет 0.627.
Судя по отчетным оценкам, чем структурнее задача, тем больше превосходство специалиста. В лингвистических строках сравниваются полные тестовые наборы kniv с выборками GPT-6 из 300 элементов, поэтому их следует воспринимать как отчетные оценки, а не как результаты сопоставимых запусков. Строка связей представляет собой сопоставимое сравнение: обе системы на полном тестовом наборе Re-DocRED с одними и теми же эталонными сущностями.
- Кореферентность: на уровне.
- Лингвистический слой: отчетные оценки kniv выше по каждой задаче на величину до 4 баллов.
- Связи на уровне документов: kniv опережает на 26 баллов. Даже когда каждой кандидатуре пары сущностей явно передавались данные при 5,4-кратном количестве вызовов, GPT-6 достигла лишь 0.545.
У разрыва в связях есть четкая причина. 75% пропусков GPT-6 приходилось на пары, которые она никогда не предлагала, а 81% ее ложных фактов относился к парам, не имеющим никакой связи. Чтение всего документа и определение того, какие пары связаны, — это как раз то, для чего создан проход маркера.
Скорость и стоимость. Мы замерили время обеих систем на одной и той же задаче:
- 60 сообщений пользователей из LongMemEval, каждое с предшествующим ему ходом диалога (медианное значение — 141 слово);
- схема памяти из 30 связей и 15 типов сущностей;
- одинаковый вывод от обеих систем: сущности и факты с их атрибутами.
На этой рабочей нагрузке среднее значение kniv примерно в 90 раз выше, чем у размещенного вызова, на процессоре ноутбука, без комиссий за API за каждое сообщение и без отправки данных за пределы машины.
Как проводилось сравнение: оценки GPT-6 получены в результате нашего состязания аннотаторов v6 с подсказками без обучения (zero-shot). Его лингвистические строки (часть речи, лемма, синтаксический анализ, NER, SRL) оценивались на выборках из 300 элементов для каждого тестового набора, а кореференция и отношения — на полных тестовых наборах. Оценки kniv получены на полных тестовых наборах во всех случаях, при этом для каждой задачи выбирается лучшая из двух моделей xlarge. Оценки отношений kniv используют пороговые значения, настроенные на разработческих данных. Метрики зависят от задачи: точность для части речи и леммы, оценки привязки для синтаксического анализа, F1 в остальных случаях.
Где происходят сбои
Руководство в каждом репозитории подробно описывает их вместе с обходными путями.
- Отношения на уровне документов уступают специализированным системам. Около 29% эталонных фактов упускаются, в основном это пограничные решения чуть ниже порога. Снижение смещений отношений меняет точность на полноту: вы найдете больше пропущенных фактов и больше ложных вместе с ними. Это не устраняет основное ограничение. Как показал раздел калибровки, даже пороговые значения, настроенные на тестовом наборе, добавляют не более одного пункта F1, поскольку остальные ошибки заключаются в том, какие пары связываются и как ранжируются отношения.
- Близкие по смыслу отношения путаются («расположено в» против «местонахождение штаб-квартиры»). Не включайте оба в одну схему. Объедините их на последующих этапах, если вам нужны оба.
- Факты обрабатываются для каждого окна размером до страницы текста. Ничего не связывается между окнами или документами; это задача вашего слоя памяти.
- Атрибуция разговора не идеальна. Местонахождение родственника может быть приписано и говорящему («моя сестра живет в Порту» может также закрепить Порту за пользователем). В UltraBERT «вы» в реплике ассистента может стать отдельной сущностью.
- Отрицание и чужая речь — самые слабые атрибуты. DeBERTa хорошо отделяет планы от утверждений («Я работаю в Acme. В следующем месяце я перехожу в Northstar» дает утвержденный факт и запланированный); UltraBERT пропускает план в этом примере. Но при наших собственных выборочных проверках «Я больше там не работаю» все еще может возвращаться как положительный факт, а фраза «Леон говорит, что я работаю в Northstar» помечается как утвержденная и принадлежащая говорящему, а не как пересказанная. Рассматривайте полярность и модальность как сигналы для проверки, а не как гарантии.
- Меньшие модели пропускают больше и выдают больше. Студенты возвращают больше фактов на сообщение, чем учителя, многие с низкими отступами, поэтому фильтруйте по отступу для обеспечения точности. tiny и small отстают от учителей на 4–17 пунктов по NER, SRL, кореференции, отношениям и типам сущностей, medium — на 2–13, и каждая карточка перечисляет свои пробелы.
- Только английский язык.
Что поставляется
- Шесть моделей, Apache-2.0: tiny, small, medium, large, xlarge-d и xlarge-u.
- Каждый репозиторий содержит: веса PyTorch; calibration.json; банк меток, содержащий 1 423 отношения и 1 559 типов сущностей с описаниями, в качестве отправных точек для вашей схемы; токенизатор; графы ONNX в форматах fp3v, FP16 и INT8; среду выполнения kniv_v7 с быстрым стартом; GUIDE.md, в котором описывается выбор между моделями, настройка пороговых значений и обход известных режимов сбоев.
- веса PyTorch;
- calibration.json;
- банк меток, содержащий 1 423 отношения и 1 559 типов сущностей с описаниями, в качестве отправных точек для вашей схемы;
- токенизатор;