TL;DR
- В недавней статье Sliding-window beats linear attention показано, что скользящее окно внимания (SWA) со стоками внимания не уступает большинству линеаризованных моделей или превосходит их.
- Опираясь на нашу работу по линеаризации внимания, мы провели чистое абляционное исследование, чтобы проверить это. Для коротких ответов наши результаты совпадают.
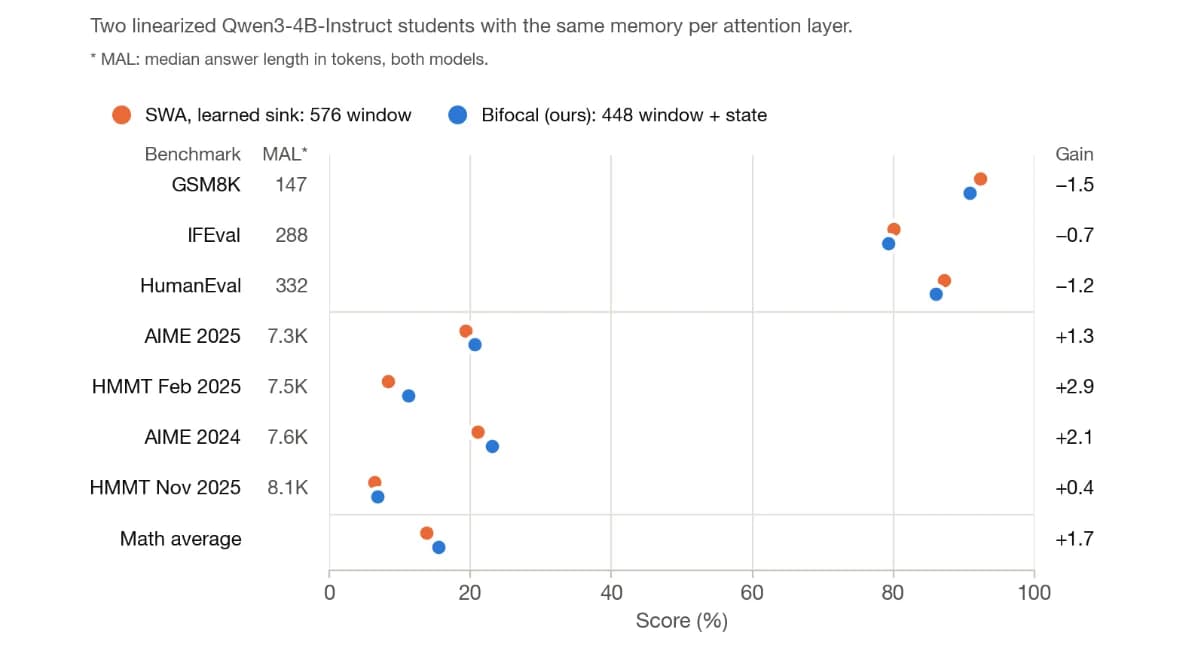
- Мы дистиллировали Qwen3-4B-Instruct в четыре студенческие модели с одинаковыми требованиями к памяти на один слой внимания: две SWA-модели (одна с обучаемыми стоками, другая со стоковыми токенами) и две модели с нашим слоем Bifocal, который тратит часть памяти на линейный микшер рядом со скользящим окном меньшего размера.
- На математических задачах, требующих длинных ответов (из AIME и HMMT), Bifocal решает почти в два раза больше задач, чем SWA. Тем не менее скользящее окно всё ещё имеет значение. Когда Bifocal отдаёт почти всю свою память линейному микшеру, результаты в математике резко падают.
- Слой Bifocal вычислительно дёшев. В модели размера Qwen3.5-4B, где Bifocal заменяет все слои внимания и GDN, наши совмещённые ядра (fused kernels) поддерживают декодирование со скоростью около 195 токенов/с для промптов до 128K токенов — так же быстро, как SWA в тех же условиях и с тем же объёмом памяти.
Узкое место KV-кэша
Трансформер сохраняет ключ (key) и значение (value) для каждого обработанного токена на каждом слое внимания. Этот KV-кэш растёт с каждым сгенерированным моделью токеном. Для Qwen3-4B каждый токен использует около 144 КиБ, поэтому для одного ответа длиной 10 000 токенов требуется около 1,4 ГиБ. В реальных условиях обслуживания (serving), когда одновременно обрабатывается несколько запросов, это может быстро превысить доступную память GPU. Модели с поддержкой рассуждений (reasoning models) постоянно генерируют ответы такой длины, поэтому KV-кэш становится узким местом.
Есть два способа сохранить фиксированный объём памяти: можно забывать старые токены и хранить только последние W токенов, что и делает скользящее окно внимания. Либо можно сжимать их в состояние фиксированного размера, как в линейном внимании и его гейтированных преемниках (Mamba, Gated DeltaNet (GDN), mLSTM).
Забывать или сжимать
Скользящее окно работает точно на последних W токенах и видит более старые токены лишь косвенно через предыдущие слои. При адаптации (retrofitting) предобученной модели SWA выходит из строя, как только начальные токены покидают окно, поскольку головки внимания используют их для сброса избыточной вероятностной массы. Решением является сток внимания (attention sink), предложенный в StreamingLLM, который закрепляет первые четыре токена в кэше. Однако сохранение этих начальных токенов усложняет управление кэшем и делает невозможным использование стандартных ядер для скользящего окна. Вместо этого мы используем обучаемый сток, как в gpt-oss, который представляет собой обучаемое смещение (bias) в знаменателе софтмакса каждой головки, поглощающее неиспользованное внимание без хранения дополнительных токенов в кэше. Эта идея восходит к работе Эвана Миллера Attention Is Off By One.
Линейный микшер сжимает все прошлые токены в состояние фиксированного размера. При линеаризации, когда предобученный трансформер преобразуется в более дешёвого «студента», один лишь линейный микшер работает плохо. Внимание модели-учителя сильно опирается на последние несколько сот токенов и требует их в полном разрешении. В нашей статье по дистилляции сочетание mLSTM со скользящим окном равномерно снизило кросс-энтропийные потери за счёт восстановления точного воспроизведения информации на коротких расстояниях. LoLCATs и другие методы линеаризации добавляют окно по той же причине.
Мы запускаем оба компонента — скользящее окно и линейный микшер — параллельно вместо каждого слоя внимания. LoLCATs уже дистиллировался в аналогичную структуру слоёв, и мы меняем две вещи:
- Наш линейный микшер — это mLSTM. Аргумент должен быть справедлив и для других современных линейных микшеров, таких как Mamba или GDN.
- Мы объединяем выходы двух компонентов с помощью зависящего от данных гейта для каждой головки: линейной проекции входа слоя в один активируемый сигмоидой скаляр o для каждой головки, который смешивает их как o · mLSTM + (1 − o) · SWA.
Мы называем этот слой Bifocal: подобно бифокальным очкам, он чётко видит то, что близко, и с меньшим разрешением то, что далеко. Но действительно ли нужна эта дополнительная сложность? Не лучше ли просто потратить память линейного микшера на большее скользящее окно?
Аргументы в пользу скользящих окон
В работе Sliding-window beats linear attention утверждается, что скользящего окна со стоками внимания достаточно самого по себе. Без какого-либо обучения окно в 64 токена с четырьмя стоковыми токенами восстанавливает 99% оценки учителя на шести стандартных бенчмарках. С окном в 512 токенов оно показывает лучший средний результат на GSM8K и HumanEval среди всех протестированных методов без обучения и линеаризованных методов, а также с большим отрывом превосходит адаптированные линейные модели в тестах «иголка в стоге сена» (needle-in-a-haystack) и BABILong.
Мы согласны с тем, что SWA со стоками внимания — это сильный и дешёвый базовый уровень (baseline), и каждая работа по линеаризации должна приводить его результаты. Однако три особенности в постановке эксперимента ограничивают применимость этого вывода:
- Большинство линейных моделей в сравнениях генерации и длинного контекста адаптировались на небольших бюджетах — от 20 до 600 миллионов токенов.
- «Длинный контекст» там означает длинные входные данные при коротких ответах. Ни один из бенчмарков не требует от модели написания длинного ответа.
- Значительная часть сравнения проводится на бенчмарках логарифмического правдоподобия (log-likelihood).
Последний пункт — это проблема для всей области. Многие статьи по линеаризации приводят результаты только для HellaSwag, WinoGrande, PIQA, ARC и MMLU. Эти бенчмарки оценивают несколько фиксированных вариантов ответов за один прямой проход (forward pass), и модель никогда не читает то, что написала сама. Если окно в 64 токена восстанавливает 99% на них, они не могут сказать, помнит ли модель что-либо из далекого прошлого.
Чтобы учесть все три пункта и следовать предложению авторов статьи о SWA сравнить дообученный SWA с линейной адаптацией при одинаковых бюджетах обучения, мы дистиллируем обе архитектуры с одинаковым бюджетом в 4 млрд токенов, выравниваем их память при инференсе и оцениваем их на бенчмарках, требующих генерации как коротких, так и длинных ответов.
Сравнение при одинаковом объёме памяти
Мы инициализируем всех «студентов» на основе Qwen3-4B-Instruct, заменяя все 36 его слоёв внимания. Модель использует внимание с группировкой запросов (grouped-query attention) с 32 головками запросов, разделяющими 8 головок ключей и значений.
Чтобы сопоставить память разных «студентов», мы выражаем состояние линейного микшера в эквивалентных токенах KV-кэша формата BF16. Без софтмакса линеаризованное внимание можно обучать в быстрой параллельной форме (как трансформер) и разворачивать при инференсе в рекуррентное состояние, накапливающее внешние произведения ключей и значений. Поскольку это рекуррентное состояние суммируется на протяжении тысяч шагов, его необходимо хранить в FP32, чтобы избежать численного дрейфа по сравнению с параллельной формой обучения. Таким образом, одно состояние mLSTM размером 128 × 128 занимает столько же памяти, сколько 128 закэшированных токенов головки ключей-значений в BF16. Поскольку на каждую головку ключей-значений приходится четыре головки запросов, значение имеет и то, где находятся состояния: хранение одного состояния на головку ключей-значений стоит 128 токенов окна на слой, тогда как хранение одного состояния на головку запросов стоит 512.
Это позволяет нам дать четырём «студентам» абсолютно одинаковый бюджет — память на 576 закэшированных токенов на слой:
- SWA, обучаемый сток: окно в 576 токенов с теми же обучаемыми стоками, что и у Bifocal.
- SWA + стоковые токены: окно в 572 токена плюс 4 стоковых токена StreamingLLM, как в статье про SWA.
- Bifocal: окно в 448 токенов плюс одно состояние на головку ключей-значений эквивалентом в 128 токенов и обучаемые стоки, не занимающие кэш.
- Bifocal, окно 64: окно из 64 токенов плюс одно состояние на голову запроса, что эквивалентно 512 токенам.
Все четыре студенческие модели дистиллированы с использованием одинаковых данных, рецепта и бюджета в 4,1 миллиарда токенов на последовательностях длиной до 40K токенов. Это делает студентов SWA гораздо более сильными базовыми моделями по сравнению с SWA без обучения, сохраняя все шансы научиться передавать информацию через 36 стековых окон (подробнее о том, насколько далеко на самом деле достигают стековые окна, см. ниже).
Наше основное сравнение — это SWA с обученным стоком против Bifocal: поскольку обученный скалярный сток на каждую голову требует пренебрежимо малой памяти, обе модели используют абсолютно одинаковый бюджет кэша и различаются только тем, как они его расходуют. Мы также обучили студента SWA с зафиксированными токенами стока, чтобы проверить, имеет ли значение тип стока — на математических бенчмарках (AIME и HMMT) это не так, оба варианта SWA показывают результат около 14%.
Само по себе скользящее окно отлично подходит для коротких ответов
Для коротких ответов большее окно работает так же хорошо, как и состояние, или даже чуть лучше. Студент SWA лидирует на всех трех коротких бенчмарках с отрывом от 0,7 до 1,5 балла. Когда длина ответов составляет всего несколько сотен токенов, промпт и ответ в основном и так помещаются в окно, поэтому модели редко приходится полагаться на сжатое состояние. Кроме того, SWA имеет преимущество при дистилляции, поскольку сохраняет архитектуру учителя, меняя лишь маску внимания и добавляя сток, в то время как Bifocal должен обучать новый линейный микшер и гейт. Таким образом, в этом режиме наши результаты согласуются со статьей по SWA.
Линейный микшер помогает при длинных ответах
Сложная математика — это другое. В задачах AIME и HMMT наши студенты генерируют около 7600 токенов на один ответ. На любом шаге окно охватывает лишь около 8% от этого объема. После нескольких сотен токенов рассуждений сам вопрос покидает пределы окна, а по мере роста ответа из него уходят и промежуточные результаты более ранних шагов. Состояние линейного микшера по-прежнему хранит сводку всего этого.
Bifocal лидирует на всех четырех математических бенчмарках, но с небольшим отрывом: в среднем 15,5% против 13,8%. Учитывая всего 120 задач, этот разрыв находится на грани статистической значимости. Картина становится намного яснее, если сгруппировать задачи по длине их ответов.
В задачах с короткими ответами обе модели решают около 59%. Из 96 задач с длинными ответами Bifocal решает в 1,8 раза больше, в то время как студент SWA с токенами стока не показывает лучших результатов. Рассматривая все индивидуальные генерации в целом, Bifocal выдает 66 правильных ответов длиннее 4000 токенов по сравнению всего с 26 у студента SWA. Длинные ответы — это область, где скользящее окно испытывает трудности, и где состояние приходит на помощь.
Разве стековые слои скользящего окна не могут заглядывать дальше? Довод в пользу чистого внимания со скользящим окном часто заключается в том, что каждый слой передает информацию дальше, поэтому L стековых окон размером W токенов могут заглядывать назад на L × W токенов, подобно стековым сверткам. Это было представлено Longformer в 2020 году и популяризировано Mistral 7B, где отмечалось, что 32 слоя с окнами по 4096 токенов обеспечивают «теоретическую область внимания примерно в 131K токенов». Для нашего студента SWA этот теоретический охват составляет 36 × 576 = 20 736 токенов — больше, чем 88% его ответов. На бумаге он все еще может видеть вопрос практически из любой точки своего ответа, но на практике он решает задачи с длинными ответами гораздо реже, чем Bifocal. Причина та же, что и для сверточных нейросетей (CNN), эффективное рецептивное поле которых составляет лишь малую часть от теоретического (Luo et al., 2016). В трансформере большая часть сигнала каждого токена остается на остаточном пути (residual path), и лишь доля передается через внимание в следующее окно. Гуансюань Сяо (shows) показал, что из-за этого влияние удаленного токена затухает примерно экспоненциально с количеством промежуточных окон, оставляя эффективный диапазон около 1,5 окон независимо от глубины. Линейному микшеру не нужна эта межслойная передача: рекуррентное состояние каждого слоя напрямую переносит более ранние токены вперед.
Разве стековые слои скользящего окна не могут заглядывать дальше?
Довод в пользу чистого внимания со скользящим окном часто заключается в том, что каждый слой передает информацию дальше, поэтому L стековых окон размером W токенов могут заглядывать назад на L × W токенов, подобно стековым сверткам. Это было представлено в 2020 году и популяризировано , где отмечалось, что 32 слоя с окнами по 4096 токенов обеспечивают «теоретическую область внимания примерно в 131K токенов».
Для нашего студента SWA этот теоретический охват составляет 36 × 576 = 20 736 токенов — больше, чем 88% его ответов. На бумаге он все еще может видеть вопрос практически из любой точки своего ответа, но на практике он решает задачи с длинными ответами гораздо реже, чем Bifocal.
Причина та же, что и для CNN, эффективное рецептивное поле которых составляет лишь малую часть от теоретического (). В трансформере большая часть сигнала каждого токена остается на остаточном пути, и лишь доля передается через внимание в следующее окно. Гуансюань Сяо () показал, что из-за этого влияние удаленного токена затухает примерно экспоненциально с количеством промежуточных окон, оставляя эффективный диапазон около 1,5 окон независимо от глубины. Линейному микшеру не нужна эта межслойная передача: рекуррентное состояние каждого слоя напрямую переносит более ранние токены вперед.
Одного линейного микшера тоже недостаточно
Если линейное состояние помогает при длинных ответах, возникает искушение потратить на него почти весь бюджет. Наш четвертый студент, Bifocal с окном 64, проверяет это, сохраняя состояние на каждую голову запроса (память объемом 512 токенов) наряду с крошечным окном в 64 токена. Вместо улучшения долгосрочных рассуждений модель деградирует, набирая всего 4,2% в математике (против 15,5% у Bifocal) и резко проседая также и на бенчмарках с короткими ответами. Точное извлечение информации из недавнего прошлого по-прежнему имеет решающее значение, а сжатое состояние размывает эту информацию.
Это также подчеркивает практический урок для внимания с группированными запросами (GQA): поскольку на каждую голову ключа-значения приходится четыре головы запроса, добавление состояний к головам запроса требует в четыре раза больше памяти, напрямую обделяя скользящее окно (64 токена вместо 448).
Какова стоимость линейного микшера?
Если объем памяти сбалансирован по проекту, то как насчет скорости? Мы провели бенчмаркинг декодирования в vLLM на архитектуре Qwen3.5-4B, заменив все слои внимания и GDN на SWA или Bifocal с бюджетом 576 токенов на слой. (Головы ключа-значения в Qwen3.5 шире, поэтому состояние стоит дороже, и Bifocal получает окно в 320 токенов.) Для сравнения мы также запустили полное внимание и родную гибридную компоновку Qwen3.5 (GDN + внимание, которая сопрягает три слоя GDN с каждым слоем полного внимания).
Во время декодирования Bifocal работает так же быстро, как и чистое SWA. При замене всех слоев внимания и GDN обе модели стабильно удерживают скорость около 195 токенов/с в диапазоне от 1K до 128K токенов промпта, отклоняясь друг от друга не более чем на 2% на любой длине. Между тем, гибрид GDN + внимание замедляется до 146 токенов/с при длине 128K по мере роста кэша полного внимания с увеличением контекста, а полное внимание падает до 92 токенов/с.
Где линейный миксер действительно требует времени, так это при обработке промпта (префилле): Bifocal обрабатывает промпты со скоростью 63–83% от скорости SWA, требуя 1,8 с вместо 1,5 с перед генерацией первого токена промпта длиной 128K. Однако для задач рассуждения в длинном формате, где генерация ответа длиной 10 000 токенов занимает почти минуту, эти дополнительные 0,3 с на промпт несущественны.
Основные выводы
- SWA с токенами-стоками (sinks) — это сильный, дешевый базис, о котором стоит упомянуть. При коротких ответах ничто в наших тестах не превосходит его при равном объеме памяти.
- Сравнивайте при равном объеме памяти. Состояние линейного миксера также занимает память: учитывайте ее в эквивалентных токенах кэша KV и помните о группированном внимании (grouped-query attention) при решении вопроса о том, разделяются ли состояния между головами запросов.
- Оценивайте на длинных генерациях и анализируйте их в зависимости от длины. Бенчмарки на основе логарифмического правдоподобия и короткие ответы не позволяют различить эти архитектуры, а усреднение по всем задачам скрывает, где именно помогает состояние.
- Используйте оба подхода. Окно само по себе исчерпывает себя на длинных ответах; линейный миксер сам по себе размывает недавнее прошлое. Bifocal объединяет их при том же объеме памяти и той же скорости декодирования.
Подробнее о рецепте дистилляции читайте в нашей статье: Effective Distillation to Hybrid xLSTM Architectures.
Детали
- Модели. Учитель (Teacher): Qwen3-4B-Instruct-2507. Все четыре ученика (students) заменяют каждый слой внимания (36 слоев). SWA с обученным стоком: скользящее окно на 576 токенов с обученным скалярным стоком для каждой головы. SWA + токены-стоки: скользящее окно на 572 токена плюс первые 4 токена последовательности. Bifocal: окно на 448 токенов с обученным скалярным стоком для каждой головы, а также mLSTM с одним состоянием на каждую голову ключа-значения (8 состояний 128 × 128 на слой, FP32), объединяемые с помощью зависящего от данных гейта для каждой головы. Bifocal, окно 64: то же самое, с окном на 64 токена и одним состоянием на голову запроса (32 состояния на слой).
- Учет памяти. На один слой один закэшированный токен занимает 8 голов ключа-значения × 128 размерностей × ключ и значение × 2 байта = 4 КиБ. Одно состояние FP32 занимает 64 КиБ, поэтому 8 состояний эквивалентны 128 токенам, а 32 состояния — 512. Нормализующие векторы mLSTM добавляют менее 1% и не учитываются.
- Дистилляция. Выравнивание скрытых состояний по слоям (2500 шагов, 819 млн токенов), затем дистилляция логитов с потерей только на основе KL-дивергенции (10 000 шагов, 3,28 млрд токенов) на последовательностях длиной до 40 960 токенов. Одинаково для всех четырех учеников.
- Данные. Общая смесь Nemotron: 40% чат и инструкции, 20% код, 20% математика, 15% естественные науки, 5% безопасность.
- Оценка. AIME 2024 и 2025, HMMT, февраль и ноябрь 2025 года: по 30 задач, 16 сэмплов на задачу, до 31 744 новых токенов, температура 0.6, top-p 0.95, top-k 20, метрика pass@1 усреднена по сэмплам. В математических бенчмарках 24% генераций Bifocal и 12% ученика SWA достигли этого лимита, в основном повторяя финальный ответ, который они уже написали. Эти ответы почти всегда неверны: если засчитать те немногие, которые содержат правильный ответ, это добавило бы 0,4 и 0,1 балла. GSM8K: 5-shot, точное совпадение (exact match), жадное декодирование. IFEval: строгая точность промптов, жадное декодирование. HumanEval (instruct): pass@1, жадное декодирование. Длины ответов перетокенизируются из сохраненного текста с помощью токенизатора учителя.
- Статистика. Доверительные интервалы получены методом парной бутстрэп-выборки по задачам с 20 000 повторных выборок. Для прироста Bifocal по среднему результату в математике 95% интервал составляет от 0,0 до 3,4 балла. Для 96 задач с длинными ответами он составляет от 0,7 до 3,3 балла. При группировке по длине ответа типичная длина каждой задачи представляет собой медиану по всем 32 ответам двух основных учеников. Подсчеты для каждого ответа оценивают каждый ответ по точному совпадению с эталонным ответом, что совпадает с оценками по задачам в 472 из 480 пар «задача — ученик».
- Что мы опустили. Для ученика SWA с токенами-стоками мы приводим результаты только по математике. Наш код оценки для токенов-стоков некорректно обрабатывает промпты длиннее кэша: на GSM8K, где 5-shot промпты имеют длину от 700 до 870 токенов, этот ученик отвечал на один из примеров вопросов вместо тестового вопроса в 14% задач по сравнению с 1–2% у других учеников. Математические промпты имеют длину менее 200 токенов. Ограничение в 3,072 токена в GPQA Diamond отсекло от 37% до 53% ответов, поэтому этот тест в основном измеряет то, кто успевает завершить работу вовремя.
- Скорость. vLLM 0.28 на одном H100 80 GB, размер батча 1, синтетические веса с конфигурацией Qwen3.5-4B: 32 слоя, 16 голов запросов и 4 головы ключа-значения с размерностью головы 256. SWA и Bifocal заменяют все 32 слоя внимания и GDN; MLP остаются без изменений. Каждый запрос считывает промпт длиной от 1K до 128K токенов, а затем генерирует 256 токенов; мы указываем медиану по пяти запросам. SWA: окно на 576 токенов с обученным скалярным стоком для каждой головы (FlashAttention-3). Bifocal: окно на 320 токенов с теми же стоками, плюс одно состояние mLSTM 256 × 256 FP32 на каждую голову ключа-значения, со слитными ядрами Triton (fused kernels) для декодирования и префилла. На один слой закэшированный токен занимает 4 КиБ, а состояние — 256 КиБ, поэтому оба вмещают объем, эквивалентный 2,25 МиБ, или 576 токенам, то есть 72 МиБ на модель. GDN + внимание и модель с полным вниманием запускались ранее на другом H100 с теми же версиями программного обеспечения; недавний запуск GDN + внимание на том же GPU, что и SWA с Bifocal, показал совпадение в пределах 0,2 токена/с на 8K и 128K. Параметры: 3,74 млрд (SWA), 3,78 млрд (Bifocal), 4,21 млрд (GDN + внимание).
Благодарности
Мы выражаем признательность совместному предприятию EuroHPC за предоставление доступа к суперкомпьютерам Leonardo в CINECA, Италия, LUMI в CSC, Финляндия, и Arrhenius в NAISS, Швеция.
Также опубликовано на iondy.com.