Результаты SuperCLUE, опубликованные 5 ноября 2026 года, показывают, почему при выборе моделей полезно ориентироваться на показатели в отдельных категориях. GPT-6.1-Sol имеет самые высокие отображаемые баллы в агентском программировании, а также в математических и научных рассуждениях, в то время как Gemini-4-Argon лидирует по контролю галлюцинаций и поддержке сверхдлинного контекста. Они разделяют первое место по точному следованию инструкциям.
Среди моделей, помеченных в источнике как открытые, лидеры различаются в зависимости от задачи: DeepSeek-V4.1-Flash-1017 лидирует в программировании, Darwin-180B-RSI-R3 — в математических и научных рассуждениях, а Kimi-K3.1-Pro — в трех остальных категориях. Kimi также имеет самый высокий общий балл среди этих открытых моделей, занимая третье место среди всех 19 участников и № 1 в нумерованном рейтинге SuperCLUE.
В таблице лидеров все 19 моделей представлены в порядке убывания общего балла, включая международные модели. Darwin занимает девятое место в общем зачете по баллам и первое среди открытых моделей в категории математических и научных рассуждений. В этой статье рассматриваются пять категорий, после чего они сводятся в единую общую таблицу.
Область применения и интерпретация
Опубликованная таблица содержит 19 моделей: 12 с меткой «открытая» и семь с меткой «закрытая». Здесь «общий лидер» означает модель с наивысшим отображаемым баллом среди этих 19 моделей, а «лидер среди открытых моделей» — наивысший балл среди 12 моделей с соответствующей меткой. Ни один из этих терминов не подразумевает рейтинг всех моделей, доступных по всему миру.
Метки открытых/закрытых моделей соответствуют классификации SuperCLUE. Они не являются независимой оценкой условий лицензирования, раскрытия тренировочных данных, доступности кода или права на коммерческое использование. Для развертывания проверяйте репозиторий, карточку модели, лицензию и условия использования каждой модели отдельно.
SuperCLUE использует отдельную политику для нумерованной колонки рангов: «Международные модели и некоторые отечественные модели исключены из рейтинга и показаны только для справки». Таким образом, международные модели за пределами Китая исключены из нумерованного рейтинга как класс. Именно поэтому у Gemini, GPT, Grok и Darwin в этой колонке стоит прочерк; это конвенция политики ранжирования, а не оценка производительности или пропущенный тест. Их опубликованные баллы по-прежнему определяют их положение в таблице по убыванию.
Разница очевидна: Gemini занимает первое место по общему баллу, GPT — второе, Kimi — третье, а Darwin — девятое среди 19 оцениваемых участников. Цифра «1» в колонке рангов источника относится к нумерованному рейтингу SuperCLUE, определяемому его политикой. Источник также объединяет модели с разницей в один балл в группы с одинаковыми рангами. Все сравнения категорий в этой статье включают международные модели на тех же условиях, что и другие оцениваемые модели.
Лидеры по категориям с первого взгляда
Лидеры по категориям выбираются из всех 19 моделей, включая 12 моделей с меткой «открытая». Баллы и разница указаны в баллах бенчмарка.
1. Агентское программирование: DeepSeek сравнивается с Gemini по отображаемому баллу
GPT-6.1-Sol лидирует с 69,23 балла; DeepSeek-V4.1-Flash-1017 является лидером среди открытых моделей с 65,38 балла.
DeepSeek идет наравне с Gemini и отстает от GPT на 3,85 балла. Она опережает следующую по результативности открытую модель, Kimi, на 7,69 балла. Это делает DeepSeek подходящим кандидатом для оценки, ориентированной на программирование, несмотря на то, что у Kimi выше общий балл.
Это изменение приоритетов важно: позиция модели в совокупном бенчмарке не обязательно совпадает с ее позицией в решении задачи, которая реально нужна разработчику. GLM-5.3 предоставляет еще одну точку для сравнения среди открытых моделей с баллом за программирование 53,85.
Для развертывания с упором на программирование полезно дополнительно сравнить модели на одних и тех же репозиториях, тестах, разрешениях на инструменты и бюджетах повторных попыток, измеряя правильность и стоимость выполнения. Генерацию кода в один шаг и многошаговое использование инструментов следует оценивать раздельно.
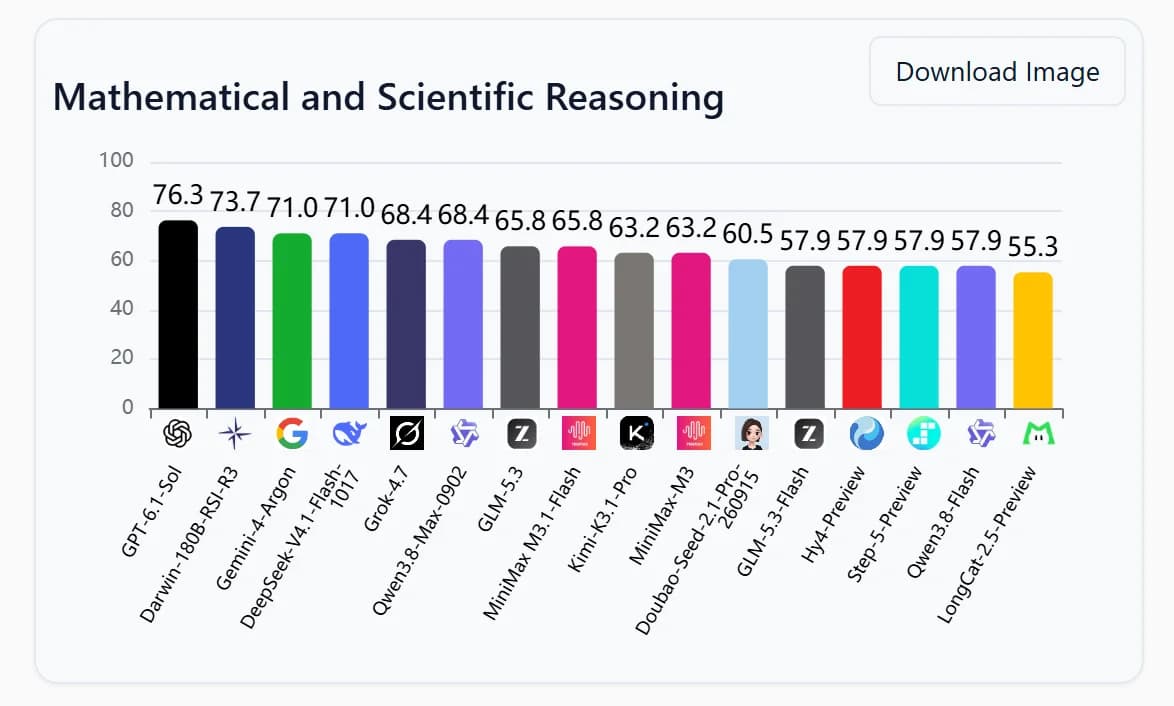
2. Математические и научные рассуждения: Darwin лидирует среди открытых моделей
GPT-6.1-Sol лидирует с 76,32 балла; Darwin-180B-RSI-R3 занимает второе место среди всех 19 моделей и первое среди открытых моделей с 73,68 балла.
Показаны все модели, разделившие наименьший включенный балл в таблице.
Darwin на 2,64 балла ниже GPT и на 2,63 балла выше Gemini и DeepSeek. Математические и научные рассуждения — это самая сильная сторона Darwin в данной оценке: она превосходит любую другую открытую модель в этой категории и все закрытые модели, кроме GPT.
Другие результаты подчеркивают ценность анализа на уровне категорий. Spark-X2.6 набирает 68,42 балла в рассуждениях, но 26,92 в программировании и 12,07 в точном следовании инструкциям. Высокая производительность в одном тесте не переносится автоматически на другие. Эти показатели также не следует делить для выражения соотношений базовых способностей: в категориях могут быть разные распределения задач и методы подсчета баллов.
Полезные дополнительные тесты позволили бы отделить математику от естественных наук, оценить правильность окончательного ответа наряду с обоснованностью рассуждений, а также контролировать бюджеты токенов вывода и доступ к инструментам.
3. Контроль галлюцинаций: Gemini лидирует, а Kimi опережает остальные открытые модели
Gemini-4-Argon лидирует с 83,19 балла; Kimi-K3.1-Pro является лидером среди открытых моделей с 67,78 балла.
Gemini опережает Kimi на 15,41 балла. Kimi набирает на 4,17 балла больше, чем GPT, и на 18,89 балла больше, чем следующая за ней открытая модель GLM-5.3-Flash.
Внутри семейства GLM показатель Flash (48,89) превышает показатель GLM-5.3 (43,61), несмотря на то, что у GLM-5.3 общий балл выше. Таким образом, наименование моделей и их совокупное место в рейтинге не являются достаточными ориентирами для оценки производительности в этой категории.
Эти баллы не являются частотой галлюцинаций. Оценку 83,19 нельзя конвертировать ни в 83,19% частоты галлюцинаций, ни в 16,81% частоты ошибок. Без определений задач и протокола оценки ее также нельзя перевести в частоту фактических ошибок для развернутого сервиса.
Для задач вопрос-ответ по документам или генерации с привлечением внешних данных (RAG) последующая оценка должна различать обоснованные ответы, уместный отказ от ответа при отсутствии доказательств и исправление ложных предпосылок. Система, которая избегает ошибок, отклоняя практически каждый вопрос, все равно может оказаться бесполезной. Важны как качество ответов, так и поведение при отказе.
4. Точное следование инструкциям: разделенное лидерство Gemini и GPT
Gemini-4-Argon и GPT-6.1-Sol делят наивысший балл (68,97); Kimi-K3.1-Pro лидирует среди открытых моделей с 44,83 балла.
Разница между самым высоким отображаемым баллом и лидером среди открытых моделей составляет 24,14 балла — это самая большая числовая разница такого рода среди пяти категорий. Поскольку сложность категорий и система оценивания могут различаться, это не следует интерпретировать как самый большой разрыв в реальных возможностях.
Kimi и DeepSeek относительно близки, их разделяет 1,73 балла. Выбор между ними требует тестирования ограничений предполагаемого рабочего процесса, а не восприятия этой разницы как решающей.
GLM-5.3 иллюстрирует еще одно различие: она набирает 53,85 балла в программировании и 77,60 в сверхдлинном контексте, но 17,24 в точном следовании инструкциям. Обработка сложных входных данных и соблюдение детальных ограничений к выводу требуют раздельной проверки.
Для автоматизации полезными тестами являются проверка на соответствие JSON-схеме, наличие обязательных полей, отсутствие нежелательного пояснительного текста и одновременное выполнение нескольких ограничений. Это предлагаемые дополнительные тесты, а не верифицированное описание набора задач SuperCLUE. Соответствие формату также следует оценивать независимо от фактической точности.
5. Сверхдлинный контекст: Gemini лидирует, Kimi близка к GPT
Gemini-4-Argon лидирует с результатом 95,63; Kimi-K3.1-Pro является лидером среди открытых моделей с результатом 87,25.
Gemini опережает GPT на 7,49 балла, а Kimi — на 8,38. Разница между GPT и Kimi составляет всего 0,89 балла. Этот небольшой разрыв делает Kimi особенно актуальной для сравнения с GPT в задачах с длинным контекстом, где для выбора между ними требуется тестирование на конкретных рабочих нагрузках.
Среди открытых моделей Kimi опережает GLM-5.3 на 9,65 балла, а GLM-5.3 опережает DeepSeek на 11,35. Таким образом, преимущество DeepSeek в программировании не распространяется на эту категорию. Шорт-листы для рабочих процессов, ориентированных на код и длинные документы, могут обоснованно различаться.
Оценка бенчмарка для длинного контекста не определяет максимальное окно контекста, поддерживаемое моделью. Прием большого объема входных данных отличается от надежного поиска информации в середине текста или установления связей между доказательствами в нескольких документах.
Тесты при развертывании должны варьировать длину входных данных, расположение доказательств и объем отвлекающего материала, одновременно измеряя качество извлечения, суммаризации и рассуждений по нескольким документам. Время до получения первого токена, требования к памяти и стоимость при ожидаемом объеме запросов также требуют отдельного измерения.
Применение результатов к реальным рабочим нагрузкам
Результаты по категориям предоставляют практическую отправную точку для выбора модели. DeepSeek подходит для шорт-листа по программированию, Darwin — для шорт-листа по математическим и научным рассуждениям, а Kimi — для шорт-листов по контролю галлюцинаций, следованию инструкциям и работе с длинным контекстом среди открытых моделей.
Для развертывания подтвердите эти сильные стороны на целевом языке и задачах, используя согласованные промпты, бюджеты на инференс и доступ к инструментам. Зафиксируйте точную версию модели, движок инференса, числовую точность и оборудование, а затем измерьте правильность наряду с задержкой, использованием памяти и стоимостью. Результаты бенчмарков, ориентированных на китайский язык, следует тестировать отдельно для корейского или других языков развертывания.
Опубликованные баллы являются результатами бенчмарка, а не статистическими гарантиями. Подробные определения задач, настройки оценки, доверительные интервалы и формула совокупного взвешивания не были проверены для этой статьи. В частности, общий балл следует считывать непосредственно из источника, а не реконструировать как простое среднее значение по пяти категориям.
Все 19 моделей в порядке убывания общего балла
Таблица ниже следует порядку убывания общего балла из источника. «Общая позиция по баллу» показывает место каждой модели среди всех 19 участников. Отдельный столбец с нумерованным рангом сохраняет ранги, определенные политикой SuperCLUE, включая ничьи и прочерки для международных участников.
Gemini занимает первое место по общему баллу с 73,62, за ней следуют GPT с 71,76 и Kimi с 61,46. Kimi — самая высокооценимая открытая модель, опережающая DeepSeek (58,95) на 2,51 балла, и занимающая 1-е место в нумерованном рейтинге источника.
Kimi лидирует среди открытых моделей в трех категориях; DeepSeek лидирует в программировании, а также получает высокие оценки в рассуждениях. Эти профили помогают определить кандидатов для различных рабочих нагрузок. Однако без формулы агрегации вклад каждой категории в общий балл не может быть количественно определен.
Darwin занимает девятое место в общем зачете с 43,08 балла, между Qwen3.8-Max-0902 (43,22) и Hy4-Preview (42,96). Эти близкие баллы иллюстрируют разницу между позициями по убыванию балла и сгруппированными нумерованными рангами источника: Qwen и Hy4 делят 5-е место, в то время как четыре модели с результатами от 42,06 до 41,17 делят 6-е место.
Заключение
Ноябрьские результаты способствуют прочтению, ориентированному на конкретные задачи. GPT лидирует в представленных оценках по программированию и рассуждениям; Gemini лидирует в контроле галлюцинаций и сверхдлинном контексте; а в точном следовании инструкциям они идут вровень. Среди моделей, помеченных как открытые, DeepSeek лидирует в программировании, Darwin — в рассуждениях, а Kimi лидирует в остальных трех категориях, а также в сравнении по общему баллу.
Эти результаты являются отправной точкой для оценки, а не универсальной рекомендацией по развертыванию. Следующим шагом является тестирование соответствующих языков и реальных рабочих нагрузок в согласованных условиях, измеряя правильность наряду со стоимостью и задержкой.
Darwin-180B-RSI-R3 от VIDRAFT — единственная модель от корейского разработчика среди этих 19 участников. Она занимает девятое место в общем зачете с 43,08 балла, второе место в математических и научных рассуждениях с 73,68 балла и первое место среди открытых моделей в этой категории рассуждений. Таким образом, ее самый сильный результат очевиден: открытая модель, разработанная в Корее, находится в числе лидеров этой оценки в области математических и научных рассуждений.
Источники
- Официальный сайт SuperCLUE: результаты опубликованы 5 ноября 2026 года, руководство по ранжированию. Живая страница может измениться после этого снимка.
- SuperCLUE November 2026 official Excel data: названия моделей, организации, классификации открытых/закрытых моделей, общие и категориальные баллы, официальные ранги. Числовые значения в этой статье отображаются с двумя знаками после запятой.