Большинство корпоративных развертываний NoSQL достигают точки, когда исходная архитектура начинает работать против команды. Со временем накладные расходы на инфраструктуру растут, шаблоны запросов перерастают исходную модель данных, инициативы в области ИИ требуют второй базы данных для векторов, а расходы на облако становится трудно прогнозировать. В этот момент команды часто начинают задумываться о том, может ли модернизация архитектуры базы данных упростить операции, поддержать новые рабочие нагрузки и контролировать расходы.
В этой статье сравниваются Couchbase Capella, MongoDB Atlas, Amazon DynamoDB и NoSQL с самостоятельным хостингом по факторам, которые оказывают наибольшее влияние на эксплуатационный опыт, включая модель управления, возможности запросов, поведение при масштабировании, готовность к ИИ, ценообразование и путь миграции. Цель состоит в том, чтобы предоставить точное и подробное сравнение операционных моделей, чтобы ваша корпоративная команда могла принять обоснованное решение.
Что такое облачная база данных?
Облачная база данных — это база данных, которая работает на облачной инфраструктуре, а не на оборудовании, управляемом организацией, которая ее использует. Этот термин охватывает широкий спектр моделей управления, и этот спектр имеет значение при оценке вариантов.
На одном конце находится самостоятельный хостинг на облачной инфраструктуре: организация запускает собственное программное обеспечение базы данных, такое как MongoDB Community, Couchbase Server или Cassandra, на виртуальных машинах в AWS, Microsoft Azure или Google Cloud. Облачный провайдер предоставляет базовые вычислительные ресурсы и хранилище, но организация остается ответственной за управление базой данных, включая подготовку, исправление ошибок, обновления, резервное копирование, масштабирование и восстановление.
Посередине находятся управляемые сервисы: облачный провайдер или поставщик базы данных берет на себя некоторые операционные задачи, такие как автоматическое резервное копирование, базовый мониторинг и управляемые обновления, в то время как организация сохраняет контроль над конфигурацией, решениями по масштабированию и топологией кластера.
На другом конце находится полностью управляемая DBaaS (база данных как услуга): поставщик берет на себя весь операционный уровень. Команда взаимодействует с базой данных через API и интерфейсы запросов. Поставщик занимается подготовкой, исправлением ошибок, масштабированием, репликацией, резервным копированием и восстановлением после сбоев. Организация платит за потребляемые возможности, а не за управляемую инфраструктуру.
Облачная платформа данных расширяет концепцию DBaaS, охватывая несколько сервисов данных в одном управляемом слое, включая операционное хранилище, поиск, кэширование, извлечение векторов, аналитику и синхронизацию. Отличие от DBaaS с одним сервисом имеет значение при оценке готовности к ИИ, поскольку приложениям ИИ обычно требуется более одного из этих сервисов, а фрагментированная платформа увеличивает как затраты, так и накладные расходы на интеграцию.
Что меняется при переходе на управляемую операционную модель
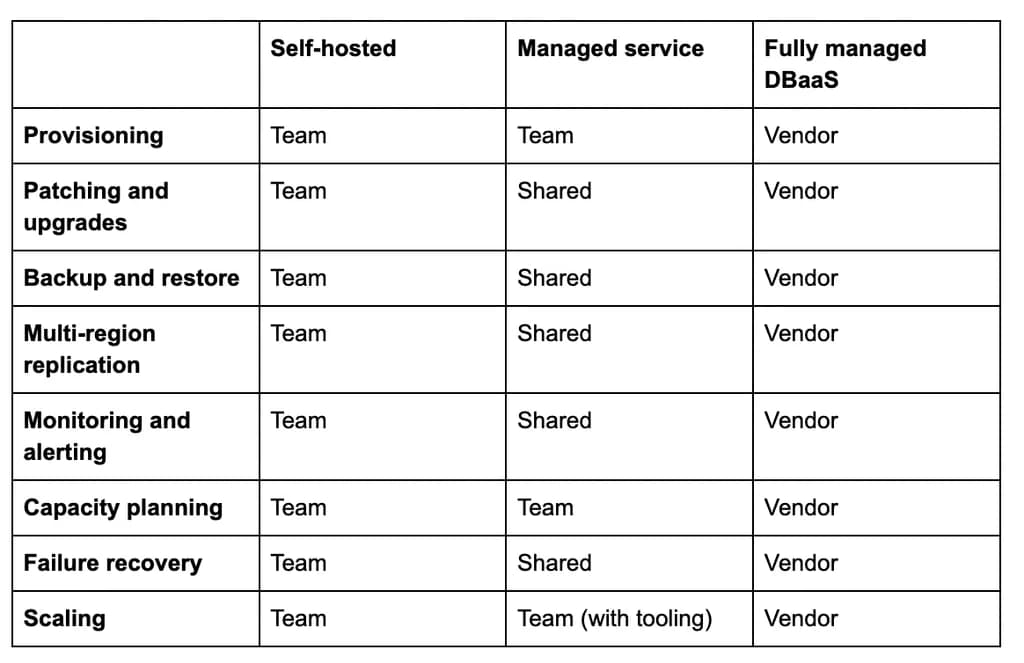
Практическая разница между NoSQL с самостоятельным хостингом и полностью управляемой DBaaS заключается не в программном обеспечении. А в том, кто владеет операционной областью.
Вот как операционные задачи переходят от инженерной команды на каждом этапе спектра управления:
Различия становятся более очевидными, если посмотреть на операционные модели на практике. Например, компания по разработке онлайн-игр Nexon использует Capella DBaaS для поддержки игровых операций для своей глобальной базы игроков. До появления Capella расширение с развертыванием на собственном хостинге обычно требовало нескольких дней планирования мощностей, подготовки, настройки репликации и проверки. С Capella команда Nexon теперь может настроить новый регион всего за 20 минут.
Дело не в том, что у Capella есть какая-то особенная функция, которой нет у баз данных на собственном хостинге. Дело в том, что управляемая модель меняет объем базовой инфраструктуры, которую команда базы данных должна эксплуатировать самостоятельно. Команды отказываются от части контроля, который дает прямое управление инфраструктурой, но они также берут на себя гораздо меньше повседневной операционной работы. Для организаций, запускающих как ИИ, так и операционные рабочие нагрузки в масштабе, этот компромисс может сделать управляемую модель все более привлекательной.
Как оценить облачную базу данных
Выбор облачной базы данных — это не столько подсчет функций, сколько понимание того, как база данных будет работать в вашей среде. Ключевые вопросы включают в себя то, какой объем инфраструктуры должна поддерживать ваша команда, насколько легко база данных адаптируется к изменению рабочих нагрузок, насколько хорошо она поддерживает новые варианты использования, такие как ИИ, и что эти варианты означают для затрат и усилий по миграции.
Следующие восемь критериев предоставляют практическую основу для сравнения вариантов облачных баз данных.
Гибкость модели данных: поддерживает ли база данных эволюцию схемы «на лету» или шаблоны доступа должны быть зафиксированы на этапе проектирования? Документные базы данных позволяют разным документам в одной коллекции иметь разные поля. Базы данных «ключ-значение» и с широкими столбцами требуют более жесткого предварительного моделирования. Узнайте больше о подходе Couchbase к моделированию данных.
Возможности запросов: поддерживает ли база данных декларативные запросы в стиле SQL, которые не были предусмотрены при проектировании схемы? Или требуются проприетарные API запросов, которые ограничивают гибкость аналитики и отчетности? SQL++ — это надмножество SQL, которое работает нативно с JSON, поддерживая соединения, агрегации, полнотекстовый поиск и векторный поиск в одном языке запросов.
Модель согласованности и производительности: является ли база данных ориентированной на память (горячие данные обслуживаются из оперативной памяти) или на диск? Архитектуры, ориентированные на память, обеспечивают стабильную задержку чтения менее миллисекунды без отдельного уровня кэширования. Архитектуры, ориентированные на диск, могут потребовать настройки кэша для достижения сопоставимой производительности. См. документацию по архитектуре Couchbase.
Модель масштабирования: масштабирует ли база данных отдельные сервисы (запросы, индексы, данные) независимо, или добавление любой мощности требует равномерного масштабирования всех сервисов? Независимое масштабирование сервисов позволяет командам добавлять мощность именно там, где этого требуют рабочие нагрузки. Узнайте о модели масштабирования Capella.
Мультирегиональный и периферийный охват: распространяется ли платформа на мобильные и периферийные развертывания на том же движке? Репликация между центрами обработки данных и синхронизация на периферии определяют, подходит ли платформа для распределенных и полевых приложений. См. Couchbase Mobile и XDCR.
Готовность к ИИ: включает ли база данных нативный векторный поиск или для ИИ требуется вторая база данных? Добавление отдельного векторного хранилища создает накладные расходы на синхронизацию, риск нарушения согласованности и дополнительный сервис для эксплуатации. Узнайте о векторном поиске Couchbase.
Прогнозируемость ценообразования: масштабируется ли модель ценообразования линейно с рабочей нагрузкой или создает неожиданные расходы при всплесках или шаблонах с интенсивным сканированием? Ценообразование Couchbase Capella рассчитывается за узел в час, что делает расходы предсказуемыми по мере роста развертываний.
Привязка к поставщику: предлагает ли поставщик путь самостоятельного управления на том же движке? База данных, которая работает только как управляемый сервис, создает «дверь в одну сторону». Платформа, где управляемые и самостоятельно управляемые варианты используют один и тот же движок, сохраняет гибкость. Couchbase Server — это версия с самостоятельным управлением того же движка, на котором работает Capella.
Capella против MongoDB Atlas
MongoDB Atlas — это наиболее широко используемый управляемый сервис NoSQL, и это база данных, с которой чаще всего сравнивают Couchbase Capella. Вот прямое сравнение:
В чем заключаются существенные преимущества Capella
Язык запросов: SQL++ от Couchbase — это полноценный суперсет SQL, поэтому имеющиеся у вашей команды знания SQL применяются напрямую. Запросы, сочетающие в себе извлечение документов, агрегацию, полнотекстовый поиск и векторное сходство, выполняются в рамках одного оператора без объединения на стороне приложения.
Язык запросов MongoDB (MQL) ориентирован на документы и нативен для JSON, но это не SQL. Командам, мигрирующим с реляционных баз данных или поддерживающим аналитиков, знающих SQL, приходится сталкиваться с ощутимой кривой обучения.
Архитектура с приоритетом памяти и встроенным кэшированием: хранилище Capella с приоритетом памяти по умолчанию обслуживает «горячие» данные из оперативной памяти, обеспечивая стабильную задержку чтения менее миллисекунды.
Приложениям в MongoDB Atlas, которым требуется чтение с низким уровнем задержки, обычно требуется дополнительный слой Amazon ElastiCache или Redis. Couchbase исключает этот уровень, поэтому с Capella кэширование является частью архитектуры, а не надстройкой. Тестирование Altoros показало, что Couchbase обеспечивает значительно более высокую пропускную способность и меньшую задержку по сравнению с MongoDB при сопоставимых рабочих нагрузках.
Многомерное масштабирование: Capella позволяет независимо масштабировать службы данных, запросов и индексов. Например, для рабочей нагрузки с интенсивными запросами можно добавить узлы запросов без добавления узлов данных.
MongoDB Atlas масштабируется единообразно, поэтому добавление емкости в одном измерении добавляет ее во всех. Это менее эффективно и дороже для рабочих нагрузок с неравномерным спросом на службы.
Мобильная среда и периферийные вычисления: Couchbase Lite предоставляет встроенную NoSQL-базу данных для iOS, Android и JavaScript с тем же языком запросов SQL++ и автоматической синхронизацией с Capella через Couchbase Mobile. Все находится на одной платформе, и дополнительных взаимоотношений с поставщиками не требуется.
MongoDB прекратила поддержку своей мобильной базы данных Realm, и поддержка завершится в сентябре 2025 года. Командам, использующим Atlas с мобильными приложениями на базе Realm, требуется новое решение для мобильной синхронизации.
В чем заключаются реальные преимущества Atlas
Atlas обладает значительно более зрелой экосистемой с большим количеством сторонних интеграций, большим количеством ресурсов сообщества и большим числом разработчиков, имеющих соответствующий опыт. Atlas Search — это функциональная реализация полнотекстового поиска. Для команд, где существующий опыт работы с MongoDB является ограничением, освоение Capella требует реальных усилий, даже если SQL++ снижает этот барьер по сравнению с полностью проприетарным языком запросов.
Capella против Amazon DynamoDB
DynamoDB и Capella обслуживают разные основные сценарии использования, поэтому данное сравнение больше касается соответствия рабочей нагрузке, а не паритета функций.
Жесткость шаблонов доступа
SQL++ в Capella позволяет выполнять запросы, которые не были предусмотрены на этапе проектирования схемы. Аналитик может написать нерегулярный (ad hoc) запрос агрегации, разработчик — добавить новый индекс без редизайна модели данных, а система отчетности — выполнять соединение (join) коллекций без сборки на стороне приложения. Для приложений, где шаблоны доступа развиваются (как в большинстве корпоративных систем), эта гибкость имеет материальную ценность.
DynamoDB требует знания и моделирования шаблонов доступа на этапе проектирования. Данные организуются вокруг ключей разделения (partition keys) и ключей сортировки (sort keys), а глобальные вторичные индексы (Global Secondary Indexes) необходимо определять до записи данных. Запросы вне определенной структуры ключей либо невозможны, либо требуют дорогостоящего сканирования таблиц. Для приложений со стабильными, прогнозируемыми шаблонами доступа при высокой масштабируемости этот компромисс разумен ради простоты.
Модель затрат при переменной нагрузке
Ценообразование Capella на основе потребления по узлам масштабируется более линейно и, как правило, более предсказуемо при нерегулярной нагрузке.
Ценообразование DynamoDB на основе единиц емкости предсказуемо в стационарном состоянии, но губительно при пиковых или ресурсоемких нагрузках со сканированием. Каждое чтение и запись потребляют единицы емкости, и вам необходимо рассчитывать подготовленную емкость под пиковую нагрузку или дополнять ее автомасштабированием, которое имеет собственные характеристики задержки.
Мультиоблачность против работы только в AWS
Capella работает на AWS, Azure и Google Cloud с использованием одного и того же движка и API.
DynamoDB — это нативная служба AWS, не имеющая аналогов в Google Cloud или Azure. Командам с требованиями мультиоблачности или планами по диверсификации облачных поставщиков требуется либо миграция, либо развертывание второй базы данных.
Честные компромиссы
Операционная простота DynamoDB и нативная интеграция с AWS являются реальными преимуществами для команд, создающих решения на базе AWS со стабильными шаблонами доступа и высоким объемом записи. Если рабочая нагрузка соответствует модели «ключ-значение» DynamoDB, ее управляемая модель превосходна. Компромиссы в отношении стоимости и сложности становятся существенными при изменении шаблонов доступа или росте требований к аналитике.
Capella против NoSQL с самостоятельным хостингом
Сравнение между Capella и NoSQL с самостоятельным хостингом (Couchbase Server, MongoDB Community, Cassandra или аналогичными) — это в первую очередь вопрос совокупной стоимости владения (TCO).
Полная операционная стоимость инфраструктуры под собственным управлением
Затраты на лицензирование или открытый исходный код — это лишь часть картины. NoSQL с самостоятельным хостингом требует:
- Инженерного времени на подготовку, настройку и обслуживание кластеров
- Дежурств инженерной группы для реагирования на инциденты с базой данных
- Планирования и выполнения обновлений (часто требующих окон простоя)
- Планирования емкости и закупки оборудования или управления облачными виртуальными машинами
- Настройки многорегиональной репликации и ее постоянного управления
- Систем резервного копирования, независимых от самой базы данных
- Инфраструктуры мониторинга и управления оповещениями
Wallbid — это корпоративная платформа аукционов, которая выбрала Couchbase Capella специально для того, чтобы избежать накладных расходов на управление инфраструктурой и оптимизировать совокупную стоимость владения (TCO). Их команда перенаправила инженерные ресурсы с администрирования баз данных на разработку продуктов, что является наиболее наглядным экономическим обоснованием для управляемых служб.
Не дорога с односторонним движением
Couchbase Server и Couchbase Capella используют один и тот же движок. Ваша команда может начать с самостоятельно управляемого Couchbase Server и перейти на Capella без переработки платформы. Или вы можете запустить гибридное развертывание, когда часть рабочих нагрузок выполняется на Capella, а другие — на самостоятельно управляемом Server.
Такой симметрии нет у MongoDB Atlas или DynamoDB. Команда, перешедшая на любую из них, не сможет вернуться к версии под собственным управлением на том же движке с теми же API.
Это важно для команд, которым требуется контроль над конкретными требованиями соответствия нормативным требованиям, развертываниями в изолированных сетях (air-gapped) или ограничениями на размещение данных. Couchbase Server поддерживает все это на том же движке, который лежит в основе Capella.
Миграция с MongoDB, Atlas или MongoLab
Команды, оценивающие Capella, часто переходят с MongoDB Community, MongoDB Atlas или устаревшего сервиса mLab (MongoLab), приобретенного MongoDB в 2018 году. Путь миграции для всех трех вариантов одинаков, поскольку в обоих случаях базовой моделью данных являются документы JSON.
Обзор пути миграции
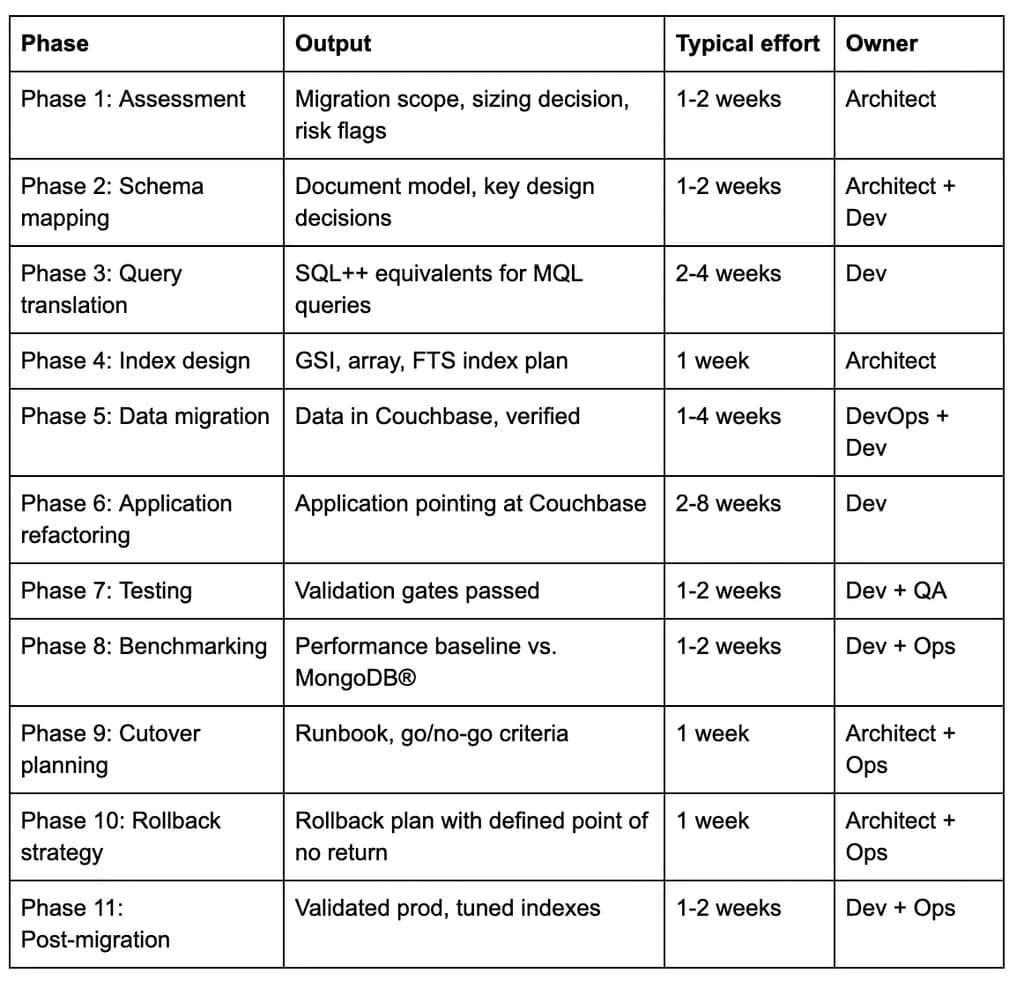
Миграция с MongoDB на Capella обычно состоит из четырех этапов:
- Оценка: аудит коллекций, структуры документов, индексов и шаблонов доступа. Выявление запросов, требующих трансляции из MQL в SQL++.
- Перемещение данных: cbmigrate выполняет прямую миграцию из MongoDB в Capella, включая маппинг коллекций и конвертацию индексов. Для крупных наборов данных, требующих минимального времени простоя, подход с инкрементальной синхронизацией с использованием коннектора Kafka поддерживает исходную базу данных в рабочем состоянии в период миграции.
- Трансляция запросов: SQL++ структурно похож на SQL и семантически близок к MQL для обычных запросов к документам. Capella iQ (ИИ-помощник, встроенный в интерфейс Capella) может напрямую переводить запросы MQL в SQL++. Плагины для VS Code и JetBrains обеспечивают поддержку трансляции запросов в среде разработки.
- Рефакторинг приложений: API SDK для Node.js, Python, Java, .NET и Go следуют тем же шаблонам, что и драйверы MongoDB. Основные изменения касаются строк подключения, ссылок на коллекции и синтаксиса запросов.
Примечание для команд, использующих mLab или MongoLab
Бренд mLab (MongoLab) продолжает встречаться в результатах поиска и конфигурациях устаревших приложений спустя долгое время после приобретения mLab компанией MongoDB в 2018 году и последующего закрытия этого сервиса. Если ваша команда использует приложение, в котором до сих пор указаны строки подключения mLab, вы уже работаете на MongoDB Atlas (инфраструктура была перенесена автоматически). Путь миграции с MongoDB Atlas на Capella, описанный выше, применим напрямую.
Облачные базы данных и обоснование данных для ИИ
Обоснование данных для ИИ (AI data grounding) — это практика привязки результатов работы модели ИИ к актуальным, авторитетным операционным данным, а не только к обучающей выборке. Модель, основанная на «живых» операционных данных, может отвечать на вопросы о таких сведениях, как текущие складские запасы, актуальные предпочтения клиентов или недавняя история транзакций. Необоснованная модель отвечает на основе обучающих данных, которые могут быть устаревшими на месяцы или годы.
Для обоснования необходимо, чтобы операционные данные и векторные представления, используемые для семантического поиска, находились в одном месте. Разделение их между основной базой данных и отдельно управляемым векторным хранилищем создает три проблемы:
- Накладные расходы на синхронизацию — поддержание актуальности эмбеддингов при изменении исходных данных
- Риск нарушения согласованности — модель извлекает вектор, который ссылается на документ, уже обновленный или удаленный в основной базе данных
- Второй счет за обслуживание
Capella решает эти проблемы, включая встроенный векторный поиск и автоматическую векторизацию на той же платформе, где хранятся операционные данные. Couchbase AI Data Plane™ расширяет эти возможности до хостинга моделей, автоматизации конвейеров RAG, семантического кэширования, памяти агентов и управления инструментами — и все это на одной платформе без необходимости управлять отдельным векторным хранилищем.
Для приложений, которым необходимо обоснование ИИ для работы в условиях сетевых сбоев, векторный поиск на устройстве в Couchbase Lite расширяет возможности семантического поиска на мобильные и периферийные устройства. Приложение для выездного обслуживания или POS-терминал в розничной торговле могут локально выполнять RAG без подключения к облаку и синхронизироваться после восстановления соединения.
Стоимость
Couchbase Capella использует модель потребления с оплатой за узел в час. Структура уровней соответствует требованиям к развертыванию:
Free — одноузловой кластер для POC и прототипирования. Кредитная карта не требуется. Подходит для оценки Capella перед принятием обязательств по промышленной эксплуатации.
Basic — развертывание в одной зоне доступности для разработки и тестирования. Не подходит для рабочих нагрузок, требующих гарантий времени безотказной работы.
Developer Pro — развертывание в нескольких зонах доступности (Multi-AZ) для некритичных рабочих нагрузок. Включает автоматическое резервное копирование, мониторинг и управляемые обновления.
Enterprise — развертывание в нескольких регионах с выделенной инфраструктурой, расширенными SLA, корпоративной поддержкой и средствами контроля соответствия требованиям. Подходит для критически важных бизнес-развертываний.
Стоимость по сравнению с MongoDB Atlas и DynamoDB зависит от характера рабочей нагрузки. Ценообразование Capella за узел, как правило, более предсказуемо, чем модель единиц емкости DynamoDB при скачкообразных или интенсивных операциях сканирования. Прямое сравнение затрат для конкретной рабочей нагрузки требует моделирования вычислений, хранения и передачи данных с учетом опубликованных цен Capella.
Часто задаваемые вопросы об облачных базах данных
Что такое облачная база данных? Облачная база данных — это база данных, работающая в облачной инфраструктуре, а не на оборудовании, которым организация управляет напрямую. Этот термин охватывает широкий спектр: от программного обеспечения баз данных, размещенного на облачных виртуальных машинах, до полностью управляемых DBaaS, где поставщик берет на себя все операционные задачи. Ключевой переменной является то, какая часть операционной нагрузки (подготовка ресурсов, исправление ошибок, масштабирование, резервное копирование, восстановление) ложится на команду, а какая — на поставщика.
В чем разница между облачной базой данных и DBaaS? Облачная база данных — это любая база данных, работающая в облачной инфраструктуре. DBaaS — это конкретная модель развертывания в этой категории, при которой поставщик полностью управляет операционным уровнем, а клиент взаимодействует с базой данных только через API и интерфейсы запросов. Не все облачные базы данных являются DBaaS. Например, команда, запускающая MongoDB Community на экземплярах EC2, использует облачную базу данных, но не использует DBaaS.
Какая альтернатива MongoDB Atlas лучшая? Ответ зависит от того, почему вы ищете альтернативу. Если проблема в мобильной синхронизации (MongoDB прекратила поддержку Realm, поддержка заканчивается в сентябре 2025 года), Couchbase Capella с Couchbase Mobile является наиболее прямой заменой «один в один». Если проблема в стоимости при масштабировании, сравнение сильно зависит от характера рабочей нагрузки и требует построения ценовой модели на основе ваших реальных показателей пропускной способности и объема хранения. Если проблема в гибкости запросов или доступе для аналитиков, SQL++ в Capella является существенным улучшением по сравнению с MQL, поскольку это полноценное надмножество SQL. Если проблема в зрелости экосистемы и привычках разработчиков, Atlas по-прежнему остается более устоявшимся вариантом, и переход связан с реальными затратами.
Дешевле ли Couchbase Capella, чем MongoDB Atlas? Это зависит от характера рабочей нагрузки. Ценообразование Capella за узел, как правило, более предсказуемо, чем у Atlas при рабочих нагрузках с высокой интенсивностью скачков или сканирования, в то время как выбор размера кластера Atlas и масштабирование Atlas Search могут привести к неожиданным расходам. Для стабильных, ориентированных на чтение рабочих нагрузок среднего масштаба разница в цене меньше, и решение зависит от операционной модели и соответствия функций. Значимое сравнение затрат требует моделирования ваших конкретных требований к пропускной способности, хранению и работе в нескольких регионах по сравнению с опубликованными ценами обоих поставщиков.
Можно ли перейти с Capella на Couchbase, управляемую самостоятельно? Да. Couchbase Capella и Couchbase Server используют один и тот же движок. Команда может перейти с Capella на самостоятельно управляемый Couchbase Server, запустить гибридное развертывание или вернуться обратно в любом направлении без изменения платформы приложения. Запросы SQL++, код SDK и модель данных идентичны в обеих моделях развертывания. Это существенное отличие от MongoDB Atlas и DynamoDB, где управляемый сервис и любой самостоятельно управляемый эквивалент не являются одним и тем же движком с одинаковыми API.
Как облачные базы данных поддерживают приложения ИИ? Облачные базы данных поддерживают приложения ИИ главным образом за счет векторного поиска (для семантического поиска и конвейеров RAG), встроенной интеграции с моделями эмбеддингов (чтобы избежать отдельного конвейера векторизации) и возможности синхронизации оперативных данных и векторных представлений на одной платформе. Облачная база данных, требующая отдельного векторного хранилища для рабочих нагрузок ИИ, создает дополнительные накладные расходы на синхронизацию, риски нарушения согласованности и требует управления еще одним сервисом. Capella включает встроенный векторный поиск, автоматическую векторизацию и уровень данных ИИ (память агентов, семантическое кэширование, хостинг моделей и управление инструментами) на той же платформе, что и оперативные данные.