LinkSummary
Системы масштаба стойки NVIDIA GB300 NVL72 обеспечивают колоссальный прирост производительности, объединяя 72 графических процессора NVIDIA Blackwell и 36 центральных процессоров NVIDIA Grace с помощью масштабируемой фабрики NVIDIA NVLink уровня стойки, известной как домен NVLink. Чтобы помочь пользователям Ray эффективно использовать эту топологию, мы представляем группы размещения с учетом доменов NVLink (NVLink Domain-Aware Placement Groups): примитив планирования с учетом многоузловой топологии, который размещает группы размещения в пределах одного домена NVLink. В этой статье мы объясняем, почему это важно для систем GB200 и GB300 NVL72, а также рассказываем, как исследовательская лаборатория NVIDIA GEAR подтвердила эти преимущества на реальных рабочих нагрузках обучения для NVIDIA GB300 NVL72.
До сих пор группы размещения Ray фокусировались на типах ускорения, привязанных к отдельным узлам, например на выборе между графическими процессорами NVIDIA Hopper и NVIDIA Blackwell. Тем не менее, более новые системы, такие как NVIDIA GB300 NVL72, предоставляют многоузловые домены NVLink, для эффективного использования которых требуется планирование с учетом топологии.
Группы размещения с учетом доменов NVLink расширяют модель планирования Ray поддержкой топологии, позволяя пользователям как максимизировать высокопроизводительную коммуникацию между графическими процессорами, так и сохранять намерения топологии при сбоях. Это небольшое, но мощное изменение раскрывает потенциал таких систем, как GB200 и GB300, закладывая основу для более общих функций планирования с учетом топологии и автомасштабирования для мультихостовых/многостоечных систем.
LinkМасштабирование NVLink для нескольких узлов: NVIDIA GB300 NVL72
Традиционные серверы с графическими процессорами, такие как NVIDIA DGX H100 и DGX H200, объединяют 8 графических процессоров в один узел, соединенных через NVLink поверх SXM, причем связь между узлами обычно осуществляется с использованием InfiniBand или RoCE.
Рис. 1. Пример стойки GB300
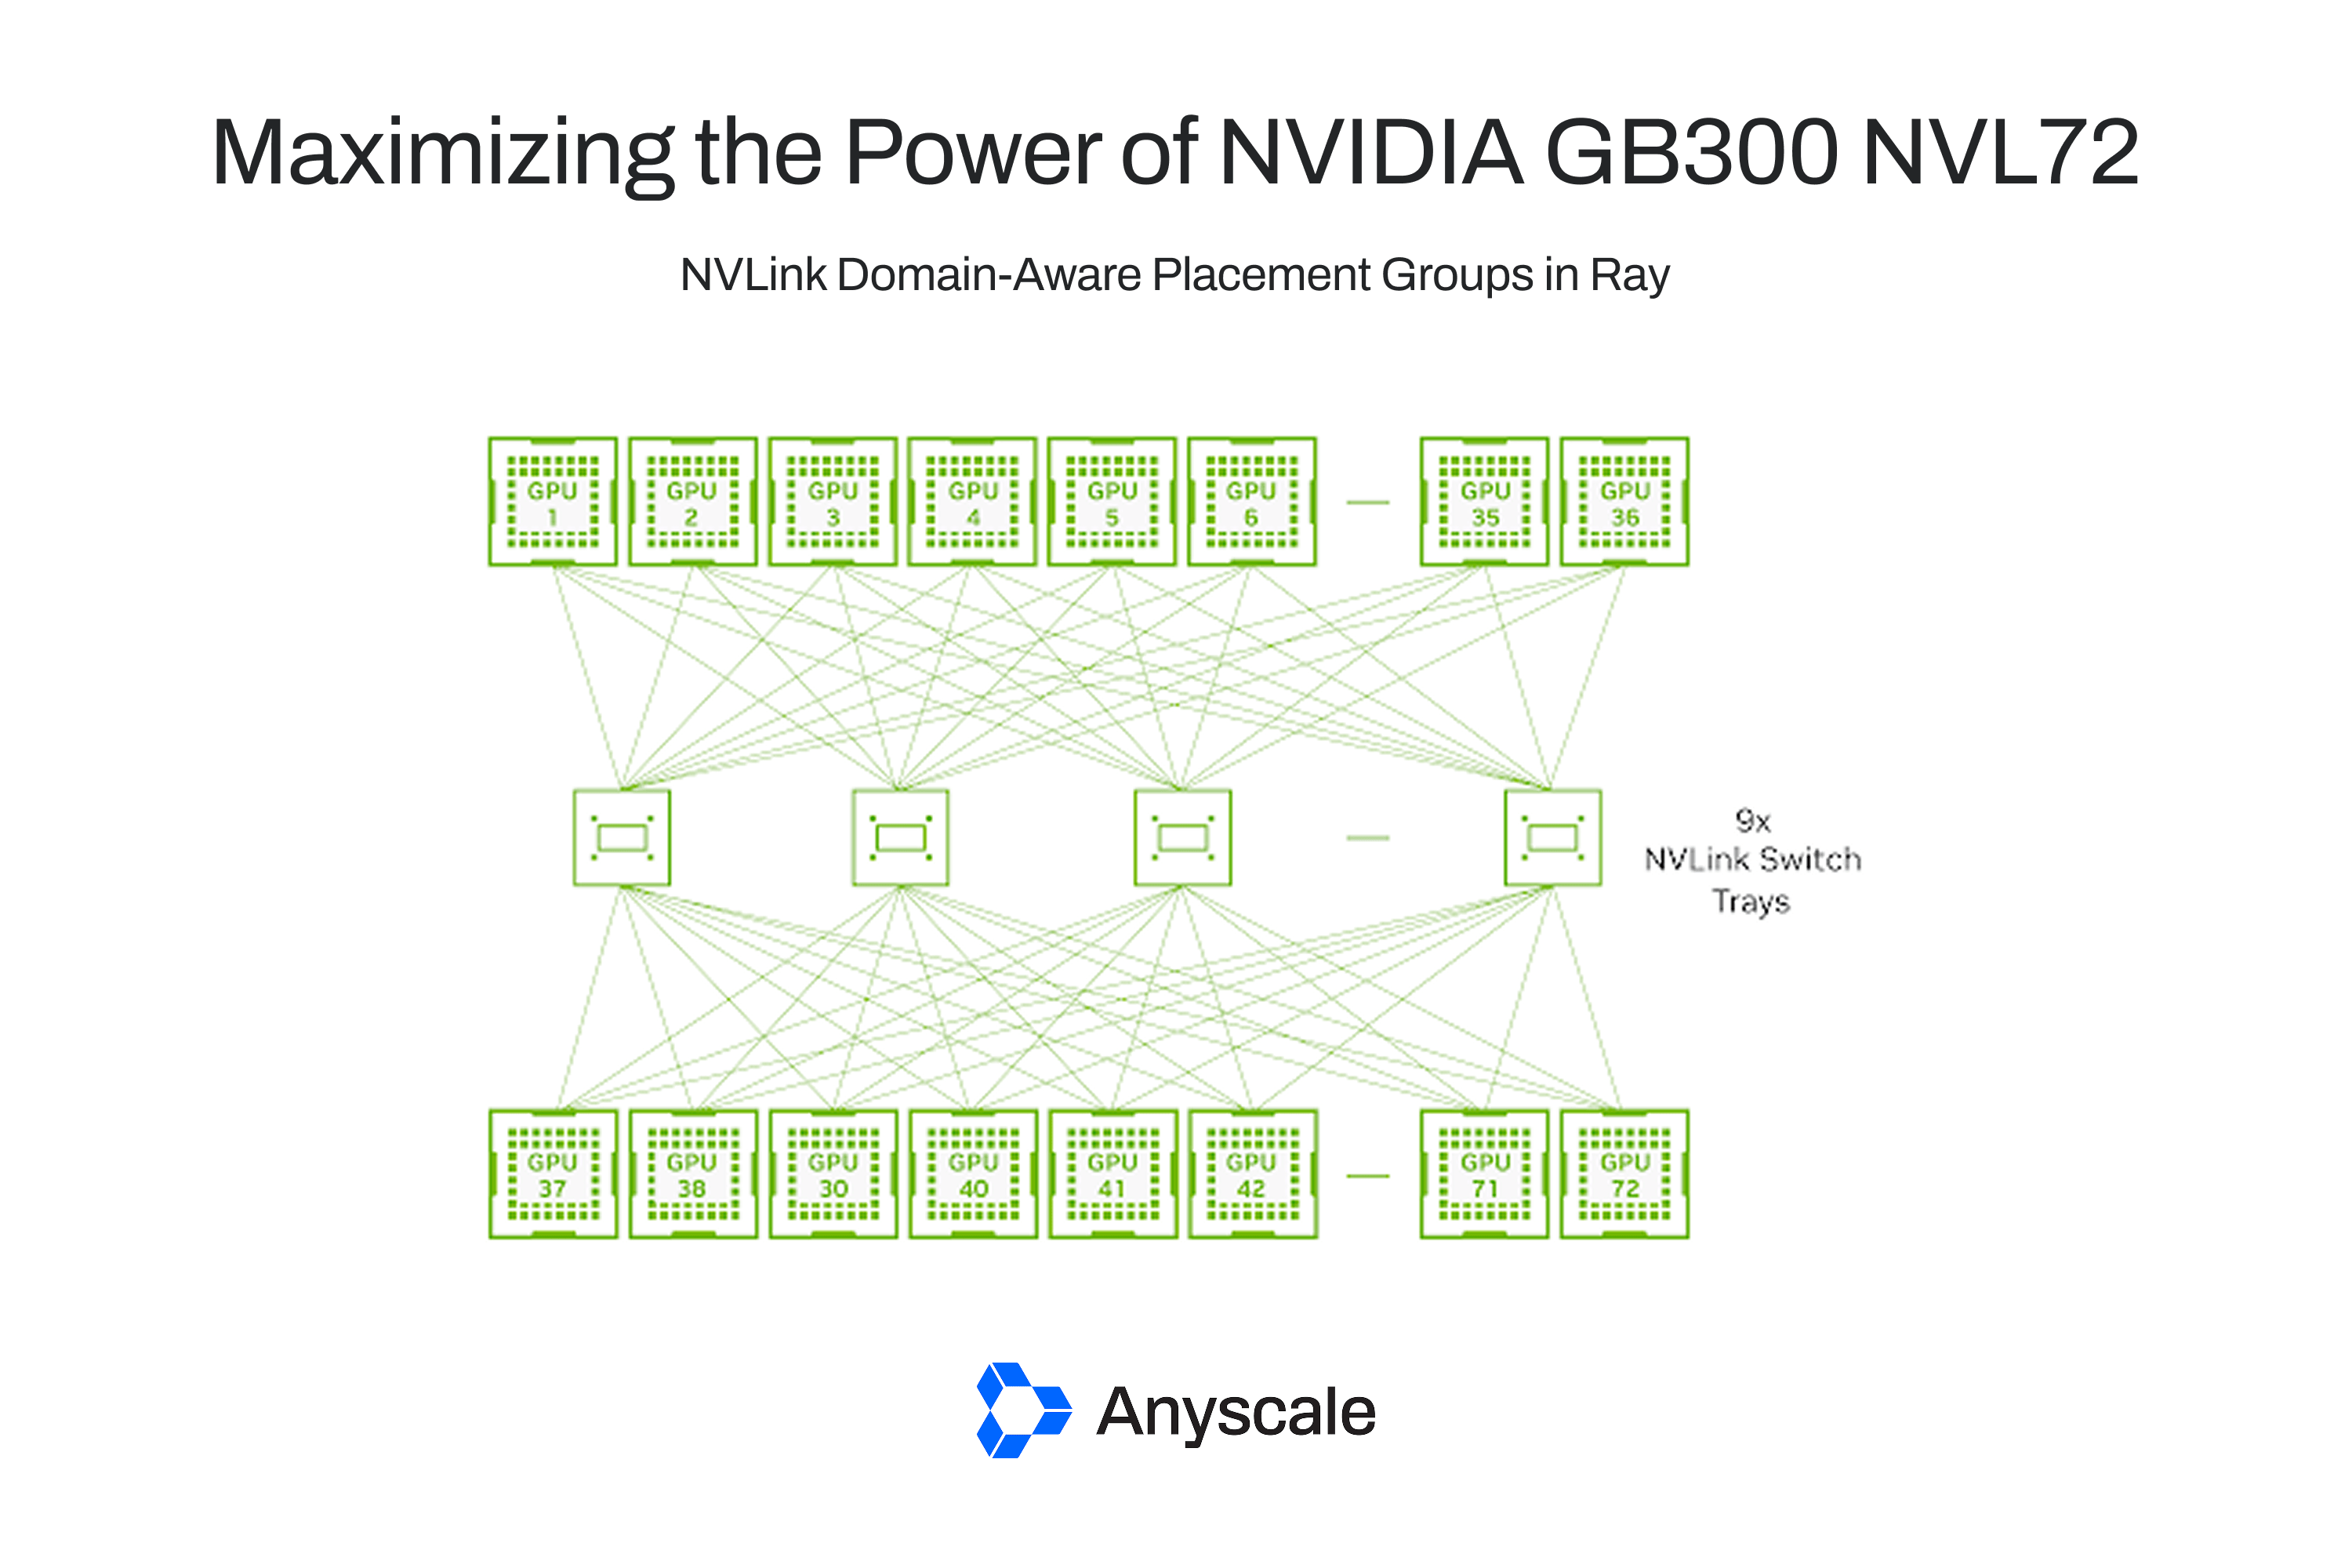
NVIDIA GB200 NVL72 и GB300 NVL72 представляют собой новую вычислительную платформу, объединяющую целую стойку из 72 графических процессоров Blackwell и 36 процессоров Grace с пропускной способностью «каждый с каждым» 1800 ГБ/с на каждый графический процессор, что фактически позволяет всем графическим процессорам работать вместе как единое целое.
Рис. 2. Топология «каждый с каждым» в GB300 NVL72
Для рабочих нагрузок, в которых преобладают коллективные коммуникации и передача данных в памяти, системы GB200 и GB300 NVL72 являются лидерами в отрасли.
LinkПредставляем группы размещения Ray с учетом доменов NVLink
Чтобы задействовать преимущества NVIDIA GB200 NVL72 и GB300 NVL72 в Ray, пользователям необходима возможность запрашивать размещение групп акторов в рамках одного домена NVLink, который соответствует одной стойке.
Раньше группы размещения Ray не учитывали зависимости между узлами. То есть они могли использовать стратегии PACK или STRICT_PACK только на уровне узла. Например, если бы вы попытались применить STRICT_PACK для 18 наборов (bundles), требующих по 4 графических и 2 центральных процессора в группе размещения, эта задача не была бы запланирована, так как фактически вы бы запросили один узел, содержащий 72 графических процессора!
Предыдущим обходным путем было назначение пользовательской метки для каждой стойки GB300 NVL72 (например, "ray.io/gpu-domain"="rack-7") с последующим использованием bundle_label_selector для «привязки» наборов к этой стойке. Этот подход требует ручного вмешательства и плохо сочетается с автомасштабированием или отказоустойчивостью.
Для решения этой проблемы мы добавляем поддержку доменов NVLink в API групп размещения. Пользователи активируют эту функцию, определяя новое поле стратегии топологии в API групп размещения, т.е. topology_strategy = {ray.io/node-id: "PACK", ray.io/gpu-domain: "STRICT_PACK"}. Это нововведение сообщает Ray, что он ДОЛЖЕН разместить все наборы в пределах одного домена NVLink.
Например, в кластере Ray с несколькими стойками GB300 следующая группа размещения гарантирует, что ваши акторы будут размещены в одном домене NVLink:
Рис. 3. Если предыдущая группа размещения успешно запланирована, это один из возможных вариантов распределения в кластере с 2 стойками GB300
Хотя этот код выглядит простым, его преимущества весьма значительны.
LinkОптимизированная производительность сети
Наиболее очевидным преимуществом размещения с учетом доменов является повышенная производительность сети. Удержание тесно связанных акторов в пределах одного домена NVLink позволяет использовать для коллективных операций, таких как all_reduce, интерфейс NVLink вместо более медленных междоменных путей. Мало того, это также позволяет более эффективно использовать новые функции для ускорения коллективных коммуникаций, такие как NVIDIA SHARP1.
LinkОтказоустойчивость с учетом приложений
Ray сохранит исходные требования приложения к топологии при изменении состояния кластера. Если узел выходит из строя или требует обслуживания, Ray заменит его узлом из того же домена NVLink (при наличии свободных ресурсов), вместо того чтобы молчаливо фрагментировать рабочую нагрузку между стойками. Пример этого показан на рисунке 3. Если свободных ресурсов нет, набор ставится в очередь на перепланирование, за исключением случаев, когда из строя выходит весь набор целиком — в таком случае для использования автоматически выбирается новый домен NVLink. Этот механизм отказоустойчивости всегда был важной частью групп размещения Ray, а теперь он расширен и на эти многоузловые системы.
Рис. 4. Пример замены узла на узел из того же домена после того, как группа размещения уже была запланирована
LinkРеальный пример: крупномасштабное распределенное обучение VLA на базе GB300
Мы сотрудничали с исследовательской лабораторией NVIDIA GEAR, чтобы протестировать эту новую функцию в ходе крупномасштабных запусков предварительного обучения VLA (Vision Language Action) на кластере GB300.
Чтобы оценить преимущества групп размещения Ray с учетом доменов NVLink, специалисты NVIDIA GEAR провели два цикла обучения: один с этой новой функцией, а другой без нее. В каждом запуске использовалось 512 графических процессоров (128 узлов), разделенных на 8 групп по 64 графических процессора (16 узлов).
Рис. 5. Наглядная демонстрация неудачного размещения акторов в нашем первом запуске обучения, из-за которого они не могли эффективно использовать NVLink во время обучения
Рис. 6. На этой диаграмме, иллюстрирующей второй запуск, показано, как каждая группа размещения локализована в пределах одного домена NVLink, оставляя по 2 свободных слота на домен
Во втором запуске скорость итераций в секунду оказалась в 1.13 раза выше, чем в первом. Тем не менее, это только начало, поскольку остаются возможности для еще более эффективного использования уникальных аппаратных возможностей GB300.
Почему во втором запуске производительность выше? В первом запуске графические процессоры тратят больше времени на обмен данными с другими участниками своей группы размещения (например, во время коллективных операций, таких как all_reduce). Во втором же запуске акторы размещаются таким образом, чтобы использовать преимущества быстрого межпроцессорного обмена данными через NVLink, что обеспечивает скорость обучения, недостижимую в первом запуске.
Кроме того, благодаря тому, что Ray «знает» о размещении групп в одном домене NVLink, обработка сбоев во время длительных циклов обучения становится значительно проще.
LinkДругие сценарии использования планирования с учетом стоек
Распределенный инференс. Задачи обслуживания, использующие разделенный инференс (disaggregated inference), часто разделяют воркеры генерации префикса (prefill) и декодирования (decode). В системах класса GB300 особенно важно, чтобы эти воркеры попадали в один и тот же домен NVLink, что позволяет им обмениваться KV-кэшем и промежуточными состояниями по самым быстрым из доступных путей. Группы размещения с учетом доменов NVLink значительно упрощают эту задачу, позволяя пользователям указывать необходимость совместного размещения связанных акторов префикса и декодирования на одной стойке вместо их ручной привязки с помощью специфичных для стоек меток.
Обучение с подкреплением. Рабочие нагрузки RL состоят из множества этапов: обучение, развертывание и оценка, каждый из которых имеет свои шаблоны связи. Размещение с учетом особенностей предметной области позволяет пользователям удерживать вместе наиболее тесно связанные части конвейера, такие как воркеры обучения политике или акторы, которые часто обмениваются весами моделей, одновременно предоставляя Ray гибкость для планирования менее требовательных к связи компонентов в других местах.
СсылкаЧто дальше?
Основная цель этой функции — обеспечить учет доменов NVLink на уровне приложений Ray. В течение следующих нескольких релизов мы стремимся предоставить еще больше возможностей и инструментов для понимания локальности графических процессоров и оптимизации размещения для достижения максимальной производительности и эффективности межсоединений.
Мы также будем расширять API групп размещения по нескольким направлениям:
- Группы размещения с учетом доменов NVLink в настоящее время поддерживают только STRICT_PACK. Мы планируем добавить поддержку других стратегий, таких как STRICT_SPREAD, которые, например, позволят размещать группы на разных стойках.
Группы размещения с учетом доменов NVLink в настоящее время поддерживают только STRICT_PACK. Мы планируем добавить поддержку других стратегий, таких как STRICT_SPREAD, которые, например, позволят размещать группы на разных стойках.
- Вложенные топологии: топология, выражаемая через группы размещения с учетом доменов NVLink, на данный момент является плоской. На практике инфраструктура обычно является иерархической, где стойки находятся в дата-центрах, которые находятся в зонах доступности и так далее. Мы планируем добавить поддержку описания таких вложенных топологий.
Вложенные топологии: топология, выражаемая через группы размещения с учетом доменов NVLink, на данный момент является плоской. На практике инфраструктура обычно является иерархической, где стойки находятся в дата-центрах, которые находятся в зонах доступности и так далее. Мы планируем добавить поддержку описания таких вложенных топологий.
СсылкаПопробуйте прямо сейчас
Перейдите по ссылке, чтобы узнать больше об использовании этой функции.
Мы будем рады услышать отзывы от сообщества об этой функции. Если у вас есть идеи по улучшению API или вы столкнулись с проблемами при его использовании, пожалуйста, создайте задачу в репозитории GitHub на https://github.com/ray-project/ray.
1Подробную информацию о SHARP можно найти здесь: https://networking-docs.nvidia.com/sharpum/3150/introduction