Мы представляем LAION-400M: 400 млн английских пар (изображение, текст) — см. также наш Data Centric AI NeurIPS Workshop 2021 paper
Концепция и содержание
Датасет LAION-400M полностью открыт и находится в свободном доступе.
ВНИМАНИЕ: обратите внимание, что этот крупномасштабный датасет не проходил модерацию (не курировался). Он был создан в исследовательских целях для тестирования обучения моделей в более крупном масштабе для широкого исследовательского и других заинтересованных сообществ и не предназначен для коммерческого использования или реальных приложений.
Мы отфильтровали все изображения и тексты в датасете LAION-400M с помощью CLIP от OpenAI, рассчитав косинусное сходство между эмбеддингами текста и изображений и отбросив те, у которых сходство ниже 0,3. Порог 0,3 был определен на основе экспертных оценок и показал себя как хорошая эвристика для оценки семантического соответствия содержания изображения и текста.
Пары «изображение-текст» были извлечены из дампа веб-данных Common Crawl и собраны со случайных веб-страниц в период с 2014 по 2021 год.
Статистика датасета LAION-400M
LAION-400M и будущие, еще более крупные датасеты, по сути, представляют собой «датасеты датасетов». Например, мы можем отфильтровать его по размеру изображений на более мелкие датасеты:
Используя индекс KNN, мы можем извлекать специализированные датасеты по интересующим доменам. Их размер достаточен (или будет достаточен) для обучения моделей в узкоспециализированных областях.
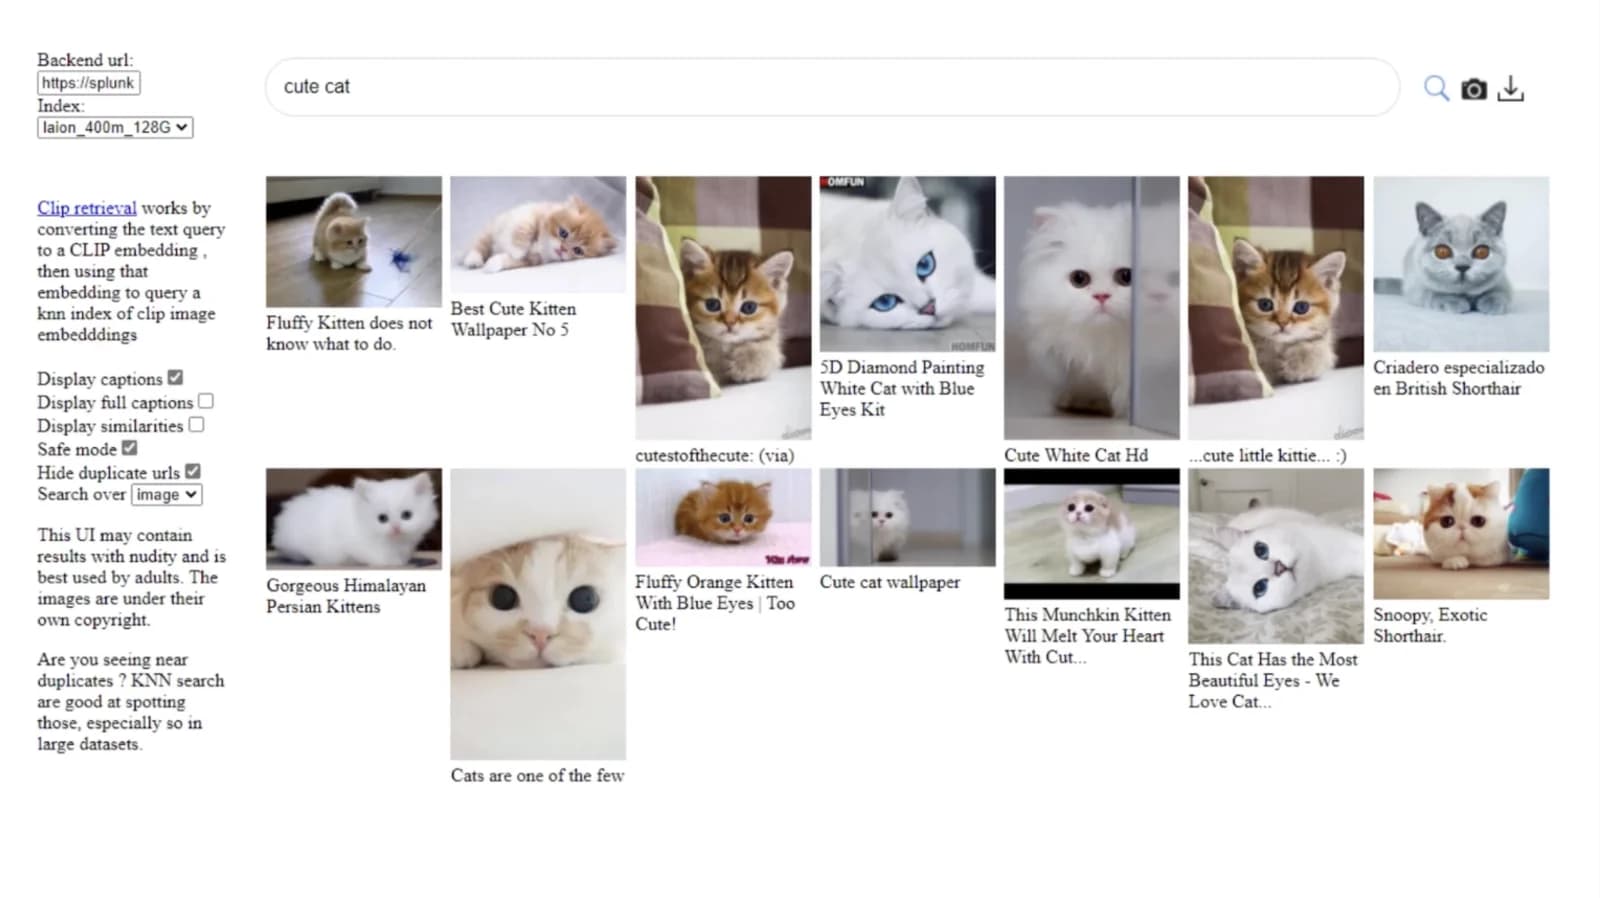
Также используйте https://rom1504.github.io/clip-retrieval/ для простой визуализации датасета. Там вы можете выполнять поиск по датасету с помощью CLIP и индекса knn.
Отказ от ответственности и предупреждение о содержимом
Наш протокол фильтрации удалил только NSFW-изображения, признанные нелегальными, но в датасете по-прежнему присутствует NSFW-контент, соответствующим образом отмеченный в метаданных. При свободном просмотре датасета имейте в виду, что это крупномасштабный, некурируемый набор данных, собранный из интернета в исследовательских целях, поэтому собранные ссылки могут вести на неприятный или неприемлемый контент. Поэтому используйте демо-ссылки с осторожностью. Вы можете извлечь «безопасный» поднабор, отфильтровав образцы с пометкой NSFW или применив более строгую фильтрацию CLIP.
Присутствует некоторая степень дублирования, поскольку мы использовали URL+текст в качестве критерия дедупликации. Одно и то же изображение с одной и той же подписью может находиться по разным URL-адресам, вызывая дубликаты. Однако одно и то же изображение с другими подписями не считается дубликатом.
Использование кластеризации KNN должно облегчить дальнейшую дедупликацию по содержимому изображений.
Структура открытого датасета LAION-400M
Мы подготовили датасет в нескольких форматах для различных сценариев использования:
- датасет метаданных (URL + подпись) объемом 50 ГБ в файлах формата parquet. Метаданные можно использовать для расчета статистики и повторного скачивания части датасета
- webdataset объемом 10 ТБ с изображениями 256×256, подписями и метаданными. Это полная версия датасета, которую можно использовать непосредственно для обучения (она предназначена для внутреннего использования, вам нужно будет самостоятельно перекачать изображения из-за лицензионных ограничений)
- набор CLIP-эмбеддингов текста и изображений для 400 млн образцов объемом 1 ТБ, полезный для пересборки новых индексов knn
- пары knn-индексов размером 16G, 32G, 64G и 128G (работают в веб-демо)
Датасет метаданных URL и подписей
Мы предоставляем 32 parquet-файла размером около 1 ГБ (всего 50 ГБ) с URL-адресами изображений, соответствующими текстами и дополнительными метаданными в следующем формате:
SAMPLE_ID | URL | TEXT | LICENSE | NSFW | similarity | WIDTH | HEIGHT
SAMPLE_ID | URL | TEXT | LICENSE | NSFW | similarity | WIDTH | HEIGHT
где
- SAMPLE_ID: Уникальный идентификатор
- LICENSE: Если в данных изображения была найдена лицензия Creative Commons, мы указали ее здесь, например, «creativecommons.org/licenses/by-nc-sa/3.0/» — в противном случае вы увидите здесь «?»
- NSFW: мы использовали CLIP для оценки наличия NSFW-контента на изображении. Оценка была достаточно консервативной, снижая количество ложноотрицательных результатов за счет увеличения ложноположительных. Возможные значения: «UNLIKELY», «UNSURE» и «NSFW».
- similarity: Значение косинусного сходства между эмбеддингами текста и изображения
- WIDTH и HEIGHT: размер изображения на момент создания эмбеддинга. Мы уменьшили оригиналы размером более 4K до 4K.
Назначение этого датасета метаданных — скачивание изображений для всего датасета или его подмножества путем передачи данных очень высокопроизводительному инструменту img2dataset.
webdataset объемом 10 ТБ с изображениями и подписями
Запустив инструмент img2dataset, мы можем скачать webdataset объемом 10 ТБ. Он изменит размер всех изображений до разрешения 256×256, добавит соответствующую подпись и сгенерирует набор tar-файлов (этот формат датасета называется webdataset), содержащих изображения, подписи и метаданные, а также соответствующие parquet-файлы с теми же метаданными
- 00000.tar размером 270 МБ, содержащий максимум 10 тыс. образцов: 0.jpg; 0.txt, содержащий подпись; 0.json, содержащий метаданные, такие как URL, исходная ширина, данные EXIF и пометку NSFW
- 0.jpg
- 0.txt, содержащий подпись
- 0.json, содержащий метаданные, такие как URL, исходная ширина, данные EXIF и пометку NSFW
- 00000.parquet размером 1,6 МБ, содержащий те же метаданные, что и JSON-файл. Полезен для расчета статистики без чтения всех tar-файлов
Таким образом, датасет 400M будет состоять из 41455 tar-файлов и 41455 parquet-файлов. Назначение этого датасета — обучение мультимодальных моделей, таких как CLIP или DALL-E.
1 ТБ CLIP-эмбеддингов
CLIP-эмбеддинги хранятся в NPY-файлах рядом с parquet-файлами в том же порядке. Поскольку этот датасет намного меньше датасета изображений, каждый NPY-файл содержит 1 млн образцов. Каждый NPY-файл имеет размер 1 ГБ, а каждый parquet-файл — 150 МБ. Всего таких файлов 400. Назначение эмбеддингов — расчет статистики по датасету, например, с использованием кластеризации или knn-индексов.
Два небольших knn-индекса размером 6 ГБ
Мы предоставляем два knn-индекса размером 6 ГБ, созданные с помощью autofaiss. Их можно использовать для формирования подмножества датасета и, в целом, для эффективного поиска по нему. См. поисковое веб-демо. Мы можем использовать инструмент фильтрации CLIP вместе с этим индексом для эффективного создания подмножеств на основе поисковых запросов. Мы также предоставляем два более качественных knn-индекса размером 16 ГБ.
Что можно делать с датасетом LAION-400M?
Моделирование зрения и языка совершило стремительный прорыв в 2021 году. Вот несколько замечаний о том, какие возможности открывают подобные датасеты «изображение + текст» и почему это интересно:
- Шесть месяцев назад OpenAI опубликовала две статьи и записи в блоге, и DALL-E. Обе модели опираются на большое количество пар (текст, изображение). Они использовали непубличный датасет из 400 млн пар. CLIP — это модель, которая вычисляет степень соответствия между текстом и изображением. Она позволяет выстраивать крупномасштабный поиск изображений по тексту и создавать невероятный арт по текстовым описаниям clip-art. Они выпустили малую и среднюю версии модели, но не код для обучения. DALL-E — это модель, которая напрямую генерирует изображения из текста. Как видно из публикации в блоге, она достигает потрясающих результатов, которые могут оказать прямое влияние на сферу создания рисунков и иллюстраций. OpenAI не выпустила ни одну модель, даже через API
- CLIP — это модель, которая вычисляет степень соответствия между текстом и изображением. Она позволяет выстраивать крупномасштабный поиск изображений по тексту и создавать невероятный арт по текстовым описаниям . Они выпустили малую и среднюю версии модели, но не код для обучения.
- DALL-E — это модель, которая напрямую генерирует изображения по текстам. Как видно из поста в блоге, она достигает потрясающих результатов, способных напрямую повлиять на мир во всем, что требует рисунков и иллюстраций. OpenAI не выпустила никакой модели даже через API.
С тех пор различные исследователи предприняли несколько попыток реплицировать DALL-E. Сначала люди объединились вокруг этого отличного репозитория репликации DALLE DALLE-PyTorch с фантастическими результатами, видимыми в файле readme. Совсем недавно в рамках мероприятий huggingface были достигнуты новые успехи (см. отчет DALLE-mini ), а онлайн-демонстрация теперь доступна по адресу DALLE-mini demo.
Усилия по репликации все еще далеки от достижения той же производительности, что и у оригинального DALLE, и кажется возможным пойти еще дальше. Некоторые люди также хотят создать лучший CLIP для получения еще более качественного сгенерированного искусства.
Большая часть результатов, которых мы можем достичь с помощью таких моделей, достигается благодаря большому объему данных. До LAION-400M крупнейший открытый датасет пар (изображение, текст) насчитывал около 10 млн (см. DALLE-datasets ), чего достаточно для обучения интересных моделей, но недостаточно для достижения наилучшей производительности. Наличие публичного датасета с сотнями миллионов пар поможет в создании этих моделей «изображение + текст».
Анализ данных LAION-400M
Мы аннотировали 3456 выборок датасета и получили следующие результаты:
- Правильный позитивный NSFW: 4
- Правильный негативный NSFW: 3371
- Ложноположительный NSFW: 73
- Ложноотрицательный NSFW: 8
- Плохие подписи: 3 (0,09 %)
Соответствие отличное, благодаря CLIP. В будущем мы могли бы улучшить автоматическую тегинг NSFW; однако общий показатель NSFW достаточно низок (менее 1%), чтобы это не было проблемой.
Технические детали
Получение датасета состоит из двух основных частей:
- распределенная обработка огромных (множество ПБ) датасетов Common Crawl, которая создает коллекцию сопоставленных URL-адресов и подписей;
- гораздо более легкая постобработка данных на одном узле, которую любой может запустить за несколько дней и которая производит конечный датасет.
1. Распределенная обработка Common Crawl
Мы получаем сырые веб-данные для создания нашего датасета из Common Crawl. Common Crawl — это некоммерческая организация, занимающаяся предоставлением копии интернета исследователям интернета, компаниям и частным лицам бесплатно для исследований и анализа. Они регулярно выпускают дампы данных в стиле HTML, спарсенные с миллиардов общедоступных веб-сайтов, найденных на веб-сайте Common Crawl. Чтобы создать пары «изображение-текст», мы просматриваем данные из Common Crawl и выделяем все теги HTML IMG, содержащие атрибут альтернативного текста. Common Crawl предоставляет свои данные в нескольких форматах. Для наших целей мы решили использовать данные в формате WAT. Файлы WAT содержат только метаданные просмотренных сайтов, которые включают все ссылки и теги IMG, содержащиеся на веб-сайте. Парсинг только этих метаданных происходит намного быстрее, чем парсинг всего HTML-текста (предоставляемого в формате WARC).
Загрузка оригинальных изображений
Мы загружаем исходные изображения по URL-адресам, которые мы спарсили из Common Crawl, с помощью асинхронных запросов, используя библиотеки Trio и Asks. Они позволяют нам использовать многопоточность для одного ЦП. Обычно домашнее интернет-соединение будет исчерпано одним или двумя ЦП. Узел дата-центра может масштабировать преимущества гарантированной скорости интернета с помощью пула многопроцессорности намного быстрее, чем узел с одним ЦП. В то время мы смогли использовать 50 ядер с полным защищенным подключением 1 Гбит/с к публичному интернету. Эта пропускная способность должна быть доступна загружающему узлу, а не разделяться между многими узлами или приложениями. Мы оптимизировали скрипт на скорость, одновременно устраняя различные возникающие ошибки. Обычно для удовлетворения требований такого высокопроизводительного узла, как описано выше, мы должны предпринять дополнительные шаги для обеспечения возможностей кэширования DNS. Мы обнаружили, что knot-resolver, запущенный с двумя процессами и настроенный с опцией кэширования, может решить эту проблему.
Фильтрация неподходящих пар «изображение-текст»
После загрузки файлов WAT из Common Crawl мы фильтруем выборки на следующих этапах:
- Мы отбросили все выборки с длиной альтернативного текста менее пяти символов.
- Мы отбросили все выборки с размером изображения менее 5 КБ.
- Мы используем постоянно обновляемые фильтры Блума, чтобы отсеять выборки, которые уже есть в нашем датасете. Фильтры Блума выполняют дедупликацию путем конкатенации URL-адреса и альтернативного текста.
- Мы используем постоянно обновляемые фильтры Блума, чтобы исключить выборки из URL-адресов, у которых ранее истекло время ожидания и которые поэтому кажутся недоступными (или, по крайней мере, недоступными эффективным способом).
- Мы используем модель CLIP от OpenAI (версию «ViT-B-32») для вычисления вложений изображения и альтернативного текста. Затем мы вычисляем косинусное сходство обоих векторов вложений и отбрасываем все выборки сходством ниже 0,3. Мы выбрали этот порог после опробования различных значений и использования оценок людей о том, насколько хорошо тексты подходят к изображениям. Более низкие значения, такие как 0,28 или 0,29, также казались нормальными во многих случаях, но после дальнейших проверок мы решили выбрать консервативное значение 0,3.
- Мы используем вложения CLIP изображений, чтобы оценить, содержат ли они контент NSFW. Мы делаем это путем вычисления вложений CLIP для списка категорий изображений, таких как «селфи», «иллюстрация» или «пейзаж», который также содержит категории, указывающие на контент NSFW, такие как «порно» и «секс».
- Затем мы вычисляем косинусное сходство между вложением изображения, которое мы в настоящее время фильтруем, и каждым из этих ключевых слов категорий. Если категория с наибольшим сходством и ключевое слово со вторым по величине сходством принадлежат ключевым словам NSFW, мы помечаем выборку как «NSFW». Если только одно из них принадлежит ключевому слову NSFW, мы классифицируем выборку как «UNSURE» (не уверен). Если оба ключевых слова с наибольшим сходством не являются NSFW, мы помечаем выборку как «UNLIKELY» (маловероятно).
- На следующем этапе мы смотрим на все выборки с тегом «NSFW» или «UNSURE» и удаляем те, у которых в тексте есть какие-либо ключевые слова, связанные с детьми, подростками или другим семантически связанным контентом.
- На шаге 8 мы повторяем процедуру вычисления косинусного сходства из шага 6 с той разницей, что теперь мы используем тексты категорий, которые указывают на контент, семантически связанный с детьми и подростками, на уровне вложений CLIP. Если наибольшее сходство или второе по величине сходство между вложением изображения выборки и текстом предопределенных категорий принадлежит тексту, указывающему на контент, связанный с несовершеннолетними лицами, мы отбрасываем эту выборку.
- Наконец, мы повторяем процедуру с шага 8 с текстами, семантически связанными с категориями животных, такими как «животное», «птица» и т. д.
Мы выполняем эти строгие этапы фильтрации на предмет NSFW с потенциально незаконным контентом, потому что не можем гарантировать, что содержимое Common Crawl свободно от такового. Мы чувствуем себя обязанными сделать все возможное, чтобы отфильтровать подобный контент. Проверки выборок, отсеянных на этапах с 7 по 9, показали, что наша процедура фильтрации является очень консервативной и дает много ложноположительных результатов (отброшенных выборок, которые не являются проблемными). Такой процесс приемлем, поскольку количество потенциальных выборок, ожидающих нашей выгрузки, огромно.
Системная архитектура
Для координации взаимодействия множества скриптов обхода (называемых воркерами) в нашем проекте мы используем сервер, который отслеживает обработанные файлы WAT и то, какому воркеру достается тот или иной необработанный WAT. Мы называем этот координирующий сервер трекером. Его функции заключаются в предоставлении задач как воркерам загрузки, так и воркерам инференса, подтверждении запросов на очистку от промежуточного сервера DL, поддержании списков контроля доступа (ACL) для сервера Bloom и некоторых других. Мы также используем несколько промежуточных серверов в качестве буферов для задач на пути к месту хранения. Промежуточные серверы непрерывно обновляют фильтры на центральном сервере Bloom, где мы используем RedisBloom по соображениям высокой производительности.
Рабочий процесс
В ходе эволюции нашего проекта обхода мы применяли два разных рабочих процесса:
Этот воркер выполняет все вычислительные шаги в рамках одной задачи, а затем отправляет результат на промежуточный сервер. Затем он ставит результаты в очередь для передачи в область хранения.
Вскоре мы обнаружили, что лучший способ задействовать ресурсы — разделить рабочую нагрузку на задачи процессора и сети (этапы загрузки) и задачи графического процессора (этапы инференса CLIP). Следовательно, двухэтапный подход использует «процессорные воркеры» для загрузки изображений, создания пар изображение-текст и сохранения промежуточного результата на промежуточный сервер. Затем «воркеры GPU» подбирают задачи, объединяют некоторое их число, чтобы получилось около 20000 пар на окончательный файл результата. Двухэтапный рабочий процесс оказался наиболее эффективным: скорость добавления пар в датасет достигала 25 миллионов в день при использовании 100 процессорных воркеров с одним ядром и одного воркера GPU с видеокартой NVidia RTX 3090, задействующей все 16 линий шины PCIe. Узлу GPU также требуется около 24 потоков процессора, чтобы поспевать за производительностью обработки GPU.
Удаление предупреждений о злоупотреблениях
Во время скачивания мы сталкивались с предупреждениями о злоупотреблениях от ручных и автоматических инструментов, защищающих веб-сайты. Пройдя определенный этап обучения, мы свели к минимуму большинство проблем, используя следующие методы снижения рисков:
- Безусловно, самым эффективным из них было использование централизованных фильтров Блума, которые исключают повторные запросы к одним и тем же URL-адресам. Конечно, эффективность этих фильтров кардинально зависит от того, насколько быстро они обновляются и используются воркерами. По определению, наличие нескольких воркеров загрузки, выполняющих задачи параллельно, делает их склонными к дублированию запросов к одному и тому же URL-адресу, даже если фильтры Блума актуальны на начало выполнения задачи.
- Поэтому второй метод значительно снизил проблему параллельных воркеров за счет рандомизации задач на уровне сервера трекера. Выполняя задачи последовательно (начиная с самых старых файлов WAT за 2013 год), мы обнаружили, что соседние задачи существенно пересекаются. Когда мы рандомизировали задачи, мы увидели резкое сокращение таких пересечений.
Кто это запустил?
Мы хотим поблагодарить:
- сообщество LAION за бесчисленные воркер-ноды по всему облаку
- сообщество любителей собирать данные на Reddit
- а также всех наших друзей и родственников, которые понятия не имели, чему именно они помогают
за запуск воркеров для создания этого огромного датасета всего за несколько месяцев.
2. Постобработка датасета
После запуска распределенного пайплайна, результатом которого стал внушительный набор данных из подписей и URL-адресов, приходит время упаковать его наилучшим образом. Цель этого второго пайплайна — создать такую версию датасета, которую легко использовать для мультимодального обучения. Для этого мы создали инструменты, которые каждый может запустить на основе коллекции подписей и URL-адресов. Точная команда для запуска доступна в cah-prepro (которая в основном использует и clip-retrieval)
Предобработка CSV-файлов с помощью Pyspark
После быстрого запуска скрипта для скачивания CSV-файлов, первым шагом этого пайплайна постобработки является дедупликация по URL и подписи. Первый пайплайн выполняет частичную дедупликацию с использованием фильтра Блума, но она является приблизительной, и некоторые дубликаты остаются. Выполнение такой постобработки в Pyspark также позволяет сократить количество файлов метаданных сотен тысяч до 32 файлов parquet размером 1.7 ГБ. См. этот скрипт дедупликации здесь. Pyspark был бы отличным средством для выполнения любой дальнейшей фильтрации, и мы приводим provide пример для вычисления некоторых статистических данных. Результирующий вывод представляет собой 32 файла parquet, содержащих такие столбцы, как URL, текст, NSFW, описанные в начале публикации.
Img2dataset
Как только этот набор 50-гигабайтных файлов parquet будет готов, мы сможем использовать инструмент , чтобы скачать, изменить размер и сохранить изображения и подписи как webdataset. Этот инструмент может скачать 100 млн изображений за 20 часов на одном узле (1 Гбит/с, 32 ГБ ОЗУ, 16 ядер i7), так что любой желаемый может запустить его для всего набора данных или меньшего подмножества. Формат, который выдает этот инструмент, представляет собой набор tar-файлов (этот формат набора данных называется webdataset), содержащих изображения, подписи и метаданные, а также соответствующие файлы parquet, содержащие те же метаданные.
- 00000.tar размером 270 МБ, содержащий максимум 10 тыс. выборок: 0.jpg, 0.txt, содержащий подпись, 0.json, содержащий метаданные, такие как URL, исходная ширина, данные EXIF, является ли изображение NSFW
- 0.jpg
- 0.txt, содержащий подпись
- 0.json, содержащий метаданные, такие как URL, исходная ширина, данные EXIF, является ли изображение NSFW
- 00000.parquet размером 1.6 МБ, содержащий те же метаданные, что и файл JSON. Полезно для вычисления статистики без чтения всех tar-файлов
Размер tar-архивов в 270 МБ указан при использовании опций img2dataset, указанных здесь download_images.sh (изменение размера всех изображений до 256×256 с отступами для максимальной однородности файлов и предотвращения потери информации). При использовании других опций вы можете получить файлы tar большего или меньшего размера.
Clip retrieval и autofaiss
Наконец, tar-датасет предназначен для вычисления и упаковки эмбеддингов CLIP, а также построения KNN-индекса по ним. Инструмент clip-retrieval позволяет быстро вычислять 100 млн эмбеддингов за 20 часов на одной видеокарте 3080, поэтому перезапуск этого этапа на всем датасете или его части не требует больших затрат. Эмбеддинги хранятся в файлах NPY рядом с файлами parquet в том же порядке. Поскольку этот датасет намного меньше набора с изображениями, каждый файл NPY содержит 1 млн сэмплов. Размер файлов NPY составляет 1 ГБ, а файлов parquet — 150 МБ. Всего насчитывается 400 таких файлов. Эти эмбеддинги помогают построить текстовый и визуальный knn-индекс с помощью инструмента , что позволяет создать квантованный индекс произвольного файла. Выбранный тип индекса занимает 6 ГБ, поэтому любой желающий может легко загрузить его и выполнять быстрые запросы (10 мс) по всему датасету с минимальными затратами. Мы также сгенерировали другой тип индекса размером 16 ГБ. Благодаря отображению памяти (memory mapping) его также можно загружать без расхода оперативной памяти. Простое веб-демо демонстрирует результаты.
Лицензия
Мы распространяем датасет метаданных (файлы parquet) под максимально открытой лицензией Creative Common CC-BY 4.0, которая не накладывает особых ограничений. Изображения защищены их собственными авторскими правами.
Участие в проекте
Вы можете внести свой вклад в проект, чтобы помочь нам выпустить следующие версии датасета размером в 1 миллиард пар, 2 миллиарда пар и так далее.
Выберите один или несколько способов, подходящих вам или вашей компании:
- пожертвовать денежные средства или вычислительное время. Мы также запустили кампанию на Go Get Funding.
- принять участие в разработке
- рассказать о проекте. А лучше всего — использовать датасет, получить отличные результаты и упомянуть его в своих научных статьях
Полезные ссылки:
- Прогресс датасета: Crawling@Home Dashboard и leaderboard
- Пост на Reddit
- DALLE-PyTorch Discord-сервер
- DALLE-PyTorch репозиторий на GitHub
Спонсоры
Мы продвинулись так далеко благодаря щедрости этих доноров: