Мы представляем LAION-400M: 400 млн пар (изображение, текст) — см. также наш Data Centric AI NeurIPS Workshop 2021 paper
Концепция и содержание
Набор данных LAION-400M является полностью открытым и свободно доступным.
ВНИМАНИЕ: имейте в виду, что этот крупномасштабный набор данных не является курируемым. Он был создан для исследовательских целей, чтобы дать возможность тестировать обучение моделей в большем масштабе для широкого круга исследователей и других заинтересованных сообществ, и не предназначен для какого-либо реального производства или применения.
Мы отфильтровали все изображения и тексты в наборе данных LAION-400M с помощью CLIP от OpenAI, вычислив косинусное сходство между текстовыми и визуальными эмбеддингами и отбросив те, у которых сходство ниже 0,3. Порог 0,3 был определен в ходе экспертной оценки и показался хорошей эвристикой для оценки семантического соответствия изображения и текста.
Пары «изображение-текст» были извлечены из веб-дампа Common Crawl и взяты со случайных веб-страниц, просканированных в период с 2014 по 2021 год.
Статистика набора данных LAION-400M
LAION-400M и будущие, еще более крупные наборы, по сути, являются наборами наборов данных. Например, мы можем отфильтровать их по размеру изображений в меньшие наборы данных, такие как этот:
Используя индекс KNN, мы можем извлекать специализированные наборы данных по интересующим доменам. Они достаточны (или будут достаточны) по размеру для обучения моделей в технических областях.
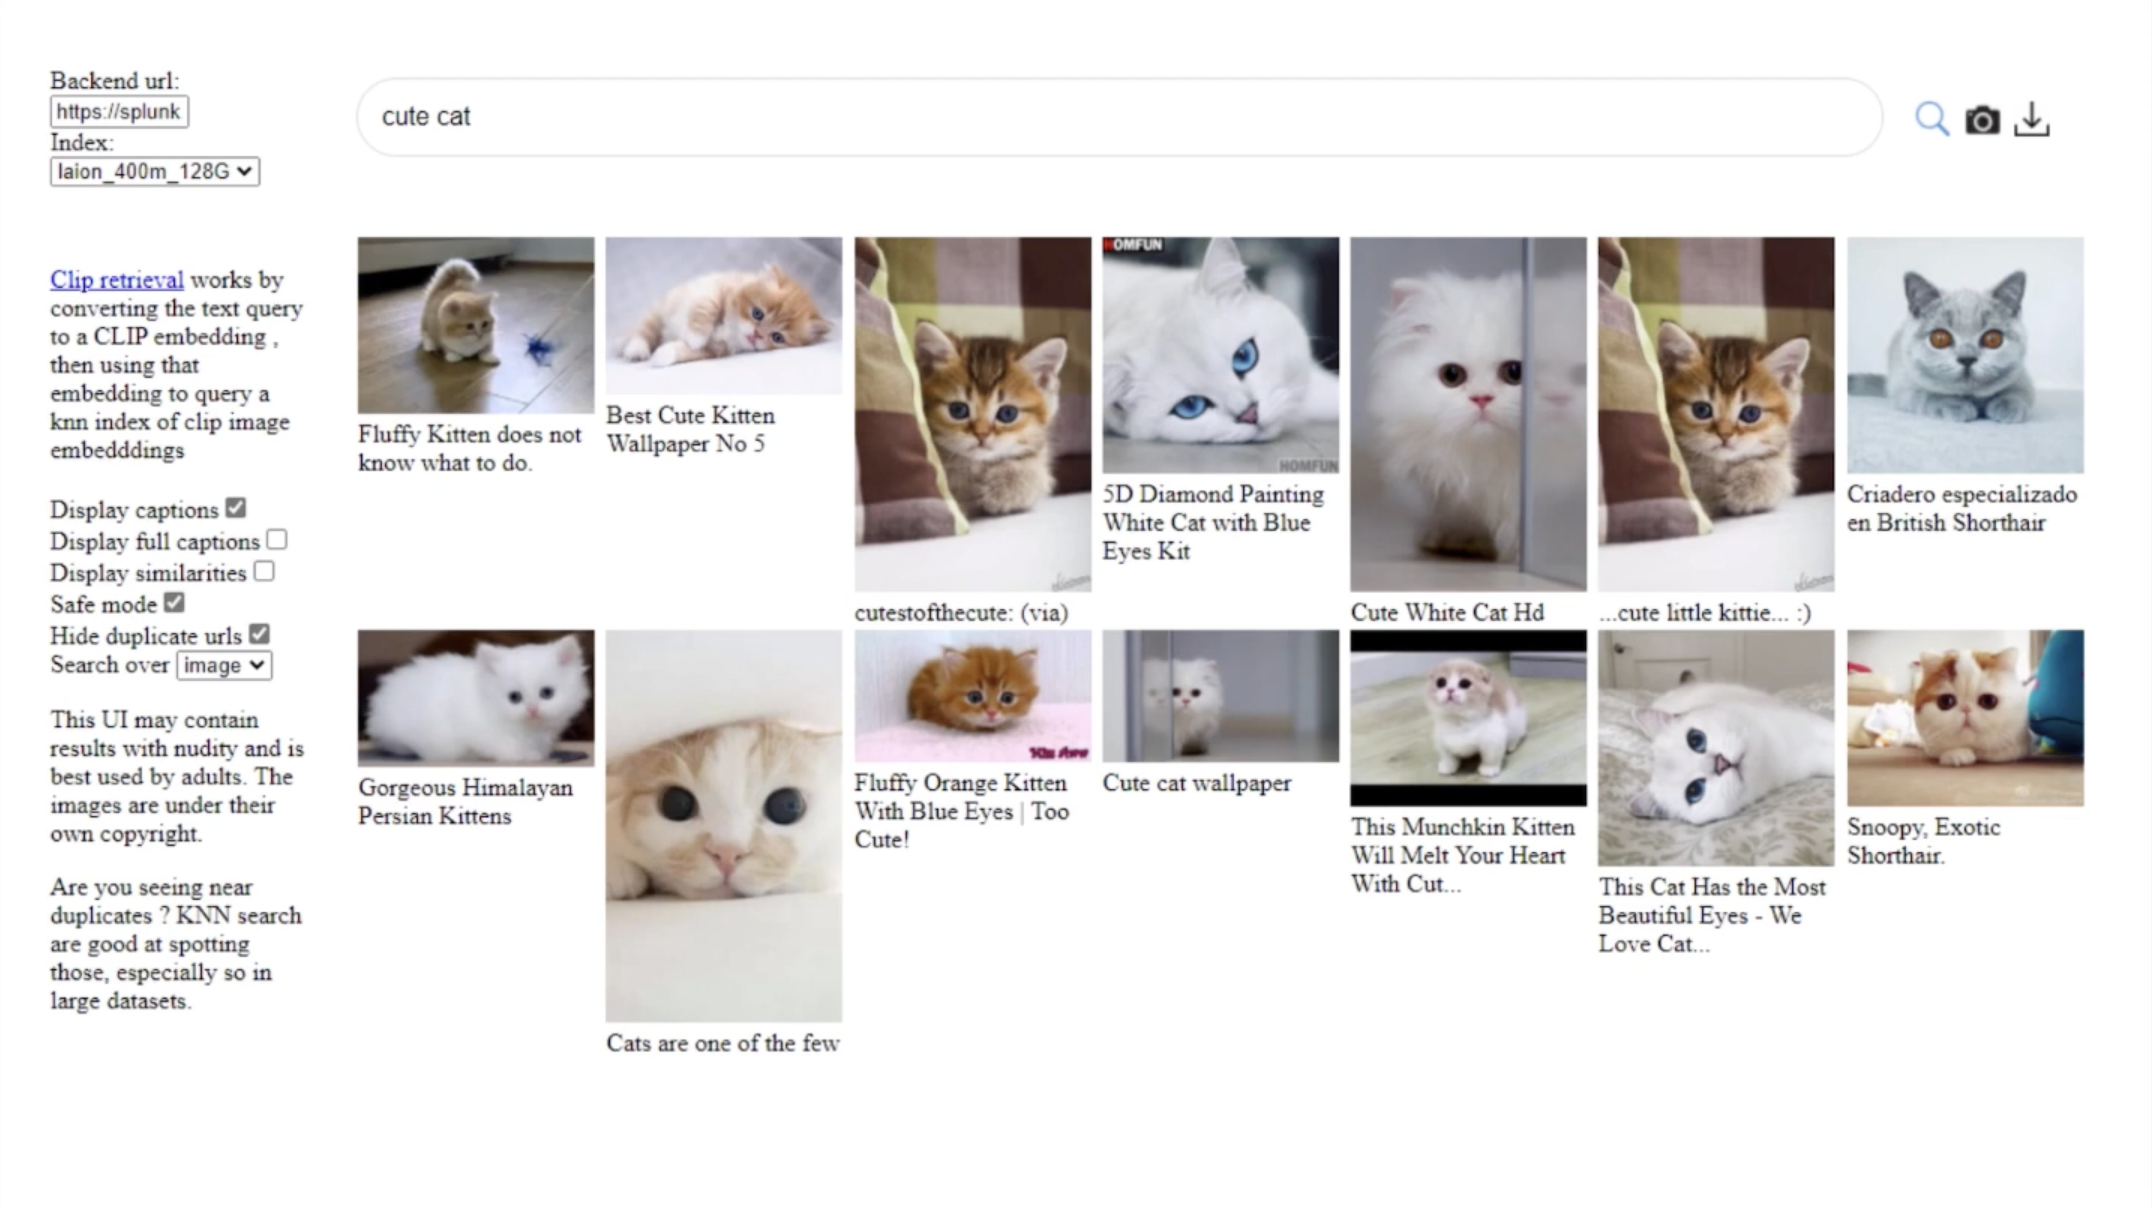
Также используйте https://rom1504.github.io/clip-retrieval/ для простой визуализации набора данных. Там вы можете осуществлять поиск по набору данных, используя CLIP и индекс knn.
Отказ от ответственности и предупреждение о содержании
Наш протокол фильтрации удалял только NSFW-изображения, признанные незаконными, но набор данных по-прежнему содержит NSFW-контент, соответствующим образом отмеченный в метаданных. При свободной навигации по набору данных помните, что это крупномасштабный, некурируемый набор, собранный из интернета в исследовательских целях, поэтому собранные ссылки могут привести к неприятному и тревожному контенту. Пожалуйста, используйте демонстрационные ссылки с осторожностью. Вы можете извлечь «безопасное» подмножество, отфильтровав образцы с NSFW или с помощью более строгой фильтрации CLIP.
Существует определенная степень дублирования, поскольку мы использовали URL+текст в качестве критериев дедупликации. Одно и то же изображение с одной и той же подписью может находиться по разным URL-адресам, что приводит к дубликатам. Однако одно и то же изображение с другими подписями дубликатом не считается.
Использование кластеризации KNN должно упростить дальнейшую дедупликацию по содержанию изображения.
Структура открытого набора данных LAION-400M
Мы подготовили набор данных в нескольких форматах для различных вариантов использования:
- набор метаданных url+подпись объемом 50 ГБ в файлах parquet. Мы можем использовать метаданные для вычисления статистики и повторной загрузки части набора данных
- 10 ТБ webdataset с изображениями 256×256, подписями и метаданными. Это полная версия набора данных, которую можно использовать непосредственно для обучения (она предназначена для внутреннего использования, вам нужно самостоятельно повторно загрузить изображения из-за проблем с лицензированием)
- набор из 1 ТБ текстовых и визуальных clip-эмбеддингов для 400 млн пар, полезный для создания новых индексов knn
- пары индексов knn объемом 16 ГБ, 32 ГБ, 64 ГБ и 128 ГБ (работающие в веб-демо)
Набор метаданных URL и подписей
Мы предоставляем 32 файла parquet размером около 1 ГБ (всего 50 ГБ) с URL-адресами изображений, связанными текстами и дополнительными метаданными в следующем формате:
SAMPLE_ID | URL | TEXT | LICENSE | NSFW | similarity | WIDTH | HEIGHT
SAMPLE_ID | URL | TEXT | LICENSE | NSFW | similarity | WIDTH | HEIGHT
где
- SAMPLE_ID: Уникальный идентификатор
- LICENSE: Если мы находили лицензию Creative Commons в данных изображения, мы указывали ее здесь, например, “creativecommons.org/licenses/by-nc-sa/3.0/” – в противном случае вы найдете здесь “?”
- NSFW: мы использовали CLIP для оценки того, содержит ли изображение NSFW-контент. Оценка была довольно консервативной, что уменьшило количество ложноотрицательных результатов ценой увеличения количества ложноположительных. Возможные значения: “UNLIKELY” (маловероятно), “UNSURE” (неуверенно) и “NSFW”.
- similarity: Значение косинусного сходства между текстовым и визуальным эмбеддингом
- WIDTH и HEIGHT: размер изображения на момент встраивания. Мы уменьшили оригиналы, которые были больше 4K, до 4K.
Цель этого набора метаданных — загрузить изображения для всего набора данных или его части, предоставив их очень эффективному инструменту img2dataset.
10 ТБ webdataset с изображениями и подписями
Запустив инструмент img2dataset, мы можем загрузить 10 ТБ webdataset. Он изменит размер всех изображений до разрешения 256×256, добавит соответствующую подпись и создаст коллекцию tar-файлов (этот формат набора данных называется webdataset), содержащих изображения, подписи, метаданные и соответствующие файлы parquet, содержащие те же метаданные
- 00000.tar размером 270 МБ, содержащий не более 10 тыс. образцов 0.jpg 0.txt, содержащий подпись 0.json, содержащий метаданные, такие как URL, исходная ширина, данные EXIF, является ли изображение NSFW
- 0.jpg
- 0.txt, содержащий подпись
- 0.json, содержащий метаданные, такие как URL, исходная ширина, данные EXIF, является ли изображение NSFW
- 00000.parquet размером 1,6 МБ, содержащий те же метаданные, что и JSON-файл. Полезно для вычисления статистики без чтения всех tar-файлов
Таким образом, набор данных 400M будет состоять из 41455 tar-файлов и 41455 parquet-файлов. Цель этого набора данных — обучение мультимодальных моделей, таких как CLIP или DALL-E.
1 ТБ clip-эмбеддингов
Clip-эмбеддинги хранятся в файлах NPY рядом с файлами parquet в том же порядке. Поскольку этот набор данных намного меньше, чем набор изображений, каждый файл NPY хранит 1 млн образцов. Каждый файл NPY имеет размер 1 ГБ, а каждый файл parquet — 150 МБ. Всего существует 400 таких файлов. Цель эмбеддингов — вычисление статистики по набору данных, например, с использованием кластеризации или индексов knn.
Два небольших индекса knn по 6 ГБ
Мы предоставляем два индекса knn по 6 ГБ, созданных с использованием autofaiss. Мы можем использовать их для вычисления подмножества набора данных и, в более широком смысле, для эффективного поиска по нему. См. поисковое веб-демо этого инструмента. Мы можем использовать инструмент фильтрации CLIP вместе с этим индексом для эффективного создания подмножеств с использованием поисковых терминов. Мы также предоставляем два индекса knn по 16 ГБ более высокого качества.
Что мы можем сделать с набором данных LAION-400M?
Моделирование зрения и языка начало активно развиваться в 2021 году. Вот несколько указаний на то, что открывают такие наборы данных «изображение + текст» и почему это кажется интересным:
- Шесть месяцев назад OpenAI опубликовала два поста в блоге и статьи, и DALL-E. Обе модели опираются на большое количество пар (текст, изображение). Они использовали невыпущенный набор данных из 400 млн пар. CLIP — это модель, которая вычисляет, насколько связаны текст и изображение. Это позволяет создавать крупномасштабный поиск по тексту для изображений, а также создавать такие безумные виды искусства «текст в изображение» clip-art. Они выпустили малую и среднюю версии модели, но не код обучения. DALL-E — это модель, которая генерирует изображения непосредственно из текстов. Как видно из поста в блоге, она достигает впечатляющих результатов, которые могут напрямую повлиять на мир во всем, что требует рисования и иллюстраций. OpenAI не выпустила никакой модели, даже через API
- CLIP — это модель, которая вычисляет, насколько связаны текст и изображение. Это позволяет создавать крупномасштабный поиск по тексту для изображений, а также создавать такие безумные виды искусства «текст в изображение» . Они выпустили малую и среднюю версии модели, но не код обучения.
- DALL-E — это модель, которая генерирует изображения непосредственно из текстовых описаний. Как можно заметить из публикации в блоге, она достигает впечатляющих результатов, которые могут напрямую повлиять на мир во всем, что требует рисования и иллюстраций. OpenAI не выпустила никакой модели, даже через API.
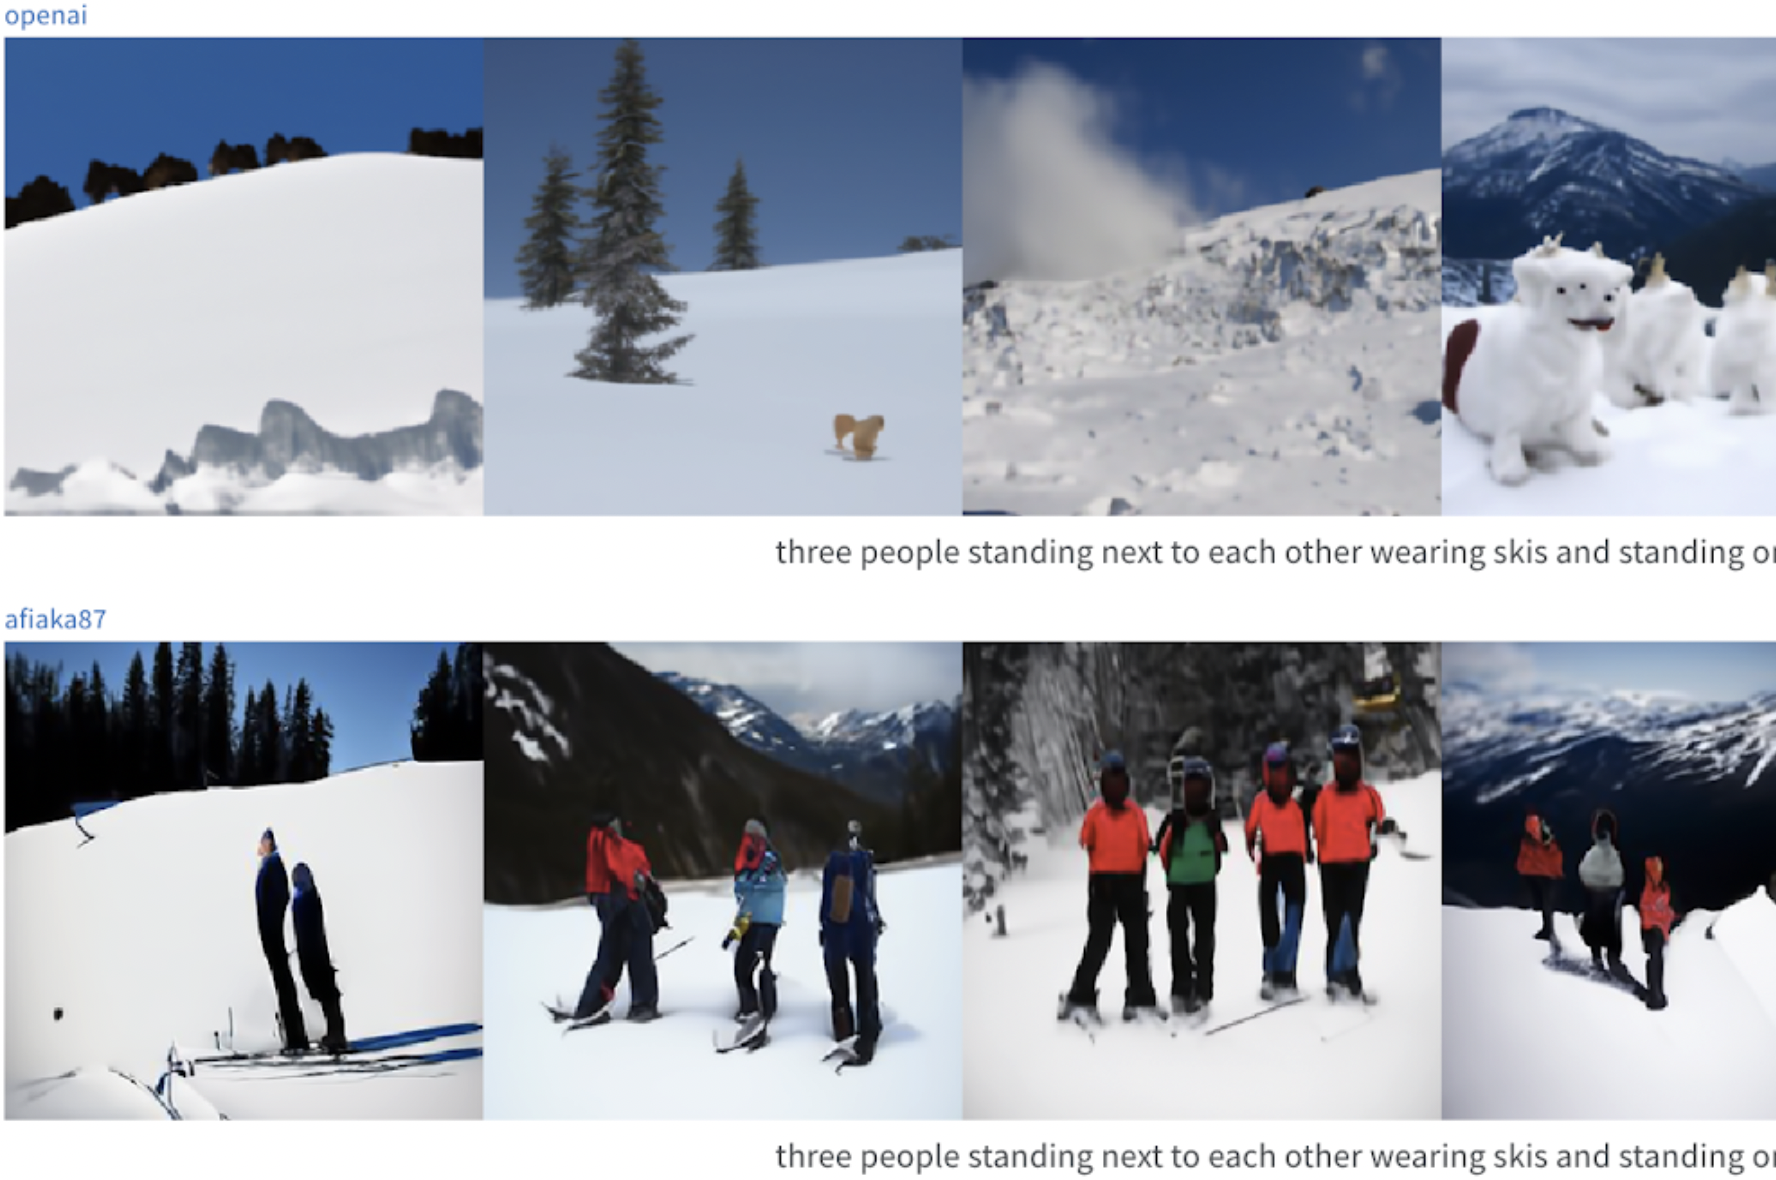
С тех пор различные исследователи организовали несколько попыток воспроизвести DALL-E. Изначально люди объединились вокруг этого отличного репозитория для репликации DALLE DALLE-PyTorch с некоторыми фантастическими результатами, которые можно увидеть в файле readme. Совсем недавно, в рамках мероприятий huggingface, были достигнуты новые успехи (см. отчет DALLE-mini ), и теперь доступна онлайн-демоверсия по адресу DALLE-mini demo.
Усилия по репликации все еще далеки от достижения той же производительности, что и у оригинальной DALLE, и кажется возможным пойти еще дальше. Некоторые люди также хотят создать лучший CLIP для получения еще более качественного сгенерированного искусства.
Значительная часть результатов, которых мы можем достичь с помощью таких моделей, обусловлена большим объемом данных. До появления LAION-400M крупнейший открытый набор данных для пар (изображение, текст) был порядка 10 миллионов (см. DALLE-datasets ), чего достаточно для обучения интересных моделей, но недостаточно для достижения наилучшей производительности. Наличие общедоступного набора данных с сотнями миллионов пар поможет в создании этих моделей «изображение + текст».
Анализ данных LAION-400M
Мы аннотировали 3456 образцов набора данных и получили следующие результаты:
- Правильно определенный NSFW: 4
- Правильно определенный не-NSFW: 3371
- Ложноположительный NSFW: 73
- Ложноотрицательный NSFW: 8
- Плохие подписи: 3 (0,09 %)
Соответствие отличное, благодаря CLIP. В будущем мы могли бы улучшить автоматическую маркировку NSFW; однако общий уровень NSFW достаточно низок (менее 1%), чтобы это не было проблемой.
Технические детали
Получение набора данных состояло из двух значительных частей:
- распределенная обработка огромных (многие ПБ) наборов данных Common Crawl, которая создает коллекцию соответствующих URL-адресов и подписей
- гораздо более легкая постобработка данных на одном узле, которую любой может запустить за несколько дней и которая создает финальный набор данных
1. Распределенная обработка Common Crawl
Мы получаем необработанные веб-данные для создания нашего набора данных из Common Crawl. Common Crawl — это некоммерческая организация, занимающаяся предоставлением копии интернета исследователям, компаниям и частным лицам бесплатно для исследований и анализа. Они регулярно выпускают дампы данных, похожих на HTML, проанализированные из миллиардов общедоступных веб-сайтов, найденных на веб-сайте Common Crawl. Чтобы создать пары «изображение-текст», мы просматриваем данные из Common Crawl и извлекаем все HTML-теги IMG, содержащие атрибут alt-текста. Common Crawl предоставляет свои данные в нескольких форматах. Для наших целей мы решили использовать данные в формате WAT. Файлы WAT содержат только метаданные просканированных сайтов, которые включают все ссылки и теги IMG, содержащиеся на веб-сайте. Анализ только этих метаданных намного быстрее, чем анализ всего HTML-текста (предоставленного в формате WARC).
Загрузка оригинальных изображений
Мы загружаем необработанные изображения по URL-адресам, которые мы проанализировали из Common Crawl, с помощью асинхронных запросов, используя библиотеки Trio и Asks. Они позволяют нам использовать многопоточность для одного процессора. Обычно домашнее интернет-соединение будет исчерпано одним или двумя процессорами. Узел центра обработки данных может масштабироваться, получая выгоду от гарантированной скорости интернета с пулом многопроцессорной обработки, гораздо быстрее, чем узел с одним процессором. В то время мы смогли использовать 50 ядер с полным защищенным соединением 1 Гбит/с с общедоступным интернетом. Эта пропускная способность должна быть доступна узлу загрузки, а не распределяться между многими узлами или приложениями. Мы оптимизировали скрипт для скорости, одновременно смягчая различные ошибки, с которыми мы столкнулись. Обычно, чтобы удовлетворить высокопроизводительный требовательный узел, подобный вышеуказанному, мы должны предпринять дополнительные шаги для обеспечения возможностей кэширования DNS. Мы обнаружили, что knot-resolver, запущенный с двумя процессами и настроенный с опцией кэширования, может решить эту проблему.
Фильтрация неподходящих пар «изображение-текст»
После загрузки файлов WAT из Common Crawl мы фильтруем образцы на следующих этапах:
- Мы отбросили все образцы с длиной alt-текста менее пяти символов
- Мы отбросили все образцы с размером изображения менее 5 КБ
- Мы используем постоянно обновляемые фильтры Блума, чтобы отбрасывать образцы, которые уже есть в нашем наборе данных. Фильтры Блума дедуплицируют путем объединения URL-адреса и alt-текста.
- Мы используем постоянно обновляемые фильтры Блума, чтобы отбрасывать образцы с URL-адресов, которые ранее истекли по времени и поэтому кажутся недоступными (или, по крайней мере, недоступными эффективным способом)
- Мы используем модель CLIP от OpenAI (версия «ViT-B-32») для вычисления эмбеддингов изображения и alt-текста. Затем мы вычисляем косинусное сходство обоих векторов эмбеддингов и отбрасываем все образцы со сходством ниже 0,3. Мы выбрали этот порог после опробования различных значений и использования человеческих оценок того, насколько хорошо тексты соответствуют изображениям. Более низкие значения, такие как 0,28 или 0,29, также казались нормальными во многих случаях, но после дальнейших проверок мы решили выбрать консервативное значение 0,3.
- Мы используем эмбеддинги CLIP изображений, чтобы оценить, содержит ли их содержимое контент NSFW. Мы делаем это путем вычисления эмбеддингов CLIP для списка категорий изображений, таких как, например, «селфи», «иллюстрация» или «пейзаж», который также содержит категории, указывающие на контент NSFW, такие как «порно» и «секс».
- Затем мы вычисляем косинусное сходство между эмбеддингом изображения, которое мы в данный момент фильтруем, и каждым из этих ключевых слов категорий. Если категория с наивысшим сходством и ключевое слово со вторым по величине сходством оба принадлежат к ключевым словам NSFW, мы помечаем образец как «NSFW». Если только одно из них принадлежит к ключевому слову NSFW, мы классифицируем образец как «UNSURE» (неуверенно). Если оба ключевых слова с наивысшими сходствами не являются NSFW, мы помечаем образец как «UNLIKELY» (маловероятно).
- На следующем этапе мы просматриваем все образцы с тегом «NSFW» или «UNSURE» и отбрасываем те, в тексте которых есть какие-либо ключевые слова, связанные с детьми, подростками или другим семантически связанным контентом.
- На шаге 8 мы повторяем процедуру вычисления косинусного сходства с шага 6 с той разницей, что теперь мы используем тексты категорий, которые указывают на контент, семантически связанный с детьми и подростками на уровне эмбеддинга CLIP. Если либо наивысшее сходство, либо второе по величине сходство между эмбеддингом изображения образца и текстом предварительно вычисленных категорий принадлежит тексту, который указывает на контент, связанный с несовершеннолетними лицами, мы отбрасываем этот образец.
- Наконец, мы повторяем процедуру с шага 8 с текстами, семантически связанными с категориями животных, такими как, например, «животное», «птица» и т. д.
Мы выполняем эти строгие этапы фильтрации NSFW-контента с потенциально незаконным содержанием, поскольку не можем гарантировать, что материалы Common Crawl свободны от такового. Мы считаем своим долгом сделать все возможное, чтобы отфильтровать подобный контент. Проверка образцов, отфильтрованных на этапах с 7 по 9, показала, что наша процедура фильтрации очень консервативна и дает много ложноположительных результатов (отбрасывает образцы, которые не являются проблемными). Такой процесс допустим, поскольку количество потенциальных образцов, ожидающих обработки, огромно.
Архитектура системы
Для координации взаимодействия множества скриптов сканирования (называемых воркерами) в нашем проекте мы используем сервер, который отслеживает обработанные WAT-файлы и то, какой воркер получает необработанный WAT. Мы называем этот координирующий сервер трекером. Его функции включают предоставление задач как воркерам загрузки, так и воркерам вывода (inference workers), подтверждение запросов на очистку от промежуточного сервера DL, ведение списков контроля доступа (ACL) для сервера Bloom и многое другое. Мы также используем несколько промежуточных серверов в качестве буферов для задач на пути к месту хранения. Промежуточные серверы постоянно обновляют фильтры на центральном сервере Bloom, где мы используем RedisBloom для обеспечения высокой производительности.
Рабочий процесс
В процессе развития нашего проекта по сканированию мы применяли два разных рабочих процесса:
Этот воркер выполняет все вычислительные этапы в рамках одной задачи, а затем отправляет результат на промежуточный сервер. После этого он ставит результаты в очередь для передачи в хранилище.
Вскоре мы обнаружили, что лучший способ использования ресурсов — это разделение рабочей нагрузки на задачи CPU + сеть (этапы загрузки) и задачи GPU (этапы вывода CLIP). Таким образом, двухэтапный подход использует «CPU-воркеры» для загрузки изображений, создания пар «изображение-текст» и сохранения промежуточного результата на промежуточном сервере. Затем «GPU-воркеры» забирают задачи и объединяют их в группы примерно по 20 000 пар на каждый итоговый файл. Двухэтапный рабочий процесс оказался наиболее эффективным: скорость добавления в набор данных достигала 25 миллионов пар в день при использовании 100 CPU-воркеров с одним ядром и одного GPU-воркера с видеокартой NVidia RTX 3090, использующей все 16 линий шины PCIe. GPU-узлу также требуется около 24 потоков CPU, чтобы справляться с вычислительной мощностью GPU.
Устранение блокировок
Во время загрузки мы сталкивались с предупреждениями о злоупотреблениях от ручных и автоматизированных инструментов, защищающих веб-сайты. После некоторого обучения мы устранили большинство проблем, применив следующие методы смягчения:
- Безусловно, самым эффективным методом стало использование централизованных фильтров Блума, которые исключают повторные запросы к одним и тем же URL-адресам. Конечно, эффективность этих фильтров сильно зависит от того, насколько быстро они обновляются и используются воркерами. По определению, наличие нескольких воркеров загрузки, выполняющих задачи параллельно, делает их склонными к дублированию запросов к одному и тому же URL, даже если фильтры Блума были актуальны в начале задачи.
- Поэтому вторая техника значительно уменьшила проблему параллельных воркеров за счет рандомизации задач на уровне сервера-трекера. Выполняя задачи последовательно (начиная с самых старых WAT-файлов 2013 года), мы обнаружили, что соседние задачи значительно перекрываются. Когда мы рандомизировали задачи, мы увидели резкое сокращение таких наложений.
Кто это запустил?
Мы хотим поблагодарить:
- команду LAION за множество воркер-узлов по всему облаку
- сообщество data hoarders на Reddit
- а также всех наших друзей и родственников, которые даже не знали, чему они помогают
за запуск воркеров, позволивших создать этот огромный набор данных за несколько месяцев.
2. Постобработка набора данных
После того как распределенный конвейер завершил работу, результатом которой стал внушительный набор данных с подписями и URL, пришло время упаковать его наилучшим образом. Цель этого второго конвейера — создать версию набора данных, которую легко использовать для мультимодального обучения. Для этого мы создали инструменты, которые может запустить любой желающий, имея коллекцию пар «подпись + URL». Точная командная строка для запуска доступна в cah-prepro (в основном используются и clip-retrieval )
Pyspark-препроцессинг CSV-файлов
После быстрого запуска скрипта для загрузки CSV-файлов, первым шагом этого конвейера постобработки является дедупликация по паре «URL + подпись». Первый конвейер выполняет частичную дедупликацию с помощью фильтра Блума, но она является приблизительной, и некоторые дубликаты остаются. Выполнение постобработки через Pyspark также позволяет сократить количество файлов метаданных с сотен тысяч до 32 parquet-файлов размером 1,7 ГБ. См. этот скрипт дедупликации здесь. Pyspark был бы отличным способом для любой дальнейшей фильтрации, и мы provide приводим пример вычисления некоторых статистических данных. Итоговый результат — 32 parquet-файла, содержащие такие столбцы, как URL, текст, NSFW, описанные в начале поста.
Img2dataset
Как только этот набор parquet-файлов объемом 50 ГБ готов, мы можем использовать инструмент для загрузки, изменения размера и сохранения изображений и подписей в формате webdataset. Этот инструмент может загрузить 100 млн изображений за 20 часов на одном узле (1 Гбит/с, 32 ГБ ОЗУ, 16 ядер i7), поэтому любой может запустить его для всего набора данных или его меньшего подмножества. Формат, который выдает этот инструмент, представляет собой коллекцию tar-файлов (этот формат набора данных называется webdataset), содержащих изображения, подписи, метаданные и соответствующие parquet-файлы, содержащие те же метаданные.
- 00000.tar размером 270 МБ, содержащий не более 10 тыс. образцов: 0.jpg, 0.txt с подписью, 0.json с метаданными, такими как URL, исходная ширина, данные EXIF, является ли изображение NSFW
- 0.jpg
- 0.txt, содержащий подпись
- 0.json, содержащий метаданные, такие как URL, исходная ширина, данные EXIF, является ли изображение NSFW
- 00000.parquet размером 1,6 МБ, содержащий те же метаданные, что и JSON-файл. Полезен для вычисления статистики без чтения всех tar-файлов
Размер tar-файлов в 270 МБ достигается при использовании опций img2dataset, указанных здесь download_images.sh (изменение размера всех изображений до 256×256 с дополнением для максимальной однородности файлов и предотвращения потери информации). При использовании других опций вы можете получить файлы большего или меньшего размера.
Clip retrieval и autofaiss
Наконец, набор данных tar предназначен для вычисления и упаковки эмбеддингов клипов, а также для вычисления индекса KNN для этих эмбеддингов. Инструмент clip-retrieval позволяет быстро вычислять 100 миллионов эмбеддингов за 20 часов на одном графическом процессоре 3080, поэтому можно с низкими затратами повторно запустить эту часть для всего набора данных или его подмножества. Эмбеддинги хранятся в файлах NPY рядом с файлами parquet в том же порядке. Поскольку этот набор данных намного меньше, чем набор изображений, каждый файл NPY хранит 1 миллион образцов. Файлы NPY имеют размер 1 ГБ, а файлы parquet — 150 МБ. Всего существует 400 таких файлов. Эти эмбеддинги помогают создать индекс KNN для текста и изображений с помощью инструмента , что позволяет создавать квантованный индекс произвольного файла. Выбранный тип индекса занимает 6 ГБ, поэтому любому пользователю будет недорого загрузить его и выполнять быстрые (10 мс) запросы по всему набору данных. Мы также создали другой тип индекса размером 16 ГБ. Благодаря отображению в память его также можно загрузить без использования оперативной памяти. Простая веб-демонстрация показывает результаты.
Лицензия
Мы распространяем набор метаданных (файлы parquet) по наиболее открытой лицензии Creative Common CC-BY 4.0, которая не накладывает никаких особых ограничений. Изображения защищены авторским правом.
Участие в проекте
Вы можете внести свой вклад в проект, чтобы помочь нам выпустить следующие версии набора данных объемом 1 миллиард пар, 2 миллиарда пар и так далее.
Выберите один или несколько способов, которые подходят вам или вашей компании:
- пожертвовать денежные средства или вычислительные мощности. Мы также запустили кампанию по сбору средств Go Get Funding.
- принять участие в разработке
- рассказать о проекте. В идеале — используйте набор данных, получайте хорошие результаты и упоминайте его в своих статьях.
Полезные ссылки:
- Ход работы над набором данных Crawling@Home Dashboard и leaderboard
- Публикация на Reddit
- Сервер Discord DALLE-PyTorch
- Репозиторий GitHub DALLE-PyTorch
Спонсоры
Мы достигли таких результатов благодаря щедрости этих спонсоров: