Мы представляем набор данных из 5,85 миллиардов пар «изображение-текст», отфильтрованных с помощью CLIP, что в 14 раз больше, чем LAION-400M, ранее бывший крупнейшим открытым набором данных «изображение-текст» в мире — см. также наше NeurIPS2022 paper
Ознакомьтесь с нашим обновлением по набору данных LAION-5B.
Крупные модели «изображение-текст», такие как ALIGN, BASIC, Turing Bletchly, FLORENCE и GLIDE, показали все более высокую производительность по сравнению с предыдущими флагманскими моделями, такими как CLIP и DALL-E. Большинство из них были обучены на миллиардах пар «изображение-текст», и, к сожалению, до сих пор не было открыто доступных наборов данных такого размера. Чтобы решить эту проблему, мы представляем LAION 5B, масштабный набор данных для исследовательских целей, состоящий из 5,85 млрд пар «изображение-текст», отфильтрованных с помощью CLIP. 2,3 млрд содержат английский язык, 2,2 млрд образцов — на 100+ других языках, а 1 млрд образцов имеют тексты, для которых невозможно определить конкретный язык (например, имена). Кроме того, мы предоставляем несколько индексов ближайших соседей, улучшенный веб-интерфейс для исследования и создания подмножеств, а также оценки обнаружения водяных знаков и NSFW-контента. Мы также объявляем о полной репродукции обучения CLIP, обученного на LAION-400M, по адресу open_clip. Изучите набор данных в демо-версии поиска. См. также тот же пост на веб-сайте laion.
Мы благодарим наших спонсоров hugging face, doodlebot и stability за предоставление нам вычислительных ресурсов для создания этого набора данных! Мы также благодарим the-eye.eu за хостинг эмбеддингов изображений и копии всего набора данных.
Отказ от ответственности относительно цели набора данных и предупреждение о содержании
Мотивация создания набора данных заключается в демократизации исследований и экспериментов в области обучения крупномасштабных мультимодальных моделей и обработки некурируемых масштабных наборов данных, собранных из общедоступного интернета. Поэтому мы рекомендуем использовать этот набор данных в исследовательских целях. Помните, что этот масштабный набор данных не является курируемым. Имейте в виду, что некурируемый характер набора данных означает, что собранные ссылки могут привести к контенту, который может вызвать сильный дискомфорт и беспокойство у человека-зрителя. Поэтому, пожалуйста, используйте демонстрационные ссылки с осторожностью и на свой страх и риск. Можно извлечь «безопасное» подмножество, отфильтровав образцы на основе тегов безопасности (используя специально обученный классификатор NSFW, который мы создали). Хотя это значительно снижает вероятность столкновения с потенциально вредоносным контентом при просмотре, мы не можем полностью исключить возможность его присутствия даже в безопасном режиме, поэтому предупреждение остается в силе и там. Мы считаем, что открытое предоставление набора данных широкому кругу исследователей и другим заинтересованным сообществам позволит прозрачно исследовать преимущества, которые приходят вместе с обучением масштабных моделей, а также выявить подводные камни и опасности, которые могут оставаться незамеченными при работе с закрытыми крупными наборами данных, доступными лишь узкому кругу лиц. Предоставляя наш набор данных открыто, мы, однако, не рекомендуем использовать его для создания готовых промышленных продуктов, поскольку фундаментальные исследования общих свойств и безопасности таких масштабных моделей, которые мы хотели бы поощрить этим выпуском, все еще продолжаются.
Введение
С момента выпуска CLIP и DALL-E в январе 2021 года несколько похожих крупных мультимодальных моделей «язык-зрение» были обучены большими группами. Модели, такие как FLORENCE, Turing Bletchley, ALIGN и BASIC, продемонстрировали очень сильные возможности переноса на новые наборы данных при отсутствии меток для каждого образца, которые также постоянно улучшались по мере увеличения объема обучающих данных, следуя законам масштабирования, наблюдаемым в предыдущих исследованиях. Этим моделям требуются миллиарды пар «изображение-текст» для достижения конкурентоспособных результатов, и, к сожалению, до сих пор не было открыто доступных наборов данных такого масштаба. Чтобы решить эту проблему, мы выпускаем LAION 5B, отфильтрованный с помощью CLIP набор данных из 5,85 миллиардов высококачественных пар «изображение-текст», их эмбеддингов CLIP ViT-L/14, индексов kNN, веб-интерфейса для исследования и создания подмножеств, а также оценок и инструментов для обнаружения NSFW-контента и водяных знаков. Мы описываем процедуру создания набора данных и демонстрируем успешное обучение архитектуры DALL-E. Обладая достаточно большими масштабами, набор данных открывает возможности для исследований мультимодальных моделей «язык-зрение» для широкого сообщества.
Лицензия
Мы распространяем набор метаданных (файлы parquet) под лицензией Creative Common CC-BY 4.0, которая не накладывает никаких особых ограничений. Изображения защищены авторским правом их владельцев.
Столбцы набора данных
Мы предоставляем следующие столбцы:
- URL: URL-адрес изображения, охвачены миллионы доменов
- TEXT: подписи, на английском для en, на других языках для multi и nolang
- WIDTH: ширина изображения
- HEIGHT: высота изображения
- LANGUAGE: язык образца, только для laion2B-multi, вычислен с использованием cld3
- similarity: косинусное сходство между эмбеддингами текста и изображения ViT-B/32, clip для en, mclip для multi и nolang
- pwatermark: вероятность того, что изображение содержит водяной знак, вычислена с использованием нашего детектора водяных знаков
- punsafe: вероятность того, что изображение является небезопасным, вычислена с использованием нашего детектора на основе clip
pwatermark и punsafe доступны либо как отдельные коллекции, которые должны быть joined с хешем url+text, либо как предварительно объединенные коллекции.
Статистика набора данных
Мы computed некоторую статистику по наборам данных, чтобы люди могли лучше понять их: образцы считаются небезопасными, если модель предсказывает это с вероятностью более 0,5. Более 0,8 — для водяного знака. Эти значения довольно консервативны, поэтому предполагаемая доля безопасного контента и водяных знаков может быть выше реальной. Могут быть выбраны другие пороговые значения для получения другого компромисса между точностью и полнотой.
Вычисленные квантили — это квантили от 0,05 до 0,95.
Также см. полный sheet и полный dashboard
Laion2B-en
Всего: 2,3 млрд образцов
Количество с высотой и шириной больше чем
- 256 -> 1324 млн
- 512 -> 488 млн
- 1024 -> 76 млн
Квантили ширины: 132.0, 160.0, 180.0, 210.0, 225.0, 240.0, 262.0, 300.0, 309.0, 340.0, 400.0, 450.0, 480.0, 512.0, 600.0, 656.0, 760.0, 960.0, 1050.0
Квантили высоты: 125.0, 150.0, 166.0, 188.0, 208.0, 225.0, 250.0, 270.0, 300.0, 320.0, 350.0, 380.0, 418.0, 470.0, 500.0, 600.0, 672.0, 800.0, 1014.0
Доля небезопасного контента: 2,9%
Доля водяных знаков: 6,1%
Средняя длина текста: 67
Квантили длины текста: 21.0, 25.0, 30.0, 33.0, 37.0, 40.0, 43.0, 47.0, 50.0, 54.0, 58.0, 62.0, 67.0, 72.0, 78.0, 85.0, 96.0, 114.0, 152.0
Laion2B-multi
Всего: 2,2 млрд образцов
Количество с высотой и шириной больше чем
- 256 -> 1299 млн
- 512 -> 480 млн
- 1024 -> 57 млн
Квантили ширины: 140.0, 160.0, 188.0, 205.0, 235.0, 250.0, 284.0, 300.0, 324.0, 366.0, 420.0, 480.0, 520.0, 600.0, 640.0, 720.0, 800.0, 960.0, 1080.0
Квантили высоты: 120.0, 144.0, 160.0, 180.0, 200.0, 217.0, 240.0, 262.0, 300.0, 320.0, 350.0, 394.0, 416.0, 458.0, 500.0, 564.0, 636.0, 725.0, 1000.0
Топ-10 языков: LANGUAGE количество доля:
- ru 241 млн 0.106
- fr 168 млн 0.074
- de 150 млн 0.066
- es 149 млн 0.066
- zh 143 млн 0.063
- ja 131 млн 0.057
- it 95 млн 0.042
- pt 88 млн 0.038
- nl 66 млн 0.029
- pl 62 млн 0.027
- no 49 млн 0.021
Доля небезопасного контента: 3,3%
Доля водяных знаков: 5,6%
Средняя длина текста: 52
Квантили длины текста: 12.0, 16.0, 20.0, 23.0, 27.0, 30.0, 33.0, 37.0, 40.0, 44.0, 48.0, 52.0, 57.0, 61.0, 67.0, 74.0, 81.0, 93.0, 120.0
Laion1B-nolang
Всего: 1.2 млрд образцов
Количество с высотой и шириной больше чем
- 256 -> 1324 млн
- 512 -> 488 млн
- 1024 -> 76 млн
Квантили ширины: 135.0, 160.0, 181.0, 207.0, 225.0, 241.0, 264.0, 300.0, 306.0, 338.0, 398.0, 426.0, 499.0, 520.0, 600.0, 655.0, 768.0, 940.0, 1080.0
Квантили высоты: 118.0, 144.0, 160.0, 186.0, 200.0, 220.0, 240.0, 260.0, 292.0, 305.0, 338.0, 368.0, 405.0, 456.0, 500.0, 562.0, 637.0, 768.0, 1000.0
Доля небезопасного контента: 3%
Доля водяных знаков: 4%
Средняя длина текста: 46
Квантили длины текста: 13.0, 17.0, 20.0, 23.0, 26.0, 29.0, 32.0, 35.0, 38.0, 41.0, 44.0, 48.0, 51.0, 56.0, 60.0, 67.0, 73.0, 82.0, 99.0
Конвейер сбора данных
Конвейер сбора данных следует приведенной выше блок-схеме и может быть разделен на три основных компонента:
- Распределенная обработка набора данных Common Crawl петабайтного масштаба, в результате которой создается коллекция соответствующих URL-адресов и подписей (этап предварительной обработки)
- Распределенная загрузка изображений на основе перемешанных данных для выбора правильного распределения URL-адресов, чтобы избежать слишком высоких нагрузок на отдельные веб-сайты
- Постобработка данных на нескольких GPU-узлах, которая является гораздо менее ресурсоемкой и может быть выполнена за несколько дней, создавая финальный набор данных.
Распределенная обработка Common Crawl
Для создания пар «изображение-текст» мы анализируем WAT-файлы из Common Crawl и извлекаем все HTML-теги IMG, содержащие атрибут alt-текста. В то же время мы выполняем определение языка текста с тремя возможными результатами: английский язык с уровнем уверенности, другой язык с уровнем уверенности, отсутствие языка (включает «не определено» и «определение ниже порога уверенности»). Набор «без языка» часто содержит короткие тексты, в основном с именами людей и названиями мест. Вся информация, извлеченная рабочими процессами предварительной обработки, упаковывалась и отправлялась на узел Postgresql для хранения с помощью команды COPY. Сервер Postgresql поддерживался на уровне около 500 млн записей путем балансировки входящих и исходящих данных из базы данных.
Распределенная загрузка изображений
Мы загружаем необработанные изображения по проанализированным URL-адресам с помощью асинхронных запросов, используя библиотеки Trio и Asks, чтобы максимально использовать все ресурсы: vCPU, оперативную память и пропускную способность. Мы обнаружили, что один облачный узел с 1-2 vCPU, 0.5-1 ГБ оперативной памяти и пропускной способностью загрузки 5-10 Мбит/с достаточно недорог, чтобы позволить загрузку при ограниченном бюджете. Такой узел может обработать 10 000 ссылок примерно за 10-15 минут. Каждая партия состояла из 10 000 ссылок, взятых с сервера Postgresql с использованием метода TABLESAMPLE, что гарантировало, что распределение среди 10 000 ссылок соответствует распределению существующих 500 млн записей, доступных в базе данных. Мы обнаружили, что распределение остается хорошим, когда в базе данных остается более 20 млн записей для обработки, учитывая, что у нас было около 300 рабочих процессов загрузки одновременно. Вышеуказанные методы позволили как максимизировать скорость загрузки, так и минимизировать ущерб репутации IP-адресов.
Вывод CLIP на этапе постобработки
Конвейер данных продолжался на GPU-узлах, выполняющих вывод на собранных парах «изображение-текст» и вычисляющих сходство эмбеддингов для изображения и текста. После установления оценки сходства мы удаляли пары ниже выбранного нами порога, т.е. 0.28 для набора данных на английском языке (с CLIP ViT B/32) и 0.26 для остальных (с mCLIP). По оценкам, мы удалили около 90% образцов, сократив 50+ миллиардов кандидатов до чуть менее 6 миллиардов.
Фильтрация неподходящих пар «изображение-текст»
После загрузки WAT-файлов из Common Crawl мы применяем следующие условия фильтрации:
- Все образцы с длиной alt-текста менее 5 символов или размером изображения менее 5 КБ отбрасываются.
- Все изображения со слишком большим разрешением, потенциально являющиеся DOS-бомбами, отбрасывались до попытки их обработки.
- Удаление дубликатов выполняется с помощью фильтра Блума на основе URL. Будущие запуски будут включать более разнообразные правила дедупликации, такие как URL + язык для многоязычного набора данных.
- Мы используем CLIP и MCLIP соответственно для вычисления эмбеддингов изображения и alt-текста. Затем мы вычисляем косинусное сходство обоих эмбеддингов и отбрасываем все образцы с косинусным сходством ниже 0.28 для английского языка (с CLIP B/32) и 0.26 для многоязычного набора данных (MCLIP). Эти пороги были выбраны на основе ручной проверки результатов тестирования.
- Мы используем эмбеддинги CLIP изображений и текстов, чтобы максимально отфильтровать незаконный контент.
Конвейер подготовки набора данных
После обработки и фильтрации Common Crawl осталось 5.85 млрд образцов URL/текст. После этого мы выполнили дополнительные шаги для подготовки набора данных. См. этот блог о семантическом поиске и файл readme clip-retrieval для получения дополнительной информации об этом процессе. См. также семантический поиск в масштабе миллиардов для получения более подробной технической информации о процессе, который был выполнен для laion5B.
- Загрузка данных как webdataset с помощью распределенного img2dataset
- Вычисление эмбеддингов Vit-L/14 с помощью распределенного clip-inference
- Вычисление индекса KNN из этих эмбеддингов с использованием autofaiss
- Вычисление дополнительных тегов (NSFW и водяной знак) с использованием эмбеддингов clip
Распределенный img2dataset
Мы разработали библиотеку img2dataset для удобной загрузки из заданного набора URL-адресов, изменения размера и хранения изображений и подписей в формате webdataset. Это позволяет загрузить 100 миллионов изображений из нашего списка URL-адресов за 20 часов с помощью одного узла (скорость соединения 1 Гбит/с, 32 ГБ оперативной памяти, процессор i7 с 16 ядрами), что позволяет любому получить весь набор данных или меньшее подмножество. Для LAION-5B мы представили распределенный режим для этого инструмента, позволяющий загрузить 5.85 млрд образцов за неделю, используя 10 узлов.
Распределенный вывод clip
Из этих изображений инструмент вывода clip retrieval использовался для вычисления эмбеддингов ViT-L/14, что позволило лучше анализировать данные. В частности, распределенный режим позволил вычислить эти эмбеддинги за неделю с использованием 32 A100: эта более крупная модель clip может быть вычислена только со скоростью 312 образцов/с на GPU, по сравнению с 1800 образцов/с для ViT-B/32. Полученные эмбеддинги доступны для использования всеми, например, для кластеризации, индексации, линейного вывода.
Распределенная индексация
Затем мы использовали эти 9 ТБ эмбеддингов изображений для создания большого индекса knn PQ128 с помощью инструмента autofaiss. Чтобы ускорить этот процесс, доступен распределенный режим.
Интеграция в пользовательский интерфейс поиска
Чтобы продемонстрировать ценность этих данных, мы интегрировали этот индекс в пользовательский интерфейс поиска knn. Он работает на основе кода под названием clip back. Индекс knn занимает 800 ГБ, как и метаданные (URL и подписи), поэтому для обоих используется отображение в память (memory mapping), чтобы не использовать оперативную память; требуется только SSD-накопитель такой емкости.
Вывод водяных знаков и безопасности
Мы хотели предоставить пользователям возможность удалять небезопасные примеры и примеры с водяными знаками. Для этого мы собрали обучающие и тестовые наборы данных. Обучающий набор был дополнен примерами, полученными из индекса knn, в то время как образцы для тестового набора были отобраны так, чтобы хорошо представлять распределение данных, но все они были размечены вручную. Вывод выполняется с использованием модуля embedding-reader для NSFW и LAION-5B-WatermarkDetection для водяных знаков. Эти теги также были интегрированы в пользовательский интерфейс, что позволяет каждому убедиться в том, что теги безопасности действительно отфильтровывают почти все небезопасные результаты, и дает уверенность в том, что обучение генеративной модели на этих данных не приведет к появлению неожиданно небезопасных изображений.
Водяные знаки
Обучающий набор данных состоит из 90 000 образцов (45 222 с водяными знаками, 44 778 чистых).
Изображения с водяными знаками представляют собой серьезную проблему при обучении генеративных моделей, таких как DALL-E или GLIDE. Чтобы решить эту проблему, мы обучили модель обнаружения водяных знаков и использовали ее для расчета показателей достоверности для каждого изображения в LAION-5B. Таким образом, мы создали обучающий набор данных, состоящий из 90 000 изображений, 50% из которых имеют водяные знаки, а 50% являются чистыми. Большинство изображений с водяными знаками были извлечены из индекса KNN LAION-400M с помощью нескольких текстовых запросов, таких как «clip art watermark», «cat watermark» или «landscape watermark».
Изображения в очищенной категории состояли из изображений из набора данных Open Images и изображений, содержащих текст, но без водяных знаков, таких как слайды PPT и мемы, также полученных из индексов kNN LAION-400M. Хотя мы пытались курировать тестовый набор для оценки качества нашей модели обнаружения водяных знаков, мы поняли, что почти невозможно провести четкую грань между тем, что на самом деле является водяным знаком, а что нет. Например, изображения с небольшим прозрачным текстом внизу некоторые люди считали помеченными водяными знаками, а другие — нет.
В конечном итоге мы решили выбрать модель, основанную на нашем консенсусном суждении. Похоже, она «хорошо» справляется с обнаружением очевидных водяных знаков, подобных тем, что используются на популярных сайтах с изображениями. Создание высококачественных, открыто доступных тестовых наборов для обнаружения водяных знаков с четкими и правдоподобными определениями того, что следует считать водяным знаком, а что нет, остается задачей для будущих проектов. Тем не менее, мы убеждены, что удаление изображений с высоким показателем достоверности наличия водяного знака на основе нашей модели значительно сократит процент изображений, которые можно было бы считать очевидными водяными знаками.
Модель доступна по ссылкам https://github.com/LAION-AI/watermark-detection и https://github.com/LAION-AI/LAION-5B-WatermarkDetection/releases/tag/1.0
Безопасность
На сбалансированном вручную размеченном тестовом наборе безопасности из 3000 образцов:
- точность классификатора B32 NSFW составляет: 0.960
- точность классификатора ViT L 14 NSFW составляет: 0.961
Модель, а также код обучения доступны по ссылке . Теги доступны по ссылкам laion2B-en-safety laion2B-multi-safety laion1B-nolang-safety. Демонстрация по ссылке (включить/выключить безопасный режим)
Использование наборов данных LAION
Laion5B и LAION-400M могут, например, использоваться для обучения
- Генеративные модели: обучение генеративных моделей «изображение/текст», например, авторегрессионных моделей, таких как DALL-E, или диффузионных моделей, таких как GLIDE
- Модели с контрастивными потерями: самообучение на парах «изображение/текст» с использованием контрастивных потерь, например CLIP
- Модели классификации: например, выполнение классификации с нулевым снимком (zero-shot) путем извлечения псевдометок из запросов к набору данных
Здесь мы представляем несколько примеров моделей, которые были успешно обучены на наших наборах данных LAION:
CLIP
Мы, LAION, в настоящее время работаем вместе с Cross Sectional Team Deep Learning (CST-DL), Scalable Learning and Multi-Purpose AI Lab (SLAMPAI) в Jülich Supercomputing Centre (JSC) и командой Open CLIP над воспроизведением результатов OpenAI CLIP.
(Результаты в правом столбце получены с помощью нашей модели. — огромное спасибо Кейду Гордону и Россу Уайтману за проведение обучения)
Репозиторий с кодом обучения и контрольными точками модели можно найти здесь:
Мы выражаем благодарность Gauss Centre for Supercomputing e.V. (<www.gauss-centre.eu>) за финансирование этой части работы путем предоставления вычислительного времени через John von Neumann Institute for Computing (NIC) на суперкомпьютере GCS JUWELS Booster в Jülich Supercomputing Centre (JSC).
Настройка вывода BLIP
BLIP — это модель, обученная как для сопоставления изображений с текстом, так и для создания подписей к изображениям. Она была обучена на подмножестве LAION-400M из 115 млн изображений. Чтобы улучшить results генерируемых подписей, мы (LAION) провели более 100 экспериментов, чтобы определить гиперпараметры, которые максимизируют оценку BLEU-4 по сравнению с подписями MS COCO. Здесь вы можете увидеть некоторые из наших результатов.
eval_best_auto0185: Рыжий кот смотрит на свое отражение в зеркале.
eval_best_auto0190: Зеленый дорожный знак со словами Queens Bronx.
Мы обнаружили, что можем значительно улучшить качество подписей, генерируя 40 (или более) вариантов подписей для каждого изображения, а затем ранжируя их с помощью OpenAI CLIP ViT-L/14 и CLIP-Resnet50x64. Сначала мы ранжировали всех кандидатов с помощью ViT-L/14, а затем снова ранжировали 5 лучших результатов с помощью Resnet50x64. Предварительные результаты оценки людьми показывают, что:
- наши оценщики поставили сгенерированным подписям среднюю оценку качества 3,8 по шкале от 0 до 5 со стандартным отклонением 0,9 (в этой конкретной конфигурации гиперпараметров n= 600)
- наши оценщики поставили оригинальным человеческим подписям из MS COCO среднюю оценку качества 3,9 со стандартным отклонением 0,8 (n = 2100)
—> Мы предполагаем, что сгенерированные подписи соответствуют (а иногда даже превосходят) среднее качество человеческих подписей MS COCO (которые иногда также далеки от идеала) в большинстве случаев, но иногда (менее чем в 10%) содержат очевидные ошибки, которые люди бы не допустили, поскольку в этих случаях потребовались бы более глубокие знания о мире и «здравый смысл».
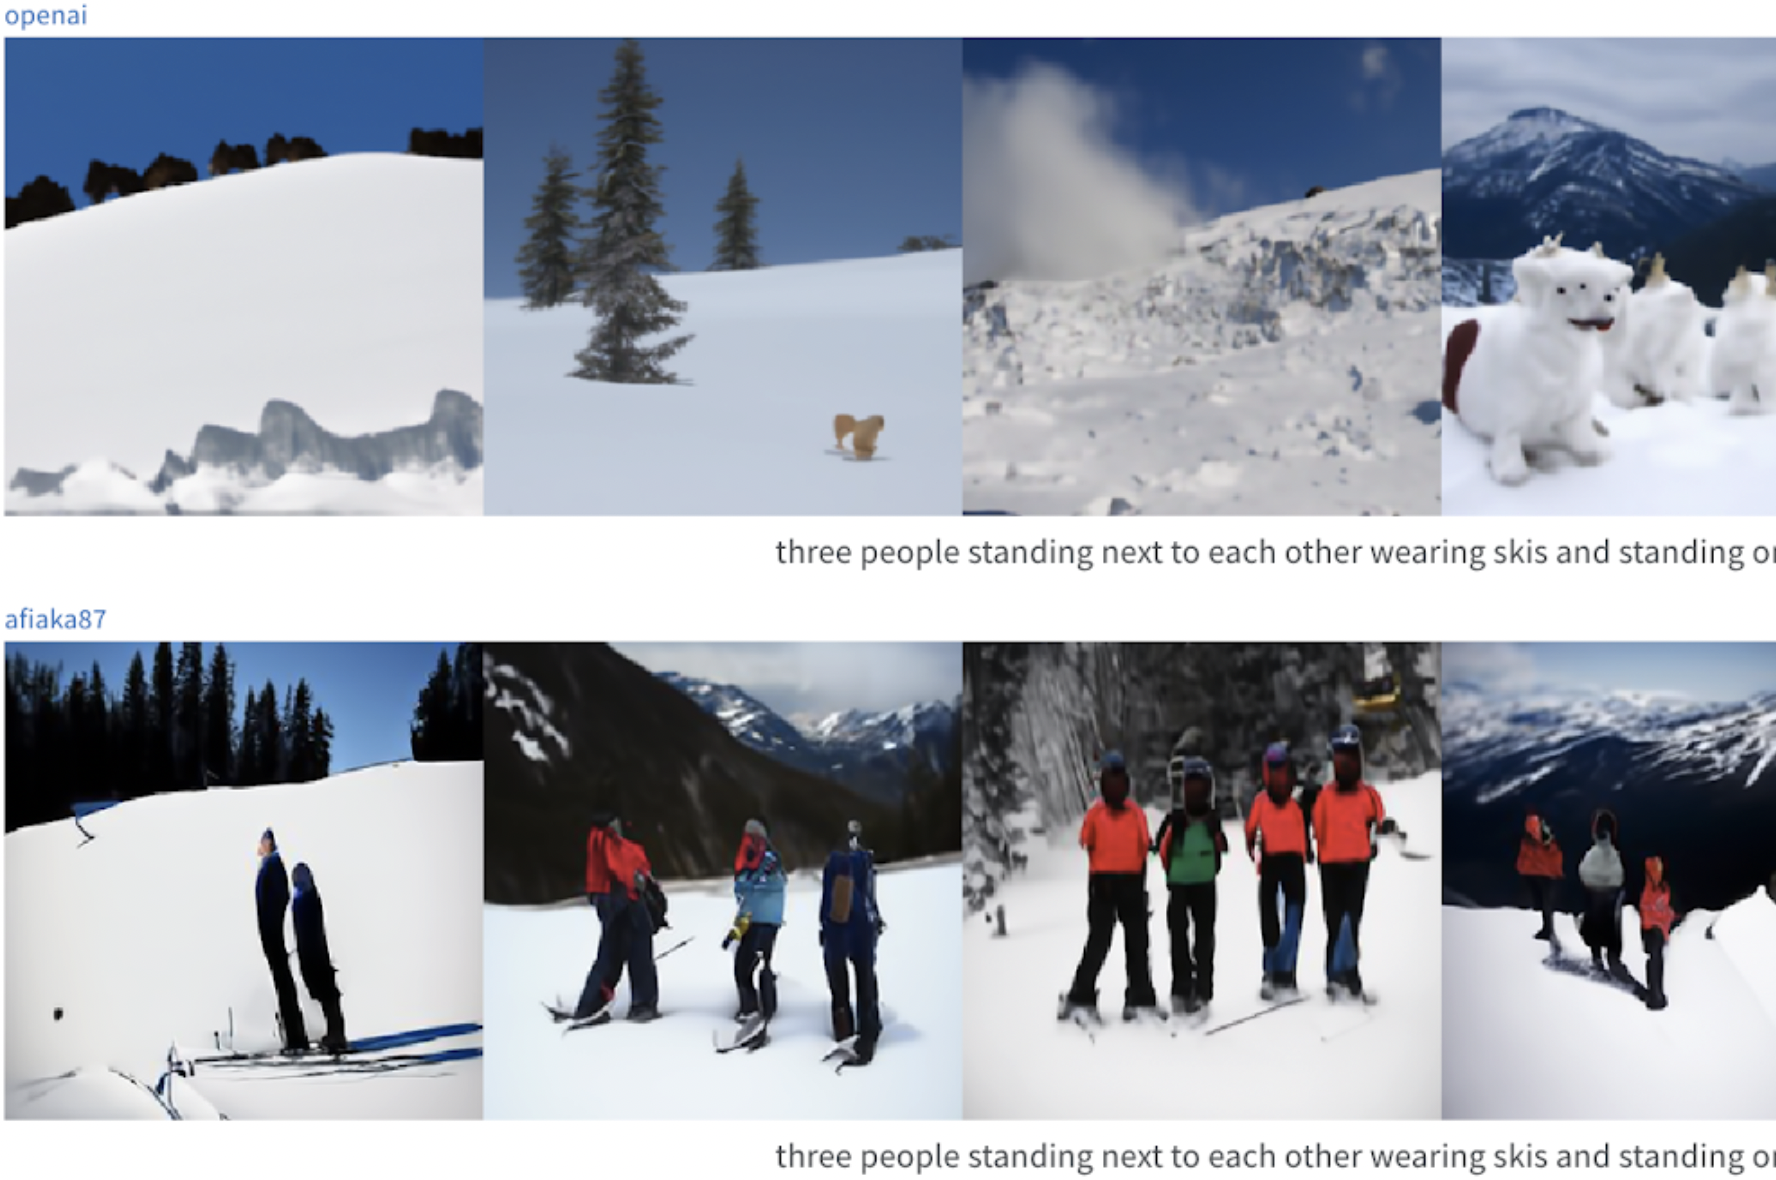
GLIDE
Клэй Маллис (псевдоним afiaka87) использовал подмножества LAION-2B для дообучения модели OpenAI Glide и сумел повторно внедрить генерацию людей. Образцы
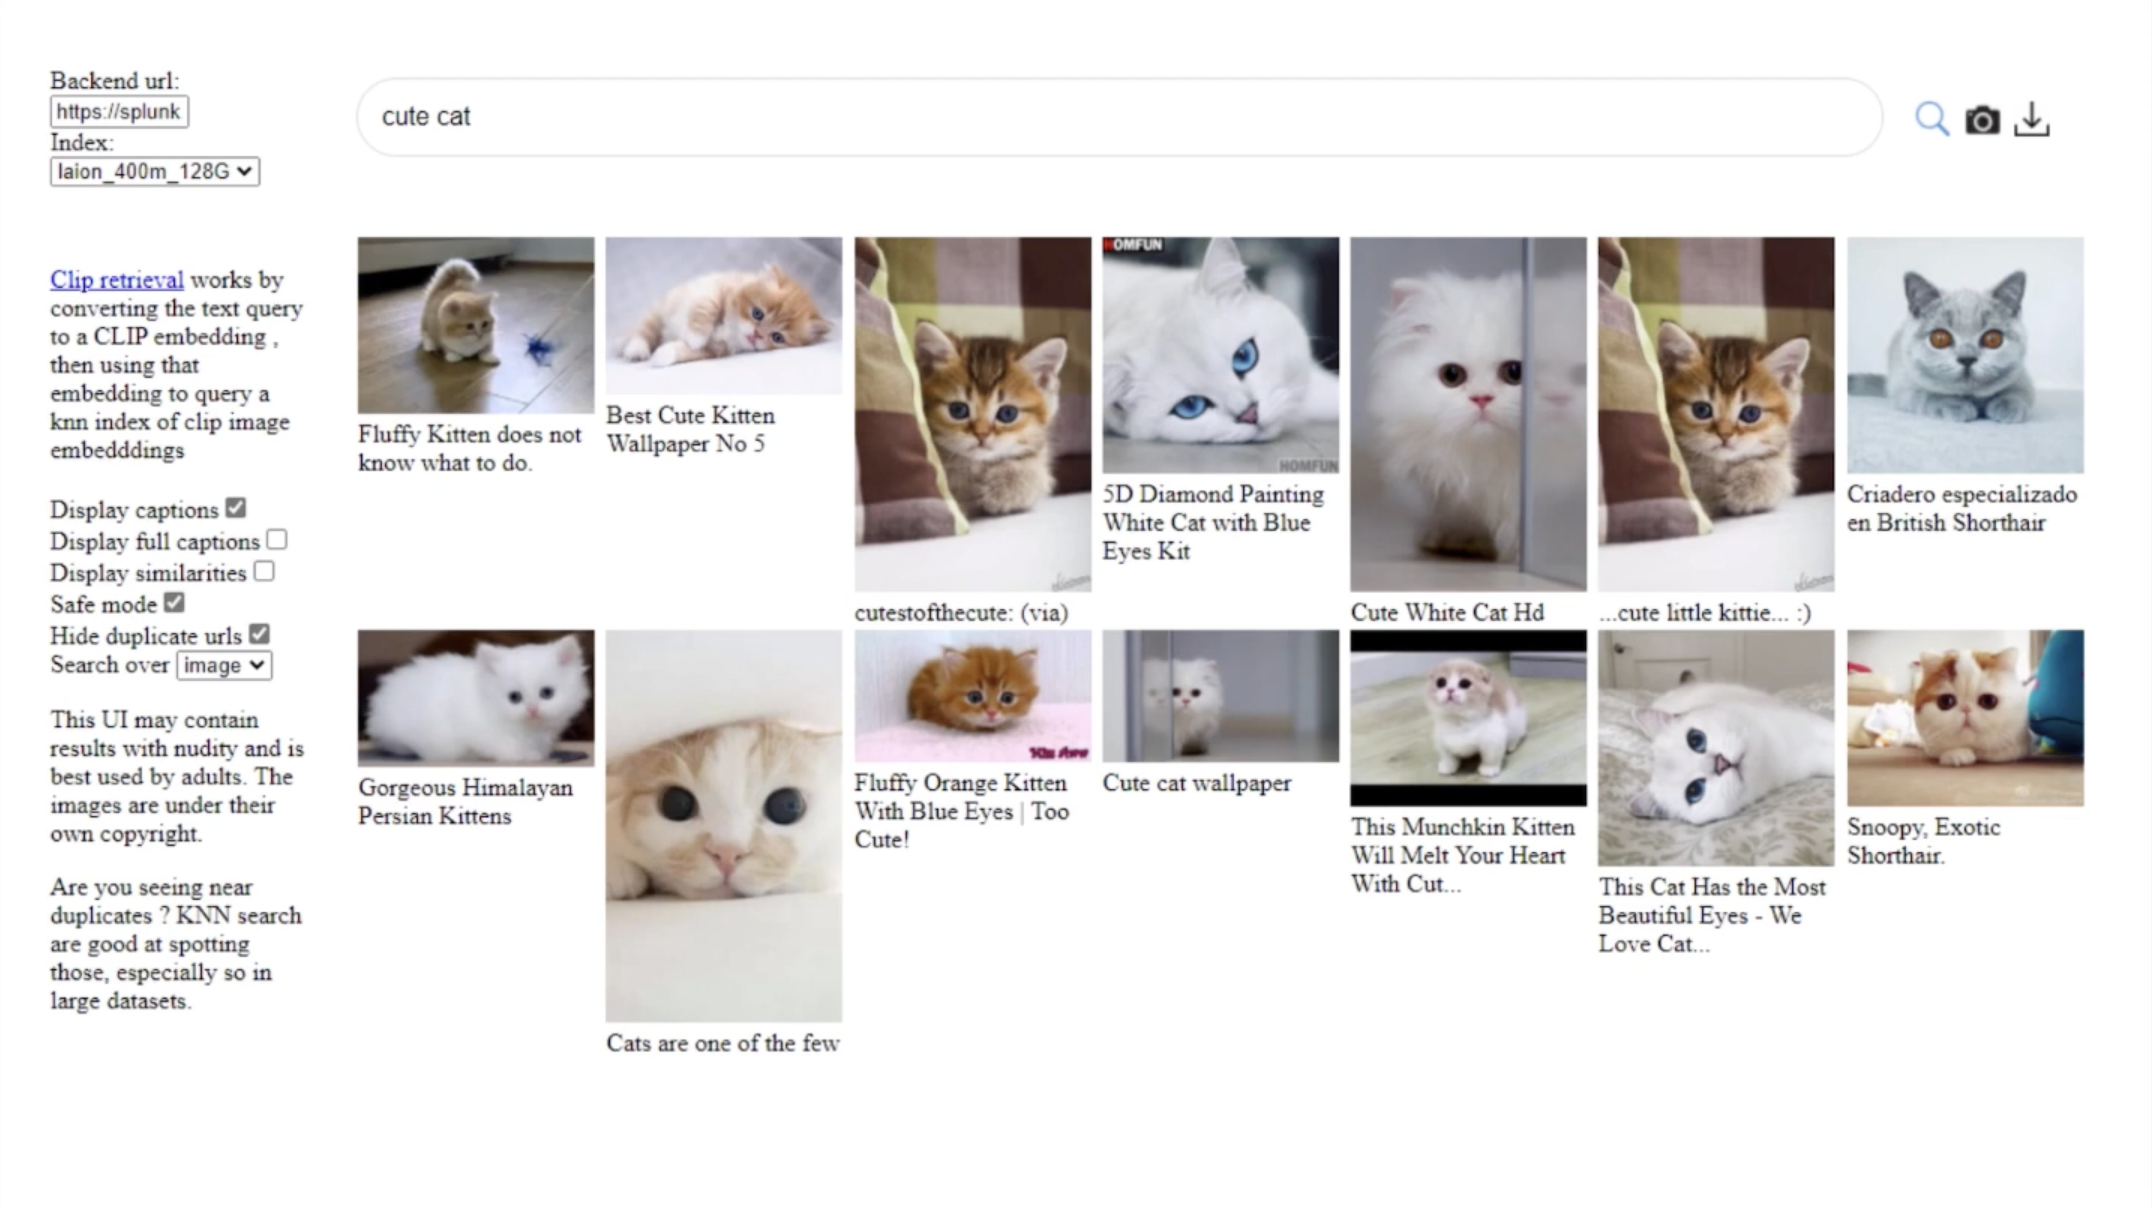
Семантический поиск и извлечение подмножеств
Интерфейс позволяет пользователю искать изображения и тексты на основе запроса изображения или текста, используя эмбеддинги CLIP входных данных и наши предварительно вычисленные индексы kNN. Он демонстрирует разнообразие изображений и подписей, которые можно найти в LAION-5B, а также высокую семантическую релевантность, и показывает распределение размеров изображений в LAION-5B. Учитывая обилие изображений высокого разрешения, можно создавать подмножества изображений для обучения различных специализированных моделей, а также выбирать разрешение изображения, подходящее для целей конкретного обучения.
CLOOB
Кэтрин Кроусон и Джон Дэвид Прессман недавно обучили CLOOB ViT-B/16, вариант CLIP, в течение 32 эпох на LAION-400M и получили предварительные результаты, которые близки к производительности OpenAI ViT-B/32, несмотря на то, что это был ранний запуск с неоптимизированными гиперпараметрами. Контрольные точки можно найти здесь: https://github.com/crowsonkb/cloob-training
(точность zero-shot на Imagenet-1K)
Мы поддерживаем связь с Андреасом Фюрстом, одним из первоначальных авторов CLOOB, и узнали от него, что их команда в настоящее время (на момент написания статьи) обучает CLOOB ViT-B/32 на LAION-400M с оптимизированными гиперпараметрами, и результаты пока весьма многообещающие (53% точности zero-shot на Imagenet после 7 эпох).
Статьи, цитирующие LAION 400M
После выпуска LAION-400M несколько научных работ использовали LAION-400M для генерации изображений, генерации текста по изображениям, генерации описаний по изображениям и сопоставления текста с изображениями:
- Векторно-квантованная диффузионная модель для синтеза текста в изображение использовала LAION-400M для обучения моделей генерации текста в изображение VQ diffusion
- Синтез изображений высокого разрешения с помощью латентных диффузионных моделей использовала подмножество LAION-400M для обучения латентных диффузионных моделей
- Подмножество лиц LAION-400M для обучения face clip
- создание подписей к изображениям с использованием подмножества LAION-400M
- была обучена отвечать на вопросы по изображениям с использованием подмножества LAION-400M
Заключение
Выпустив обновленную версию общедоступного набора данных, содержащего 5 миллиардов пар «изображение-текст», мы установили новые стандарты масштаба общедоступных наборов данных и дали исследователям со всего мира возможность обучать современные языково-визуальные модели, такие как GLIDE или Turing Bletchley. В качестве доказательства концепции мы продемонстрировали, что подмножество нашего набора данных может быть использовано для обучения различных моделей типа CLIP, создавая образцы достаточного качества. Этот набор данных расширяет возможности многоязычного крупномасштабного обучения и исследования языково-визуальных моделей для широкого сообщества, которые ранее были ограничены доступом к проприетарным крупным наборам данных.
Что дальше?
Это только начало! Теперь, когда этот огромный и открытый набор данных выпущен, его можно использовать для обучения множества моделей, таких как гигантские модели CLIP, модели генерации изображений/текста и многое другое. У нас так много проектов в работе, что, если вам интересно, лучше всего присоединиться к нашему Discord-серверу и узнать, что происходит. Мы были и всегда будем низовым сообществом, которое работает открыто и приветствует всех, кто добр и увлечен машинным обучением.
Присоединяйтесь к нам в discord и помогите нам обучать такие модели, как CLIP, BLIP, GLIDE, Dall-E, SimMIM, AudioCLIP, и не стесняйтесь делиться с нами своими идеями для новых проектов.
Станьте частью нашей постоянно растущей толпы сторонников, которые помогают нам воплощать мечты о машинном обучении в реальность!
Участники проекта
- Кристоф Шуман: Он руководил этим проектом и создал POC для большинства его компонентов, включая фильтрацию CLIP, модель безопасности, модель водяных знаков и проект настройки вывода Blip.
- Ричард Венку: Системная архитектура и оптимизация скриптов загрузки, фильтрация с помощью GPU. Настройка инфраструктуры AWS.
- Ромен Бомон: Руководство по масштабированию конвейера фильтрации common crawl. Создал и запустил конвейер подготовки набора данных: задание дедупликации pyspark, img2dataset, вывод clip, autofaiss, теги безопасности.
- Клейтон Маллис: Обучение/анализ DALLE-pytorch, обучение glide, фильтрация WDS
- Женя Жицев: научная организация и написание текстов, планирование и дизайн экспериментов, получение вычислительных ресурсов, общее руководство
- Роберт Качмарчик: Создал архитектуру WDS, выполнил прогоны обучения DALL-E, расчет балансировки, аннотирование образцов (NSFW, водяной знак, качество подписи) и пересмотр рукописи
- Андреас Кёпф: Он провел поиск гиперпараметров для стратегий вывода с помощью модели описания изображений BLIP
- Ааруш Катта: Обучил модель водяных знаков