IntelliJ IDEA — ведущая IDE для профессиональной разработки на Java и Kotlin
IntelliJ IDEA IntelliJ Platform Java
AI-агенты могут ускорить создание кода, но они не делают его выполнение дешевле. В приложениях, управляющих миллионами объектов, выделение памяти и сборка мусора по-прежнему имеют значение. JVM решает эти проблемы на нескольких фронтах: ZGC нацелен на паузы сборки мусора, Project Leyden решает задачи запуска и разогрева, а Project Lilliput уменьшает пространство, занимаемое каждым заголовком объекта. В Java 27 HotSpot по умолчанию включает компактные заголовки объектов (Project Lilliput, JEP 534).
Синтетические бенчмарки часто демонстрируют меньший объем объектов, но что этот шаг на самом деле дает для масштабного реального приложения на JVM? Мы оценили этот эффект непосредственно внутри IntelliJ IDEA.
Что такое компактные заголовки?
Каждый объект Java имеет заголовок. Он идентифицирует класс объекта и хранит или кодирует состояние, используемое для блокировок, хеш-кодов идентификации и сборки мусора. Поскольку каждый экземпляр несет эти издержки, уменьшение заголовка является привлекательной целью для оптимизации памяти.
В протестированной нами 64-битном конфигурации HotSpot стандартный заголовок экземпляра занимает 12 байт: 8-байтное слово метки (mark word) и 4-байтный указатель на класс. Компактный макет объединяет их в одно 8-байтное слово.
Означает ли это немедленное сокращение общей памяти приложения на 10–20%? Не обязательно. Ниже мы прослеживаем влияние компактных заголовков от исходных макетов объектов и дампов кучи до резидентной памяти процесса и интерактивных рабочих нагрузок IDE, показывая, где именно проявляется экономия, а где она исчезает.
Как мы тестировали компактные заголовки в IntelliJ IDEA
Мы измерили три конфигурации с возрастающими требованиями к ресурсам:
- Без проекта (открыт только экран приветствия).
- Маленький проект: Spring Petclinic с примерно 3370 строками кода на Java/Kotlin.
- Крупный проект: монорепозиторий IntelliJ IDEA с примерно 26,5 миллионами строк кода.
Размеры кодовой базы различаются почти на четыре порядка, что обеспечивает существенно разные профили индексации и объемы памяти. Для обеих конфигураций проектов мы запускали автоматизированный скрипт, который многократно открывал исходные файлы Java, вставлял и удалял комментарии, разрешал ссылки на код, сохранял изменения и закрывал редактор.
Мы использовали IntelliJ IDEA 2026.2.3, работающую на JBR 25.0.4 (среда выполнения Java, используемая в IDE от JetBrains), явно переключая компактные заголовки в положение «включено» и «выключено». В каждом сравнении сборка, снимок проекта, рабочая нагрузка и значения -Xmx оставались прежними. Мы выполнили несколько заходов для каждой конфигурации на в остальном простаивающем хосте, чередуя порядок выполнения (вкл/выкл), чтобы минимизировать влияние разогрева кэша и предвзятости порядка.
Резидентный набор памяти (RSS)
Начнем с основного метрики, которую пользователи обычно замечают, когда процесс выглядит тяжелым: RSS (resident set size).
RSS учитывает страницы физической оперативной памяти, отображенные на процесс. Сюда входят страницы частной памяти и страницы разделяемой памяти, такие как динамические библиотеки. Поскольку разделяемые библиотеки учитываются для каждого процесса, который их отображает, RSS не отражает объем оперативной памяти, эксклюзивно удерживаемый IDE.
Мы опросили основной процесс IDE с помощью команды ps. В таблице ниже приведено среднее значение трех медиан фаз для каждого запуска в МиБ, а в скобках указаны минимальная и максимальная медианы запусков.
Вердикт: При идентичных лимитах -Xmx компактные заголовки не привели к статистически значимому или постоянному сокращению общего RSS.
Означает ли это, что компактные заголовки не дали практической пользы? Чтобы ответить на этот вопрос, нам нужно заглянуть внутрь кучи и выяснить, как на самом деле работают компактные заголовки, вместо того чтобы предполагать повсеместное падение памяти процесса.
Измерение объема объектов
RSS процесса охватывает гораздо больше, чем живые объекты в куче Java. Резидентные страницы могут включать невыделенный запас пространства внутри выделенной (committed) кучи, метаданные классов, код, скомпилированный JIT, стеки потоков, нативные буферы и структуры данных JVM, общие библиотеки и другие файлы, отображаемые в память. Таким образом, уменьшение только заголовков объектов может не привести к снижению RSS процесса на соответствующее число байт (если вообще приведет к заметному изменению).
Чтобы изолировать структурную экономию, мы сравнили объем объектов — сколько байт занял бы тот же набор захваченных объектов при каждой модели макета заголовка.
Для ваших проектов вы можете изучить это напрямую в IntelliJ IDEA. Ее дамп памяти показывает количество экземпляров, поверхностные (shallow) и удерживаемые (retained) размеры в разрезе классов, позволяя увидеть, что именно занимает кучу. Начиная с версии 2026.3 EAP, он также предлагает оценки с учетом компактных заголовков, используя модели макетов JOL.
В таблице ниже сопоставлены смоделированные объемы для идентичных захваченных куч.
Здесь экономия заметна: модель с фиксированной популяцией уменьшает объекты Welcome и Petclinic примерно на 6,3%, а объекты монорепозитория — на 8,2%–8,4%. Хотя RSS на системном уровне маскировал этот эффект, экономия памяти внутри кучи вполне реальна.
Почему выигрыш не фиксирован
Почему удаление 4 байт из заголовка не приводит к равномерной экономии в 4 байта для каждого отдельного объекта? Потому что две кучи одинакового размера могут содержать совершенно разные объекты, а заголовок — лишь одна из переменных.
Экземпляр также хранит примитивные поля и ссылки. Массив хранит свою длину и данные элементов. Их количество, тип и ширина ссылок влияют на общий размер объекта. В нашем сравнении типы полей и ширина ссылок остаются прежними, но изменение заголовка может сместить смещения полей и изменить выравнивание (padding). Вот как это работает:
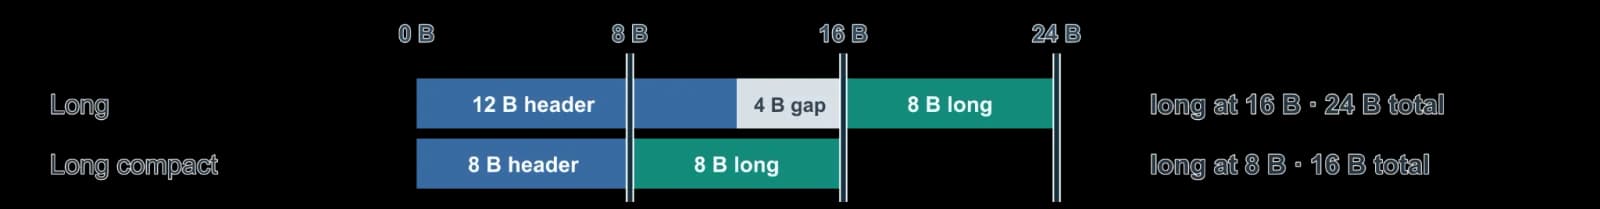
HotSpot по умолчанию округляет поверхностный размер каждого объекта до числа, кратного восьми байтам. Это может поглотить четырехбайтовое уменьшение заголовка: объект с одним int остается размером 16 байт в любом макете (12 + 4 байта или 8 + 4 байта плюс 4 байта выравнивания). Пустой объект Object, напротив, уменьшается с 16 до 8 байт; объект с двумя полями int уменьшается с 24 до 16 байт, как показано на изображении ниже:
Внутри объекта также может присутствовать выравнивание. Поля имеют собственные требования к выравниванию; они не все начинаются с границ, кратных восьми байтам. В смоделированной здесь компоновке HotSpot стандартные смещения полей соответствуют ширине их хранения: один байт для byte/boolean, два для short/char, четыре для int/float и сжатых ссылок, и восемь для long/double. Это отлично от округления всего объекта до размера, кратного восьми байтам, и не является гарантией языка Java.
Давайте посмотрим на Long.value. После 12-байтного заголовка его восьмибайтное поле начинается со смещения 16, оставляя четырехбайтовый пробел. После 8-байтного заголовка оно может начинаться со смещения 8. Весь объект уменьшается с 24 до 16 байт. HotSpot может упаковывать или переупорядочивать поля, поэтому точные смещения по-прежнему зависят от класса и правил компоновки JVM.
Массивы демонстрируют ту же закономерность: byte[0] остается размером 16 байт, в то время как byte[1] уменьшается с 24 до 16 байт. Когда куча содержит миллионы объектов различной формы, общая экономия зависит от этого набора, а не только от количества объектов.
Мы сверили эти примеры с реальными поверхностными размерами с помощью Instrumentation.getObjectSize на той же JBR с явно отключенными и включенными компактными заголовками. Поверхностный размер учитывает заголовок объекта, поля и выравнивание, но не включает объекты, доступные по ссылкам. Мы также проверили сжатие ссылок и выравнивание. Вот что показала JBR 25.0.4:
Вывод из таблицы прост: меньший заголовок не делает каждый объект меньше. Общее уменьшение кучи полностью зависит от профиля распределения объектов в приложении.
Практические преимущества: выделение памяти, сборка мусора и пропускная способность
Даже если RSS процесса не снижается при фиксированном значении -Xmx, дает ли уменьшенный размер объектов какие-то преимущества для среды выполнения в других аспектах? Мы искали четыре эффекта:
- Выделяет ли тот же рабочий процесс меньше мегабайт в общей сложности?
- Запускается ли сборщик мусора реже или потребляет ли он меньше циклов?
- Становятся ли скриптовые операции IDE быстрее в результате изменений, указанных выше, или таких эффектов, как улучшение локальности кеша процессора?
- Может ли приложение надежно работать при меньшем значении -Xmx?
Для первых трех вопросов мы сравнили состояние с выключенными и включенными заголовками при одинаковых значениях -Xmx: 2048 МиБ для Petclinic и 4096 МиБ для монорепозитория.
Стала ли JVM выделять меньше байт?
Для каждого проекта наш скрипт бенчмарка повторял одну и ту же последовательность операций: открытие файла Java, вставка и удаление комментария, разрешение ссылок, сохранение и закрытие редактора. Сюда входят фоновые задачи и задачи проверки, выполняемые параллельно, поэтому это не сводка выделения памяти исключительно для операций редактирования.
Если вы хотите проанализировать горячие точки выделения памяти в собственном коде, профилировщик Memory Allocations в IntelliJ IDEA отслеживает пути вызовов и временные шкалы. Как и инструмент дампов кучи IntelliJ IDEA, он изначально учитывает компактные заголовки объектов, поэтому вы можете рассчитывать на точные цифры для вашего приложения независимо от целевой версии JVM.
При идентичных рабочих нагрузках компактные заголовки позволили устранить от 8,8% до 13,0% от общего объема выделенной памяти.
Стало ли у сборщика мусора меньше работы?
Меньший объем выделенной памяти может означать меньшую нагрузку на сборщик мусора. Мы сравнили количество запусков GC в JVM и затраченное на сборку время во время открытия и индексации проекта, а также время пауз GC во время выполнения скриптовых операций.
Во время открытия и индексации монорепозитория в каждом запуске с компактными заголовками было зарегистрировано меньше событий GC, чем в запусках с обычными заголовками. Среднее время работы GC и зарегистрированное процессорное время GC в этих сравнениях также оказались ниже.
Ускорилась ли работа IDE?
В конечном счете это вопрос, который волнует разработчиков больше всего. Для тех же операций мы сравнили их общее время, 95-й перцентиль задержки операции и загрузку процессора в масштабе всего процесса.
Показатели производительности имеют небольшую положительную тенденцию, что говорит об умеренном ускорении.
Насколько низким может быть -Xmx?
Если компактные заголовки упаковывают больше экземпляров в тот же объем кучи, насколько сильно мы можем уменьшить -Xmx, прежде чем рабочие нагрузки начнут давать сбои?
Мы уменьшали значение -Xmx до тех пор, пока сценарии индексации и редактирования не переставали работать полностью надежно. Успешным прохождением считалось завершение короткого сценария, даже если он замедлялся.
В таблице ниже показаны самые низкие протестированные настройки, при которых успешно завершались все повторы для каждого проекта и макета заголовков.
Примечание: это пороговые значения, при которых тестовые рабочие нагрузки стабильно завершались, а не рекомендуемые конфигурации для продакшена.
Для Petclinic компактные заголовки позволили снизить минимально жизнеспособную кучу с 400 МиБ до 376 МиБ (уменьшение на 6%). Для монорепозитория минимальный предел снизился с 1888 МиБ до 1568 МиБ, что дает экономию в 320 МиБ (17%).
Заключение
Обновления, которые делают существующие приложения более эффективными без изменения ни единой строки кода приложения, встречаются редко. Компактные заголовки объектов достигают этого за счет снижения «налогов» на память, которые платят миллионы объектов. Наряду с улучшениями запуска и сборки мусора, они являются частью масштабной работы Java над эффективностью выполнения — укрепляя JVM в то время, когда мы генерируем больше кода, чем когда-либо.
Когда вы внедряете компактные заголовки в своих собственных приложениях, реальная выгода будет зависеть от набора ваших объектов и их выравнивания. Многие объекты будут занимать меньше места, что часто приводит к снижению частоты выделения памяти, уменьшению нагрузки на сборщик мусора и снижению предела жизнеспособной кучи. Тем не менее, это не гарантирует немедленного соразмерного снижения RSS процесса или повсеместного ускорения выполнения. Измеряйте эти показатели отдельно и не уменьшайте -Xmx просто потому, что заголовки должны быть меньше.
Возможно, вы уже используете эту функцию в IntelliJ IDEA. Изменение в IntelliJ Platform появилось в версии 2026.2 и включает заголовки компании по умолчанию. Это избавляет от необходимости ручной настройки сразу после миграции на новую версию Java — что определенно стоит сделать, учитывая объем работы по оптимизации среды выполнения, проделанный в последнее время.
Что бы вы хотели, чтобы мы изучили дальше? Интересны ли вам новые статьи о производительности Java, новых функциях Java или и то, и другое? Дайте нам знать в комментариях!