Выбор следующего сообщения для одного пользователя выглядит как задача ранжирования, но это не совсем так. Набор кандидатов меняется ежедневно. Лучший ответ различается от пользователя к пользователю. Вы видите вознаграждение только за то действие, которое фактически совершили, и даже тогда оно является разреженным. Кроме того, каждый выбор должен учитывать жесткие бизнес-ограничения. Это делает задачу контекстной задачей принятия решений с ограничениями, и стек построен вокруг этого.
CleverAI™ состоит из двух связанных частей. Движок принятия решений (decisioning engine) выбирает действие для каждого пользователя. Агентный слой, AI Studio, — это место, где агенты генерируют кандидатов, проводят решение через кампании и пользовательские пути (journeys), и удерживают всю систему сфокусированной на бизнес-цели.
Модель должна выполнять две задачи. В офлайн-режиме она изучает долгосрочное поведение: периодичность покупок, стадию жизненного цикла, многолетнюю реакцию на кампании. В онлайн-режиме вторая обучаемая модель обрабатывает то, что не могла увидеть офлайн-модель, например, дрейф данных, абсолютно новую сессию, новую категорию или внезапное падение вовлеченности. Она обновляется при каждом результате, но не может отбросить априорное распределение (prior) и не должна чрезмерно реагировать на одиночное событие.
Системная сторона имеет три жестких требования. Контекст меняется с каждым событием у сотен миллионов пользователей, и он должен считываться быстрее, чем поступит требующий его запрос. Каждый запрос оценивает большое пространство кандидатов с учетом жестких ограничений. А контур вознаграждения должен быть достаточно быстрым, чтобы стратегия (policy) отражала последнее взаимодействие, а не последнее переобучение.
Агентный слой добавляет четвертое требование. Каждое действие агента должно регулироваться, и каждый агент должен принимать решения на основе одной и той же стратегии. В противном случае интеллект фрагментируется между агентами.
Задача принятия решений
При каждом решении движок наблюдает контекст пользователя и набор допустимых действий . Каждое действие представляет собой кампанию вместе с параметрами доставки: каналом, временем, предложением или отсутствием действия вообще. Движок выбирает и позже наблюдает вознаграждение (положительное, если пользователь продвинулся к цели, отрицательное, если отдалился). Нам нужна стратегия, которая максимизирует ожидаемое вознаграждение, никогда не назначая вероятность недопустимому действию:
Эквивалентно, стратегия должна минимизировать сожаление (regret) по сравнению с лучшим допустимым действием для каждого пользователя:
Три вещи делают эту задачу сложнее классического учебного варианта. Набор действий меняется каждый день по мере запуска и завершения кампаний, поэтому ничто нельзя обучить один раз и сохранить. Лучшее действие зависит от , поэтому единого победителя не существует. И обратная связь является частичной: вы видите вознаграждение только за то действие, которое совершили, и никогда — за те, которые не совершали.
Большинство инструментов, к которым команды обращаются в первую очередь, упускают как минимум два из этих аспектов:
- Правила для когорт дают всем в сегменте одно и то же действие, игнорируя то, как варьируется внутри него.
- Последовательные A/B-тесты распределяют трафик равномерно на фиксированный период. При наличии вариантов часть трафика направляется на проигрывающие варианты (arms) на протяжении всего теста, поэтому сожаление (regret) растет линейно по . Результатом также является один глобальный победитель, поэтому даже после теста вы остаетесь линейно далеки от оптимума для каждого отдельного пользователя. Адаптивные стратегии достигают сублинейного роста сожаления (regret), порядка вплоть до размерности и логарифмических факторов.
- Модель склонности (propensity model) сама по себе оценивает : кто с наибольшей вероятностью совершит действие. Она ничего не говорит о том, : что именно им отправить.
Ключевые компоненты архитектуры CleverAI™ Live
Каждый компонент отвечает за один член сформулированной выше задачи.
- TesseractDB™ -> контекст : Единое хранилище признаков (feature store) реального времени содержит состояние событий в режиме реального времени и до 10 лет истории по каждому пользователю. Обе обучаемые модели считывают данные из него, поэтому между недавним и историческим контекстом нет границы синхронизации.
- Creators и Experts –> действия и их описания : Creators поставляют варианты контента с эмбеддингами; Experts предоставляют специализированные оценки для рекомендаций, прогнозов, времени, канала и последовательности.
- Guardrails -> допустимое множество : Это жесткие ограничения, применяемые непосредственно на этапе принятия решения, а не постобработочный фильтр. В итоге выбирается лучшее допустимое действие, а не лучшее действие, которое случайно прошло фильтрацию.
- The Tesseract Decisioning Engine™ -> стратегия : обученное в офлайне априорное распределение (prior), которое инициализирует онлайн-модель, обновляющуюся с каждым взаимодействием.
- Experience Builder -> исполняет действие и возвращает вознаграждение .
- The Clean Room -> расширение : Эмбеддинги вычисляются внутри среды клиента, поэтому регулируемые атрибуты участвуют в ранжировании, не покидая ее.
- AI Studio -> агентный слой поверх всего этого: разворачивает агентов и агентные обвязки (harnesses). Агенты считывают и записывают данные в TesseractDB™, направляют Creators и Experts для генерации кандидатов, вызывают Tesseract Decisioning Engine™ для выбора и задействуют Experience Builder для исполнения. Действия агентов контролируются согласованиями с участием человека (HITL) и системой RBAC.
Входные данные: Goal (Цель), Strategy (Стратегия), Guardrails (Ограничения)
Управляющий слой (control plane) преобразует намерения маркетолога в два объекта, которые оптимизирует движок: вознаграждение и допустимое множество.
Goal → вознаграждение . Маркетолог определяет положительные сигналы (оформление заказа, добавление в корзину) и отрицательные сигналы (удаление приложения, отмена подписки). Вознаграждение за решение является функцией целевых событий, следующих за ним в рамках горизонта цели :
где — время принятия решения. поощряет положительные события и штрафует за отрицательные.
Guardrails определяют допустимое множество . Соответствие критериям, границы аудитории, а также ограничения по частоте и точкам контакта объединяются в набор действий , из которых движок может выбирать для данного пользователя прямо сейчас:
Здесь — это набор ограничений (caps), применимых к действию (по каналу, глобально, по команде или метке), а — текущее значение пользователя относительно ограничения в его временном окне.
Эти входные данные распределяются между двумя потребителями. TesseractDB™ получает границы аудитории и целевые события, поэтому сегменты и производные признаки вычисляются с их учетом. AI Studio получает полный набор целей, стратегий и ограничений (guardrails) в качестве задачи, на основе которой ее агенты строят планирование.
AI Studio
AI Studio — это агентный слой автоматизации. Его главное архитектурное правило: агенты планируют и действуют, но никогда не осуществляют выбор для конкретного пользователя самостоятельно. Каждый агент, которому требуется решение, вызывает одну и ту же стратегию , благодаря чему существует единая обученная модель пользователя, а не отдельная модель под каждый промпт агента.
- Агенты: Процессы, ориентированные на достижение цели и отвечающие за результат. Lifecycle Agents оптимизируют контент и последовательность для достижения контрольных точек, таких как первая покупка или прохождение KYC. Разовые агенты и агенты оттока (drop-off) отвечают за календарные рассылки и брошенные шаги воронки. Команды с пользовательским сценарием, который мы еще не реализовали, могут написать собственный модуль на Foundry и запустить его на той же инфраструктуре с той же базовой стратегией.
- MCP Server & Skills: Инструментальный интерфейс, к которому обращаются агенты: инструменты чтения (аналитика, сегменты, история кампаний), инструменты записи (создание или изменение кампаний, пользовательских путей, сегментов) и инструменты оценки (чтение показателей эффективности, оценки). Этот же интерфейс доступен и внешне, поэтому собственный ассистент клиента может управлять платформой в рамках того же контракта.
- Controls: Каждая операция записи агента проходит этап проверки и одобрения человеком (HITL), а система RBAC ограничивает то, что каждый агент может читать или изменять.
Слой данных: TesseractDB™ как хранилище признаков (Feature Store)
TesseractDB™ (более 12 патентов) создан для быстрого и точного вычисления . Для пользователя в момент принятия решения контекст является функцией всей истории этого пользователя в едином хранилище:
История включает в себя поведение в реальном времени по мере его поступления, до 10 лет истории на уровне событий (без выборки или агрегирования), текущие атрибуты профиля, каждую предыдущую доставку и её результат, а также вычисленные признаки.
Ключевое решение заключается в том, что всё это хранится в одном хранилище. Традиционные архитектуры разделяют историю (хранилище данных или CDP) и оперативное состояние (операционное хранилище), что вынуждает выбирать между сетевым соединением во время запроса и устаревшим контекстом. Поскольку оба алгоритма обучения считывают данные из TesseractDB™, результат принятия решения записывается обратно и становится частью процесса принятия решений.
Чистая комната (Clean Room): расширение пространства признаков без перемещения данных
Внутренние оценки рисков, атрибуты на уровне транзакций и записи, подпадающие под ограничения по месту хранения, часто являются самыми сильными сигналами, которые есть у клиента, и они не могут покидать среду клиента. Пусть — это такие приватные атрибуты. Чистая комната вычисляет эмбеддинг внутри среды клиента и возвращает только этот эмбеддинг:
обучается быть прогностическим для цели, оставаясь при этом невосстановимым из .
Генерация кандидатов: создатели и эксперты
Движок никогда не оценивает ID кампании. Он оценивает описание действия, что и позволяет обучению переноситься между кампаниями. Два вышестоящих уровня, координируемых через AI Studio, создают это описание.
Создатели генерируют варианты контента — текст, изображения, шаблоны, предложения, варианты взаимодействия — в рамках правил бренда. Вместо того чтобы вручную помечать кампании фиксированной схемой, CleverAI™ встраивает контент кампании в изученное семантическое пространство, которое фиксирует тон, тему, тип предложения, срочность и визуальный характер, а затем объединяет это со структурированными метаданными и выбором доставки:
где — это эмбеддинг семантического намерения, а — структурированные метаданные (определение аудитории, тип цели, временное окно).
Эксперты — это специализированные модели для рекомендаций, прогнозов (склонность к конверсии, оттоку), лучшего времени отправки, лучшего канала и интеллектуальной последовательности. Они не являются отдельными движками принятия решений. Каждый из них вносит вклад в оценку или , которую движок использует как признак на стороне пользователя или на стороне действия.
Уровень принятия решений: Tesseract Decisioning Engine™
Движок принимает пять входных данных на запрос: контекст (из TesseractDB™ и Чистой комнаты), варианты (от создателей), оценки экспертов, цель и допустимый набор, и выдает один результат: лучшее допустимое действие, которым может быть сообщение, предложение, канал, время, шаг последовательности, опыт взаимодействия с продуктом или отсутствие действий.
Два обучающихся алгоритма: Система 1 и Система 2
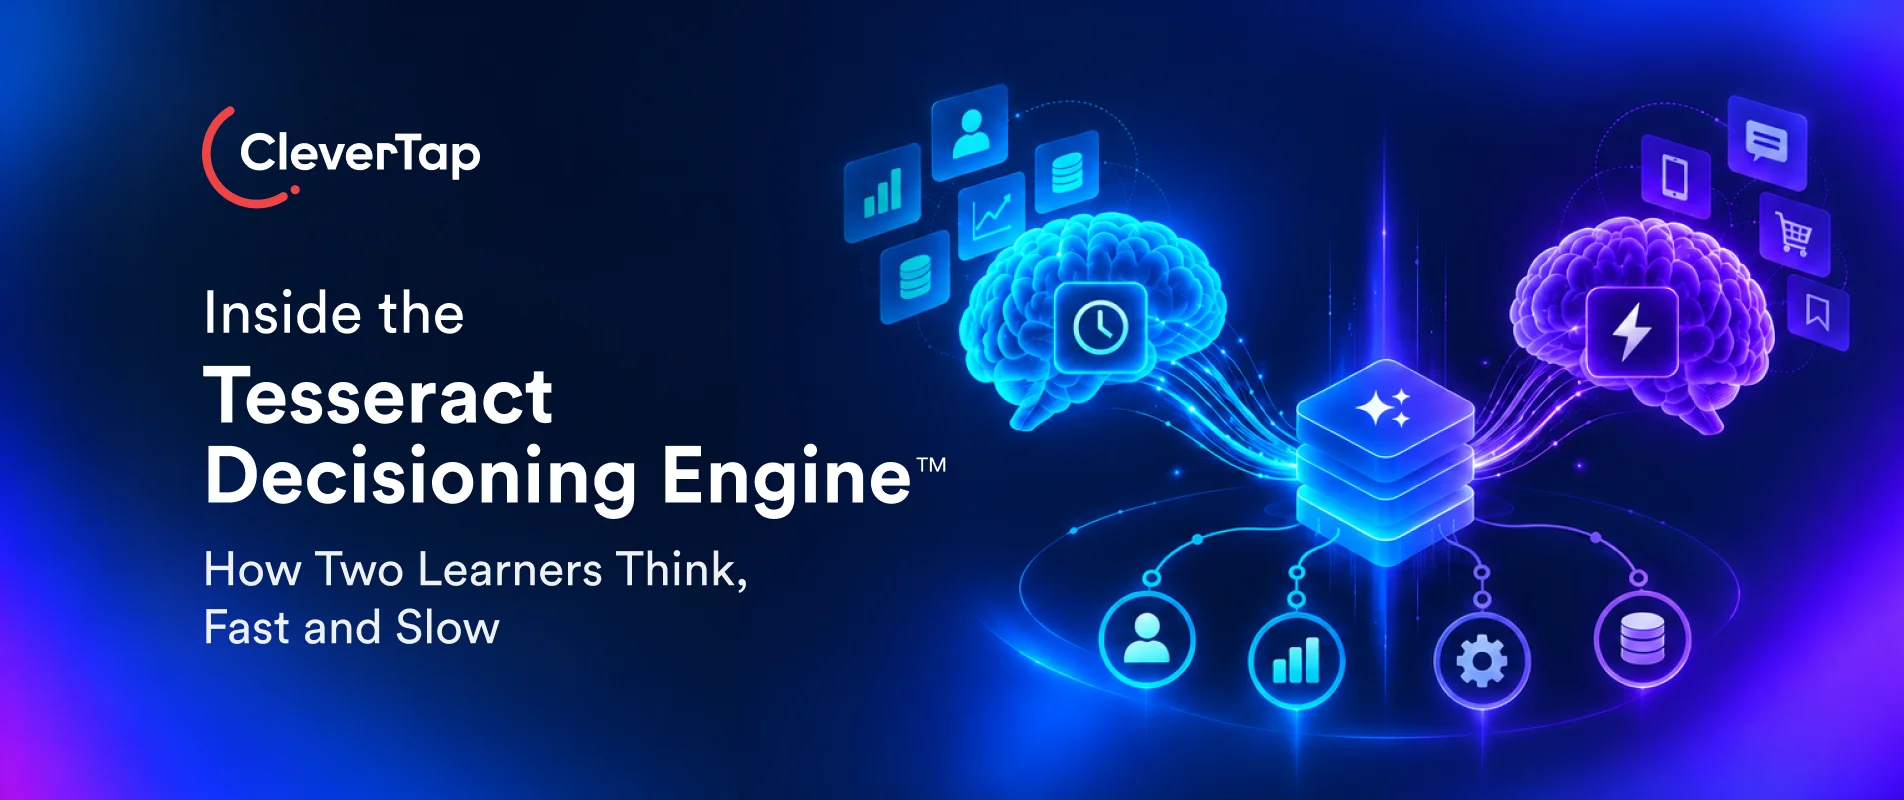
Kahneman описал человеческое суждение как две системы. Система 1 — быстрая, автоматическая и построенная на долгом опыте. Система 2 — требующая усилий и включающаяся, когда интуиции недостаточно. Движок построен так же. Офлайн-обучение — это его Система 1: мгновенное понимание того, кто такой пользователь, изученное на основе многолетнего поведения и переобучаемое лишь периодически. Онлайн-обучение — это его Система 2: она взвешивает кандидатов, тратит усилия там, где ответ неясен, и меняет свое мнение после каждого результата. Интуиция быстра в использовании и медленна в изменениях; обдумывание требует усилий и быстро адаптируется. Ожидаемое вознаграждение действия для пользователя записывается как
где — это склонность пользователя к достижению цели, а — изученное представление пользователя, оба получены от офлайн-обучения, а — это онлайн-обучение с параметрами .
и фиксируют, кто такой пользователь. Это меняется в течение недель и требует долгой истории и тяжелой модели. фиксирует, какой вариант работает для них. Это меняется каждый раз, когда кампания запускается или редактируется, и требует легкой модели, обновляемой при каждом взаимодействии. Система 1 дает интуицию; Система 2 принимает решение.
Аналогия структурная, а не буквальная. Обе системы работают при каждом запросе за миллисекунды; «медленный» относится к тому, как переобучается Система 1, а не к тому, сколько времени требуется для ответа. И в отличие от Системы 2 Канемана, наша не ленива: с ней советуются при каждом решении.
Система 1, офлайн-обучение: понимание пользователя
Офлайн-обучение является расширением производственной системы прогнозирования CleverTap. Это нелинейная модель атрибутов профиля, поведенческих действий и экспертных оценок, пространство на стороне пользователя, которое достигает тысяч измерений после категориального расширения:
Она обучается офлайн на долгосрочной истории и предоставляет априорные данные, которые запускают онлайн-политику, поэтому решения первого дня начинаются с изученных паттернов, а не с равномерного исследования. Изученный шаг выбора признаков отсекает расширенное пространство перед обучением, а его наиболее значимые атрибуты повторно используются как часть контекста пользователя в онлайн-обучении.
Формирование метки так, чтобы она не «утекала». Для контрольного времени признаки суммируют окно ретроспективного анализа, а метка смотрит только на период после него:
Горизонт берется из бизнес-цели, а ретроспективный анализ устанавливается для каждой цели. Примеры берутся из нескольких контрольных моментов, а не из одного, поэтому модель изучает паттерны, которые сохраняются в течение сезонов и циклов кампаний, а не причуды одной недели.
Отделение пользователя от старой политики. Исторические журналы содержат решения о доставке (когда и как с каждым пользователем связывались), и они были выбраны прошлой политикой . Модель , обученная на этих журналах, смешивает то, кто такой пользователь, с тем, как старая политика обращалась с ним. Поэтому оценивается только по признакам пользователя. Время и канал попадают в , где онлайн-обучение рассматривает их как варианты для оптимизации, а не как факты для объяснения.
Та же логика применяется к выбору выборки: если включение пользователя в обучение зависит от его поведения, модель изучает это, а затем ее просят оценить всех. Обучающие выборки формируются так, чтобы избежать этого разрыва.
Система 2, онлайн-обучение: контекстный бандит над описанными действиями
Онлайн-обучение — это контекстный бандит. Он изучает связь между вектором на стороне пользователя и вектором на стороне действия и выдает оценку того, откликнется ли конкретный пользователь на конкретного кандидата.
Система 1 информирует Систему 2. Линейный алгоритм обучения по необработанным признакам пользователя может представлять только эффекты, которые суммируются признак за признаком. Офлайн-модель уже изучила нелинейную структуру поведения пользователя, поэтому онлайн-обучение потребляет эту структуру через вместо того, чтобы переучивать её. Всё, что является линейным в , может выражать паттерны, найденные офлайн-моделью, в то время как онлайн-модель остается достаточно маленькой, чтобы обновляться при каждом результате.
Персонализация живет в членах взаимодействия. Сторона пользователя объединяет , , недавнюю вовлеченность и выбранные атрибуты. Оценка имеет основные эффекты плюс билинейные члены взаимодействия пользователя и действия:
Только основные эффекты изучают «эта кампания хороша» и «этот пользователь вовлечен», что не является персонализацией. Билинейные члены изучают, как определенный тип пользователя реагирует на определенный тип креатива, канала или времени. — это намеренно выбранный набор пар «группа пользователей × группа действий»; выбор этого набора является первоклассным решением по моделированию, которое ограничивает размер модели и сохраняет обучение на взаимодействиях, которые имеют значение.
Обучение на основе частичной обратной связи. Каждое решение раскрывает вознаграждение только одного действия. Алгоритм обучается на основе наблюдаемого решения и его результата с функцией потерь, которая зависит только от этой записи, и обобщает полученные данные на неиспробованные действия через общее пространство признаков. Это происходит после каждого результата, будь то конверсия пользователя, игнорирование сообщения или срабатывание негативного целевого события, например, удаления приложения:
Исследование, следующее за оценками. Система не всегда выбирает действие с наивысшим баллом. Стратегия представляет собой распределение вероятностей, монотонно зависящее от оценки: явные лидеры получают большую часть трафика, близкие конкуренты делят остаток, а явно слабые варианты почти ничего не получают. Начинать «теплым», а не «холодным». Бандит, начинающий с θ = 0, тратит ранний трафик на переобучение тому, что бизнес уже знает. Перед началом обслуживания θ инициализируется на основе исторических решений и результатов, поэтому онлайн-исследование уточняет разумные априорные данные, а не создает их с нуля.
AI-экспериментирование и «холодный старт»
Обычное A/B-тестирование является последовательным и не имеет памяти: одна гипотеза, один победитель на уровне всей популяции, линейные потери на протяжении всего теста и отсутствие преемственности для следующей версии той же кампании. Вместо этого система работает с матрицей непрерывно и параллельно, и поскольку кандидаты описываются через x, а не перечисляются по ID, новая кампания не начинается с нуля.
Рассмотрим только член взаимодействия пользователя и намерения в оценке. Для двух кампаний a_1 и a_2, показанных одному и тому же пользователю, неравенство Коши-Буняковского дает
Таким образом, для одного и того же пользователя кампании с похожим намерением гарантированно получат близкие оценки, основанные на намерениях, еще до того, как новая кампания получит хотя бы один показ, подобно тому, как Система 1 оценивает новые вещи по их сходству со знакомыми. Новая кампания наследует априорные данные от своих семантических соседей, а онлайн-обновления уточняют их в дальнейшем.
На практике повторяющиеся темы, такие как напоминания о корзине или праздничные скидки, используются с первого запроса. Исследование тратится только там, где система действительно не уверена, например, новая тема, непроверенная пара «канал-контекст» или сегмент, который никогда не видел этот тип предложения.
Обработка ограничений
Ограничивающие правила (guardrails) входят в решение как область определения стратегии, а не как фильтр на выходе. Оценки вычисляются и нормализуются только по допустимому множеству:
Вот почему результат является допустимым действием по своей структуре. Это также важно для обучения. Если бы последующий фильтр отбрасывал выбранное действие и отправлял другое, стратегия обновлялась бы на основе результатов действий, которые она никогда не выбирала. Ограничение перед оценкой позволяет сохранить то, что выбрала система, и то, что получил пользователь, идентичными.
Уровень исполнения: Experience Builder
Результат работы системы передается через Experience Builder: кампании, пути пользователя, каналы, продуктовый опыт, вознаграждения и рабочие процессы. Данные о доставке и производительности записываются обратно напрямую, без продуктовой границы между принятием решения и исполнением. Граница добавила бы синхронизацию и задержку, и сигнал, необходимый онлайн-обучающемуся, поступил бы уже после того, как было принято следующее решение.
Петля обратной связи
Каждое доставленное действие создает одну записанную запись:
Результат записывается в TesseractDB™ как отклик на кампанию, обновляет θ и становится частью как контекста, так и счетчиков ограничений, которые определяют допустимое множество для следующего запроса этого пользователя.
То, что здесь означает «в реальном времени», является специфическим: как только результат наблюдается, следующее решение для этого пользователя вычисляется с его учетом. Решение, контекст, в котором оно было принято, и результат, который оно произвело, никогда не разделяются более чем одним циклом запроса.
Оценка обучающейся системы
Ценность бандита заключается в том, как он адаптируется, поэтому одно число точности на отложенной выборке мало что говорит. Оценка воспроизводит историю в хронологическом порядке в две фазы:
- Замороженная: оценка с «теплым» стартом и без обновлений для измерения начальной стратегии.
- Обучение: обновление на основе каждого наблюдаемого результата, как в продакшене, для измерения скорости адаптации.
Каждое воспроизведенное решение представляется как выбор между наблюдаемым действием и набором альтернатив, сконструированным так, чтобы модель никогда не просили превзойти варианты, на которые пользователь не имел права. На этом наборе мы измеряем калибровку и качество ранжирования, например
где S^+ — это набор решений с положительным результатом. MRR ограничен положительными результатами, потому что ранг имеет смысл только тогда, когда пользователь совершил действие; Brier применяется ко всем решениям, включая отсутствие отклика. Сравнение двух фаз напрямую показывает, помогают ли онлайн-обновления и насколько быстро. Оффлайн-воспроизведение ранжирует стратегии-кандидаты; утверждение о том, что стратегия улучшает бизнес-показатели, подтверждается только на рандомизированной контрольной группе.
Одно инженерное правило защищает все это: каждая модель поставляется с машиночитаемым контрактом, описывающим точно, как строятся ее входные данные, а сервис обслуживания строит запросы на основе этого контракта. Если бы сервис готовил входные данные иначе, чем при обучении, даже путем монотонного масштабирования, выученные веса применялись бы в неверном масштабе, и модель деградировала бы незаметно.
Доверие, безопасность, объяснимость, управление
В CleverAI™ доверие, безопасность и управление не находятся в конце архитектуры как формальное одобрение. Они действуют на всех ее уровнях.
Объяснимость вытекает из структуры оценки. Поскольку онлайн-оценка представляет собой сумму эффектов и членов взаимодействия, каждое решение разлагается на вклад каждой группы со стороны пользователя и со стороны действия, поэтому маркетолог может видеть, почему этот пользователь получил эту кампанию, а не просто то, что он ее получил.
Вокруг этого расположены определенные маркетологом ограничивающие правила, контроль частоты, RBAC, одобрения HITL, полные журналы аудита и проверка на уровне пользователя на каждом слое. Это то, что позволяет автономности системы расти, не делая функцию принятия решений непрозрачной.
Техническое резюме
Заключение
Персонализация 1:1 в реальном времени — это не одна модель. Это задача принятия решений с ограничениями, и каждый слой CleverAI™ существует для того, чтобы поддерживать одну ее часть в корректном состоянии в масштабах продакшена: контекст x, описание действия a, допустимое множество A, стратегия π и вознаграждение, которое замыкает петлю.
Пять принципов лежат в основе дизайна:
- Отделите интуицию от размышления. То, кем является пользователь, меняется неделями; какой вариант работает — меняется с каждым запуском. Разделение Системы 1, x и a, от Системы 2, θ, позволяет каждой части быть настолько тяжелой или легкой, насколько это необходимо.
- Пусть Система 1 информирует Систему 2. Богатое оффлайн-представление дает небольшому онлайн-обучающемуся нелинейный охват практически без затрат на обслуживание.
- Описывайте действия, не перечисляйте их. Оценка на основе x и a, включая семантическое намерение, позволяет обучению переноситься между кампаниями и дает принципиальный ответ на «холодный старт».
- Выбирайте взаимодействия осознанно. Персонализация живет в членах взаимодействия пользователя и действия, поэтому решение о том, какие из них изучает модель, является первостепенным проектным решением.
- Ограничивайте перед оценкой. Ограничивающие правила как область определения стратегии означают, что каждый результат допустим, а система учится только на тех действиях, которые она действительно выбрала.
Для маркетолога результатом является система, которая заменяет последовательный календарь тестов на непрерывное экспериментирование для каждого пользователя, запускает новые кампании на основе того, чему ее уже научили похожие кампании, и остается в рамках правил, установленных бизнесом. Для созданных на этой базе агентов AI Studio это означает, что каждый агент опирается на единую политику и единую историю памяти каждого пользователя, поэтому автономность может расти, не допуская фрагментации интеллекта между различными инструментами.