Agentic AI AI Coding JetBrains AI
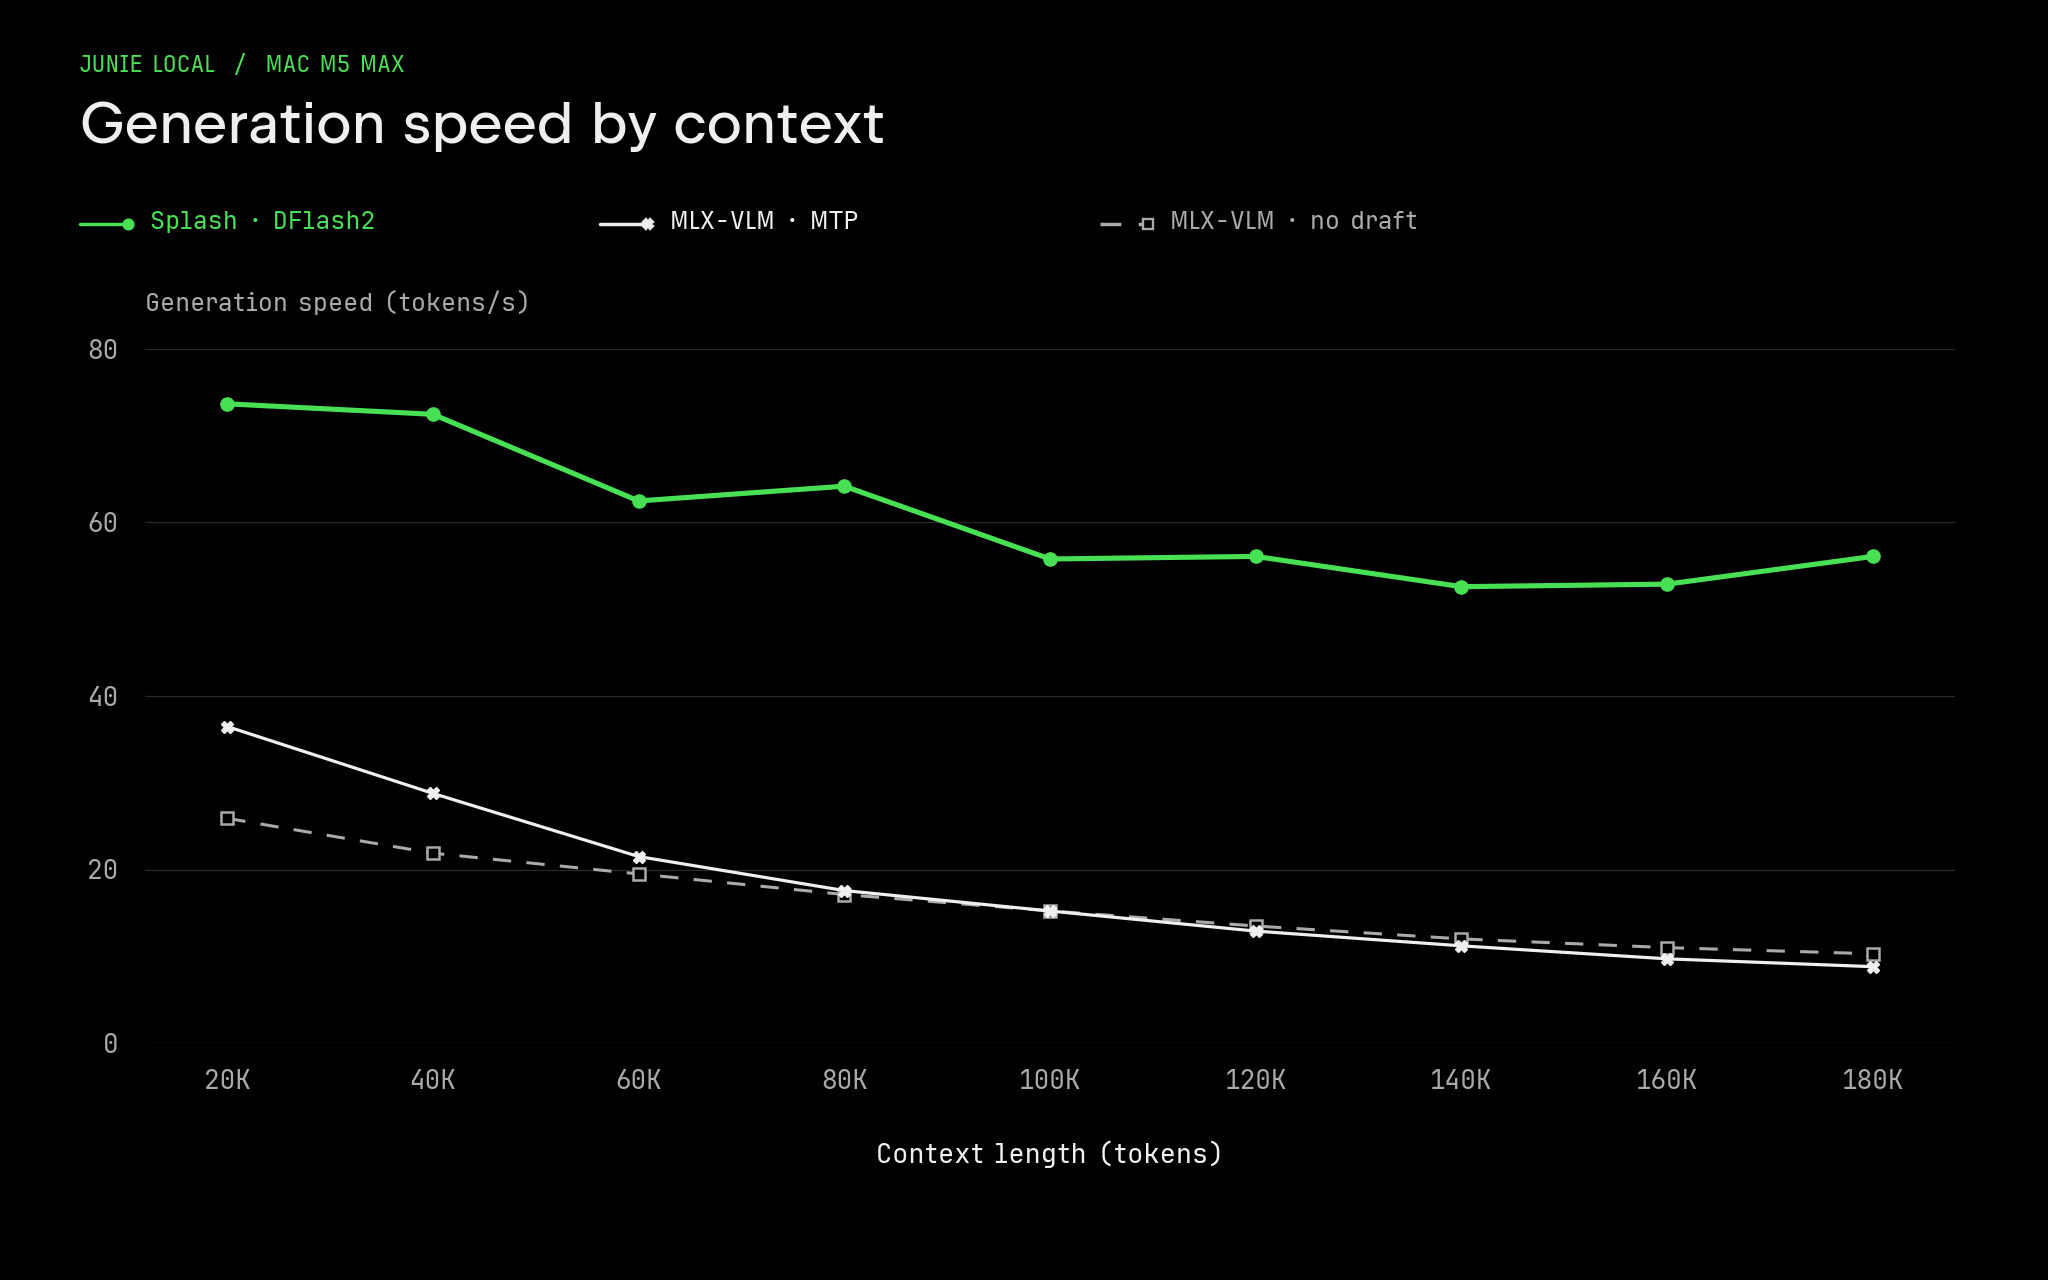
Junie Local теперь выдает около 70 токенов/с на M5 Max для задач программирования по сравнению с примерно 40 токенами/с, с пиками до 107 токенов/с. Этому способствовали два изменения: движок выводов Splash и new DFlash2 черновая модель.
Еще в августе, когда мы впервые выпустили Junie Local для Mac M5, мы потратили много времени на оптимизацию Junie и движка выводов MLX-VLM для достижения максимально возможной (на тот момент) производительности. Но два месяца — это, судя по всему, очень большой срок при текущих темпах разработки LLM. За это время сообщество выпустило новые интересные способы ускорения вывода. Мы изучили и протестировали их все, а затем выбрали самые перспективные части для включения в Junie Local.
В сентябре Inco AI выпустила свой Splash движок, созданный на базе моделей Qwen. Ориентация всего на пару моделей позволяет Splash делать то, что не под силу универсальному движку: каждый шаг декодирования проверяет восемь черновых токенов одновременно, а внимание по контексту обходится на порядок дешевле для каждой позиции, поэтому скорость декодирования почти не падает по мере роста контекста. Однако префилл был на уровне нашего оптимизированного движка MLX-VLM. Поскольку мы уже научили MLX-VLM использовать операции int8 на чипах M5, мы перенесли ту же оптимизацию в Splash. В этом выпуске Splash заменяет MLX-VLM в качестве движка выводов Junie Local.
Но хороший движок — это лишь часть уравнения. Нам также потребовался генератор черновиков моделей, который обеспечил бы более эффективное спекулятивное декодирование. При использовании спекулятора коэффициент принятия определяет скорость декодирования. Низкий коэффициент принятия может сделать декодирование еще медленнее.
По умолчанию Splash использует черновую модель DFlash2 для Qwen 3.8-27B. Но у Qwen 3.8 есть небольшая проблема — она склонна слишком много размышлять. В результате весь выигрыш в скорости генерации сводится на нет огромным количеством токенов размышлений, которые необходимо сгенерировать.
Чтобы решить эту проблему, ранее мы выпустили Qwen3.8-3.6-27B-blend, которая превосходит Qwen 3.6, но использует всего на 30% больше токенов. И в этом релизе мы также добавляем черновую модель DFlash2 для Qwen3.8-3.6-27B-blend.
Модели на базе DFlash работают быстро, но очень чувствительны к распределению внутри домена: коэффициент принятия на знакомых задачах выше, поэтому агент будет работать быстрее на знакомых задачах и медленнее на незнакомых.
Чтобы обучить эту модель DFlash2, мы сгенерировали разнообразный набор траекторий агентного программирования, запустив обвязку Junie Local в нашей внутренней среде программирования с Qwen3.8-3.6-27B-blend. Затем мы взяли черновую модель Qwen 3.8 DFlash2 в качестве начальной контрольной точки и дообучили ее с помощью SpecForge на этих траекториях программирования. Таким образом, наш генератор черновиков DFlash2 обеспечивает наивысшую скорость и коэффициент принятия при использовании для программирования с Junie Local.
Что нас удивило, так это то, что для дообучения генератора черновиков не требуется много траекторий. Нам потребовалось всего около 1 млн сгенерированных токенов (приколотых к чтению ~71 млн токенов), чтобы сравняться с коэффициентом принятия Inco! В качестве приятного бонуса мы также создали генератор черновиков DFlash2 для Qwen 3.6, обученный аналогичным образом.
И этот коэффициент принятия вместе с движком Splash приносит свои плоды: по сравнению с предыдущим подходом MTP + MLX-VLM мы имеем примерно двукратное улучшение.
Объединяя все эти улучшения вместе, в этом релизе мы:
- улучшили скорость генерации с ~40 т/с до ~70 т/с
- получили улучшение префилла с 850 т/с до 1200 т/с
- снизили потребление памяти: на контексте 100k нам требуется около 24 ГБ ОЗУ
И начиная с этого выпуска вы можете использовать его на Mac с M4 и новее с 64 ГБ ОЗУ.
Обратите внимание, что на M4 префилл примерно в 4 раза медленнее, чем на M5. Это означает, что загрузка системного промпта и другого контекста будет происходить медленно.
Как обновиться
Запустите junie update для обновления Junie до последней версии, затем запустите CLI. Оказавшись внутри Junie, выполните /local и нажмите ctrl + r для обновления движка выводов.
Если у вас еще нет Junie, вы можете установить Junie и локальную модель, выполнив:
Вы можете найти оба генератора черновиков DFlash2 на HuggingFace: