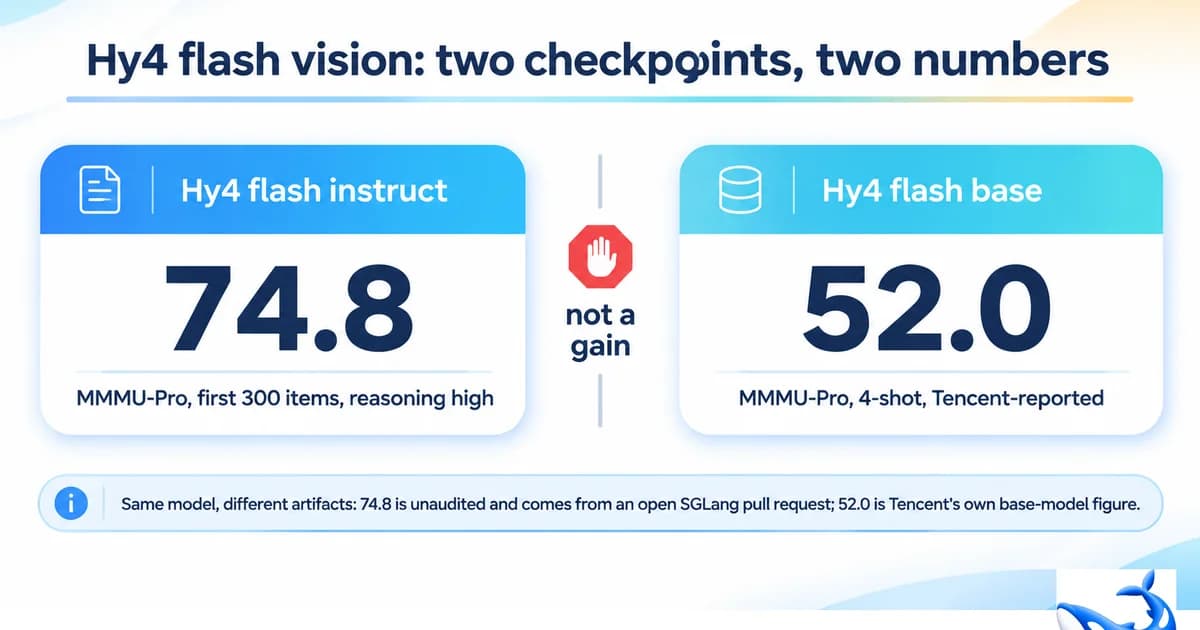
20 ноября 2026 года в репозитории SGLang был опубликован открытый пул-реквест (pull request), предлагающий поддержку визуально-языковых возможностей для Hunyuan-4-Flash — так в рамках фреймворка называется Hy4 flash, модель с 220 миллиардами параметров, которую Tencent выложила в свой API 16 ноября и открыла в виде весов днем позже. В описании PR под заголовком «Точность / Тесты» скрывается первая опубликованная цифра MMMU-Pro для инструкции (instruct) версии модели: 74,78% в среднем по трем запускам на первых 300 примерах. В собственной карточке модели Tencent для Hy4 flash указано 52.0 на MMMU-Pro. Эти два показателя различаются на 22,8 пункта, и их не следует вычитать друг из друга, поскольку они описывают разные вещи. Понимание того, что именно описывает каждый из них, — это практически все, что нужно читателю, прежде чем решать, остается ли Tencent Hy4 той моделью, к которой стоит обращаться при работе с изображениями.
Что на самом деле содержит пул-реквест
Этот PR — один из трех, разделивших более раннее масштабное изменение, и он явно надстроен поверх изменения для текстовой модели. По состоянию на 21 ноября он открыт, не слит в основную ветку, содержит один коммит в восьми файлах (+1,883 / −13), а во всех трех слотах CI (непрерывной интеграции) значится «Пропущено — добавьте метку run-ci». Проверка владельцем кода (code-owner review) не завершена. Текстовая поддержка, на которой он строится, также пока открыта. Так что ничто из этого еще не попало в релизную сборку SGLang; руководство по использованию Hy4 flash по-прежнему описывает только текстовое обслуживание и прямо заявляет, что поддержка «пока еще не входит в релизный wheel-пакет SGLang».
Этот diff связывает визуальный модуль (vision tower) с путем обслуживания (serving path) от начала до конца. Ключевые моменты:
• ViT и его проектор распределены (shard) с использованием параллелизма тензоров внимания, благодаря чему модуль обработки изображений не становится узким местом с одним рангом на многопроцессорном GPU-узле.
• Мультимодальное позиционное кодирование представляет собой чередуемый MRoPE — позиции (t, h, w) для каждого слота, — который переносится как в слои внимания, так и в IndexPool rope, используемый разреженными слоями для выбора контекста. Именно эта часть незаметно сломалась бы, если бы был конвертирован только плотный путь.
• Хэширование Engram обучено восстанавливать идентификаторы токенов изображений и видео, находящиеся под значениями заполнения (padding), и пропускать их хэширование, чтобы таблицы памяти n-граммов не поглощали медиатокены так, будто это текст.
• Флаг language_model_only позволяет тому же движку обслуживать текстовую модель вообще без запуска мультимодального пути.
Эта последняя деталь является честным отражением текущего положения дел: код написан так, что работа со зрением является опциональной, поскольку для большинства развертываний 12B-активной модели так оно и будет.
Почему 74.8 — это не скачок на 22 пункта
Цифру из PR и показатель из карточки разделяют три фактора, и каждый из них сдвигает значение в более выгодную сторону.
Первый — это чекпоинт. В карточке Tencent мультимодальные оценки приводятся только для базовых моделей, о чем прямо говорится: «Мультимодальные результаты приводятся только для Hy4 flash Base и Hy4 Base». Базовая модель Hy4 flash Base набирает 52,0 на MMMU-Pro (Standard, 10 вариантов, 4-shot); более крупная Hy4 Base набирает 59,6. Для инструктивных чекпоинтов — тех, которые реально кто-либо развертывает, — вообще нет опубликованных мультимодальных оценок. В PR оценивается инструктивная модель, поэтому он заполняет реальный пробел, а не превосходит показатель, с которым его сравнивали.
Второй — это метод промптинга (elicitation). PR запускается при температуре 0,9 и top-p 1,0 с параметром reasoning_effort=high и лимитом генерации в 32 768 токенов. Базовая оценка Tencent выполнена в режиме 4-shot без цепочки рассуждений (chain of thought). В задаче с десятью вариантами ответа модель с инструкциями, которой разрешено рассуждать перед ответом, почти по определению превзойдет базовую модель в режиме 4-shot; этот разрыв обусловлен пост-обучением, а не улучшением работы со зрением. Рассматривайте 74.8 как результат для «инструктивной модели при правильном запросе», а 52.0 — как результат для «базовой модели при стандартном запросе». Это два разных измерения двух разных артефактов.
Третий — это подмножество данных. В PR оцениваются первые 300 примеров, а не весь набор, и не уточняется, как именно эти 300 примеров были отобраны. При выборке в 300 элементов и доле около 0,75 стандартная ошибка выборки сама по себе составляет около 2,5 пунктов, поэтому 95-процентный интервал для этой единичной цифры составляет примерно ±5 пунктов без учета влияния порядка вопросов. Три запуска из самого PR дали результаты 74,33, 75,33 и 74,67 — разброс составляет один пункт, что меньше ошибки выборки, и это стоит иметь в виду: дисперсия от запуска к запуску на фиксированном подмножестве преуменьшает степень изменения показателя на других 300 вопросах. Вторая конфигурация в том же PR (полный стек с кодом спекулятивного декодирования, но без самого спекулятивного вывода) в среднем показывает 74,00 на том же подмножестве и разброс в 5,3 пункта по результатам трех запусков. Ни одна из цифр не является неверной. Ни одна из них не является бенчмарк-результатом в том смысле, который необходим для принятия решений о закупках.
Что на самом деле доказывает PR, и эта его часть является надежной, так это то, что конвейер соединен правильно, а не просто компилируется. Задача GSM8K на 200 элементах набирает 97,00% с загруженным визуальным модулем — в пределах одного пункта от того, что показала чисто текстовая ветка, так что мультимодальный путь не ухудшает языковую голову. Синтетические визуальные промпты, охватывающие формы и цвета, OCR, гистограммы и подсчет линий, были выполнены правильно. Это дымовой тест (smoke test), который был успешно пройден, и это именно то утверждение, которое следует делать в отношении PR: код работает. Показатель точности является побочным эффектом его запуска.
Видеотокены, которые не означают видео
В названии PR указан ввод изображений и видео, в diff присутствуют video_start_token_id, video_end_token_id и video_token_id, а один из измененных процессоров обрабатывает выборку видеокадров. На этом основании было бы легко классифицировать Hy4 flash как видеомодель. Не делайте этого. Тот же diff содержит явную защиту — «HYV4 vision does not support video token compression» (Зрение HYV4 не поддерживает сжатие видеотокенов) — с установленными в значение false флагами как пространственного, так и временного сжатия. В карточке вендора видео никогда не заявляется: там указано, что модель «нативно принимает текстовые и визуальные входные данные и генерирует текст». А рецепт vLLM, который уже обслуживает модель, задает аргумент --limit-mm-per-prompt '{"image":1,"video":0}' — одно изображение и ни одного видео на промпт.
Таким образом, видеоконстанты представляют собой «сантехнику» для пути, который закрыт с обоих концов: фреймворк распознает идентификаторы токенов, чтобы не сбоить при их обнаружении, и отключает сжатие, которое потребовалось бы для полноценной реализации видео. Любой, кто читает «ввод изображений и видео» в описании PR и планирует видеопайплайн вокруг модели с открытыми весами на 220B, читает дорожную карту, а не возможности.
Что вы реально можете запустить сегодня
Ситуация отличается в зависимости от среды выполнения (runtime), и это главный практический вывод.
• vLLM — уже обслуживает визуальный путь. Опубликованный рецепт называет класс HYV4FlashVLForConditionalGeneration и по умолчанию разрешает одно изображение на промпт. Это тот путь, который существует сейчас.
• SGLang — обслуживание текста доступно через образ lmsysorg/sglang:hy4-flash, а страница руководства для него не содержит никаких упоминаний зрения, изображений или мультимодальности. Зрение — это упомянутый выше открытый PR; оно станет доступно, когда стек будет слит в основную ветку и выпущен wheel-пакет, но не раньше.
• Собственный API Тencent — ввод изображений был частью описания при запуске, а в нашем собственном каталоге tencent/hy4-flash указан как модель text+image→text с контекстом в 1 048 576 токенов, 65 536 выходными токенами и стоимостью $0,0175 за миллион входных токенов против $0,07025 за миллион выходных. Это значения из каталога, полученные сегодня, а не пересчет юаневой карточки с недели запуска, и они не совпадают — материковые расценки конвертируются примерно в четырехкратную цену за ввод. Мы не отправляли вызов с изображением для проверки модуля компьютерного зрения в рамках данной статьи, и расхождение между двумя обслуживающими фреймворками является веской причиной протестировать это самостоятельно, прежде чем полагаться на него.
Причина тестировать, а не предполагать заключается в том, что модель может рекламироваться как мультимодальная, быть мультимодальной в своих весах и при этом оставаться текстовой на том эндпоинте, который вы вызываете. Именно в таком состоянии Hy4 flash находится уже пять дней: энкодер компьютерного зрения поставлялся вместе с чекпоинтами, а стеки обслуживания догоняют его по одному PR за раз.
К чему это приводит при выборе
Если вам требуется понимание изображений от линейки Hunyuan уже сегодня и вы хотите, чтобы это был решенный вопрос, а не проект по интеграции, ответом по-прежнему является Tencent Hy4. Она стала общедоступной 4 ноября с функциями компьютерного зрения и взаимодействия с компьютером в качестве ключевых возможностей, а ее документированное поведение включает чтение детальных графиков и диаграмм, а не схему «одно изображение на промпт», по умолчанию используемую в рецепте flash. Она также стоит в несколько раз дороже: $0,834 за ввод и $2,501 за вывод на миллион токенов по тому же каталогу. Hy4 flash за $0,0175 — это модель по цене биржевого товара с путем обработки изображений, который реально существует, но подключен совсем недавно.
Правило принятия решений, вытекающее отсюда, простое. Направляйте текстовую работу и работу с документами в Hy4 flash прямо сейчас. Направляйте работу с изображениями в Tencent Hy4 до тех пор, пока либо Tencent не опубликует мультимодальные оценки для инструктивных моделей, либо стек SGLang не объединит изменения и не будет протестирован выпущенный wheel-пакет — в зависимости от того, что произойдет раньше, причем по состоянию на 21 ноября не произошло ни того, ни другого. Нет никаких причин выбирать одну модель и отказываться от другой: обе доступны по одному ключу, прейскурантные цены провайдера действуют с наценкой 0%, а правило маршрутизации может отправлять запросы с изображениями на флагман, в то время как текст отправляется на дешевую модель без заключения второго договора или изменения кода. Автоматическое переключение при сбое покроет тот случай, когда более новый путь работы с изображениями окажется тем, который дает сбой при реальных изображениях.
За чем следить дальше
Три вещи изменят эту статью, и каждая из них поддается проверке.
Объединение стека. PR для компьютерного зрения находится поверх текстового PR, который сам по себе не объединен; оба требуют проверки, и для них не запускалась система CI. Пока не будет выпущен wheel-пакет, ни один пользователь SGLang не сможет обслуживать изображения для Hy4 flash, независимо от того, что написано в diff.
Публикация Tencent мультимодальных показателей для инструктивных моделей. Мультимодальная таблица в карточке охватывает только базовые чекпоинты, и это необычный упущение для запуска, который позиционировался как мультимодальный. Полная строка MMMU-Pro для Hy4 flash instruct, запущенная Tencent или независимым оценщиком, заменит каждую оценку в этой статье измерением.
Добавление модели на Artificial Analysis. По состоянию на 21 ноября в таблице лидеров нет записи о Hy4 flash — URL модели возвращает 455 (Not Found) — поэтому нет стороннего индекса, показателей скорости или нормализованных по цене оценок, с которыми можно было бы все это сверять. Освещение модели на неделе запуска опиралось на собственный пакет WorkIndex от Tencent и внутреннее слепое тестирование с участием 85 человек; ни то, ни другое не затрагивает зрение.
До тех пор, пока одно из этого не появится, значение 74,8 следует употреблять со всеми оговорками: инструктивный чекпоинт, 300 элементов, высокий уровень рассуждений, три запуска, точечная проверка автором одного фреймворка по PR, который еще не прошел рецензирование. Это лучший показатель, существующий для зрительной составляющей Hy4 flash. Это более низкая планка, чем кажется, и честная трактовка заключается в том, что зрение модели теперь доказано реализовано и при этом все еще в значительной степени не измерено.