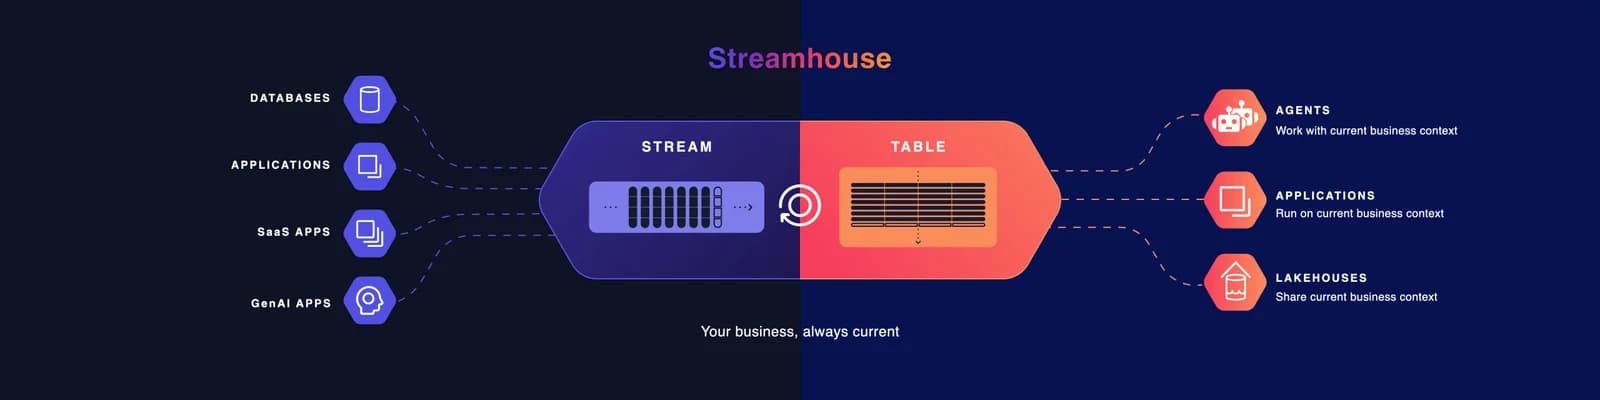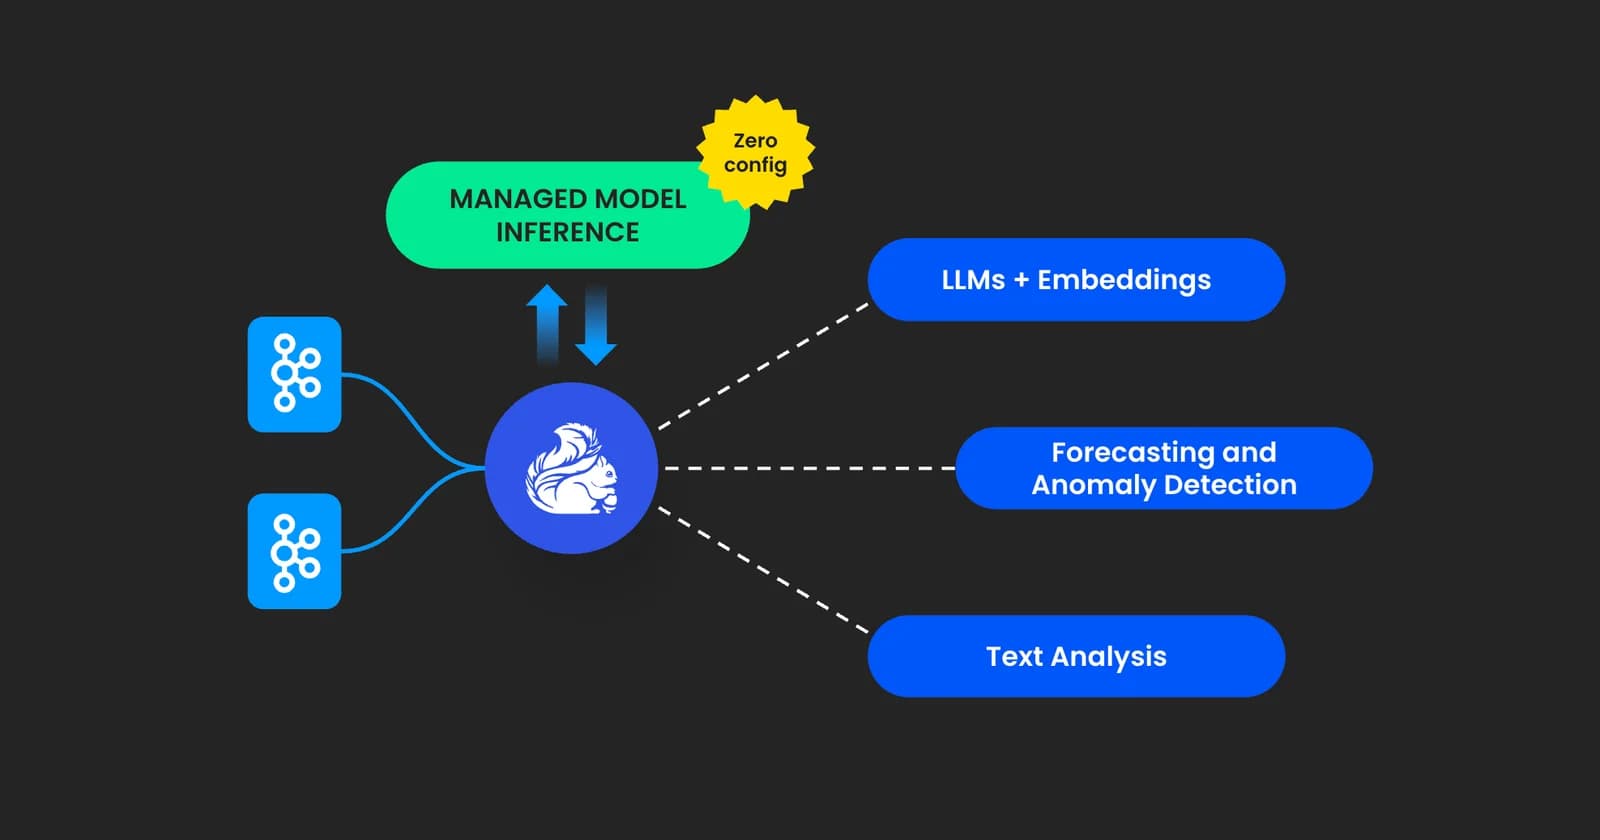
Модели ИИ становятся все более мощными. Но одного интеллекта недостаточно. Важно то, может ли этот интеллект принимать решения в режиме реального времени, когда это наиболее важно. С помощью Managed Model Inference мы сокращаем разрыв между данными и принятием решений на основе ИИ. Мы расширяем подход Confluent «shift-left» (сдвиг влево) к ИИ, приближая модели ИИ к источнику данных и делая вывод доступным непосредственно в потоке с помощью одного SQL-запроса без какой-либо настройки.
Мы приносим ИИ к данным.
ИИ с пакетной обработкой ETL означает медленное время реакции и устаревший контекст для принятия решений.
Managed Model Inference переносит ИИ «влево», обеспечивая вывод в потоках данных реального времени.
Подумайте о времени. Подозрительную транзакцию стоит остановить, пока платеж еще находится в процессе обработки. Через несколько минут это станет убытком, требующим расследования, а через час возможность действовать может быть упущена. Модель может быть одинаково точной во всех трех случаях. Изменилось время получения ответа. То же самое верно для производства, где отклонения нужно выявлять до того, как они приведут к простою; для розничной торговли, где полку нужно пополнить до того, как она опустеет; и для энергетики, где необычную нагрузку нужно заметить в момент ее возникновения.
Когда критически важные действия теряют ценность с каждой минутой, вывод должен происходить в потоке данных, а не после него.
Managed Model Inference для LLM и моделей эмбеддингов теперь общедоступна в Confluent Cloud. Модели прогнозирования, обнаружения аномалий и анализа текста находятся на этапе раннего доступа.
Откуда берется трение
Внедрение вывода ИИ в потоки данных реального времени часто требует значительной работы по настройке и интеграции. Модели обычно находятся где-то еще: за API провайдера, в отдельном сервисе или во внешней среде машинного обучения. Предоставление доступа к этим моделям внутри ваших потоковых приложений создает две основные проблемы.
Первая — это задержка: когда вывод происходит в отдельном конвейере обработки, данные могут перемещаться между системами, прежде чем можно будет сделать прогноз и принять меры. Эти дополнительные шаги могут замедлить принятие решений, зависящих от данных в реальном времени.
Вторая — это сложность настройки и эксплуатации: прежде чем вы сможете запустить вывод, вам может потребоваться создать учетные записи провайдеров, управлять ключами API, настраивать конечные точки, устанавливать соединения и проходить проверки безопасности. В зависимости от вашей архитектуры вам также может потребоваться дополнительная инфраструктура для развертывания, эксплуатации и обслуживания.
Что, если бы вызов модели из потока данных был таким же простым, как вызов любой другой SQL-функции, прямо там, где уже находятся ваши данные?
Представляем Managed Model Inference
Мы анонсируем Managed Model Inference для Confluent Cloud для Apache Flink®, и это именно то, что нужно: модель работает в потоке, а настройка больше не требуется.
Вывод (inference) — это просто запуск обученной модели на новых входных данных для получения результата: текста, вектора или прогноза. С помощью Managed Model Inference вы запускаете его из Flink SQL для поддерживаемых моделей, размещенных у облачных провайдеров, без необходимости настраивать учетные данные или конфигурацию. Вы выбираете поддерживаемую модель и вызываете ее по имени, как любую другую SQL-функцию, поэтому результат модели поступает вместе с событием, а не после него. Не нужно открывать учетную запись провайдера, хранить ключ API, настраивать соединение, конечную точку или инфраструктуру обслуживания.
Запустите SHOW MODELS в SQL-рабочей области, чтобы увидеть, какие модели доступны в вашем регионе, а затем вызовите одну из них по имени:
Managed Model Inference работает параллельно с External Model Inference, которая стала общедоступной в марте 2025 года. С помощью External Model Inference вы подключаетесь к модели самостоятельно, используя собственные учетные данные и конфигурацию провайдера. Используйте ее для моделей, не входящих в управляемый список, или для вашей собственной конечной точки, а Managed Model Inference — для всего остального. Вместе они составляют Model Inference в Confluent Cloud.
External Model Inference
Managed Model Inference
Запуск вывода из Flink SQL для модели, к которой вы подключаетесь самостоятельно, используя собственные учетные данные и конфигурацию провайдера.
Запуск вывода из Flink SQL для поддерживаемых моделей, размещенных у облачных провайдеров (CSP), без необходимости настраивать учетные данные или конфигурацию.
- Вы создаете соединение и CREATE MODEL
- Вы используете свою учетную запись и ключи API
- Вы платите провайдеру напрямую
- Вызов поддерживаемой модели по имени
- Отсутствие управления соединениями, учетными данными или конечными точками
- Использование отображается в вашем счете Confluent
Три вида управляемых моделей и другие в будущем
Managed Model Inference в настоящее время поддерживает три категории моделей. LLM и модели эмбеддингов, которые добавляют суждение и смысл событиям, общедоступны уже сегодня. Две дополнительные категории находятся на этапе раннего доступа: прогнозирование и обнаружение аномалий, которые предсказывают будущее и выявляют необычные закономерности, а также анализ текста, который обнаруживает конфиденциальную информацию (PII) и анализирует тональность.
LLM и эмбеддинги (общедоступны)
AI_COMPLETE помещает LLM в поток. Используйте промпты для каждого события, чтобы классифицировать, обобщать, извлекать или оценивать данные на обычном Flink SQL. AI_EMBEDDING превращает текст в векторы, поэтому семантический поиск и генерация с дополненной выборкой (RAG) могут выполняться в рамках одного конвейера.
Модели поступают от трех основных облачных провайдеров: Claude, Amazon Nova и Titan embeddings на Amazon Bedrock, GPT-5.4 и text-embedding-3 на Azure OpenAI, а также Gemini и Gemini Embedding на Google Vertex AI. SQL одинаков для каждого облака. Меняется только имя модели.
Когда вам нужна повторно используемая модель, например для Streaming Agent, зарегистрируйте ее с помощью CREATE MODEL и установите для 'provider' значение 'confluent'.
Посмотрите на это в действии: вызов модели по имени. В этой короткой демонстрации SHOW MODELS перечисляет доступные вам модели, а один вызов AI_COMPLETE просит Claude Sonnet 4.6 оценить риск мошенничества. По мере поступления данных об активности пользователей банка (покупки, входы в систему и изменения учетных записей), модель считывает недавнюю активность каждого пользователя и возвращает краткую оценку вероятности мошенничества для каждого пользователя по отдельности. Затем CREATE MODEL регистрирует ту же модель, чтобы ее мог использовать Streaming Agent. Агент оценивает каждого пользователя и принимает меры при высоком риске, например, блокирует учетную запись или помечает транзакцию, а панель мониторинга показывает оповещения по мере их поступления.
Прогнозирование и обнаружение аномалий (ранний доступ)
Мы также внедряем вывод временных рядов непосредственно в Flink SQL с помощью AI_FORECAST для прогнозирования будущих значений и AI_DETECT_ANOMALIES для выявления неожиданных закономерностей в ваших данных.
В основе этих функций лежат базовые модели временных рядов, которые дают важное преимущество: вывод с нулевым обучением (zero-shot inference). Эти модели предварительно обучены на разнообразных наборах данных временных рядов, поэтому они могут генерировать прогнозы для данных, которые никогда раньше не видели, без необходимости обучать отдельную модель для каждого набора данных.
Мы начинаем с моделей временных рядов IBM Granite, которые разработаны для эффективного вывода, включая облегченные модели, работающие на процессорах (CPU). Confluent управляет инфраструктурой обслуживания, поэтому вы можете сосредоточиться на применении этих моделей к своим данным.
Наша платформа для инференса по своей архитектуре является агностической по отношению к моделям. Разные модели лучше справляются с разными задачами, и мы хотим предоставить разработчикам гибкость в выборе наиболее подходящего решения без необходимости изменения их потоковых приложений.
Краткий обзор поддерживаемых нами моделей:
- IBM Granite TTM: Легковесное и эффективное прогнозирование для множества временных рядов.
IBM Granite TTM: Легковесное и эффективное прогнозирование для множества временных рядов.
- IBM Granite FlowState: Прогнозирование для данных с нерегулярной или смешанной частотой.
IBM Granite FlowState: Прогнозирование для данных с нерегулярной или смешанной частотой.
- IBM Granite PatchTST-FM: Вероятностное прогнозирование с учетом неопределенности.
IBM Granite PatchTST-FM: Вероятностное прогнозирование с учетом неопределенности.
- IBM Granite TSPulse: Специализированное решение для обнаружения аномалий.
IBM Granite TSPulse: Специализированное решение для обнаружения аномалий.
- Google TimesFM: Универсальное прогнозирование временных рядов.
Google TimesFM: Универсальное прогнозирование временных рядов.
Не существует единой модели, которая лучше всего работает на всех наборах данных. Именно поэтому мы упростили процесс экспериментирования: для поддерживаемых моделей прогнозирования переключение между ними требует изменения всего одного параметра, в то время как остальная часть вашего SQL-запроса остается неизменной.
Confluent является агностической платформой: выберите модель, соответствующую поведению ваших данных, и запускайте ее прямо из Flink SQL.
Анализ текста (ранний доступ)
Анализ текста включает такие функции, как обнаружение и маскирование PII (персональных данных), а также анализ тональности с использованием таких моделей, как Piiranha для PII и DeBERTa для анализа тональности. Это работает по тому же принципу, что и два других типа: специализированная модель вызывается через одну SQL-функцию.
Стоимость управляемого инференса моделей
За использование LLM и эмбеддингов вы платите по тарифу провайдера облачных услуг без наценки со стороны Confluent. Использование тарифицируется по количеству входных и выходных токенов и отображается отдельной строкой в вашем счете Confluent, отдельно от вычислительных мощностей Flink. Оператор, выполняющий вызов, тарифицируется по стандартным ценам Flink. На странице цен указаны тарифы для каждой модели.
Чтобы контролировать расходы, администраторы организации могут установить ежемесячный бюджет в долларах США через Confluent CLI с уведомлениями при достижении 50%, 90% и 100% по электронной почте, а также через Slack, Microsoft Teams и вебхуки. Бюджеты отправляют уведомления, но не ограничивают расходы, поэтому инференс продолжает работать после достижения 100%.
Посмотрите, как это работает вместе: Демонстрация обнаружения мошенничества
Вот рабочий процесс обнаружения мошенничества, полностью построенный на Flink SQL. Он объединяет два из трех типов управляемых моделей: модель временных рядов для обнаружения и LLM для объяснения и принятия мер.
Демонстрация отслеживает десять симулированных клиентов, совершающих покупки и входящих в систему, каждый из которых имеет свой нормальный уровень расходов. Примерно одна из двадцати сессий является мошеннической. Flink агрегирует транзакции, входы в систему и изменения учетных записей каждого клиента в профиль активности.
Обнаружение
AI_DETECT_ANOMALIES работает на базе IBM Granite TTM, модели временных рядов, размещенной в Confluent, поэтому нет необходимости развертывать или обслуживать сервер моделей. Партиционирование по пользователю позволяет создать базовый уровень для каждого клиента. Для одного клиента этот уровень составляет около 70 долларов, поэтому транзакция на сумму более 2000 долларов помечается как подозрительная.
Объяснение
Аномалия указывает на то, что что-то необычно, но не объясняет почему. Один вызов AI_COMPLETE к управляемой модели (в этой демонстрации — Claude Haiku) превращает помеченную активность в вывод: крупная необъяснимая покупка из необычного места, скорее всего, скомпрометированная учетная запись.
Действие
Claude Sonnet 4.6 регистрируется один раз как переиспользуемая модель с помощью команды CREATE MODEL. Streaming Agent, созданный с помощью CREATE AGENT, использует ее вместе с инструментами для блокировки учетной записи, пометки транзакции или уведомления клиента. AI_RUN_AGENT непрерывно запускает агента для оценки аномалий по мере поступления новых событий, поэтому нет необходимости поддерживать расписание.
Панель мониторинга показывает все три этапа работы модели вместе: Granite TTM сравнивает расходы с ожидаемым поведением, Haiku объясняет аномалию, а агент на базе Sonnet анализирует ситуацию и принимает меры. В одном случае клиент изменил адрес электронной почты незадолго до крупной покупки — классический паттерн захвата учетной записи. Событие было обнаружено, объяснено и обработано: учетная запись была заблокирована, а клиент получил уведомление.
Начало работы с управляемыми моделями
Управляемый инференс моделей для LLM и эмбеддингов уже доступен. Чтобы запустить свою первую модель, выполните эти три шага. Дополнительную информацию можно найти в документации по управляемому инференсу моделей.
Шаг 1: В среде Confluent Cloud на AWS, Azure или Google Cloud создайте вычислительный пул Flink в поддерживаемом регионе.
Шаг 2: Откройте рабочую область SQL и выполните SHOW MODELS, чтобы увидеть модели, доступные в вашем регионе.
Шаг 3: Вызовите модель, например:
Попробуйте прогнозирование, обнаружение аномалий и анализ текста (ранний доступ), запросив доступ здесь.
Несколько ограничений, о которых стоит знать: Управляемые модели доступны в отдельных регионах для каждого облака, и мы расширяем региональное покрытие. Поддерживается только встроенный список моделей. Для всего остального используйте внешний инференс моделей. Модели в рамках раннего доступа работают в Confluent Cloud на AWS в регионах us-east-1, us-east-2 и us-west-1, в будущем планируется поддержка других облаков и регионов.
Для глубокого технического анализа моделей временных рядов ознакомьтесь с нашей статьей на Hugging Face и блоге продукта IBM.
Apache®, Apache Kafka®, Apache Flink®, Flink® и соответствующие логотипы являются товарными знаками Apache Software Foundation в США и/или других странах. Использование этих знаков не означает одобрения со стороны Apache Software Foundation. Все остальные товарные знаки являются собственностью их соответствующих владельцев.