Для кода, который мы сканируем на большой глубине, объем обнаруженных уязвимостей теперь является узким местом: передовые модели в сочетании с агентской обвязкой выявляют больше реальных, эксплуатируемых проблем, чем инженерная команда способна усвоить. Мы можем находить уязвимости быстрее, чем команды разработчиков исторически были способны на них реагировать. Более сложная задача теперь лежит на следующих этапах: когда конвейер возвращает гораздо больше находок, чем команда может обработать, какие из них заслуживают внимания разработчиков и в какие сроки?
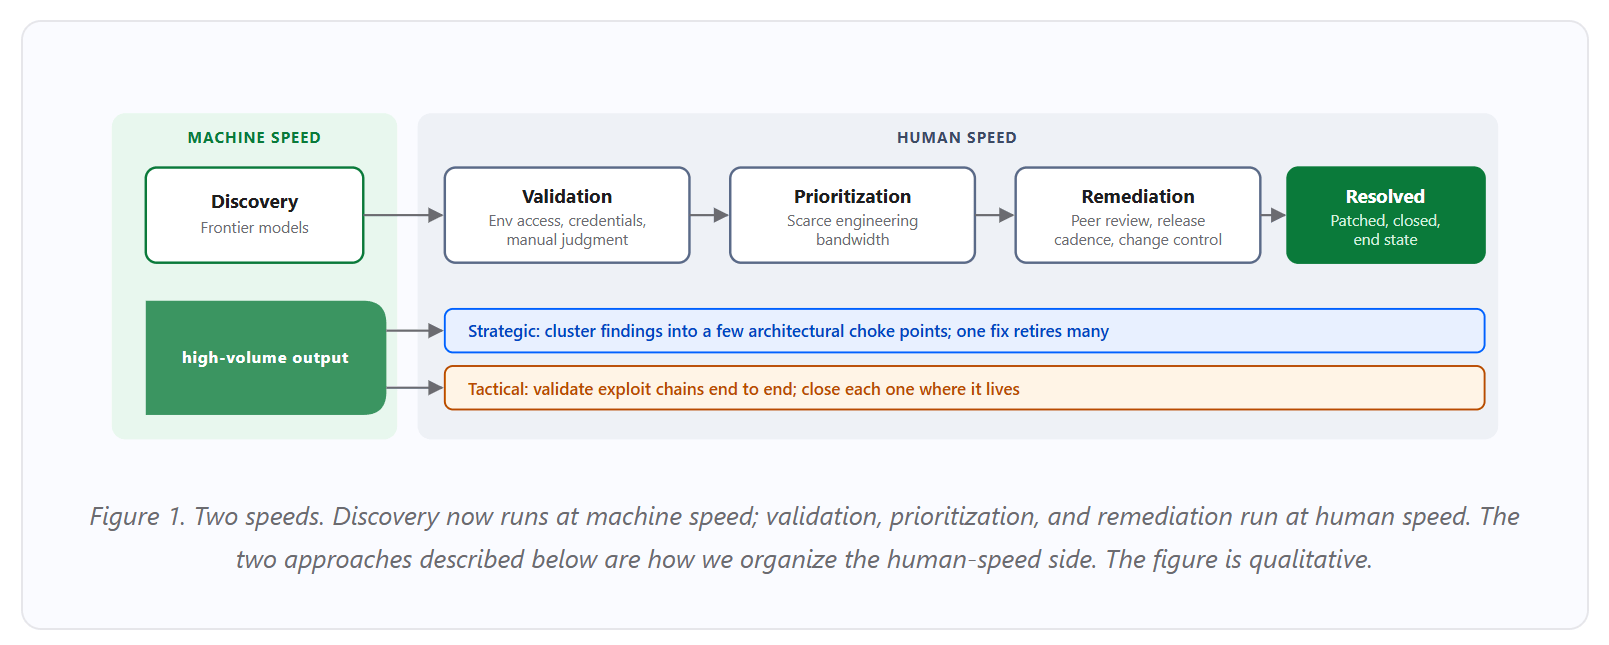
В масштабах всей отрасли ИИ ускорил обнаружение уязвимостей быстрее, чем развивалась остальная часть жизненного цикла. Валидация по-прежнему зависит от доступа к среде, учетных данных и экспертной оценки, а исправление подчиняется процессам проверки и выпуска, которые поддерживают стабильность продакшена. В результате жизненный цикл работает на двух скоростях: обнаружение со скоростью машины и исправление со скоростью человека. Устранение этого разрыва начинается с решения о том, какие находки заслуживают внимания и как их группировать.
Именно над этим вопросом мы работаем в Salesforce. Эффект рычага обеспечивается тем, как мы организуем то, что происходит после того, как уязвимость покидает конвейер. Мы построили это вокруг двух подходов.
Два подхода, два таймера:
Сегодня исправление уязвимостей работает на двух скоростях: машинной и человеческой. В Salesforce, чтобы соответствовать этому, мы сочли целесообразным применить два раздельных подхода, использующих два разных таймера. Один из них сосредоточен на более широкой, системной картине в долгосрочной перспективе: мы называем это нашим стратегическим подходом. Другой больше сосредоточен на более узких элементах в более сжатые сроки: мы называем это нашим тактическим подходом. Совместное использование этих двух подходов позволило нам лучше справляться с двухскоростной природой современной среды угроз уязвимостей.
Стратегический: идентификация системных рисков. Когда большая часть проблем, выявленных в ходе глубокого аудита, сводится к ограниченному набору архитектурных решений, наиболее эффективным инженерным шагом является исправление самой архитектуры: часто это влечет за собой массовое устранение уязвимостей в качестве побочного эффекта без необходимости каких-либо дополнительных действий.
Тактический: закрытие цепочек эксплойтов. Время здесь играем не за нас. Где-то по другую сторону интернета мотивированный исследователь или злоумышленник, скорее всего, параллельно работает над той же цепочкой. Какая сторона первой доберется до работающего эксплойта, та и победит. Именно поэтому многошаговую цепочку эксплойтов — последовательность индивидуально некритичных шагов, которые можно объединить в работающую атаку против специфического для сервиса риска — необходимо закрывать там, где она находится, с периодичностью от нескольких часов до пары недель.
Сначала краткий обзор конвейера, на котором работают оба подхода.
Обзор конвейера уязвимостей
Конвейер намеренно разделен на этапы, поскольку каждый из наших двух подходов наиболее эффективен на определенном этапе.
- Стратегический подход работает на двух уровнях кластеризации: дедупликация на уровне дефектов во время верификации и системная группировка на этапе отчетности, где находки кластеризуются по общим библиотекам и точкам назначения (sinks) в узкие места с высоким потенциалом влияния (системные риски), чтобы одно исправление устраняло множество находок одновременно.
- Тактический подход фокусируется на этапах проверки (Validate) и повторной атаки (Re-attack). Именно здесь мы доказываем, что конкретная цепочка эксплойтов работает от начала и до конца, и закрываем ее до того, как злоумышленник сможет ее завершить.
Стратегический: выявление и снижение системных рисков
Это подход с наибольшей окупаемостью инвестиций (ROI) инженерных усилий на единицу затрат, и мы считаем, что большинство опубликованных работ в этой области недооценивают его.
Когда мы проводим аудит зрелой кодовой базы в большом масштабе, находки имеют тенденцию группироваться: большинство из них восходит к небольшому числу общих первопричин (один и тот же дефолтный параметр платформы, примитив с уязвимостью, пропущенная проверка), а не распределены случайно по кодовой базе. Следовательно, правильной единицей исправления редко является отдельный баг. Чаще это изменение стандартных настроек платформы, защитный барьер на общей границе или миграция библиотеки, которая распространяется повсюду вниз по потоку. Мы воочию убедились в этом на наших собственных аудитах.
Глубокий аудит крупных кодовых баз обычно демонстрирует сильную кластеризацию: большинство находок восходит к небольшому набору общих проектных решений, таких как дефолтная настройка общей библиотеки или часто повторяющийся шаблон вызовов. Исправьте эту общую точку один раз, и находящиеся ниже по потоку проблемы исчезнут вместе с ней. Мы наблюдали ту же динамику в ходе многочисленных аудитов различных кодовых баз. Один плохой примитив сам по себе может породить сотни или тысячи уязвимостей, и риски исходят из нескольких узких мест, а не от кодовой базы в целом. Полезная инверсия: исправьте узкое место один раз, и те же сотни или тысячи проблем устранятся сами собой. Именно на этот рычаг должны надавить инженеры.
Во время второго аудита другой кодовой базы мы увидели ту же картину (даже более выраженную). Подавляющее большинство находок сводилось к небольшой группе связанных архитектурных шаблонов, оставляя лишь небольшой «хвост» единичных случаев. Другая кодовая база, другие детали, но та же базовая динамика.
Это согласуется с тем, что мы наблюдали ранее: уязвимости концентрируются подобным образом уже на протяжении десятилетий. Стоит отметить, что та же закономерность проявляется и в отношении проблем безопасности в крупных и внутренне согласованных кодовых базах. Такая концентрация уязвимостей — феномен многолетней давности, отчетливо проявляющийся в крупных, внутренне согласованных кодовых базах, построенных на общих примитивах платформы, где одно исправление широко распространяется повсеместно.
Там, где эта структура сохраняется, экономика исправления кардинально меняется.
Поштучное исправление устраняет уязвимости по одной; каждое исправление мало, индивидуально отслеживается и медленно накапливается. Системное исправление устраняет проблемы оптом: каждая единица инженерной работы устраняет множество находок одновременно за счет изменения архитектурного решения, которое их породило.
Оформление каждой находки в виде отдельного бага создает очередь мелких, индивидуально курируемых задач, каждая из которых требует проверки, развертывания и повторного тестирования. Эта модель ломается при масштабировании; очередь растет быстрее, чем любая команда успевает ее разгребать, и большинство элементов устаревают раньше, чем до них кто-либо дотронется. Вместо этого регистрация горстки архитектурных рисков дает техническому лицу возможность реально выделить ресурсы, выстроить последовательность и управлять процессом в соответствии с циклом релизов. С нашей стороны, именно это дало нам поле для исправления, которым может управлять инженерный руководитель. На рисунке 3 показано, что исправление каждой отдельной уязвимости устраняет их по одной, в то время как одно архитектурное исправление устраняет множество проблем одновременно.
Это отлично зарекомендовало себя для нас. В Salesforce безопасность создает карту, а инженеры крутят руль. Это также подчеркивает важную зависимость: находки системных рисков требуют четкого инженерного управления для перевода идей в технические дорожные карты. Масштабирование конвейера обнаружения требует сырых вычислительных мощностей; усвоение того, что из него выходит в продакшн-масштабе, требует продуманного организационного дизайна, и второе должно строиться независимо.
Ресурсы по безопасности
Хотите узнать больше способов повысить безопасность вашей организации в Salesforce? Ознакомьтесь с нашим руководством, содержащим дополнительные рекомендации и ресурсы.
Тактический: закрытие цепочек эксплойтов
Вторая стратегия имеет равный вес и работает по совершенно другому графику. Стратегическое сокращение — правильный шаг против архитектурных паттернов, которые создают множество находок одновременно. Оно не закрывает конкретную, подтвержденную цепочку эксплойтов, которая существует в одном сервисе на одном пути выполнения. Тактическое закрытие — это не запасной вариант для того, с чем не справляется стратегическое, а структурное дополнение.
Для многошаговых цепочек эксплойтов — подтвержденных сквозных эксплойтов, которые объединяют несколько шагов в работающую атаку против конкретного сервиса — единицей устранения является сама цепочка. Каждую цепочку необходимо обнаружить, проверить на эксплуатируемость, устранить на уровне сервиса и протестировать заново. Каждая цепочка представляет собой отдельную задачу по устранению со своими собственными временными рамками.
Срочность этой стратегии придает не количество цепочек. Ее придает противник, стоящий за каждой цепочкой.
Тактическая стратегия функционирует в ином темпе, чем стратегическая. Обе они должны сосуществовать в рамках одной программы, поскольку лежащие в их основе риски имеют разную природу.
Для наших наиболее критически важных целей мы проверяем цепочку на работающем промежуточном экземпляре (staging). Этот последний шаг — разница между «достижимо в теории» и «срабатывает на практике».
Это масштабнее, чем звучит. Статический конструктор цепочек имеет нетривиальный уровень ложных срабатываний. Путь, который кажется достижимым в графе вызовов, на этапе выполнения может оказаться защищен конфигурацией, флагами функций или промежуточным ПО (middleware), которые статический анализатор не заметил. Запуск эксплойта — это то, что отделяет ложные срабатывания от реальных цепочек: теоретические пути здесь терпят неудачу, и срабатывают только актуальные цепочки эксплойтов. Запускающийся эксплойт дает разработчикам нечто однозначное, и как только разработчик видит работающий эксплойт, дебаты прекращаются. Для высоконадежных находок, прошедших этот фильтр, коэффициент успешности (реально работающий эксплойт на реальной цели) оказался высоким.
Стоит упомянуть внешнее подтверждение: во время одного из недавних запусков наш конвейер обнаружил критическую находку, которая совпала с независимо поданной заявкой в рамках программы выплаты наград за найденные уязвимости (bug bounty) от внешнего исследователя. Та же цепочка, найденная двумя разными способами. Именно таким свидетельствам мы доверяем.
Ограничением этого подхода является стоимость настройки для каждой конкретной цели: чистое развертывание сервиса для тестирования требует значительного времени, и большая часть необходимого контекста находится у команды, которая им владеет. Это делает подход непрактичным для всей инфраструктуры в целом, поэтому мы ограничиваем его критически важными целями. Путь вперед является общим: когда сервисные команды поставляют рабочий контейнер или конфигурацию compose вместе со своим сервисом, валидация может быть автоматизирована, и обе команды тратят свое время на исправление.
Портфель: почему оба подхода важны и почему ни один из них по отдельности не работает
Эти подходы дополняют друг друга и одинаково важны.
Стратегическое сокращение эффективно устраняет архитектурный долг, но может упускать конкретные, подтвержденные цепочки эксплойтов, которые миграция библиотек не может устранить. Опора исключительно на этот подход оставляет активные цепочки эксплойтов в продакшене.
И наоборот, исключительно тактический подход не поддается масштабированию. Устранение каждой находки по отдельности истощает бюджеты и переполняет очереди разработки без достижения совокупных результатов.
Портфельный подход преуспевает за счет балансирования долгосрочной окупаемости инвестиций (ROI) от стратегической очистки и немедленного снижения угроз посредством тактического патчинга. Несоответствие этих рисков, когда только один из них рассматривается как полноценное решение, является распространенным сценарием сбоя.
Выводы для руководителей служб безопасности, выполняющих аналогичную работу
Если вы управляете или планируете управлять конвейером, который объединяет рассуждения на базе передовых моделей, автоматизированный статический анализ и выполнение проверенных эксплойтов в рабочей среде, проблема объема уязвимостей станет лимитирующим фактором задолго до того, как таковой станет проблема обнаружения.
Вот что мы можем порекомендовать на основе года работы с такой системой:
- Рассматривайте устранение уязвимостей как портфель из двух подходов. Стратегическая очистка повышает рентабельность инвестиций в разработку с каждым релизом; тактический патчинг закрывает действующие цепочки в условиях дефицита времени, диктуемого противником, и серьезная программа реализует оба направления.
- Соотносите единицу устранения с характером риска. Системный риск требует архитектурного исправления в темпе разработки, а многошаговая цепочка эксплойтов требует патча в темпе действий противника; несоответствие этих двух аспектов — самая частая причина пробуксовки подобных программ, с которой мы сталкивались.
- Рассматривайте системный риск как объект вывода первого порядка. Создайте объект кластера до того, как масштабировать объем, потому что баг-трекер, который принимает только индивидуальные находки, уже потерял свое преимущество.
- Находки без владельца никуда не ведут. Если у вас нет назначенных лидеров разработки, готовых принять отчеты о системных рисках как архитектурную задачу в рамках реального релизного плана, исправьте это, прежде чем масштабировать обнаружение дальше.
- Относитесь к тактическим цепочкам со срочностью, диктуемой действиями противника. Подтвержденные, эксплуатируемые цепочки — это не элементы бэклога; метрикой здесь является временной интервал между нашим обнаружением и действиями противника с поправкой на время, необходимое для выпуска патча.
- Инвестируйте в инфраструктуру тестирования. Методология накапливается; базовый движок анализа — это взаимозаменяемый компонент. Спроектируйте конвейер так, чтобы движки можно было менять без переделки, и оценивайте их в соответствии с вашими задачами с точки зрения затрат на участие оператора и надежности.