6 ноября 2026 г.
Ai2
Роботы учатся складывать белье, сортировать детали и работать с незнакомыми предметами. Но эти демонстрации часто носят довольно узкий характер и не объясняют, чему научился робот или почему он потерпел неудачу.
Чтобы изучить сложную систему, ученые часто начинают с небольшой контролируемой среды, такой как чашка Петри или террариум, где они могут изменять условия и наблюдать за результатами. Робототехнике нужны среды, которые делают возможным исследования такого рода — исследователи должны иметь возможность изменять обучающие данные или структуру модели, повторять тест и отслеживать причину сбоя.
Сегодня мы представляем фреймворк для создания таких сред; мы называем их FoundationWorlds. Каждая из них объединяет контролируемый симулированный мир, предназначенный для изучения робототехники в конкретной среде, с инструментами для автоматической генерации задач и обучающих демонстраций, а также метриками для измерения поведения робота с течением времени. Вместе они предоставляют условия для изучения таких вопросов, как улучшение моделей по мере поступления новых обучающих данных и наилучшее сочетание высокоуровневых рассуждений с точным физическим управлением.
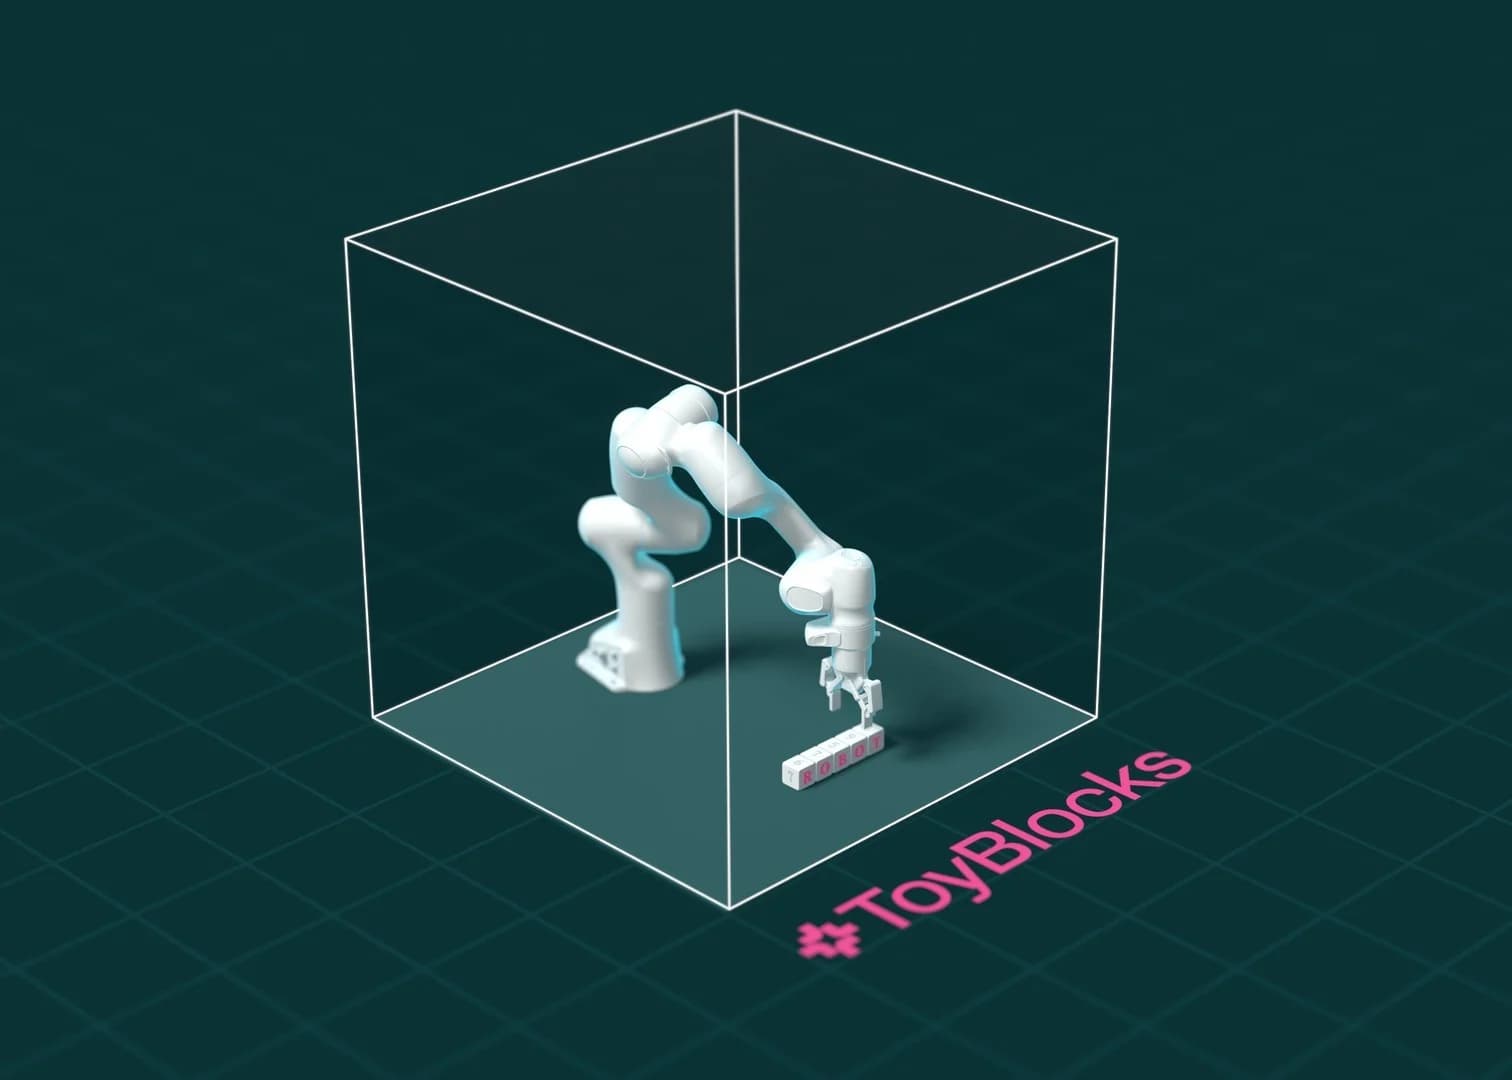
Наш первый базовый мир — это ToyBlocks: открытая среда симуляции, построенная вокруг робота-манипулятора и кубиков на столе. Обстановка намеренно проста, но робот все равно должен рассуждать о том, как кубики взаимодействуют друг с другом и как их расставлять, выполняя толкание, переворачивание и штабелирование.
ToyBlocks автоматически генерирует демонстрации, которые представляют собой записи выполнения задач роботом в симуляции, без необходимости трудоемкого дистанционного управления, при котором человек удаленно управляет роботом. Исследователи могут легко варьировать этот обучающий опыт. Например, команда может сгенерировать больше демонстраций толкания или переворачивания, а затем оценить производительность на задачах, исключенных из обучения.
Начав с ToyBlocks в качестве нашего первого FoundationWorld, мы стремимся распространить этот подход на все более сложные среды.
Как работает ToyBlocks
Опираясь на нашу предыдущую работу в области открытого обучения роботов, включая MolmoAct 2, MolmoBot и MolmoSpaces, ToyBlocks дает исследователям возможность изучать вопросы робототехники в намеренно ограниченной предметной области.
Будучи FoundationWorld, ToyBlocks разработан с учетом четырех требований: (1) реалистичная физика и внешний вид, (2) автоматическая генерация задач и демонстраций в больших масштабах, (3) задачи, сочетающие рассуждения с ловкостью, и (4) широкий охват задач, возможных в рамках предметной области.
Задачи с открытым концом требуют моделирования широкого спектра объектов и взаимодействий, что делает невозможным выполнение всех этих требований. Узкая специализация ToyBlocks, с другой стороны, позволяет выполнить их все.
В рамках меньшего пространства ToyBlocks исследователи могут работать над изучением того, как робот может научиться выполнять любую разумную задачу, будучи уверенными, что симулированный манипулятор и кубики ведут себя очень похоже на свои физические аналоги.
ToyBlocks — это не просто сбор и укладка кубиков: картинки и буквы на гранях кубиков позволяют выполнять задачи поиска, сортировки и упорядочивания. Роботу может потребоваться повернуть кубик, чтобы увидеть скрытую грань, прежде чем решать, куда он принадлежит. Доменная рандомизация — изменение размера кубиков, высоты стола и других физических свойств от сцены к сцене — проверяет, насколько хорошо модели обобщаются при изменении геометрии.
ToyBlocks использует обучение с подкреплением (RL) и планирование движения, которое вычисляет, как робот должен двигаться, для генерации навыков для задач с короткой перспективой, включающих краткие последовательности действий. Обучение навыкам происходит в Isaac Lab, платформе Nvidia с открытым исходным кодом для обучения роботов в симуляции. Путем проб и ошибок эти политики — модели, выбирающие действия робота — изучают не захватные навыки, такие как толкание кубика по столу или переворачивание его на другую грань без подъема. Генерация навыков может опираться на привилегированную информацию — значения, которые симулятор может предоставить напрямую, а реальный робот нет, такие как точное положение и ориентация кубика — вместо их оценки по изображениям с камер. Это позволяет автоматически генерировать навыки, которые в реальном мире потребовали бы дистанционного управления.
Для генерации данных демонстраций планировщик задач и движений (TAMP) автоматически выбирает и упорядочивает навыки, необходимые для решения задачи, и планирует движения робота между ними. Запуск каждого плана в симуляции создает набор данных записанных демонстраций вместе с метками, описывающими, какую задачу или навык выполняет робот. ToyBlocks масштабирует генерацию данных путем создания и выполнения сотен таких планов параллельно на одном графическом процессоре (GPU), достигая производительности, до 24 раз превышающей реальное время.
Действие на основе наблюдений датчиков добавляет проблему восприятия: модель должна оценить позу кубика — его положение и ориентацию, которые симулятор мог бы предоставить напрямую. Чтобы отразить реальные условия, ToyBlocks обучает модели, которые сопоставляют сырые наблюдения датчиков с действиями.
Выполнение Molmo 2 (высокоуровневая модель) и ManiFlow (низкоуровневая модель), обученных в ToyBlocks. Molmo 2 выбирает такие навыки, как вращение и переворачивание, указывая соответствующий кубик с помощью интерфейса указания, в то время как ManiFlow управляет симулированным манипулятором для выполнения заданных навыков.
Управляемый генератор данных ToyBlocks позволяет пользователям создавать обучающие смеси, которые подчеркивают определенные навыки или заполняют пробелы в существующих наборах данных. Исследователи могут изучить, сколько данных требуется модели и какой опыт помогает ей обобщать на неизведанные задачи. Например, они могут проверить, улучшает ли добавление демонстраций вращения и захвата-и-размещения операцию переворачивания, или варьировать баланс примеров внутри и за пределами определенной рабочей области — оценивая свой выбор на задачах, исключенных из обучения. Важно отметить, что оценка обученных моделей генерирует метрики, выходящие за рамки показателей успешности; она предоставляет такую информацию, как скорость выполнения, силы, действующие на объекты, и прогресс выполнения задач, измеряемый с использованием тех же спецификаций, которые используются модулем планирования.
Интерфейс веб-страницы позволяет пользователям подключать Claude — или другую передовую модель — и использовать естественный язык для инструктажа робота или выполнения задач, предлагая способ изучить, как модель планирует и действует, не требуя опыта в робототехнике.
Исследования на базе ToyBlocks
Приведенные ниже оценки используют ToyBlocks для изучения того, как обучающие данные и методы влияют на производительность, пространственное мышление, обобщение на новые буквы и внешний вид кубиков, многошаговое планирование, перенос на физических роботов и передовые модели, которые действуют через инструменты. Пользователи могут легко разрабатывать собственные задачи и меры для исследования других вопросов — например, работает ли модель лучше, когда она выбирает объекты путем указания или с помощью текстовых команд, таких как «выбери желтый кубик».
Низкоуровневые модели действий: пространственное обобщение VLA
Низкоуровневые модели действий, такие как модели «зрение-язык-действие» (VLA), сопоставляют языковые инструкции и визуальные наблюдения с действиями робота.
Предпосылка VLA заключается в том, что благодаря предварительному обучению на крупномасштабных наборах данных они могут быстро адаптироваться к различным сценариям или конкретному рабочему пространству. Однако данные о том, насколько хорошо эти модели действий обобщают свой опыт, остаются противоречивыми. В одних исследованиях сообщается, что эти модели действий чувствительны к изменениям входных данных, таким как различное расположение объектов и освещение, тогда как в других показано, что VLA обладают хорошей способностью к обобщению. Мы утверждаем, что такие исследования часто опираются на реальные наборы данных с ограниченной гибкостью пространственных вариаций. ToyBlocks позволяет нам протестировать, насколько хорошо модели действий обобщают опыт в простой, легко воспроизводимой среде с осмысленным разнообразием в пространстве задач.
Мы разрабатываем тесты на обобщение, которые варьируют последовательности навыков, необходимые для выполнения инструкций, буквы или цвета на блоках, а также количество блоков на сцене. Исследование процесса укладывания может исключить стопки из четырех блоков из обучающей выборки, а затем проверить, может ли модель комбинировать знакомые движения для их построения. Исследования рабочей зоны разграничивают производительность в новых позициях внутри зоны обучения и за ее пределами, где модель должна выполнять экстраполяцию. Ниже мы иллюстрируем настройку исследования и полученные результаты.
Мы рассматриваем четыре задачи: «Сложить» (Stack), «Разобрать» (Unstack), «Перевернуть» (Flip) и «Повернуть» (Rotate). Для этих задач мы изучаем интерполяцию (новые конфигурации в пределах диапазона обучения) и экстраполяцию (конфигурации за пределами этого диапазона). Например, мы оцениваем способность к обобщению, обучая модель на сценариях, где объекты появляются только в левой зоне (зеленой) и тестируя в правой зоне (оранжевой), либо обучая на высоте стопок в 2 и 5 блоков и тестируя на высоте 3 и 4 блока.
Высокоуровневые рассуждения: зрительно-языковые модели
Задачи с длинным горизонтом планирования, требующие множества шагов, позволяют нам измерить, насколько хорошо модели умеют планировать последовательность действий для их решения. Наш фреймворк позволяет создавать такие долгосрочные задачи, а также оракулы — эталонные компоненты, которые предоставляют правильные планы или действия как на высоком, так и на низком уровнях. Это позволяет нам определить, произошел ли сбой на этапе высокоуровневого планирования или низкоуровневого выполнения, когда модель не справляется с задачей. Примером задачи с длинным горизонтом может быть составление слова «Ai2» из стопки блоков; поскольку буквы могут быть не сразу видны, агент должен сначала выбрать действия, которые раскрывают информацию, а затем спланировать и выполнить последовательность действий для построения стопки.
Мы оцениваем иерархические модели с явным высокоуровневым планированием и низкоуровневыми моделями выполнения. В данном случае мы выбираем Molmo 2, зрительно-языковую модель (VLM), в качестве планировщика верхнего уровня, а ManiFlow — в качестве низкоуровневой политики. Molmo 2 выбирает навык для выполнения и блок, над которым его нужно применить, в то время как низкоуровневая модель выполняет инструкцию. Мы обучаем низкоуровневые модели, такие как ManiFlow, останавливаться после завершения выполнения и запрашивать у высокоуровневой модели следующую инструкцию. Мы оцениваем возможности планирования модели на трех сценариях возрастающей сложности. Самый простой сценарий инициализируется тем, что каждый символ стоит вертикально и обращен к камере. В среднем сценарии символы могут стоять не вертикально, а самый сложный сценарий содержит символы, которые не видны в начале эпизода.
Высокоуровневые рассуждения: агентные системы
Наши эксперименты с агентными системами проверяют, как передовые модели планируют и действуют посредством вызовов инструментов. Мы изучаем три сценария с использованием Claude Opus 5.5. В сценарии поиска и написания мы предоставляем доступ к навыкам ToyBlocks через Model Context Protocol (MCP) — стандарт для подключения приложений искусственного интеллекта к инструментам. Агент видит сцену через изображения с камеры, вызывает такие навыки, как захват, переворот или поворот, указывая на пиксель, и решает, когда искать, строить или объявлять задачу выполненной или невыполнимой. Одни и те же инструменты MCP могут выполнять либо запрограммированные навыки, генерирующие демонстрации ToyBlocks (захват и перемещение на основе планирования движения, а также поворот и переворот на основе обучения с подкреплением), либо изученные навыки ManiFlow. ToyBlocks включает в себя инфраструктуру, лежащую в основе этих экспериментов, которая также обеспечивает работу веб-интерфейса на естественном языке, описанного ранее.
Передовая модель (Claude Fable 5.1) управляет роботом в мире ToyBlocks, чтобы искать блоки и складывать их в башенку, образующую слово «Ai2». Во время эпизода агент размышляет: «Мне нужно выяснить, приводит ли операция захвата и перемещения к естественному выравниванию ориентации или мне нужно исправить ее вручную… У меня осталось 63 вызова, этого вполне хватит для проведения контролируемого теста» (0:06). Позже агент выдвигает гипотезу: «…возможно, рыскание захвата является радиальным — направленным от основания робота к блоку» (0:15) и в конечном итоге подтверждает эту гипотезу (0:26) перед построением трехблочной башни, однако буква «A» оказывается повернута боком (1:11). Удивительно, но современные передовые модели часто совершают подобные перцептивные ошибки (см. следующий рисунок), несмотря на их впечатляющие возможности планирования, пространственного мышления и поиска.
Для классического планирования агент (наша система на базе Claude Opus 5.5 для планирования и выбора действий) успешно решает все 30 задач из группы задач по укладыванию блоков, аналогичных тем, с которыми передовые модели испытывали трудности несколько лет назад, используя текстовые описания. Он также решает 30 задач из 30 при многократном наблюдении изображений с камеры и выборе следующего действия в замкнутом контуре.
В сценарии поиска и написания агент должен был составлять стопки, образующие трехбуквенные слова. Ему нужно было найти блоки с соответствующими буквами среди восьми блоков на сцене. Важно отметить, что 50% сцен не содержали блоков со всеми необходимыми буквами, что делало задачу невыполнимой. В этом случае мы требовали от агента заявить, что задача невыполнима. Мы обнаружили, что в этом эксперименте агент смог успешно решить или корректно признать невыполнимыми 63% задач. Ошибки в основном были связаны с тем, что агент путал буквы с похожими внешне буквами (13%) или выбирал неверную ориентацию для буквы в стопке (15%).
Наши результаты также показывают, что агент мог решать задачу более эффективно, когда блоки обладали семантическими закономерностями или паттернами, используя такие паттерны для рассуждений о скрытых гранях. Например, в большинстве невыполнимых сцен, когда блоки не имели паттернов, агент корректно осматривал грани всех блоков, прежде чем объявить о невыполнимости, в то время как при наличии у блоков семантических паттернов он смог объявить о невыполнимости значительно быстрее.
Наш третий экспериментальный сценарий исследует, может ли агент изучать поведение своих навыков, проводя эксперименты подобно ученому. Когда навык ведет себя неожиданным образом, агент выдвигает гипотезу, разрабатывает небольшой тест и корректирует свое понимание на основе полученного результата. Мы развиваем эту идею, позволяя агенту запускать собственные эксперименты и писать собственные описания навыков на основе того, что он обнаружил. Такие изученные описания повышают показатель успешности с 24% при использовании описаний по умолчанию до 63%, превосходя 36%, достигаемые с описаниями, написанными экспертом-человеком.
Условные модели мира как симуляторы
Динамические модели мира, обученные с учетом управляющих воздействий (action-conditioned world models), предсказывают, как сцена изменяется в ответ на действия робота. Их использование в качестве альтернативы симуляторам на основе моделей для обучения и оценки стратегий роботов представляет собой активно развиваемую область исследований. Насколько успешно они справляются с этой задачей, зависит от точности предсказания физических взаимодействий, которую трудно измерить без знания истинного состояния сцены. ToyBlocks предоставляет такую эталонную истину — актуальное состояние смоделированной сцены, — что позволяет проводить тщательно контролируемые тесты производительности недавно разработанных моделей мира в задачах манипулирования объектами на низком уровне. Здесь концевым эффектором руки является ее захват.
В частности, мы проверили, способны ли обусловленные действиями модели мира предсказывать движения блоков или результаты выполнения навыков после обучения на примерах их выполнения. Для этого мы выбрали четыре различных навыка (захват и перемещение, переворот, поворот и смешанная задача) и сгенерировали по 900 траекторий — последовательностей состояний и действий робота во времени — для каждого навыка. 50% этих траекторий представляли собой успешные демонстрации навыка, а 50% — неуспешные из-за небольших изменений пространственной конфигурации. При равном количестве успешных и неуспешных выполнений модель, которая всегда предсказывает успех, оказалась бы права только в половине случаев. Модели были дообучены на этих демонстрациях, после чего проверялась их способность предсказывать результат последовательностей действий для тех же навыков.
Мы протестировали три типа моделей: модель предсказания видео с 5 миллиардами параметров (Wan 2.2), an agentic model that created its own physics simulator tuned to match the demonstration data (Astra), и латентную модель мира (LeWM). Во время тестирования каждая обученная модель должна предсказывать будущие изображения, состояния симулятора или латентные состояния (выученные внутренние представления) соответственно на основе исходного изображения и последовательности действий. Для полных траекторий модели используют исходное изображение в качестве единственного наблюдаемого изображения вместе с последовательностью действий. Для коротких сегментов взаимодействия (одиночный захват, перемещение, переворот или поворот) модели начинают с реального изображения непосредственно перед этим взаимодействием. Полные траектории показывают, как ошибки накапливаются на больших горизонтах планирования, в то время как сегменты взаимодействия изолируют отдельное взаимодействие (например, контакт захвата с блоком) и демонстрируют, насколько хорошо модель его предсказывает. Чтобы справедливо сравнить модели, мы анализируем их предсказания, считывая, где, по их мнению, должны находиться блоки и захват в различных точках траектории и завершится ли задача успехом в конце.
Эксперименты в реальном мире с моделями высокого и низкого уровня
Оценки по методу sim-to-real проверяют стратегии, обученные в симуляции, на физических роботах, выполняющих задачи по манипулированию блоками. Сравнивая симуляцию и выполнение в реальном мире, мы оцениваем, дают ли наблюдаемые в симуляции поведения и паттерны сбоев значимые указания на производительность в реальных условиях. Например, исследователи могут оценивать отдельные навыки и их комбинации в задачах с более длинным горизонтом планирования, чтобы определить, где возникают сбои и переносятся ли эти паттерны на физические развертывания.
Мы проверяем, можно ли развернуть модели, обученные исключительно на наборах данных симуляции ToyBlocks, в реальном мире в режиме zero-shot, без предварительного обучения на реальных примерах. Мы оцениваем ManiFlow и каждый низкоуровневый навык (захват, перемещение, переворот и поворот) по отдельности. Мы тестируем, способна ли иерархическая система (Molmo 2 + ManiFlow) выполнять долгосрочные задачи по выкладыванию слов из трех блоков, требующие последовательностей таких действий. В экспериментах в реальном мире используется рука Franka FR3 с захватом Robotiq в тридцати конфигурациях сцены. Каждая сцена содержит от 4 до 10 блоков, виденных во время обучения. Эпизод считается успешным только в том случае, если соответствующие блоки перемещены в целевые позы без столкновений. Если оператор вмешивается, чтобы остановить робота из-за небезопасного движения во время эпизода, он отмечается как неуспешный.
Успешность базовых навыков модели ManiFlow оказалась схожей в симуляции и реальном мире (80,0% и 81,1%). Иерархическая система Molmo 2 + ManiFlow успешно справилась с 55,5% смоделированных эпизодов (111/200) и 50,0% эпизодов в реальном мире (15/30); необходимы дальнейшие испытания для установления статистической достоверности для различных задач.
Параллельное выполнение укладки блоков в реальном мире и в симуляции с использованием одного и того же планировщика высокого уровня. Розовые кольца отмечают целевую точку планировщика для каждого навыка. В сценах используются разные метки блоков, а воспроизведение симуляции пересинхронизировано так, чтобы захваты и отпускания совпадали с действиями реального робота.
Для переноса Molmo 2 и ManiFlow (обе обучены исключительно на данных ToyBlocks) на физического робота мы устраняем различия между симуляцией и реальностью в три этапа.
Перед генерацией данных мы выполняем идентификацию системы путем настройки параметров смоделированного робота, включая трение в суставах и инерцию приведенных масс (момент инерции мотора и редуктора, приведенный к суставу), чтобы они соответствовали траекториям реального робота. Во время генерации данных мы рандомизируем физические свойства (размер объекта, трение и высоту стола) и визуальные свойства (освещение, фон, материалы и параметры камеры). На этапе инференса наблюдения фиксируются с помощью фронтальной камеры ZED и камеры ZED Mini на запястье. Для стратегий, использующих карты глубины, мы генерируем чистые карты глубины, оценивающие расстояние в каждом пикселе, из парных изображений с RGB-камер с помощью FastFoundationStereo, вместо того чтобы полагаться на зашумленные измерения датчиков глубины.
Открытие инструментов для дальнейших исследований
ToyBlocks объединяет генерацию данных, обучение и оценку в единой контролируемой среде, позволяя исследователям изучать, как роботы обучаются с течением времени, и проверять, как изменения в модели или ее обучающих данных влияют на поведение робота. Мы выпускаем симуляционные ресурсы, генераторы процедурных задач и демонстраций, автоматически сгенерированные демонстрации, две обученные модели, демонстрирующие возможности фреймворка (одна на базе Molmo 2, а другая на базе ManiFlow), код для обучения, а также код для оценки и проверочные наборы. Это позволяет другим командам создавать собственные смеси данных для обучения и исследовать типы сбоев, выходящие за рамки тех, что рассматривались в наших первоначальных экспериментах.
Наш первый релиз данных представляет собой подтверждение концепции, включающее 85 336 долгосрочных демонстраций, каждая из которых состоит примерно из 6–12 демонстраций навыков в зависимости от набора. Первоначальные наборы данных охватывают почти 1600 часов данных выполнения роботом и 144 миллиона кадров. Через несколько недель мы планируем второй релиз с набором данных большего масштаба, большим количеством навыков и более комплексным бенчмаркингом. Мы также добавим полностью интегрированную возможность обучения с подкреплением (RL), которая не входит в текущий пакет.
Другие направления развития ToyBlocks включают бимануальное (двуручное) манипулирование и осязательные руки роботов, оснащенные датчиками силы и касания для изучения движений и задач, связанных с частым физическим контактом. Мы также исследуем взаимодействие с неструктурированными кучами блоков как способ сбора данных и изучения того, как новые поведения и задачи могут возникать в процессе взаимодействия.
Будущее направление: манипулирование кучей блоков на основе RL.
Будущее направление: бимануальное манипулирование блоками.
С помощью ToyBlocks мы хотим продвинуть науку об обучении роботов к будущему, в котором роботы смогут надежно применять полученные знания в незнакомых задачах и средах. Мы призываем исследовательское сообщество изучить ToyBlocks для собственных исследований и даже в качестве основы для создания собственных FoundationWorlds.
Присоединяйтесь к нам
В Ai2 мы строим будущее прозрачного искусственного интеллекта с открытым исходным кодом, создаваемого открыто для расширения возможностей научного прогресса и фундаментального понимания этой меняющей мир технологии. Мы здесь не ради прибыли, мы здесь для того, чтобы преимущества ИИ широко разделялись на благо человечества. Если вам это близко, пожалуйста, ознакомьтесь с нашими открытыми вакансиями.
Открытые вакансии