Улучшайте свои инструменты с помощью функций на базе ИИ во многих продуктах JetBrains
Агентный ИИ
Часть 2: Хранение, поиск и инструментарий агентов
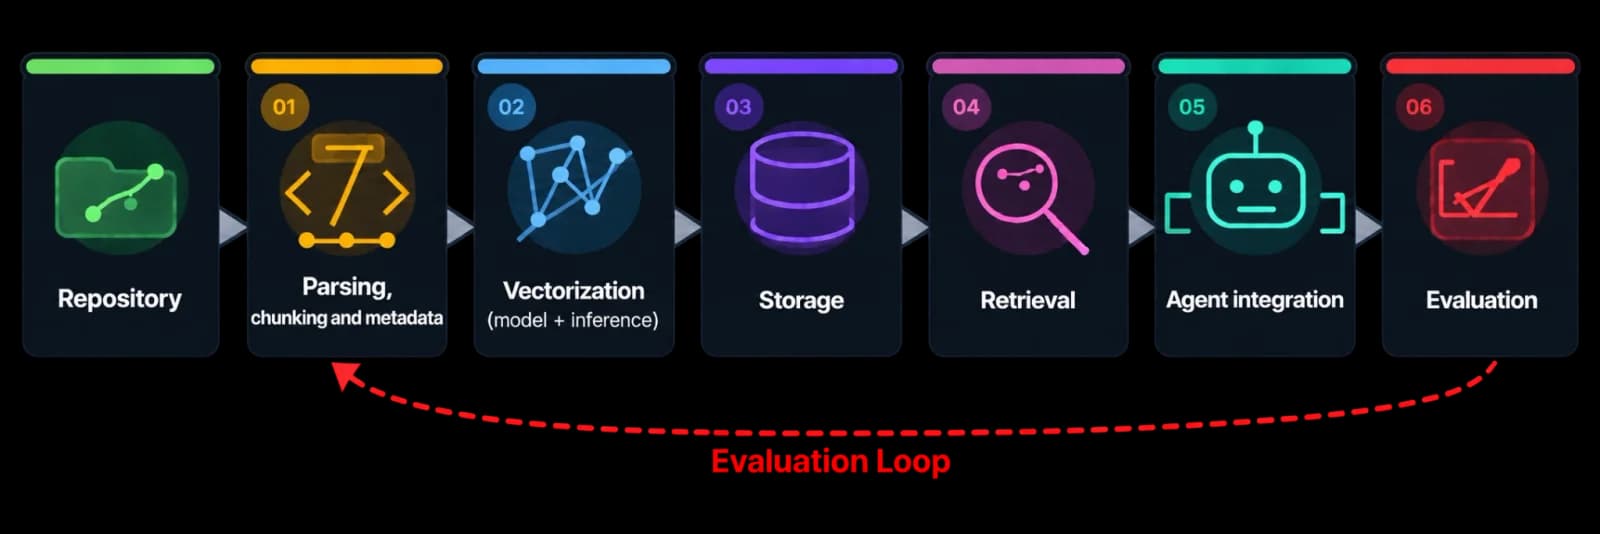
В этой серии блогов мы делимся уроками, извлеченными за последние шесть месяцев при создании и внедрении Air Context — промышленной RAG-системы для поиска по коду. В первой части мы рассмотрели разбиение на фрагменты, парсинг и векторизацию. Однако преобразование кода в векторы — это лишь часть пути.
В этой статье мы разберем следующие проблемы, которые необходимо решить для любой серьезной промышленной RAG-системы: как хранить миллионы векторов, чтобы индекс успевал за Git, и как находить нужные векторы за миллисекунды.
Хранение
После того как код проанализирован, разбит на фрагменты и преобразован в векторы, возникает вопрос: где их хранить? Реальная кодовая база может генерировать миллионы векторов. Ситуацию осложняет то, что кодовые базы не статичны. Они часто меняются, существуют в десятках веток одновременно, а агент ожидает ответа за миллисекунды, с фильтрацией по нужному репозиторию, нужному пути и только тем файлам, которые разрешено видеть пользователю. Все это требует специального уровня хранения, который эффективно выполняет операции поиска с учетом заданных ограничений.
В центре этого уровня хранения находится векторный индекс. Векторный поиск требует нахождения векторов, наиболее близких к вектору запроса. Сравнение запроса с миллионом векторов по очереди происходит слишком медленно, поэтому на практике мы используем структуры приближенного поиска ближайших соседей (ANN), такие как HNSW или IVF. Они пропускают большинство сравнений и возвращают результаты, очень близкие к оптимальным, но не гарантируют идеального совпадения. Эта скорость требует компромиссов: сколько действительно релевантных результатов будет возвращено (так называемая полнота или recall), сколько памяти нужно индексу, насколько хорошо он справляется с постоянным потоком вставок и удалений и может ли он вообще учитывать фильтры.
Кроме того, любая здоровая кодовая база должна поддерживать множественные инкрементальные обновления индекса по мере фиксации коммитов. Чтобы обеспечить это в масштабе, архитектура должна избегать хранения отдельной копии каждого фрагмента для каждой ветки, использующей один и тот же код, а также поддерживать согласованность векторов и метаданных, описывающих их. Ни одна из этих возможностей не обеспечивается моделями эмбеддингов. Без надежных решений для хранения наши с таким трудом извлеченные векторы просто не будут пригодны для использования.
Роль аппроксимации
Алгоритмы приближенного поиска жертвуют некоторой долей полноты, но эффективно работают с большими наборами данных.
Мы обнаружили, что гибридный подход, при котором мы также используем точный поиск по более ограниченному векторному пространству после начального ANN-поиска, работает удивительно хорошо.
Другими словами, использование дешевого первого прохода сужает весь корпус до небольшого набора вероятных кандидатов. После этого выполнение точного сравнения становится доступным. Приближенный индекс справляется с масштабом, а точный проход обеспечивает финальную точность. Это дает нам еще один рычаг для тонкой настройки поиска, поскольку мы думаем не только о том, какие алгоритмы использовать, но и о том, как использовать их в тандеме.
Фильтрованный ANN: нюансы
Векторный поиск для семантического сходства не учитывает жесткие ограничения поиска, такие как ограничение результатов репозиторием, веткой или конкретной подпапкой. Кроме того, должны строго соблюдаться требования безопасности и прав доступа, например, ограничения на типы данных, которые могут быть запрошены. Этот тип фильтрации метаданных требует детерминированного механизма, который будет иметь приоритет над любым алгоритмом поиска.
Сочетание фильтра с ANN-индексом — задача действительно сложная, так как эти два механизма конфликтуют друг с другом. Граф HNSW строится в предположении, что можно свободно перемещаться между соседями; как только вы ограничиваете обход узлами, удовлетворяющими предикату, граф может стать несвязным, и поиск может пропустить валидных кандидатов. Существует три основных стратегии решения этой проблемы:
1. Предварительная фильтрация (Pre-filtering). Это означает применение предиката метаданных в первую очередь, а затем поиск только по оставшемуся набору. Это обеспечивает 100% полноту относительно фильтра. Однако при этом теряется преимущество ANN-индекса для отфильтрованного подмножества, и система фактически переходит к точному поиску. Эта стратегия лучше всего подходит для узкоспецифичных фильтров, таких как один небольшой репозиторий или узкая подпапка. Однако она становится затратной, когда фильтр оставляет слишком большую совокупность для поиска.
2. Метаданные, объединенные с векторным индексом. Самый мощный подход общего назначения — это хранилище, в котором фильтрация является первоклассным гражданином самого индекса. Другими словами, такие параметры, как права доступа к папкам или репозитории, доступны для поиска и влияют на векторное расстояние. Qdrant и turbopuffer построены именно так. Вы сохраняете большую часть скорости ANN *и* соблюдаете фильтр, не прибегая к полному перебору. Для RAG промышленной кодовой базы с реальными требованиями ACL это будет сбалансированный выбор.
3. Пост-фильтрация (Post-filtering). Сначала выполняется ANN-поиск, затем отбрасываются результаты, не прошедшие проверку предикатом. Проблема, конечно, в том, что поскольку топ-K кандидатов выбирались без учета этого фильтра, большинство или все они могут оказаться невалидными, что приведет к короткому списку низкого качества. Режим итеративного сканирования в pgvector смягчает это, извлекая все больше кандидатов, пока их не станет достаточно после фильтрации, но это влечет за собой затраты на задержку и может быть непредсказуемым. Пост-фильтрация считается самой слабой из трех стратегий.
Следование за инкрементальными изменениями кода
При работе с большими репозиториями кода RAG-система не может позволить себе переиндексировать всю кодовую базу при каждом изменении. Таким образом, для достижения приемлемой производительности индексации и соблюдения лимитов хранения данных индексация должна выполняться инкрементально.
В идеале мы хотим, чтобы каждый снимок репозитория детерминированно кластеризовался в дерево Меркла, отражающее структуру его каталогов. Новые ревизии сравниваются с предыдущими сверху вниз, и целые неизмененные поддеревья связываются с новым снимком как есть, без какой-либо переиндексации. Эмбеддинги дополнительно дедуплицируются по хешу содержимого фрагмента, поэтому внутри самих измененных кластеров мы индексируем только измененный код.
Благодаря инкрементальности обновления и удаления индекса выполняются шаг за шагом в небольших транзакциях с ограниченным параллелизмом, а тяжелые задачи по обслуживанию, такие как построение векторных индексов, переносятся на фоновые процессы, предотвращая узкие места процессора базы данных.
Тем не менее, вся эта обработка и бизнес-логика требуют времени и вычислительных ресурсов. Построение векторных индексов HNSW является одним из основных «узких мест» по нагрузке на ЦП в нашем конвейере обработки данных базы. Чтобы предотвратить перегрузку системы, мы разделяем процесс загрузки векторов и построения индекса. Сначала записываются векторы, а индекс HNSW строится только после того, как снимок репозитория полностью сохранен в базе данных. Затем построение выполняется асинхронно при строго контролируемом параллелизме. Для эффективного использования ЦП мы применяем неблокирующее параллельное создание индексов, что позволяет выполнять не более одного построения индекса за раз для каждого шарда. Это обеспечивает стабильность экземпляров базы данных, поскольку снимок становится доступным для поиска только после того, как его индекс готов.
Чтобы справиться с ограничениями ЦП, памяти и емкости метаданных одного экземпляра базы данных, наша архитектура масштабируется горизонтально по нескольким шардам, каждый из которых поддерживается собственным основным экземпляром и репликами только для чтения. Поисковые запросы обслуживаются репликами только для чтения, развернутыми в географически распределенных регионах, что гарантирует низкую задержку. Кроме того, для обеспечения изоляции данных каждый клиент привязан ровно к одному шарду, а простой уровень маршрутизации на стороне приложения направляет каждую транзакцию к нужному шарду на основе идентификатора клиента.
Использование локальных индексов для локальных изменений
В типичном жизненном цикле разработки ПО (SDLC) код сначала пишется на локальном ноутбуке или настольном компьютере, а затем отправляется в удаленную ветку и объединяется с остальной кодовой базой. На этих начальных этапах разработки код очень важен для конкретного разработчика, но менее значим для других разработчиков, работающих в своих собственных ветках. Создание локального индекса на машине разработчика для поддержки этапа разработки до отправки кода (pre-push) может помочь снизить нагрузку и требования к диску центрального поискового индекса, а также обеспечить релевантность результатов поиска.
Индексы Air Context могут полностью размещаться на устройстве для поддержки этого сценария использования. Для локального хранения векторов и поиска мы внедрили USearch, компактный высокопроизводительный движок, созданный для векторов. Векторы и метаданные разделены: снимки, кластеры и фрагменты хранятся в выделенном хранилище метаданных вместе с векторным индексом. Поскольку эти метаданные используют ту же модель, что и сервер, весь инкрементальный конвейер продолжает работать локально. Неизмененные кластеры повторно связываются между ревизиями, а идентичные фрагменты используют один и тот же сохраненный вектор.
Использование единой модели метаданных между сервером и локальным хранилищем позволяет нам поддерживать каскадное индексирование, которое обеспечивает переход кода от локального к общему. Поиск становится двухэтапным процессом. Сначала он выполняется по удаленному индексу, а затем по локальному, с использованием переранжировщика (reranker), который объединяет лучшие кандидаты из обоих источников в единый список результатов.
Таким образом, мы поддерживаем гибкий локальный индекс, который всегда синхронизирован с локальным деревом файлов, и в то же время оптимизируем хранение и логический вывод за счет использования общих удаленных индексов для удаленных веток. Кроме того, мы экономим ценное время за счет прозрачного переноса индекса с локального на удаленный по мере его отправки в центральный исходный код.
Оптимизация после извлечения
Постобработка: превращение кандидатов в ответ
Описанный выше поиск ближайших соседей не дает окончательного результата. Он выдает список кандидатов: фрагменты, векторы которых находятся ближе всего к запросу. Хотя это отличное начало, содержащее много полезных данных, это не конечный продукт, который должен быть доставлен агенту или пользователю. Результаты ANN могут содержать почти дубликаты, несколько фрагментов одной и той же функции или фрагменты, которые получили высокий балл по неверной причине, например, потому что они имеют несколько редких слов, общих с запросом.
Постобработка включает в себя все действия, необходимые для преобразования необработанного списка кандидатов в текст, который читает агент. В нашем конвейере это включает удаление дубликатов, группировку фрагментов, принадлежащих одному файлу, определение того, сколько результатов стоит показать, и, самое главное, переранжирование. Каждый из этих шагов обходится дешево по сравнению с самим поиском, поскольку каждый из них выполняется для нескольких десятков кандидатов, а не для всей кодовой базы.
Переранжирование
Переранжирование лучше всего описать как второй, более тщательный взгляд на кандидатов перед их передачей. Наш первый проход должен быть быстрым, так как он сравнивает каждый фрагмент с запросом через два вектора, вычисленных независимо. Переранжировщик может позволить себе быть медленнее. Его роль — посмотреть на запрос и кандидата рядом и оценить, насколько они действительно соответствуют друг другу. Хотя мы не можем использовать LLM для оценки релевантности результатов по огромному индексу, это становится допустимым вариантом при работе с более ограниченным набором результатов. В конечном счете, переранжирование дает нам упорядоченный список, в котором лучшие совпадения переместились в начало.
В дополнение к этому подходу, использующему поиск соседей с последующим переранжированием, мы экспериментировали с несколькими другими конфигурациями поиска. Некоторые из них обеспечили заметное улучшение качества поиска, но ценой значительно более высокого использования ресурсов и более медленного поиска. Одним из примеров является JointRank, метод, представленный на конференции ICTIR ’25, который предлагает языковой модели ранжировать множество кандидатов за один проход, разбивая их на перекрывающиеся группы, ранжируя каждую группу параллельно и объединяя частичные упорядочивания в одно.
Агентный поиск
Дальнейшие попытки улучшить качество поиска привели нас к изучению использования инструмента агентного поиска. Вместо однократного извлечения мы можем использовать специального агента для извлечения кода. Этот агент может организовывать вызовы нескольких инструментов поиска и чтения, включая извлечение на основе эмбеддингов. Он может принимать решения о том, какие инструменты вызывать, и использовать разные пороговые значения в зависимости от самого запроса. Агент самостоятельно решает, когда искать, когда открывать файл и когда он увидел достаточно. Мы ограничиваем количество шагов, которые он может предпринять, чтобы исследование никогда не выходило за рамки бюджета.
Этот агент извлечения может быть реализован как субагент — распространенный в последние годы шаблон для вспомогательных агентов, которые сохраняют изолированный контекст. Когда субагент выполняет чтение, возвращается только его вывод, поэтому контекст основного агента остается небольшим и сфокусированным. Claude Code, например, позволяет пользователям определять пользовательских субагентов, которых основной агент может вызывать как любой другой инструмент.
Субагент также может работать на более дешевой или быстрой модели, чем та, которая пишет код, и может быть ограничен инструментами только для чтения, чтобы предотвратить случайное внесение изменений. Кроме того, несколько таких агентов могут работать одновременно над независимыми вопросами. Для нашего инструмента поиска это означает, что основной агент тратит меньше токенов и времени на поиск кода и больше — на поставленную перед ним задачу.
Форматирование результатов и предварительная загрузка фрагментов
Последний аспект этапа постобработки, который нам необходимо рассмотреть, — это формат, используемый для передачи результатов агенту. Наша цель — сэкономить время агента, избавив его от выполнения дополнительных вызовов, и при этом гарантировать, что у него достаточно данных для оценки релевантности результатов поставленной задаче. Однако это нужно делать разумно: чем больше данных мы заранее включаем в ответ, тем сильнее раздуваем контекст агента и, возможно, засоряем его. Мы приняли стратегию, при которой уровень детализации соответствует оценке релевантности каждого результата.
Результаты для кандидатов, чьи показатели релевантности превышают заранее заданный порог, содержат больше информации, включая сам фрагмент кода, номера строк и дополнительные метаданные. Для кандидатов с более низкой предполагаемой релевантностью мы предоставляем только базовую информацию, такую как имя файла и, возможно, очень короткий фрагмент кода. Это позволяет агенту сосредоточиться на наиболее вероятных совпадениях, при этом указывая, где еще можно поискать.
От теории к практике
В этой статье мы обсудили вторую часть конвейера, охватив хранение, поиск и извлечение данных. Что касается хранения, основную работу выполняет аппроксимированный индекс с последующей точной проверкой небольшого набора кандидатов. Фильтры по репозиторию, ветке и правам доступа находятся внутри индекса, а не вокруг него. Представление каждого снимка состояния в виде дерева Меркла позволяет индексу синхронизироваться с Git, повторно используя все, что не изменилось, а локальный индекс на машине разработчика берет на себя работу до того, как код будет отправлен в репозиторий.
Что касается извлечения, ранжировщик повторно и более внимательно изучает кандидатов, чтобы оценить их релевантность. Специализированный субагент способен на более глубокое исследование, когда однократного поиска недостаточно. Наконец, формат результатов позволяет предоставлять агенту детали пропорционально нашей уверенности в каждом совпадении, благодаря чему контекст агента остается небольшим и сфокусированным.
Остается один критически важный вопрос, который мы еще не затронули: помогает ли все это агенту на самом деле? Несмотря на все оптимизации, алгоритмы и внимание к масштабируемости, оказывает ли этот RAG-аппарат измеримое влияние на производительность агента? В конце концов, агенты, особенно при использовании передовых моделей, становятся все более искусными в навигации по большим кодовым базам. С учетом этого, какова добавочная стоимость инструментов семантического поиска?
Это важные вопросы, которые занимали нас с самого начала нашего пути. В следующей статье мы покажем, как мы подключаем Air Context к агентам, что потребовалось для превращения этого в продукт и как мы проводим оценку — от бенчмарков извлечения до сквозных запусков агентов. Спойлер: в этих запусках агентам с Air Context требовалось до 70% меньше итераций для решения задачи.
Как всегда, задавайте вопросы в комментариях или делитесь собственным опытом. Если вы хотите попробовать это на своем коде, Air Context доступен в публичной предварительной версии и уже включен в вашу подписку JetBrains AI.
До скорой встречи!