По мере взрывного роста объема данных, обрабатываемых ИИ, узкие места в передаче данных стали новой проблемой. Может ли технология памяти следующего поколения предложить решение? Теперь появилась возможность услышать ответ SK hynix на этот вопрос.
Компания SK hynix приняла участие в OCP Global Summit 2026, проходившем с 12 по 15 число в Сан-Хосе, штат Калифорния, где представила широкий спектр решений в области памяти следующего поколения и обозначила направление развития технологий памяти в эпоху ИИ.
OCP Global Summit — это технологическая конференция, посвященная обмену опытом и стандартизации дизайна и спецификаций оборудования для центров обработки данных. В этом году, когда инфраструктурные технологии, которые станут основой развития ИИ, вышли на первый план, новая серверная система, предложенная SK hynix, привлекла значительное внимание. SK hynix продемонстрировала решения следующего поколения, которые она готовит для серверов на уровне реальных систем, доказав их практическую реализуемость и в очередной раз подтвердив свое технологическое лидерство.
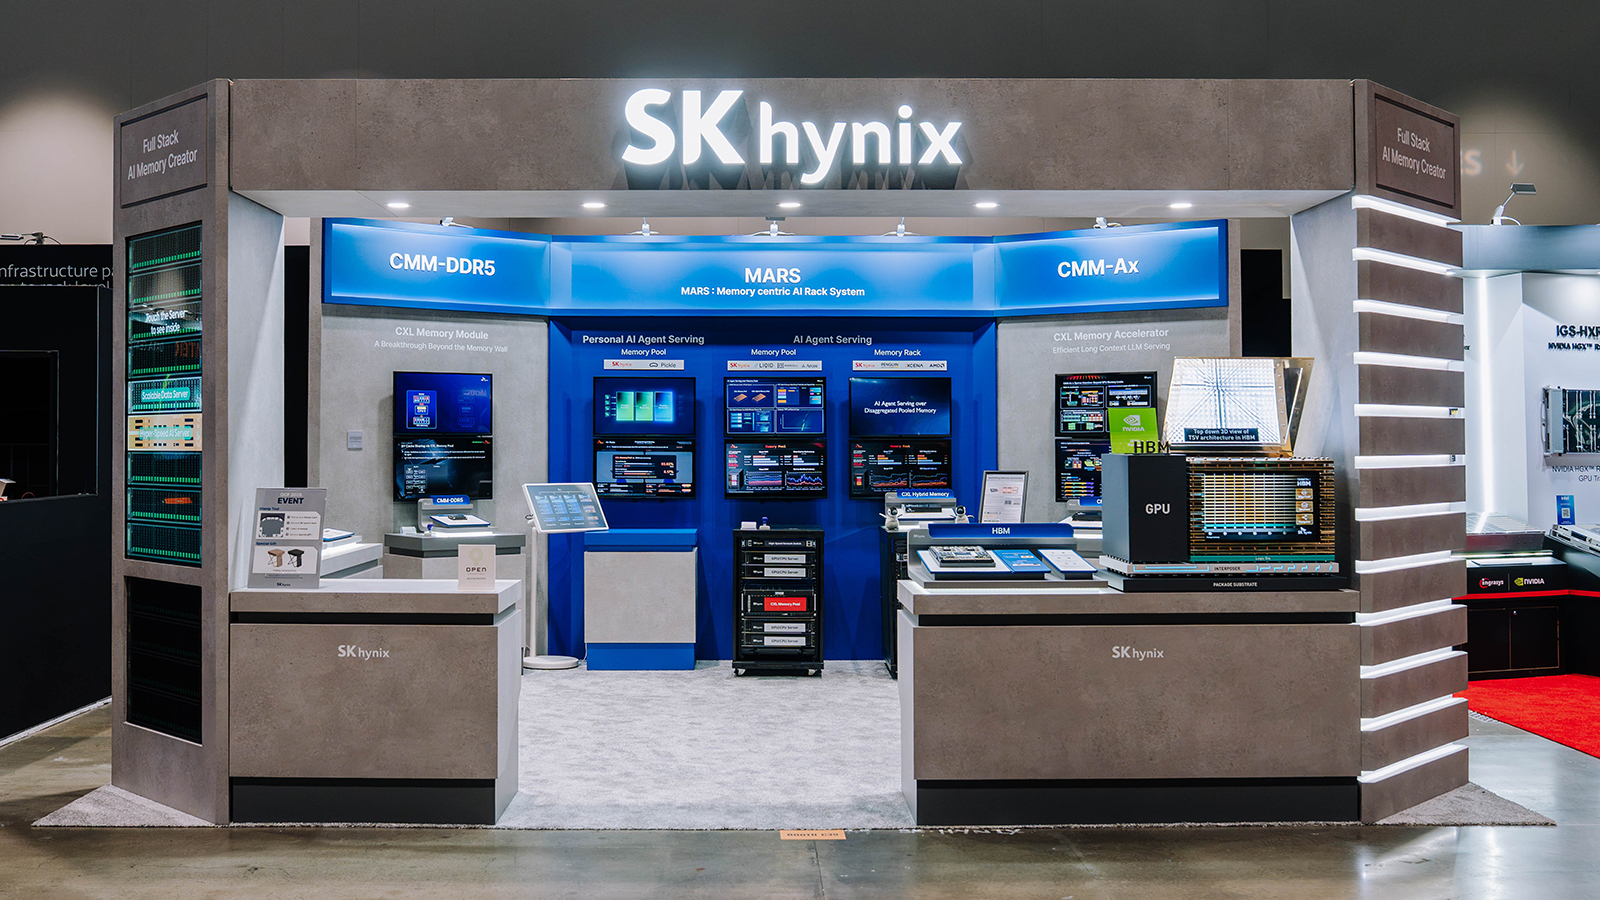
▲ Выставочный стенд SK hynix
Благодаря концепции стенда, сочетающей прочную серую раму с неоново-голубым освещением, SK hynix визуализировала «надежность» и «эффективность» — ключевые ценности своих решений в области памяти следующего поколения. Выставочное пространство было разделено на переднюю и заднюю секции. В передней части внимание посетителей привлекала «Секция памяти» (Memory Section), где были представлены текущие флагманские продукты компании, а просторная секция «Демонстрация системы» (System Demo) в задней части позволила посетителям более детально ознакомиться с решениями SK hynix в области памяти, которые составят экосистему серверов следующего поколения.
▲ Посетители осматривают секцию «Демонстрация системы»
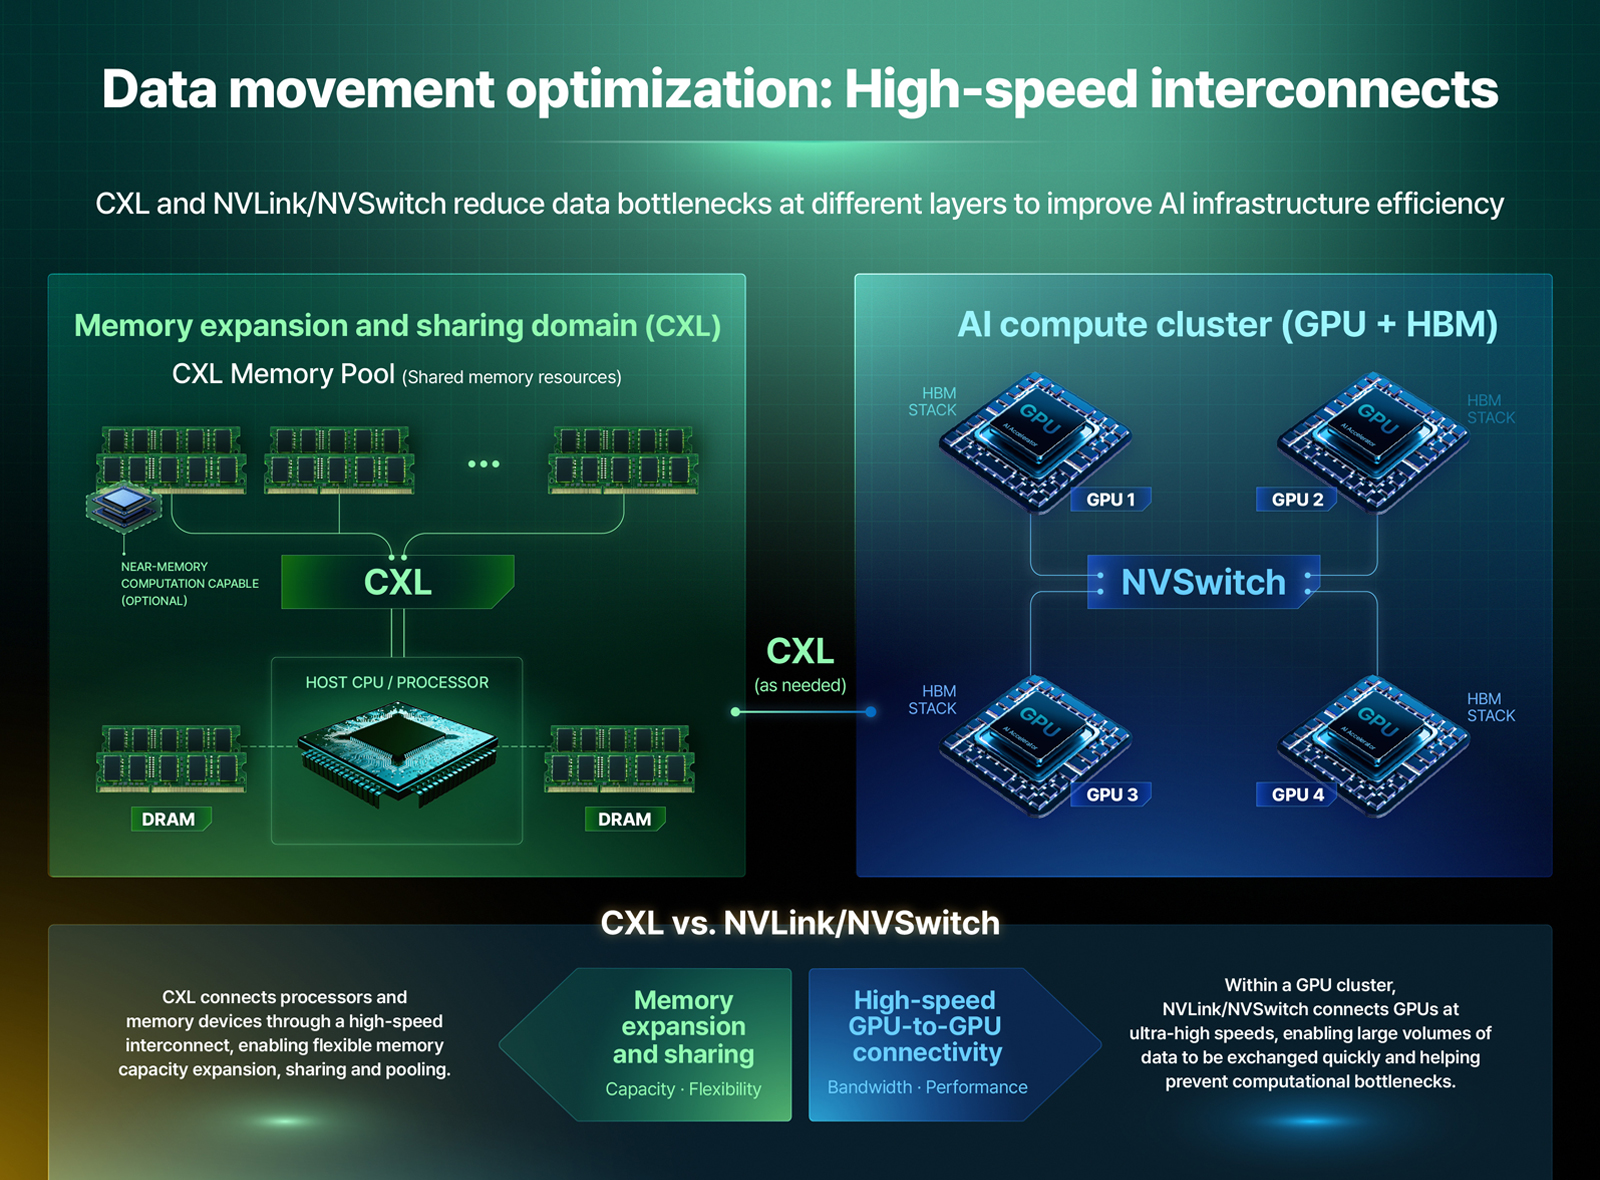
В секции «Демонстрация системы» были последовательно представлены три решения, слева направо: CMM-DDR5, MARS и CMM-Ax. CMM (CXL* Memory Module)-DDR5 — это решение для памяти, которое повышает эффективность использования ресурсов за счет того, что несколько серверов совместно используют пул памяти и задействуют столько, сколько им необходимо, на основе стандарта интерфейса CXL. На этой выставке SK hynix представила свой продукт второго поколения (256 ГБ), оптимизированный для рабочих нагрузок ИИ и основанный на CXL 3.2. По сравнению с предыдущим поколением, продукт более чем вдвое увеличивает пропускную способность (80 ГБ/с) и повышает энергоэффективность примерно на 30%. Благодаря применению функции CXL Pooled, он привлекает внимание как продукт памяти следующего поколения, который эффективно устранит узкие места в средах с интенсивным использованием данных и высокими нагрузками.
* CXL (Compute eXpress Link): решение следующего поколения, которое эффективно соединяет процессоры, графические процессоры, память и другие компоненты внутри вычислительной системы для поддержки крупномасштабных и сверхвысокоскоростных вычислений. Основанное на интерфейсе PCIe, оно обеспечивает быструю передачу данных и предоставляет функцию объединения ресурсов (пулинг), которая эффективно использует память.
▲ Посетители изучают продукт CMM-DDR5
В сентябре прошлого года SK hynix подписала деловое соглашение с NAVER Cloud и с тех пор совместно работает над устранением узких мест в облачных ИИ-сервисах с использованием решений на базе CXL. На этой демонстрации компания представила результаты проверки — на уровне PoC* — того, как решение для совместного использования KV-кэша* в среде агентного ИИ* и решение для совместного использования эмбеддингов в «OmniServe», омнимадальном* сервисе, работают на практике. Проанализировав реальные клиентские системы и рабочие нагрузки для подтверждения применимости своих решений на базе CXL, SK hynix заложила основу для полномасштабного расширения этих решений.
* Агентный ИИ (Agentic AI): ИИ, который самостоятельно ставит цели и выполняет многоэтапные задачи без инструкций пользователя. * KV-кэш (Key Value Cache): временная память, в которой хранятся ранее вычисленные результаты, когда ИИ-агент на базе большой языковой модели генерирует текст. Он растет в геометрической прогрессии по мере того, как разговор становится длиннее, а задач для обработки — больше, поэтому способность эффективно хранить и обрабатывать его оказывает огромное влияние на производительность ИИ-агента. * Омнимадальный (Omni-Modal): подход, который обрабатывает несколько форм данных — таких как текст, изображения и голос — вместе в рамках одной модели. * PoC (Proof of Concept): этап, на котором проверяется, действительно ли работает новая технология или концепция.
▲ Посетители изучают информацию о MARS
MARS (Memory Centric AI Rack System) — это система следующего поколения, которая максимизирует эффективность за счет интеграции решений партнеров в одну стойку*, в центре которой находится память. На этой выставке SK hynix представила три демонстрации совместно с несколькими партнерами.
* Стойка (Rack): рама стандартного размера, используемая в центрах обработки данных для размещения серверов, систем хранения, сетевого оборудования и других устройств слоями. Поскольку оборудование управляется в юнитах стойки, стойка служит базовым строительным блоком инфраструктуры центра обработки данных.
▲ Демонстрация технологии обслуживания ИИ-агентов с использованием пула памяти CXL
В демонстрации обслуживания ИИ-агентов SK hynix — совместно с Arcee, Liqid и Marvell — показала систему, которая соединяет несколько серверов и графических процессоров с использованием пула памяти*. Благодаря этому компания доказала, что передача или повторное использование KV-кэша на основе пула памяти CXL значительно повышает производительность системы по сравнению с традиционными методами, основанными на сетевом взаимодействии.
* Пул памяти (Pooled Memory): технология, которая группирует несколько модулей памяти CXL в пул и повышает общую эффективность использования памяти, позволяя нескольким хостам эффективно распределять ее емкость.
▲ Демонстрация технологии обслуживания ИИ-агентов с использованием гибридной памяти CXL
В демонстрации, проведенной совместно с AMD, Penguin, Xcena и Arcee, SK hynix показала эффективность стойки памяти с использованием памяти CXL и гибридной памяти CXL*. Результаты подтвердили, что стойка памяти может эффективно хранить и быстро повторно использовать крупномасштабные KV-кэши, которые генерируются непрерывно. В частности, демонстрация четко показала две возможности: быстрое прогнозирование того, какие KV-кэши потребуются на основе предыдущего разговора и истории задач, и предварительная загрузка необходимых KV-кэшей в DRAM для быстрой обработки. Также было доказано, что за счет хранения полного KV-кэша на SSD стойка может одновременно обеспечивать как высокую скорость чтения, так и хранение большого объема данных.
* Гибридная память CXL (CXL Hybrid Memory): гибридное решение на базе CXL, объединяющее DRAM и SSD.
▲ Демонстрация технологии, снижающей задержку отклика сервиса с использованием пула памяти
Совместно с Pickle, поставщиком персональных ИИ-агентов, SK hynix провела демонстрацию, снижающую задержку отклика сервиса с использованием пула памяти. Демонстрация подтвердила, что потоковая передача на основе пула памяти может ускорить передачу данных между несколькими моделями ИИ, необходимыми для персонального ИИ-агента, чтобы конечные результаты быстрее доходили до пользователей.
▲ Демонстрация технологии эффективного обслуживания LLM с длинным контекстом
CMM-Ax — это решение для памяти нового поколения, объединяющее вычислительные функции с памятью. Выполняя вычисления непосредственно внутри памяти, без перемещения данных, оно позволяет снизить нагрузку на центры обработки данных в плане энергопотребления и затрат. На этой выставке, с помощью демонстрации своей системы логического вывода ИИ следующего поколения «Efficient Long Context* LLM* Serving», компания SK hynix показала, что CMM-Ax может эффективно ускорять работу с длинными контекстами, которые было сложно обрабатывать на обычных системах на базе GPU. Исследования, лежащие в основе этих достижений, также получили официальное признание за техническое совершенство, будучи опубликованными на «MICRO 2026», самой престижной научной конференции в области компьютерной архитектуры.
* Длинный контекст (Long Context): диапазон текста, который ИИ может обрабатывать за один раз, определяется как его контекст. Чем длиннее контекст, тем больше информации ИИ может использовать одновременно для генерации уточненных ответов, но это также требует большего объема памяти. * LLM (Large Language Model — большая языковая модель): модель ИИ, которая обучается на больших данных для генерации и понимания естественных, человекоподобных предложений. Значительно увеличивая масштаб своих параметров, она приобретает передовые возможности обработки языка, такие как понимание сложного контекста, рассуждение и перевод.
Секция памяти была организована таким образом, чтобы посетители могли увидеть флагманские продукты, с помощью которых SK hynix в настоящее время лидирует на рынке памяти. В выставочном пространстве портфеля продуктов в крайнем левом углу была представлена линейка продуктов для инфраструктуры ИИ, охватывающая eSSD и серверную DRAM.
Линейка eSSD представила продукты с различным назначением, адаптированные к разнообразным потребностям клиентов, организованные по форм-фактору: высокопроизводительный «PS1010 U.2»; высокопроизводительный «PS1110 E3.S» и высокоемкий «PS1101 E3.S», находящиеся в стадии последовательной разработки; а также «PEB210 E1.S» и «PEB210 M.2 2280», которые поддерживают прямое жидкостное охлаждение (DLC) и привлекают внимание как eSSD для центров обработки данных.
Что касается серверной DRAM, SK hynix представила линейку DDR5 RDIMM с различным объемом памяти — во главе с «256GB 3DS* RDIMM*», который обеспечивает самый большой в отрасли объем для рабочих нагрузок ИИ, и расширяющуюся до 96 ГБ и 64 ГБ. Наряду со 128-гигабайтным DDR5 MRDIMM*, компания также продемонстрировала «192GB SOCAMM*2», который повышает энергоэффективность и экономию пространства благодаря новому форм-фактору.
* 3DS (3D Stacked Memory — трехмерная многослойная память): высокопроизводительная память, которая соединяет два или более чипа DRAM с помощью TSV (сквозных кремниевых переходов). * RDIMM (Registered Dual In-line Memory Module — регистровый модуль памяти DIMM): серверный модуль, объединяющий несколько чипов DRAM. * MRDIMM (Multiplexed Rank Dual In-line Memory Module — мультиплексированный ранговый модуль памяти DIMM): продукт, в котором два ранга — базовая рабочая единица модуля — работают одновременно, что значительно повышает скорость. * SOCAMM (Small Outline Compression Attached Memory Module): маломощный модуль памяти на базе DRAM, специализированный для серверов ИИ.
▲ Сенсорный экран, где посетители могут ознакомиться с информацией о продукте
Компания SK hynix также установила модель с сенсорным экраном, напоминающую реальный сервер, что позволило посетителям ознакомиться с подробной информацией о продуктах.
▲ Посетитель устанавливает продукт HBM4 компании SK hynix на модель NVIDIA Vera Rubin
Выставочное пространство HBM* в центре было спроектировано так, чтобы посетители могли сразу оценить как лидерство SK hynix в области технологий HBM, так и ее прочное партнерство с NVIDIA. С левой стороны дисплея модель суперчипа NVIDIA Vera Rubin подчеркивала партнерство между двумя компаниями, в то время как посетители могли самостоятельно установить HBM4 и SOCAMM2 на модель сервера. Справа стояла модель HBM, увеличенная в миллион раз, с сопровождающим монитором, на котором транслировалось видео о TSV* и Advanced MR-MUF* — ключевых технологиях, лежащих в основе HBM. Между двумя моделями были размещены реальные продукты HBM4E, HBM4 и HBM3, чтобы посетители могли воочию увидеть, как продукты HBM эволюционировали от поколения к поколению.
* HBM (High Bandwidth Memory — память с высокой пропускной способностью): высокотехнологичный, высокопроизводительный продукт, который соединяет несколько чипов DRAM вертикально для увеличения емкости и значительного повышения скорости обработки данных. HBM разрабатывалась в следующем порядке: 1-е поколение (HBM) – 2-е поколение (HBM2) – 3-е поколение (HBM2E) – 4-е поколение (HBM3) – 5-е поколение (HBM3E) – 6-е поколение (HBM4) – 7-е поколение (HBM4E). * TSV (Through Silicon Via — сквозной кремниевый переход): технология, которая соединяет чипы вертикально с помощью электродов, проходящих прямо через кремниевую подложку. * Advanced MR-MUF: технология MR-MUF нового поколения, которая применяет контроль коробления — технологию управления чипами, позволяющую укладывать чипы на 40% тоньше обычных без изгиба, а также улучшает теплоотвод.
▲ Модель, показывающая структуру HBF
HBF (High Bandwidth Flash — флэш-память с высокой пропускной способностью) — это решение NAND нового поколения, которое, подобно HBM, применяет технологию TSV для объединения высокой емкости обычного хранилища с высокой пропускной способностью. По мере наступления эры агентного ИИ, ориентированного на логический вывод, она привлекает внимание как ключевая технология для эффективной обработки растущего использования данных ИИ. С левой стороны дисплея стояла модель, показывающая структуру HBF, а справа от нее — баннер с подробными техническими характеристиками. На сопровождающем мониторе и планшете SK hynix представила ключевые особенности HBF, а также соответствующие сильные стороны HBM и HBF в различных средах обслуживания логического вывода ИИ с помощью видеороликов и графиков производительности, основанных на внутренних симуляциях. Было показано, что высокоскоростная обработка HBM может быть использована в средах, где критически важно быстрое время отклика, в то время как характеристики высокой емкости HBF могут быть использованы в средах, требующих памяти большой емкости для обслуживания множества пользователей.
▲ Графика, передающая видение SK hynix, расположенная на внешней стене стенда
Тем временем на правой стене стенда была размещена графика, передающая видение компании по предоставлению оптимизированных решений для всей иерархии памяти. Под историей пути от разработки первого в мире HBM в 2013 году до достижения нынешнего технологического лидерства были также представлены новейшие продукты и статус разработки технологий в каждой из областей HBM, DRAM и NAND.
▲ Вице-президент Хосик Ким, глава департамента исследований систем памяти, во время своей презентации
Наряду с выставкой, презентационные сессии также повысили ожидания в отношении серверных систем, ориентированных на память. Во-первых, на сессии «Executive», состоявшейся во второй половине первого дня, вице-президент Хосик Ким, глава отдела исследований систем памяти, выступил в качестве спикера с презентацией под названием «Введение в серверные системы ИИ, ориентированные на память (MARS)» (Introduction to Memory-centric AI Rack Systems (MARS)).
Вице-президент Ким сначала отметил, что по мере быстрого роста генеративного ИИ и гипермасштабируемых центров обработки данных традиционные архитектуры, ориентированные на CPU и GPU, сталкиваются с узким местом, известным как «стена памяти», наряду с резко растущим энергопотреблением. Затем он представил «серверную систему ИИ, ориентированную на память» в качестве решения.
«Эта система реализует объединение памяти на уровне стоек и динамический обмен данными с нулевым копированием путем соединения процессоров и графических процессоров с помощью технологии CXL следующего поколения, — пояснил он, — и она спроектирована таким образом, чтобы значительно увеличить скорость перемещения данных при высоких нагрузках». Он добавил: «Используя это, мы можем повысить эффективность повторного использования KV-кэша в совместном агентном ИИ, ускорить скорость отклика мультимодальной модели omni в персональных агентных ИИ-сервисах и решить проблемы с нерегулярным доступом к памяти, возникающие при крупномасштабном обучении GNN*».
* GNN (Graph Neural Network — графовая нейронная сеть): модель ИИ, которая обучается на данных со структурой графа, соединенных узлами и ребрами. Она используется в областях, где важны взаимосвязи между данными, таких как социальные сети, молекулярные структуры и рекомендательные системы.
▲ Вице-президент Ёнпё Джу, руководитель отдела системной архитектуры, принимает участие в панельной дискуссии
Кроме того, вице-президент Ёнпё Джу, руководитель отдела системной архитектуры, принял участие в панельной дискуссии, состоявшейся во второй половине третьего дня. Дискуссия, проходившая под темой «Интеграция программных фреймворков и API между компаниями для PIM/PNM», была посвящена важности программного фреймворка, который связывает клиентов и продукты в рамках экосистемы, где несколько компаний переплетены как в конкуренции, так и в сотрудничестве, а также необходимости стандартизации в этой области.
На сессии «Breakout», состоявшейся в тот же день, инженеры, непосредственно участвовавшие в разработке, вышли на сцену и подробно рассказали о необходимости ключевых технологий памяти, предпосылках их создания, а также о реальном процессе разработки и текущем статусе.
Сначала руководитель группы AI System Infra Чонрюль Ким выступил с докладом «Система обслуживания агентного ИИ с вычислительным пулом общей памяти» — о технологиях на основе общей памяти, которые повышают производительность агентных ИИ-сервисов, — объяснив, что совместное использование токенов ускоряет токенизацию на базе процессора, а совместное использование KV-кэша повышает скорость отклика и эффективность использования ресурсов. Он также подчеркнул потенциал дальнейшего повышения производительности за счет переноса токенизации и анализа важности KV-кэша в реальном времени на вычислительную общую память.
Технический руководитель AI System Infra Ёнхун Мин вместе с профессором Киваном Мэнгом из Университета штата Пенсильвания выступили с докладом «Системная архитектура с использованием вычислительной памяти для обучения с дифференциальной приватностью» — о системной архитектуре, которая использует память с вычислительными возможностями для повышения эффективности обучения ИИ с дифференциальной приватностью, — представив базовую технологию, которая снижает дополнительную вычислительную нагрузку и перемещение данных в процессе обучения, используемом для защиты личной информации, тем самым повышая скорость обучения и энергоэффективность. Наконец, технический руководитель AI Platform SW Джухи Ли выступила с презентацией «Хранилище как уровень производительности для обслуживания LLM».
В SK hynix заявили: «На этом OCP Global Summit было особенно важно показать, как наши решения памяти следующего поколения работают в реальных системах», добавив: «Мы продолжим стремиться к технологическим инновациям, чтобы технологии ИИ могли продолжать развиваться, опираясь на память как на основу».