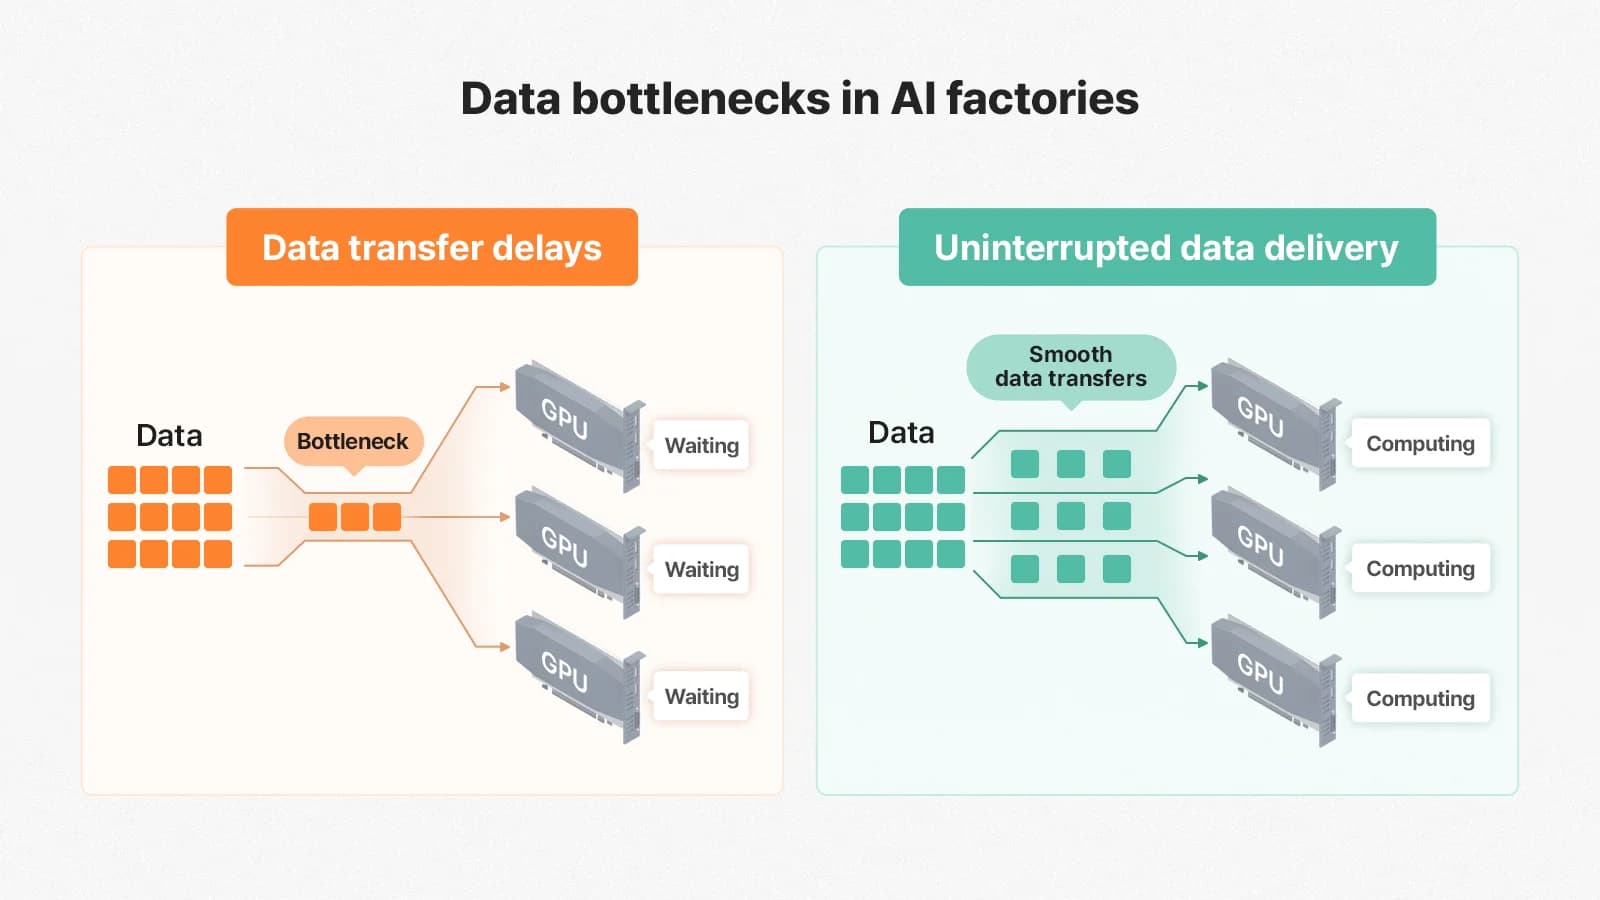
По мере того как рабочие нагрузки ИИ смещаются в сторону логического вывода и агентного ИИ, критерии производительности систем также меняются. Одной лишь вычислительной мощности уже недостаточно. Место хранения данных, скорость их перемещения и эффективность обработки теперь напрямую влияют на производительность и эффективность систем ИИ.
Эта серия статей исследует трансформацию экосистемы ИИ, в которой программное обеспечение, инфраструктура центров обработки данных, полупроводники и технологии памяти работают сообща. В ней также рассматривается, почему полупроводниковая память стала фундаментальной технологией для эпохи ИИ, и излагается видение SK hynix по созданию экосистемы памяти для ИИ следующего поколения.
В 5-й части рассматривается, почему память и системная архитектура должны развиваться вместе по мере того, как ИИ выходит за пределы центров обработки данных в физический мир. В статье представлены идеи Нам Сон Кима, почетного профессора Иллинойсского университета в Урбане-Шампейне (UIUC), который занимался исследованиями энергоэффективных процессорных архитектур и руководил разработкой DRAM следующего поколения и технологии обработки в памяти (PIM).
① Смена парадигмы в вычислениях ИИ ② Настоящее «узкое место»: данные, а не вычисления ③ Реорганизация инфраструктуры: почему архитектура определяет производительность ④ Смена полупроводниковой парадигмы в сторону памяти ⑤ Завершение формирования ИИ: Физический интеллект и роль памяти — профессор Нам Сон Ким, Иллинойсский университет в Урбане-Шампейне (UIUC)
В эпоху физического ИИ архитектура подсистемы памяти и размещение данных в иерархии памяти становятся столь же важными, как системная архитектура и вычисления этих данных. По мере того как ИИ выходит за рамки моделей, ограниченных центрами обработки данных, в системы, взаимодействующие с физическим миром в режиме реального времени — такие как роботы, транспортные средства, промышленные дроны, умные очки с ИИ и носимые устройства, — повышения только вычислительной производительности становится недостаточно. Производительность все больше зависит от того, где хранятся данные, насколько близко к источнику их можно обработать и насколько эффективно их можно доставить при необходимости с минимальным энергопотреблением.
В частях с 1 по 4 этой серии рассматривалось, как факторы, определяющие производительность ИИ, выходят за рамки чистых вычислительных мощностей, включая доставку данных, архитектуру инфраструктуры и системный дизайн, ориентированный на память. Часть 5 переносит фокус за пределы центра обработки данных. По мере того как ИИ проникает в физический мир, ограничения, связанные с энергопотреблением, тепловыделением, временем отклика и размером устройства, становятся все более жесткими. Чтобы обеспечить надежную работу ИИ в рамках этих ограничений, сама отправная точка проектирования систем должна измениться.
Умные очки должны быстро интерпретировать информацию в поле зрения пользователя, а роботам необходимо воспринимать окружающую обстановку и корректировать свои движения практически в режиме реального времени. Аналогичным образом, транспортные средства и промышленные дроны должны принимать автономные решения даже при потере связи или задержках отклика. В таких ситуациях перекладывать все принятие решений на центр обработки данных непрактично. Вместо этого лучше подходит системная архитектура, которая обрабатывает данные рядом с местом их генерации и принимает решения локально.
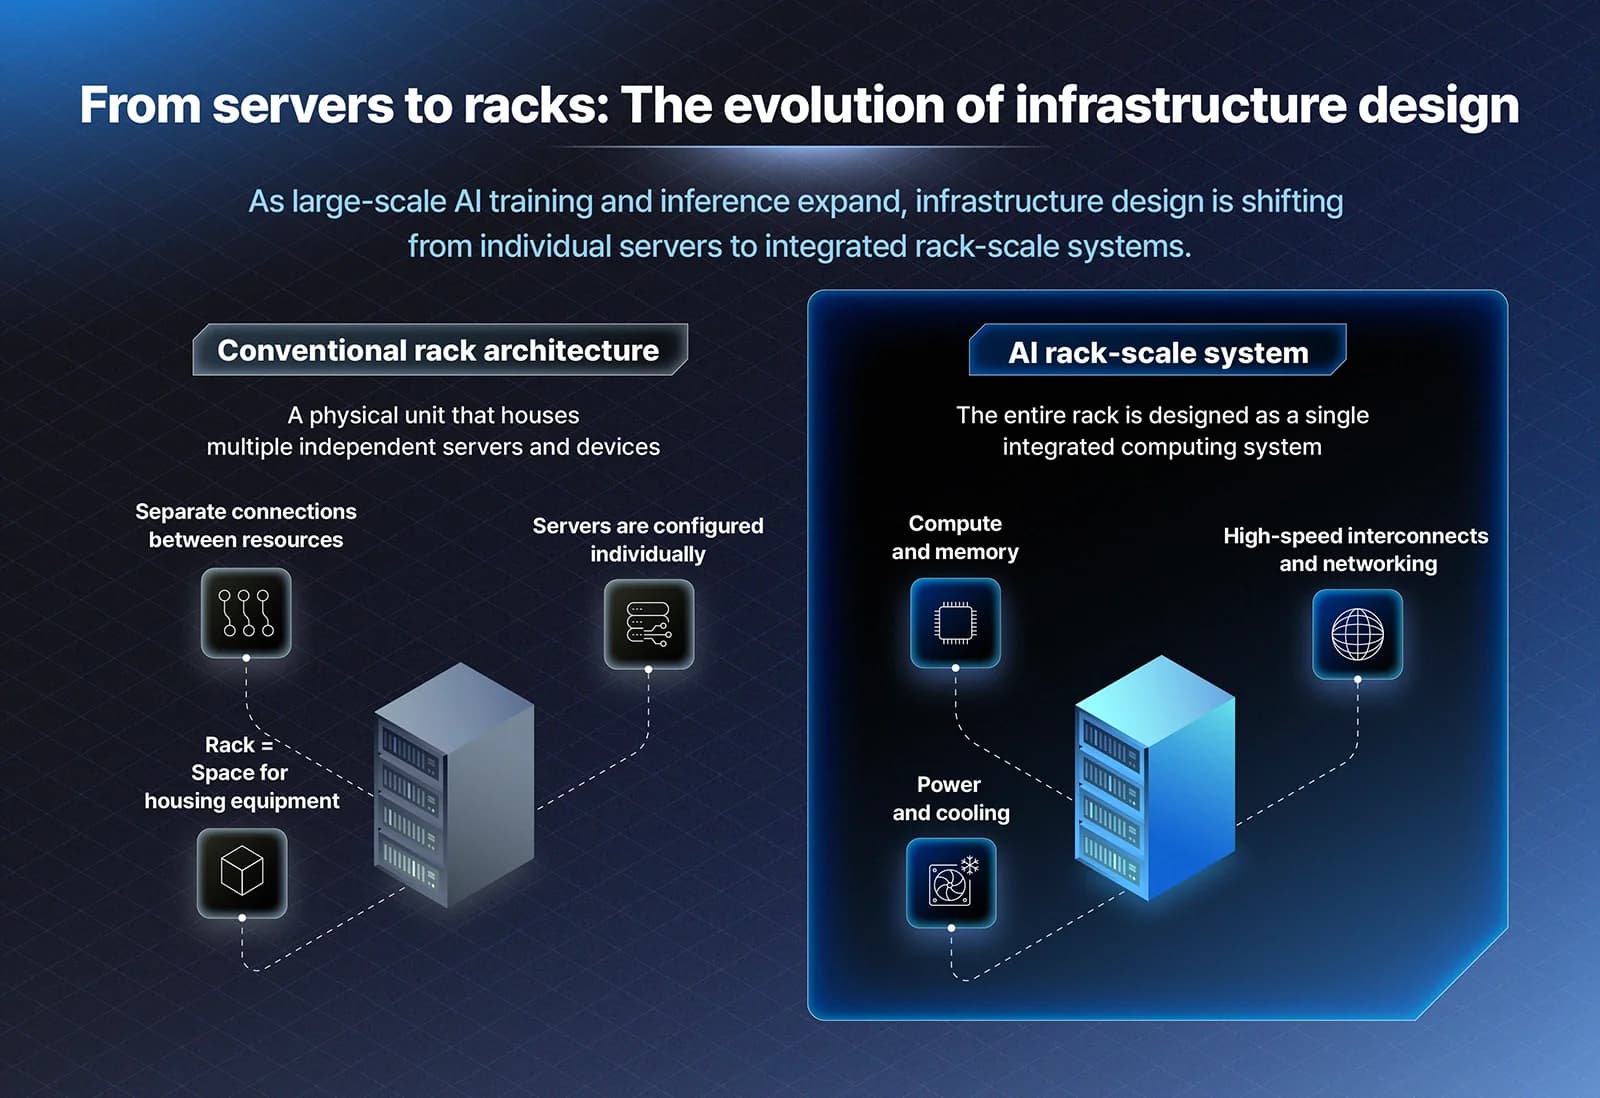
До сих пор высокопроизводительный ИИ в основном работал в гипермасштабируемых центрах обработки данных. Эти объекты предлагают доступ к крупномасштабным кластерам GPU, достаточному пространству на платах, мощным источникам питания и надежным системам охлаждения, обеспечивая достаточные системные ресурсы для обработки ресурсоемких вычислительных нагрузок и сложного перемещения данных.
Однако среды, в которых работают физический ИИ и локальный ИИ (on-device AI)*, значительно отличаются от центров обработки данных. Локальный ИИ интегрирует возможности ИИ непосредственно в устройства, находящиеся рядом с пользователями, такие как смартфоны, умные очки и носимые устройства. Как физический ИИ, так и локальный ИИ требуют высокой производительности, низкой задержки и высокой энергоэффективности одновременно.
* Локальный ИИ (On-device AI): подход, при котором вычисления ИИ выполняются непосредственно на устройствах, таких как смартфоны, носимые устройства и умные очки, без отправки данных на внешние серверы.
Однако при интеграции ИИ в физические устройства емкость аккумулятора, теплоотвод, размер корпуса и архитектура межсоединений становятся критическими ограничениями проектирования. Периферийные и мобильные среды не могут легко вместить большие кластеры GPU или расширять стандартные модули памяти по мере необходимости. Энергетические ресурсы также ограничены, как и возможности отвода тепла. По мере уменьшения размеров устройств их бюджеты мощности сокращаются, а пространство, доступное для отвода тепла, становится все более ограниченным.
В результате ИИ, работающий в физическом мире, должен по возможности обрабатывать данные локально внутри устройства или, по крайней мере, рядом с местом их генерации. Движения роботов, решения по управлению автономным транспортом и промышленные системы управления крайне чувствительны к задержкам. Увеличение времени кругового прохождения сигнала по сети может задержать принятие критически важных решений, а нестабильные соединения ставят под угрозу общую надежность системы. По мере выхода ИИ за пределы центра обработки данных проектирование продуктов должно начинаться с учета емкости памяти, путей передачи данных и задержек.
Эти ограничения также влияют на проектирование алгоритмов. Одним из подходов является сжатие моделей, которое уменьшает размер модели при минимизации снижения производительности, тем самым расширяя спектр моделей, которые могут работать непосредственно на устройствах. Одним из широко используемых методов является квантование*, которое представляет параметры модели с использованием меньшего количества бит для уменьшения требований к хранению и нагрузки при передаче данных.
Однако для физического ИИ и локального ИИ простого уменьшения размера модели недостаточно. Производительность логического вывода также должна поддерживаться даже в условиях жестких ограничений по мощности и тепловыделению. TurboQuant* — это пример метода квантования, разработанного для удовлетворения этих требований, который фокусируется на снижении требований к памяти во время логического вывода при сохранении качества ответов модели.
В последнее время появились подходы, которые отдают приоритет поиску в памяти, а не повторяющимся вычислениям. Engram* — один из таких примеров. В обычных больших языковых моделях (LLM) система обычно обрабатывает информацию или реконструирует паттерны, последовательно проходя через несколько слоев нейронной сети. Engram, напротив, хранит часто используемые паттерны и информацию в таблице поиска «условной памяти», извлекая только ту информацию, которая относится к данному вводу. Это похоже на то, как люди делают заметки о часто используемой информации и обращаются к ним при необходимости. Хотя такой подход снижает вычислительную нагрузку — поскольку одну и ту же информацию не нужно пересчитывать каждый раз, — он увеличивает объем данных, которые необходимо хранить и извлекать. В результате емкость памяти и возможности доставки данных становятся основными ограничениями скорости и эффективности обработки.
* Квантование: метод, который представляет веса модели, значения активации и кэши ключей-значений (KV) с использованием меньшего количества бит для снижения объема используемой памяти и перемещения данных. Например, представление 16-битных данных в 8-битном или 4-битном форматах позволяет сократить требования к хранению и накладные расходы на передачу данных * TurboQuant: метод квантования, который снижает использование памяти путем сжатия KV-кэша в низкобитовые представления во время вывода LLM * Engram: архитектура, использующая условную память и крупномасштабные таблицы поиска для переноса части вычислительных нагрузок на операции поиска в памяти, вместо восстановления информации исключительно посредством вычислений внутри нейронной сети
Хотя TurboQuant и Engram используют разные подходы, оба они представляют собой попытки перекалибровать взаимосвязь между вычислениями и памятью. Одной лишь оптимизации программного обеспечения недостаточно для улучшения реальной производительности. По мере того как ИИ проникает в физический мир, изменения в алгоритмах все чаще диктуют изменения в архитектуре памяти.
По мере того как ИИ выходит за пределы центров обработки данных в периферийные и мобильные устройства, требования к проектированию памяти также меняются. В частности, в приложениях физического ИИ любая задержка при обработке данных может напрямую привести к задержкам в принятии решений и физических действиях в реальном мире. Следовательно, сфера проектирования расширяется за пределы самой памяти, охватывая системную интеграцию — от размещения и соединения компонентов памяти и логики до обеспечения достаточной пропускной способности внутри корпуса и управления тепловыделением во время работы.
Проектирование памяти для физического ИИ должно решать три ключевые задачи: размещение данных вблизи вычислительных устройств, гибкое подключение необходимых ресурсов памяти, а также хранение и подача больших объемов данных на соответствующем уровне памяти. Для решения этих задач используются различные технологии, включая специализированную HBM*, 3D-стековую DRAM*, специализированную DRAM, вычисления в памяти (Processing-in-Memory)*, Compute Express Link*, High Bandwidth Flash* и твердотельные накопители (SSD).
* Специализированная HBM: архитектура HBM, адаптированная к конкретным рабочим нагрузкам ИИ или системным требованиям путем настройки пропускной способности, емкости, характеристик энергопотребления и конфигураций корпуса * 3D-стековая DRAM: технология, которая вертикально размещает DRAM непосредственно поверх логических полупроводников, таких как системы на кристалле (SoC), для сокращения путей передачи данных и увеличения возможностей ввода-вывода (I/O). Она направлена на снижение задержек и энергопотребления при улучшении использования пространства * Вычисления в памяти (PIM): технология, которая выполняет определенные вычисления внутри или рядом с памятью * Compute Express Link (CXL): стандарт высокоскоростного межсоединения, который связывает процессоры, ускорители и устройства памяти для обеспечения расширения и совместного использования памяти * High Bandwidth Flash (HBF): технология памяти следующего поколения на основе NAND, исследуемая как новый уровень памяти между HBM и SSD. Подобно HBM, HBF применяет технологию логической обработки к базовому кристаллу, стремясь обеспечить значительно большую емкость, чем HBM, при достижении сопоставимой пропускной способности и экономической эффективности
Во-первых, специализированная HBM, 3D-стековая DRAM и специализированная DRAM ориентированы на размещение памяти ближе к вычислительным устройствам при адаптации емкости, пропускной способности и характеристик питания к конкретным рабочим нагрузкам и системным требованиям. HBM вертикально стекирует несколько кристаллов DRAM и соединяет их через широкий интерфейс для обеспечения высокой пропускной способности в заданном форм-факторе. 3D-стековая DRAM дополнительно сокращает расстояние между памятью и вычислительными устройствами за счет размещения DRAM непосредственно поверх логических чипов или систем на кристалле (SoC), увеличивая пропускную способность передачи данных в ограниченном пространстве. Специализированная DRAM аналогичным образом оптимизирует характеристики памяти для конкретных форм-факторов* и рабочих нагрузок.
* Форм-фактор: физические проектные ограничения устройства, включая его размер, форму, внутреннее пространство, требования к питанию и тепловые условия
PIM делает еще один шаг вперед, приближая определенные вычисления к месту хранения данных. По мере увеличения объема данных, передаваемых между памятью и процессорами, растут энергопотребление и задержки. Для рабочих нагрузок, связанных с частым и повторяющимся доступом к данным, PIM выполняет определенные операции обработки внутри или рядом с памятью, чтобы сократить ненужное перемещение данных.
В случаях, когда размещения памяти ближе к вычислениям недостаточно, архитектура соединений также должна измениться. Например, такие системы, как Engram, которые хранят и извлекают большие объемы информации через таблицы поиска, или агенты физического ИИ, поддерживающие обширную контекстную и статусную информацию, могут превышать пределы емкости внутренней памяти устройства. CXL решает эту проблему, предоставляя высокоскоростной последовательный интерфейс между процессорами, ускорителями и устройствами памяти, что позволяет расширять и совместно использовать внешние ресурсы памяти.
Поскольку не все данные могут храниться в HBM или DRAM, большие объемы данных обрабатываются уровнем хранения. Журналы датчиков роботов, данные карт для автономного вождения и информация, накопленная за длительные периоды в физических средах, могут храниться в SSD на основе 3D NAND и извлекаться в DRAM или HBM при необходимости. Однако большие наборы данных, к которым часто обращаются во время вывода, такие как веса моделей, требуют более высокой пропускной способности, чем могут обеспечить обычные SSD. HBF нацелен на эту конкретную потребность как новый уровень памяти, стекируя кристаллы 3D NAND и используя широкий интерфейс для объединения большой емкости хранения NAND с высокой скоростью передачи данных.
Хотя эти технологии выполняют разные роли, их объединяет общая цель: размещение данных там, где они нужны, и сокращение ненужного перемещения данных. HBM, 3D-стековая DRAM и PIM оптимизируют уровни памяти вблизи вычислений, в то время как CXL обеспечивает гибкое подключение для дополнительных необходимых ресурсов памяти. Тем временем SSD и HBF хранят и поставляют большие объемы данных. В конечном счете, проектирование памяти для физического ИИ сводится к тому, как эти различные уровни объединяются для удовлетворения требований конкретных рабочих нагрузок и систем.
По мере того как ИИ выходит за пределы центров обработки данных в периферийные устройства, роботов и транспортные средства, становится все труднее удовлетворить потребности каждой рабочей нагрузки с помощью одного набора спецификаций памяти. Крупномасштабное обучение и вывод требуют высокой пропускной способности и емкости, в то время как встроенный ИИ в компактных форм-факторах отдает приоритет энергоэффективности и низкой задержке. В то же время, по мере того как объем данных, генерируемых на местах — таких как журналы датчиков роботов, данные карт для автономного вождения и многое другое — продолжает расти, проектирование уровня хранения также стало важной задачей.
Следовательно, широкий спектр технологий памяти и хранения, от HBM до HBF, должен быть интегрирован в единый портфель на уровне системы ИИ. Критерий конкурентоспособности памяти для ИИ также смещается от производительности отдельных продуктов к тому, насколько эффективно вся иерархия памяти может быть настроена для конкретных рабочих нагрузок и форм-факторов.
Это основа видения SK hynix в отношении полностековых решений для памяти ИИ. Достижение системной производительности и энергоэффективности требует объединения HBM и других продуктов DRAM, включая 3D-стековую DRAM, специализированную память, SSD, HBF, CXL и PIM, посредством единого, полностекового подхода к проектированию систем ИИ. Реализация этих вариантов и комбинаций требует возможностей Memory Library, которые поддерживают конфигурации памяти, адаптированные к архитектурам и рабочим нагрузкам клиентов.
Помимо простого предоставления продуктов, адаптированных к требованиям клиентов, SK hynix стремится стать архитектурным партнером, совместно проектируя конфигурации памяти, оптимизированные для конкретной архитектуры каждого клиента. Будущие системы ИИ должны проектироваться с учетом не только вычислительных возможностей, но и всего жизненного цикла данных: где они хранятся, как перемещаются и где обрабатываются. По мере расширения сферы физического ИИ память становится неотъемлемой частью проектирования систем, обеспечивая своевременную подачу нужных данных и устраняя разрыв между вычислительными устройствами и хранилищами.
По мере того как ИИ все глубже проникает в физический мир, способы хранения, передачи и обработки данных напрямую влияют на скорость отклика и эффективность системы. Поскольку память играет все более решающую роль в производительности систем ИИ, мы вступаем в эпоху, когда эволюция памяти будет определять эволюцию самого ИИ.
Отказ от ответственности: Мнения, выраженные в этой статье, принадлежат исключительно автору и не обязательно отражают официальную позицию SK hynix.