Поскольку объем данных, обрабатываемых системами искусственного интеллекта, продолжает расти, технология памяти для эффективного хранения и обработки этих данных развивается все быстрее. Выходя за рамки простого хранения данных и их извлечения по мере необходимости, формируется целый ряд конкретных идей — таких как распределение памяти по уровням в зависимости от частоты использования данных или объединение нескольких серверов в единый пул памяти для повышения эффективности передачи между хранилищем и системой. Постоянные инновации в области проектирования и технологий производства продолжают способствовать росту емкости и скорости обработки, в то время как отрасль активно работает над расширением роли памяти за счет интеграции вычислительных функций.
Компания SK hynix приложила значительные усилия, чтобы опережать эти быстро меняющиеся технологические тенденции и предоставлять клиентам оптимальные решения. Конференция Supercomputing 2026, проходившая с 15 по 20 ноября в Чикаго, штат Иллинойс, США, предоставила возможность воочию увидеть результаты этих усилий.
Supercomputing 2026 — это глобальная конференция, объединяющая новейшие технологии в области высокопроизводительных вычислений (HPC) и искусственного интеллекта. В этом году выставку посетили около 10 000 человек, в ней приняли участие около 500 компаний и организаций.
В ходе мероприятия SK hynix подробно представила свои решения нового поколения в рамках живых демонстраций и презентовала свое технологическое видение трансформации экосистемы искусственного интеллекта вокруг памяти. Компания укрепила отношения сотрудничества с глобальными клиентами и партнерами, одновременно внимательно изучая новейшие технологические тенденции на рынке вычислений нового поколения и исследуя новые возможности для бизнеса.
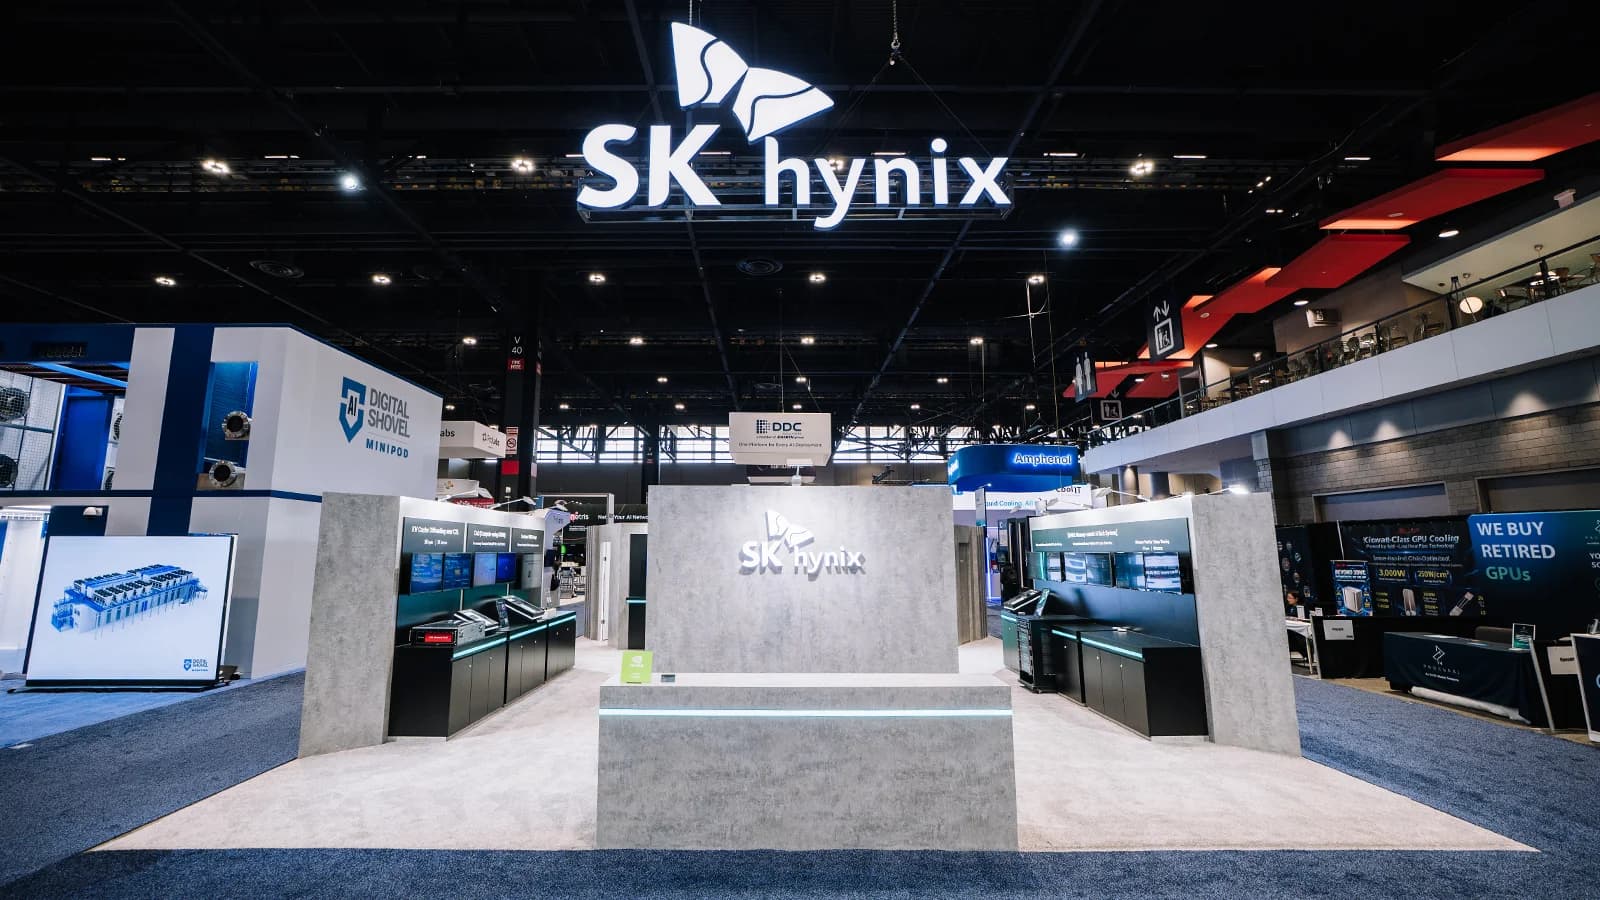
▲ Выставочный стенд SK hynix
Благодаря яркому дизайну стенда, в котором неоново-голубой свет подчеркивал контуры шершавых серых стен, SK hynix визуально воплотила образ технологии памяти нового поколения. Выделяясь даже в полумраке выставочного зала, стенд привлекал внимание проходящих мимо посетителей.
▲ Посетители у экспозиции MARS
Пройдя через вход и направляясь к стене справа, посетители сначала попадают в зону MARS. MARS (Memory-centric AI Rack System) — это система нового поколения, которая максимизирует эффективность за счет интеграции решений партнеров в единую стойку*, в центре которой находится память. В секции MARS компания SK hynix представила три связанных с ней деморолика.
* Стойка (Rack): Стандартный каркас, используемый в центрах обработки данных для размещения серверов, систем хранения, сетевого оборудования и других устройств в несколько ярусов. Поскольку оборудование управляется в юнитах стойки, стойка служит базовым строительным блоком инфраструктуры центра обработки данных.
▲ Демонстрация пула памяти, совместно использующего кэш KV на уровне стойки
В первой демонстрации SK hynix объединила память CXL* с гибридной памятью CXL*, чтобы представить пул памяти*, совместно использующий кэш KV* на уровне стойки. Крупномасштабные кэши KV, которые генерируются непрерывно, сохраняются на SSD в составе гибридной памяти CXL; при их повторном использовании система на основе предыдущих разговоров и истории задач прогнозирует, какие именно кэши KV понадобятся, и быстро загружает их в DRAM. Это продемонстрировало, что решение способно обеспечить хранение большой емкости для огромных объемов информации, необходимых для работы ИИ, а также высокую скорость чтения.
* CXL (Compute eXpress Link): Интерфейс нового поколения, который эффективно соединяет ЦП, графические процессоры, память и другие компоненты вычислительной системы для поддержки крупномасштабных вычислений на сверхвысоких скоростях * Гибридная память CXL: Решение памяти на базе CXL, которое идет на шаг дальше памяти CXL на базе DRAM, объединяя DRAM и SSD * Кэш KV (Key Value Cache): Временная память, которая хранит ранее вычисленные результаты, когда ИИ-агент на основе большой языковой модели генерирует текст. Он растет экспоненциально по мере удлинения беседы и увеличения числа обрабатываемых задач, поэтому возможность эффективного хранения и обработки кэша KV существенно влияет на производительность ИИ-агента * Пул памяти (Pooled Memory): Технология, объединяющая несколько модулей памяти CXL в общий пул и повышающая общую эффективность использования памяти за счет того, что несколько хостов могут разделять ее емкость.
▲ Демонстрация технологии обслуживания ИИ-агентов с использованием вычислительного пула памяти
Во второй демонстрации SK hynix показала систему обслуживания на базе ИИ-агентов, которая повышает эффективность за счет использования вычислительного пула памяти* для соединения нескольких серверов и графических процессоров. Это доказало, что выборочная передача или повторное использование кэша KV с помощью вычислительного пула памяти на базе CXL может значительно повысить производительность системы по сравнению с традиционными методами, зависящими от сетевого взаимодействия.
* Вычислительный пул памяти (Computational Memory Pool): Решение памяти, в которое добавлены вычислительные функции внутри пула памяти, позволяющие выполнять простые вычисления до отправки данных на ЦП или графический процессор.
▲ Демонстрация технологии совместного использования токенов на базе пула памяти CXL
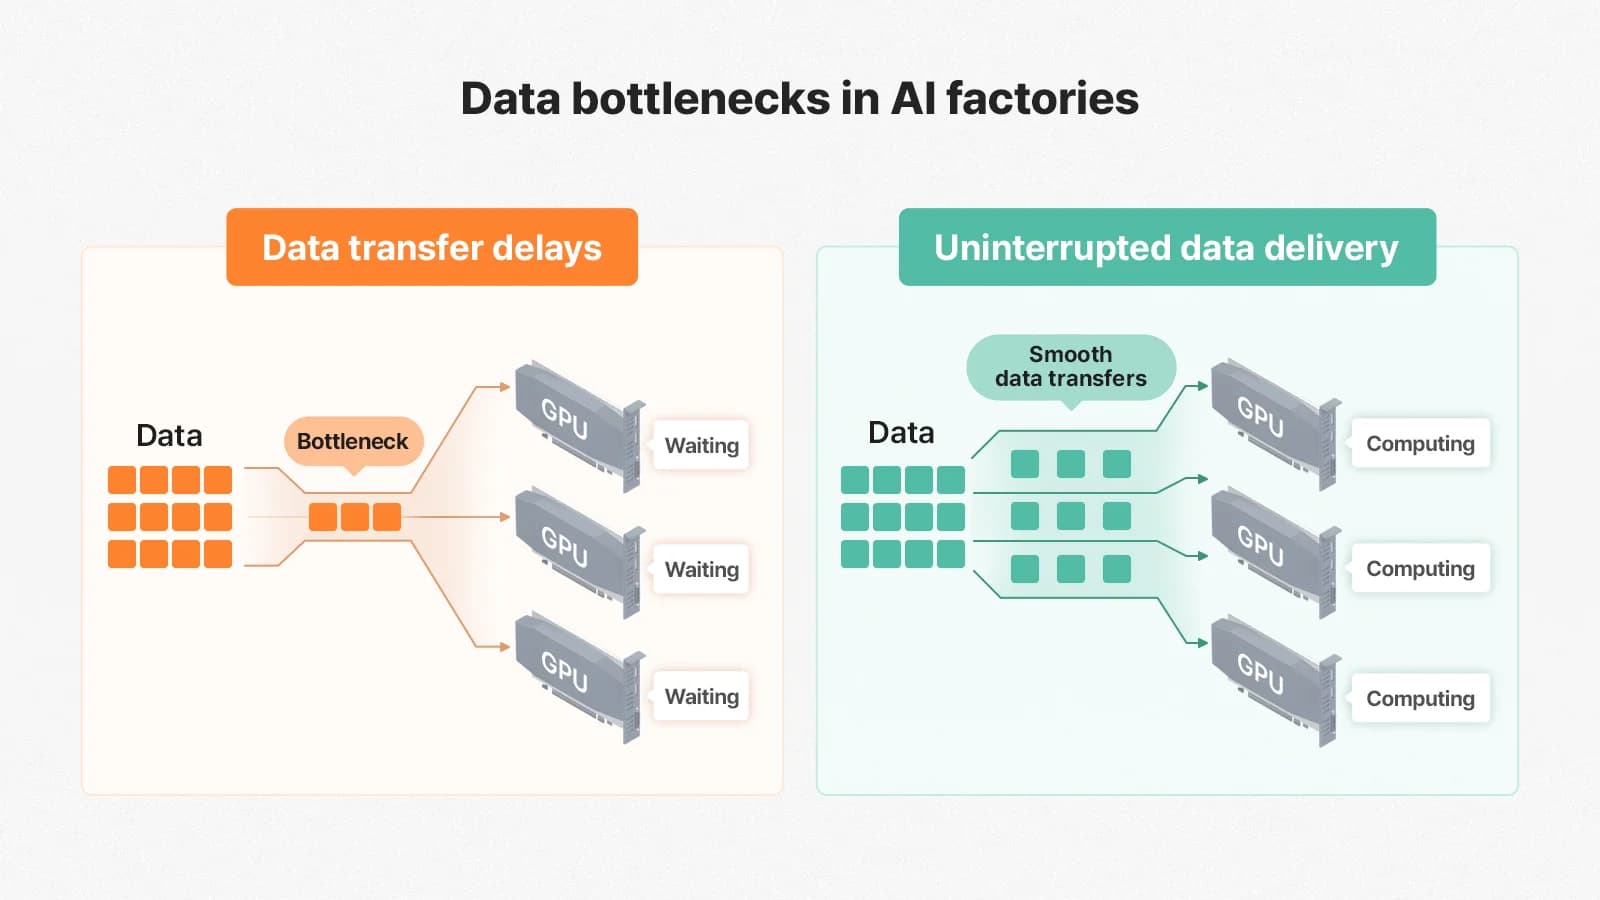
В третьей демонстрации SK hynix показала, как повышается производительность мультимодальных* служб искусственного интеллекта за счет того, что серверы на базе ЦП, соединенные через пул памяти CXL, совместно используют генерируемые ими токены. Для мультимодальных служб ИИ время токенизации* оказывает огромное влияние на производительность, поскольку задержки при предварительной обработке на ЦП увеличивают время простоя графического процессора и снижают эффективность обработки. Используя пул памяти CXL для совместного использования данных запросов и токенов между серверами ЦП, SK hynix сократила избыточную обработку, тем самым оптимизировав использование ресурсов ЦП и планирование задач, а также улучшив предварительную обработку. В результате сократилось время простоя графического процессора и возросла производительность обслуживания.
* Мультимодальность: Технология искусственного интеллекта, которая понимает и обрабатывает различные формы данных одновременно, такие как текст, изображения, голос и видео * Токенизация: Процесс разбиения данных, таких как текст или изображения, на мельчайшие единицы, называемые токенами, чтобы модель искусственного интеллекта могла их обработать.
На противоположной стене располагалась секция системных демонстраций. Слева направо были последовательно представлены три технологии: выгрузка кэша KV через CXL (KV Cache Offloading over CXL), вычисления с использованием DRAM (Compute-using-DRAM) и настраиваемый массив HBM (Custom HBM Array), которые заставляли посетителей останавливаться в изумлении.
▲ Посетители смотрят демонстрационный ролик в зоне выгрузки кэша KV через CXL
Зона разгрузки кэша KV через CXL (KV Cache Offloading over CXL) включала в себя видеоролик, представляющий концепцию технологии, демонстрационное видео, а также баннер с подробным описанием продуктов, составляющих данное решение. Разгрузка кэша KV через CXL — это новая технология памяти для ИИ, которая помогает центрам обработки данных эффективно размещать память и совместно использовать ее в соответствии с требованиями. Она добавляет пул памяти CXL в иерархию памяти ИИ, которая ранее состояла только из HBM* и DRAM: кэши KV, которые понадобятся в ближайшее время, размещаются в первую очередь в HBM и DRAM, в то время как кэши KV, которые будут востребованы позже, хранятся в пуле памяти CXL. Поскольку место хранения определяется с учетом таких факторов, как частота повторного использования, давность использования, размер и стоимость восстановления, этот подход может принести преимущества, выходящие за рамки простого увеличения емкости. Пул памяти можно использовать для перераспределения ресурсов в соответствии с меняющимся спросом или для того, чтобы позволить нескольким хостам совместно использовать емкость. Совместно с SK Telecom, которая развивает бизнес центров обработки данных на базе ИИ, компания SK hynix завершила верификацию в реальной среде вывода LLM*, а на этой выставке она продемонстрировала эти приросты эффективности в демонстрационном видео, чтобы посетители могли оценить их с первого взгляда.
* HBM (High Bandwidth Memory): высокоэффективный продукт с высокой добавленной стоимостью, объединяющий несколько чипов DRAM по вертикали для увеличения емкости и резкого повышения скорости обработки данных. HBM развивалась в следующем порядке: 1-е поколение (HBM) – 2-е поколение (HBM2) – 3-е поколение (HBM2E) – 4-е поколение (HBM3) – 5-е поколение (HBM3E) – 6-е поколение (HBM4) * LLM (Large Language Model): модель искусственного интеллекта, которая обучается на больших данных для понимания человеческого языка и генерации естественных предложений
▲ Посетители изучают брошюру, представляющую решение Compute-using-DRAM
Зона вычислений с использованием DRAM (Compute-using-DRAM) состояла из видеоролика, представляющего концепцию технологии, демонстрационного видео, а также размещенных под ними брошюр о продуктах и решениях. Compute-using-DRAM — это технология, которая выполняет вычисления внутри памяти за счет использования явления распределения заряда (charge-sharing*), присущего массиву ячеек DRAM. Используя структуру DRAM, которая активирует строки от тысяч до десятков тысяч битов одновременно, она параллельно обрабатывает операции на уровне битов посредством копирования данных из строки в строку и одновременной активации нескольких строк. Поскольку в ней используется стандартная коммерческая память DRAM без добавления отдельного вычислительного модуля, она позволяет повысить как пропускную способность, так и энергоэффективность, минимизируя при этом потери площади кристалла и емкости. В частности, она привлекла значительное внимание как решение нового поколения для повышения эффективности передачи данных в системах ИИ, поскольку может выполнять простые операции — такие как логические операции, арифметика и построенные на них крупномасштабные сравнения данных — непосредственно внутри памяти и передавать только результаты, вместо того чтобы перемещать большие объемы данных, генерируемых при вычислениях ИИ, в иерархию кэша вычислительного модуля.
* Распределение заряда (Charge Sharing): явление, при котором заряд, хранящийся в ячейке DRAM, соприкасается с разрядной линией и изменяет напряжение — основной принцип, по которому DRAM считывает данные
▲ Посетители изучают структурную модель массива Custom HBM Array
В зоне Custom HBM Array был представлен видеоролик, представляющий концепцию технологии, а также модель продукта и брошюра с описанием решения. Обычные системы на базе GPU могут подключать только фиксированное количество модулей HBM, что ограничивает возможности расширения пропускной способности, а также приводит к неэффективному использованию ресурсов GPU при выполнении декодирования LLM (генерации ответов). Custom HBM Array преодолевает эти ограничения благодаря структуре, которая соединяет несколько модулей cHBM*, оснащенных вычислительными функциями. Ожидается, что она обеспечит более быстрое время отклика и более высокую энергоэффективность по сравнению с обычными системами на базе GPU, а также уменьшит узкие места при перемещении данных. Посетители проявили живой интерес, изучая внутреннюю структуру по частям перед моделью продукта, задавая вопросы находившимся рядом сотрудникам и задерживаясь надолго.
* cHBM (Custom High-Bandwidth Memory): настраиваемая технология памяти, которая позволяет добавлять различные функции к обычной памяти HBM. Когда вычислительные функции интегрированы, она может быть спроектирована так, чтобы располагать память и вычислительный модуль вертикально друг над другом, сокращая расстояние, которое должны проходить данные, и задействуя высокую пропускную способность памяти
▲ Основные продукты HBM компании SK hynix
В секции портфолио продуктов за стендом компания SK hynix представила свою ключевую линейку продукции для инфраструктуры ИИ. В зоне HBM следующее поколение HBM4E и HBM4 были выставлены бок о бок с HBM3E, которая в настоящее время занимает лидирующие позиции на рынке HBM.
В зоне серверной памяти DRAM компания SK hynix представила модуль «256GB 3DS* DDR5 RDIMM*», обладающий наибольшей в отрасли емкостью для рабочих нагрузок ИИ, а также высокоскоростной модуль «128GB DDR5 MRDIMM*» и универсальный модуль «96GB DDR5 RDIMM». Рядом с ними был выставлен модуль «192GB SOCAMM*2», который повышает эффективность использования энергии и пространства благодаря новому форм-фактору.
* 3DS (3D Stacked Memory): технология, которая вертикально упаковывает несколько чипов DRAM и соединяет их с помощью сквозных кремниевых выводов (TSV) для увеличения емкости в рамках одного корпуса * RDIMM (Registered Dual In-line Memory Module): модуль памяти DRAM, используемый в серверах и рабочих станциях, который повышает стабильность за счет включения регистра для ретрансляции сигналов * MRDIMM (Multiplexed Rank Dual In-line Memory Module): серверный модуль DRAM, который повышает пропускную способность за счет одновременного использования двух ранкингов * SOCAMM (Small Outline Compression Attached Memory Module): стандарт серверных модулей на основе маломощной DRAM, характеризующийся высокой энерго- и пространственной эффективностью
В зоне твердотельных накопителей корпоративного класса (eSSD) наибольшее внимание привлекли модели «PEB210 E1.S», поддерживающая прямое жидкостное охлаждение (DLC), и «PS1110 E3.S», обеспечивающая высокую емкость и низкое энергопотребление в соответствии со стандартом NVMe* E3.S. Линейку дополнили новейшие продукты eSSD — такие как «PS1010 U.2» и «PEB210 M.2 2280» — которые отвечают разнообразным потребностям клиентов в самых разных сценариях использования.
* NVMe (Non-Volatile Memory Express): стандарт связи для энергонезависимой памяти на базе интерфейса PCIe. По сравнению с обычным интерфейсом SATA, он лучше подходит для сверхвысокоскоростной обработки данных большой емкости.
▲ Секция представления компании, демонстрирующая историю и видение SK hynix, а также ее путь разработки HBM и статус новейших продуктов
За стеной у входа на стенд располагалась секция представления компании. На настенной графике была представлена история и концепция развития SK hynix, отражающая в едином ключе путь разработки HBM вместе с текущим статусом новейших продуктов в сферах HBM, DRAM и NAND.
▲ Технический руководитель Енхун Мин из подразделения AI System Infra выступает со своей презентацией
В рамках сессии презентаций технический руководитель Енхун Мин (Younghoon Min) из AI System Infra поднялся на сцену, чтобы представить доклад «Обеспечение обслуживания Agentic AI с помощью дезагрегированных пулов памяти» (Enabling Agentic AI Serving with Disaggregated Memory Pools), подробно рассказав о MARS — архитектуре систем ИИ на базе памяти.
В частности, он представил ключевые технологии архитектуры MARS: совместное использование и повторное использование кэша KV на базе пула памяти CXL, а также обмен токенами для стойки ЦП. Он пояснил, что эти технологии повышают коэффициент использования графических и центральных процессоров по сравнению с традиционными методами, существенно улучшая производительность обслуживания многошаговых агентированных систем ИИ.
В SK hynix отметили, что, поскольку память становится решающим фактором производительности и эффективности инфраструктуры ИИ, эта выставка позволила компании наглядно продемонстрировать свою технологическую конкурентоспособность и видение памяти для ИИ. В дальнейшем, выступая в роли ключевого технологического партнера, нацеленного на повышение производительности вычислений для ИИ, SK hynix продолжит развиваться вместе со своими клиентами.