По мере того как ИИ-агенты становятся все более способными и сфера их применения расширяется на кибернетическую безопасность и другие области, потребность в эффективной оценке возрастает. Агенты, исследующие кодовую базу, принимают последовательность решений: где искать, какие инструменты использовать, как интерпретировать свидетельства и когда отправлять найденный результат. Оценка такой работы требует четких определений задач, постоянных условий выполнения и способа анализа как процесса, так и результата.
Мы представляем Agentic FAITH, расширение платформы оценки FAITH от Cisco Foundation AI. Она переносит задачи, требующие многократных шагов и использования инструментов, в ту же самую структуру, которую команды уже используют для бенчмарков вопрос-ответ. Теперь исследователи и инженеры могут использовать единый рабочий процесс для проведения оценок в области кибербезопасности, оценки результатов и анализа итогов для обоих типов задач.
Рисунок 1. Традиционные и агентские бенчмарки используют общий рабочий процесс, причем каждый бенчмарк определяет собственные задачи и правила подсчета очков.
Единый рабочий процесс для оценок кибербезопасности
FAITH уже объединяет бенчмарки кибербезопасности для анализа угроз, классификации уязвимостей и сведений о безопасности в единый рабочий процесс оценки. Поддержка агентов расширяет этот рабочий процесс на такие задачи, как исследование репозитория с помощью инструментов терминала, предоставляя командам единую платформу для запуска и анализа как традиционных, так и агентских оценок.
Рабочий процесс остается привычным: query запускает бенчмарк и собирает записи, eval оценивает результаты, а summarize сообщает о результатах. Команда run-all объединяет эти этапы. Команды, использующие FAITH, могут запускать и анализировать свои новые агентские бенчмарки с помощью тех же самых команд.
Для агентских задач FAITH управляет взаимодействием между моделью и ее инструментами. Модель выбирает действие, получает вывод инструмента и использует этот результат для принятия решения о дальнейших шагах. Запуск продолжается до тех пор, пока агент не отправит ответ или не достигнет условия остановки, определенного бенчмарком.
Рисунок 2. Для инструментов терминала FAITH передает вызов настроенной среде и возвращает результат модели. Она записывает эти взаимодействия для последующей проверки.
Оцените в действии с помощью VulnLoc
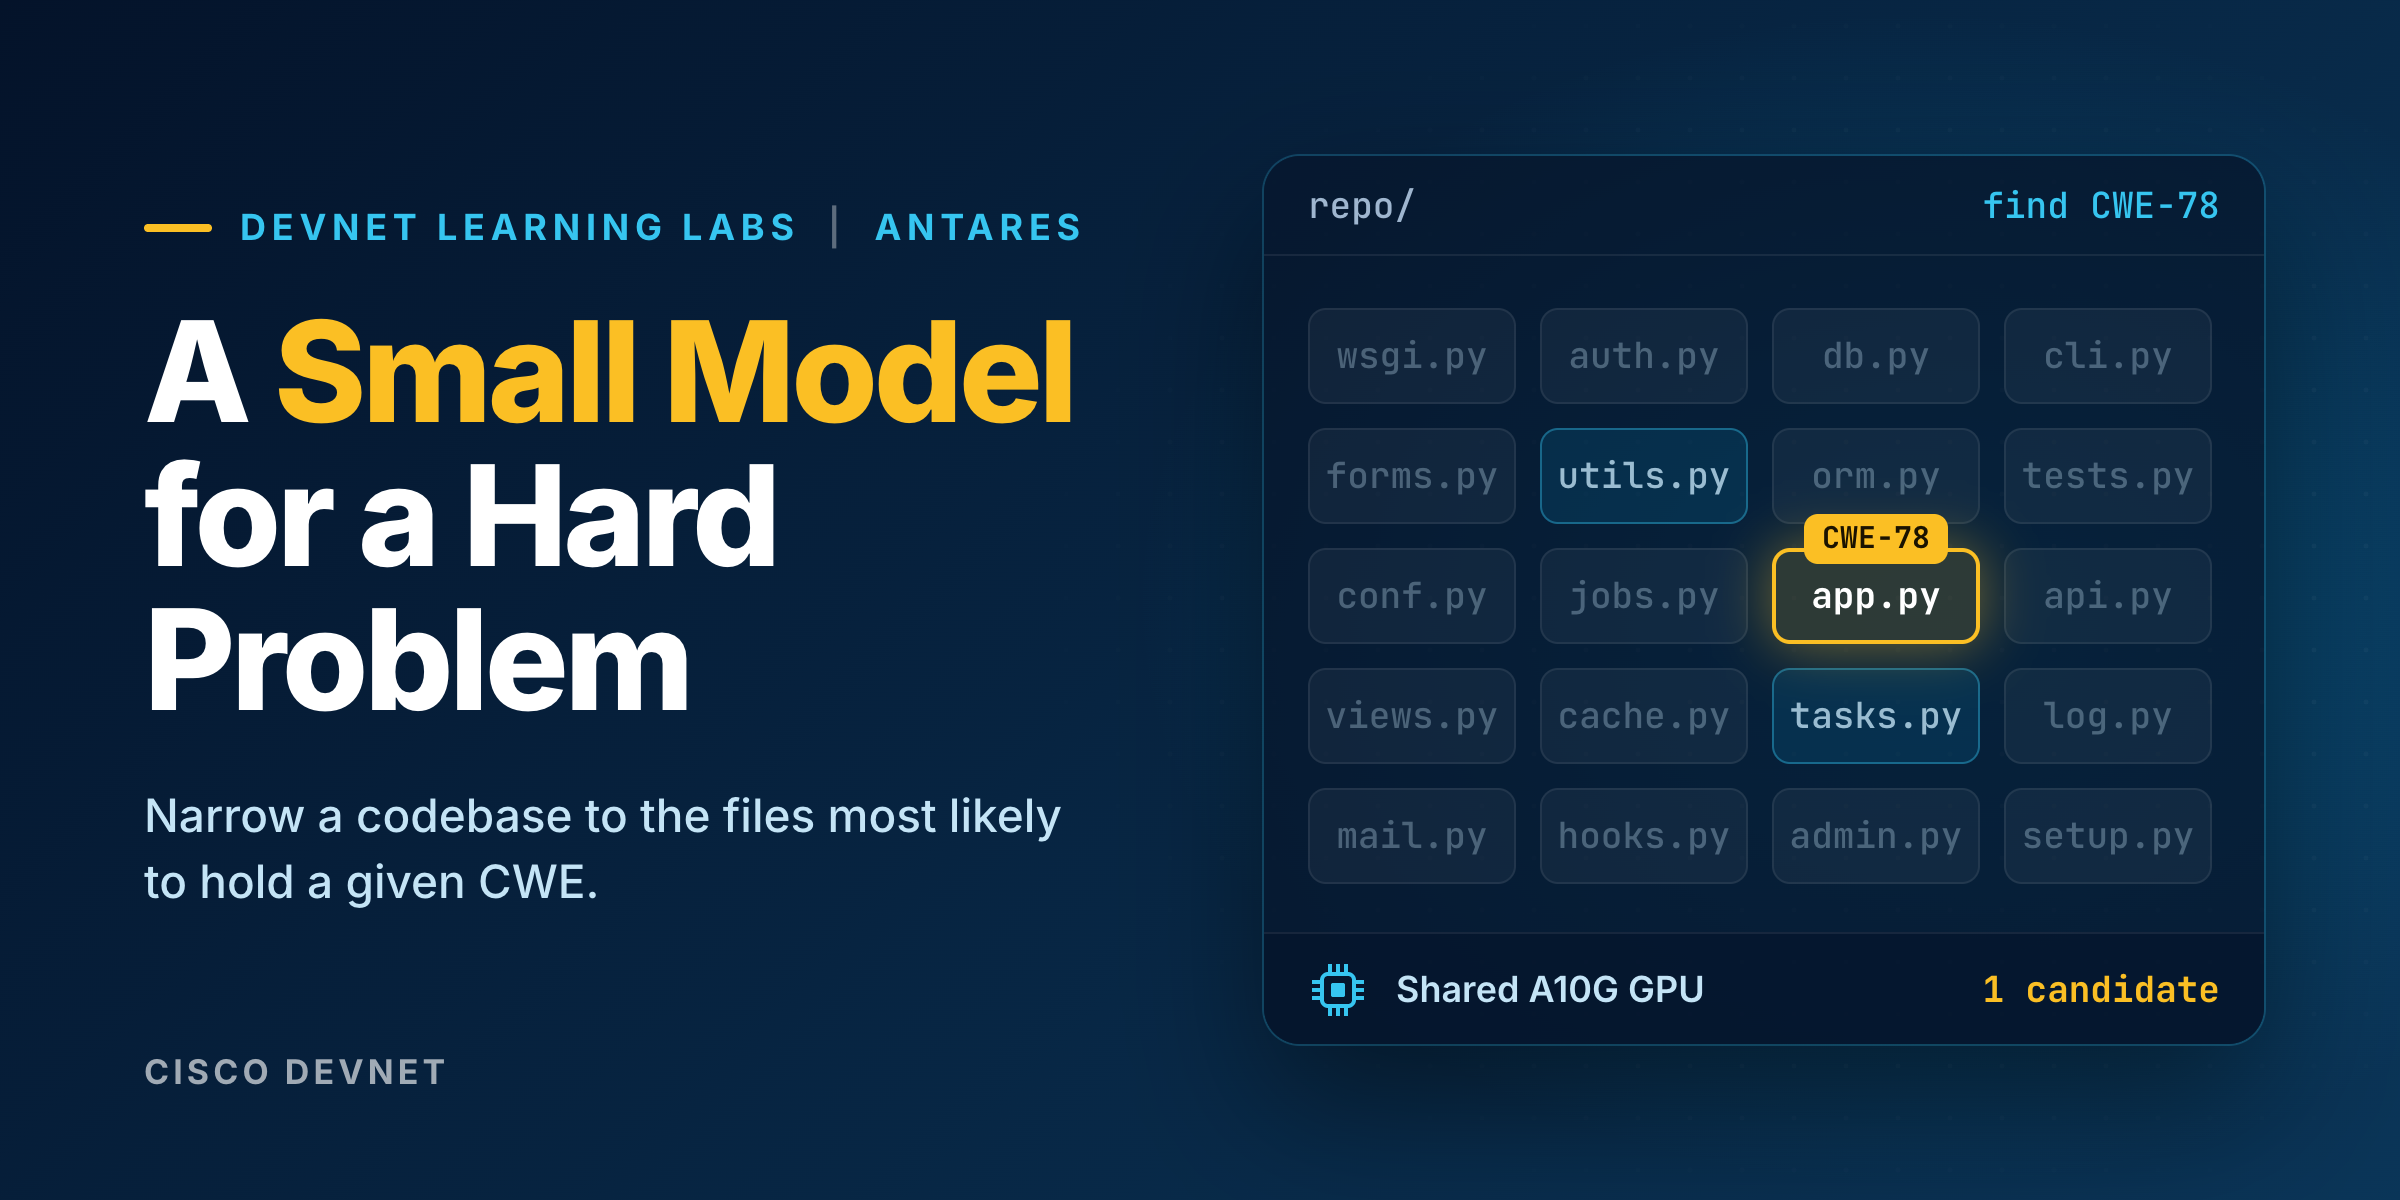
Первым интегрированным агентским бенчмарком является VulnLoc, который оценивает, насколько хорошо агенты находят уязвимые файлы в репозитории и избегают ложных тревог на пропатченном коде.
Каждая задача предоставляет агенту снимок репозитория и описание класса уязвимости. Агент исследует код с помощью инструментов терминала, ищет релевантную логику и следует за тем, что обнаруживает. Затем он отправляет файлы, в которых, по его подозрению, содержится уязвимость, или явно сообщает, что не нашел подходящей уязвимости.
VulnLoc может запускаться локально с помощью Docker для доверенных входных данных или в Kubernetes через Agent Sandbox. Среда выполнения обеспечивает доступ к репозиторию только для чтения.
FAITH объединяет обе фазы бенчмарка:
- Фаза А: поиск затронутых файлов. Агент проверяет репозиторий до установки исправления безопасности. Набор файлов F1 измеряет, насколько хорошо отправленные им файлы соответствуют эталонным данным бенчмарка, учитывая как пропущенные файлы, так и неверный выбор.
- Фаза Б: распознавание исправления. Агент проверяет соответствующий пропатченный репозиторий и сообщает об отсутствии указанной уязвимости. Основной метрикой является частота истинных отрицательных результатов.
В совокупности эти фазы оценивают способность находить уязвимости и избегать ложных тревог на пропатченном коде. Статус выполнения записывается, чтобы корректный отчет об отсутствии подходящей уязвимости можно было отличить от пропущенной отправки или сбоя выполнения.
Рисунок 3. Пути к файлам и отправленные данные являются иллюстративными.
Создавайте оценки на основе своих задач
VulnLoc — это первая интеграция в расширяемую архитектуру бенчмарков. Авторы бенчмарков могут определять, как загружаются задачи, какие инструменты может использовать агент, где эти инструменты выполняются и как извлекаются и оцениваются отправленные данные. Они могут повторно использовать существующие компоненты или реализовывать и регистрировать новые в FAITH.
Бенчмарки также настраивают промпты, лимиты итераций, бюджеты вызовов инструментов и тайм-ауты. Четкое определение этих условий помогает командам понять настройки, лежащие в основе результата, и оценивать модели в рамках единого набора ограничений.
Конфигурация развертывания может переопределять среду бенчмарка по умолчанию, позволяя командам адаптировать настройки выполнения, сохраняя определение задачи неизменным.
Понимайте каждый запуск и сохраняйте свой прогресс
FAITH сохраняет историю бесед, вызовы инструментов и ответы, отправленные ответы, ошибки выполнения и причину завершения каждой задачи. Если агент пропускает уязвимый файл, исследователи могут проверить, проверял ли он этот код, какую информацию он получил и не исчерпал ли свой бюджет выполнения. Эти записи помогают командам расследовать сбои и определять изменения для изучения в последующих оценках.
Длинные оценки также получают преимущество от контрольных точек завершенных задач. FAITH сохраняет каждую завершенную задачу перед началом следующей. Когда это хранилище остается доступным, прерванная оценка может повторно использовать подходящие завершенные результаты. Работа возобновляется на границах задач, снижая необходимость повторять завершенные задачи после прерывания.
Начало работы с Agentic FAITH
Новая техническая документация FAITH объединяет инструкции по установке, руководство по быстрому началу работы с агентами, конфигурацию моделей, руководство по развертыванию и инструкции по созданию бенчмарков.
Начните с небольшой оценки VulnLoc. Выберите модель и конечную точку, которые поддерживают структурированные вызовы инструментов через совместимый с OpenAI интерфейс Chat Completions, настройте среду Docker и запустите задачу. Agentic FAITH поддерживает размещенные конечные точки и соответствующим образом настроенные модели, обслуживаемые через совместимый API. Проверьте сохраненную запись выполнения вместе с оценкой, прежде чем расширять область оценки.
Начните работу с руководством по быстрому старту Agentic FAITH, изучите код на и внесите свой вклад в виде бенчмарков, которые вы хотите оценить следующими. Мы создаем общую платформу для растущего спектра способов использования ИИ-систем в кибернетитке и приветствуем бенчмарки, которые помогают нашему сообществу измерять эти возможности.