В марте мы писали, что в Learning Labs появятся среды на базе графических процессоров, чтобы учащиеся могли на практике опробовать собственные ИИ-модели Cisco. Первые две такие лаборатории уже запущены и построены на базе Antares. В этом посте сначала рассказывается о самих лабораториях, а затем приоткрывается завеса тайны над тем, как платформа запускает рабочие нагрузки на графических процессорах. Если вас интересуют только лаборатории по безопасности, вам хватит первой половины.
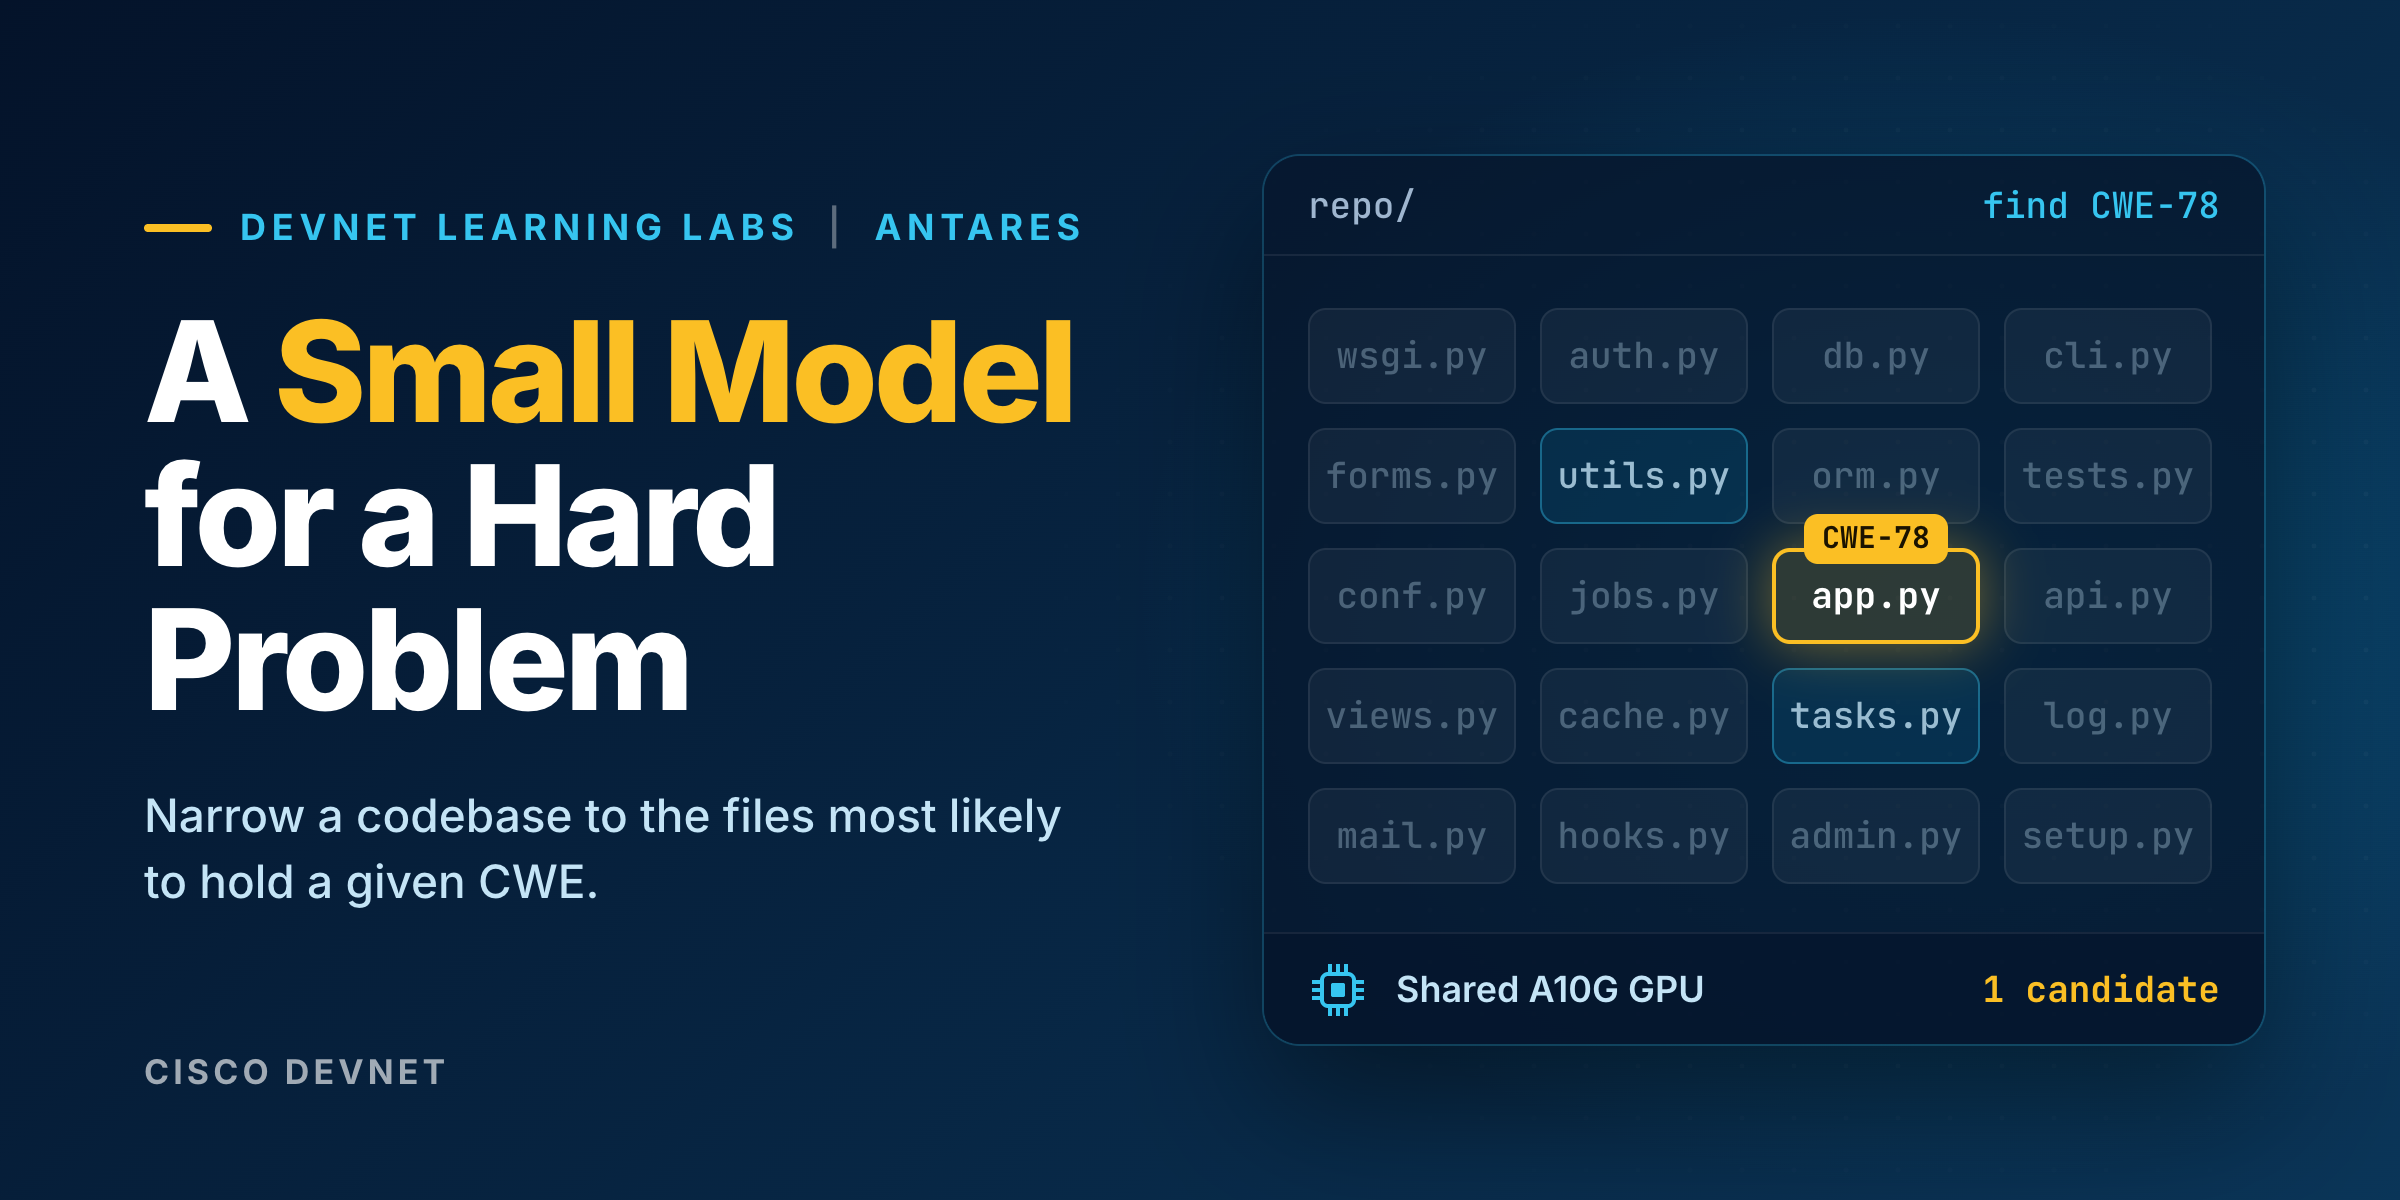
Antares-1B возвращает app.py в качестве кандидата на внедрение команд (command-injection) для проверки в родной лаборатории DevNet GPU. Этот прогон на NVIDIA A10G занял 25,95 секунд; воспроизведение сжато до 4,5 секунд. Пройдите эту лабораторию
Что делает Antares
Поиск реального места возникновения известного типа уязвимости в большой кодовой базе обычно означает чтение файла за файлом или отправку кода в большую облачную модель. Antares устраняет оба этих ограничения. Это семейство компактных моделей с открытыми весами от Cisco Foundation AI, достаточно маленьких для запуска на одном графическом процессоре. У них одна задача: локализация уязвимостей. Вы передаете в Antares тип уязвимости, записанный в виде CWE (стандартная категория программных уязвимостей, например CWE-78, внедрение команд ОС), и модель определяет, какие файлы в кодовой базе могут ее содержать.
Antares сканирует код не так, как статический анализатор, применяя фиксированные правила за один проход. Она работает как агент, который исследуется итеративно, подобно тому, как человек-рецензент работает с незнакомым репозиторием. Каждый шаг выбирается на основе результатов предыдущего: модель ищет релевантные шаблоны кода, читает файлы-кандидаты, учитывает новые данные и переходит по цепочке от одного файла к другому. Когда путь оказывается бесперспективным, она меняет направление, сужая круг файлов до тех, которые наиболее важны, пока не наберет достаточно доказательств для ответа. Например, если попросить ее найти внедрение команд (CWE-78), она выполнит поиск вызовов вроде os.system, откроет app.py, чтобы посмотреть, откуда поступают входные данные, и сообщит об этом файле, объяснив, почему он может быть уязвим.
Несмотря на свой размер, Antares не уступает гораздо более крупным моделям в локализации уязвимостей (подробности бенчмарков см. в карточке модели). Она создана как быстрый конфиденциальный предварительный фильтр: она сокращает большой репозиторий до короткого списка файлов-кандидатов для аналитика-человека, при этом ваш исходный код никогда не покидает вашу среду, если модель и инструменты исследования развернуты локально.
- Модели: Коллекция Hugging Face
- Документ: arXiv 2608.02407
- CLI: cisco-foundation-ai/antares-cli
Две лаборатории: Сканирование кода на уязвимости на графическом процессоре
В обеих лабораториях вы указываете Antares кодовую базу и тип уязвимости, а она подсказывает, какие файлы с наибольшей вероятностью ее содержат и почему. Инференс модели запущен на графическом процессоре в размещенной в браузере лабораторной среде Cisco, там же выполняется и проверка репозитория. Каждая лаборатория занимает около 45 минут (без учета загрузки моделей) и требует бесплатной учетной записи Hugging Face с одобренным доступом к защищенным моделям Antares. Те же действия работают на любом хосте с поддержкой графического процессора, поэтому вы можете применить полученные знания в собственной среде.
Родная лаборатория DevNet связывает опубликованный шаг запроса с завершенным выводом Antares-1B в терминале.
Воспринимайте результаты работы Antares как кандидатов для проверки, а не как подтвержденные находки. Как и любая модель локализации, она может пропустить уязвимый файл или пометить чистый. Она лучше всего работает в сочетании со статическим анализом и ручным просмотром, а не вместо них, и обе лаборатории показывают, как проверить ее работу.
Начало работы с Antares: создание собственного агента поиска уязвимостей
В этой лаборатории вы создадите работающий агент локализации уязвимостей с нуля. Вы загрузите antares-1b, напишете небольшое приложение Flask с уязвимостью внедрения команд ОС (CWE-78) и запрограммируете цикл агента, позволяющий модели выполнить поиск. Затем вы понаблюдаете за тем, как Antares ведет поиск шаг за шагом: каковы его мысли, какие команды он запускает и что возвращает в ответ. В конце он назовет файл, который считает уязвимым, и объяснит почему.
К концу вы научитесь:
- Искать в кодовой базе определенный тип уязвимости (CWE) и получать вероятный файл с понятным объяснением.
- Понимать, как работает ИИ-агент безопасности «под капотом», а не относиться к нему как к черному ящику.
- Ограничивать область работы агента сканируемым кодом с помощью простых защитных барьеров, которые отклоняют команды, пытающиеся производить чтение за пределами репозитория.
- Самостоятельно проверять результат перед тем, как доверять ему — именно так аналитик безопасности использует быстрый предварительный фильтр вроде Antares.
Интерфейс командной строки Antares: сканирование репозитория так же, как в CI
В второй лаборатории вы отсканируете репозиторий с несколькими заложенными уязвимостями с помощью официального Antares CLI от Cisco, работающего на GPU с использованием vLLM. Вы пройдете через три команды, которые используются в реальном проекте:
- antares plan выполняет профилирование репозитория и рекомендует, какие типы уязвимостей стоит проверить, до расходования времени GPU.
- antares query исследует одну уязвимость. В лаборатории она возвращает кандидата на внедрение команд в app.py примерно за 24 секунды.
- antares sweep проверяет каждую рекомендованную уязвимость параллельно и создает отчеты в форматах JSON, Markdown и SARIF, которые уже читают CI-пайплайны и дашборды сканирования кода.
К концу вы научитесь:
- Сканировать весь репозиторий на предмет важных для него типов уязвимостей одной командой и просматривать результаты.
- Интегрировать результаты в CI с помощью вывода SARIF.
- Читать результаты сканирования так, как это делает аналитик, включая проверку выбранных типов уязвимостей перед тем, как делать выводы о пропущенных.
- Сканировать код, который вы не писали, с включенными защитными барьерами. CLI работает со снимком состояния только для чтения, разрешает только те команды чтения, которые добавлены в белый список, блокирует раскрытие оболочки (shell expansion) и изолирует попытки внедрения промптов, скрытые в сканируемом коде.
За кулисами: лаборатории GPU на платформе DevNet
Эта половина предназначена для читателей, которым интересно, как платформа запускает лаборатории GPU в масштабе.
Разделение времени на общих узлах
Лаборатории GPU запущены на инстансах AWS g5.2xlarge, каждый из которых оснащен одним NVIDIA A10G (около 23 ГиБ видеопамяти). Каждая лабораторная среда получает часть этого GPU, настроенную как 3 реплики с разделением времени на один физический GPU. Разделение времени делит время вычислений, а не память. Все три учащихся разделяют один пул видеопамяти без жестких границ между ними, и это оказалось важным (A10G не поддерживает MIG, поэтому аппаратное секционирование на этом типе узлов недоступно).
Подробнее о механике кластера, включая планирование Kubernetes, настройку разделения времени и Karpenter, читайте в нашей серии о GPU: Часть 1 и Часть 2.
Три учащихся, один графический процессор
Перед публикацией мы создали тестовый инструмент бенчмаркинга, который запускает каждую лабораторию от начала до конца по тому же пути, который использует реальный учащийся, через шлюз Istio и WebSocket. Он запускает волны одновременных лабораторных сред и фиксирует завершение, время выполнения шагов, телеметрию ЦП, памяти, диска и графического процессора для каждого процесса.
Обе лаборатории были успешно завершены при одновременной работе трех учащихся на одном GPU. В «Начале работы» каждый учащийся получил почти равную треть вычислительной мощности GPU.
Лаборатории CLI требовалось одно исправление, чтобы заработать. Каждый учащийся запускает собственный сервер vLLM, а экземпляры vLLM не координируют использование памяти GPU друг с другом (vllm#10643). По умолчанию каждый сервер определяет размер своего кэша KV на основе объема памяти, который кажется свободным при запуске. Когда одновременно запускаются три сервера, каждый из них видит память, которую собираются занять остальные; они допускают перераспределение памяти, и в результате обычно запускается только один («No available memory for the cache blocks»).
Для исправления требуются два флага, поскольку vLLM принимает два независимых решения о памяти при запуске:
- –kv-cache-memory 3120851354 фиксирует размер кэш-памяти KV каждого сервера на уровне 2,91 ГиБ вместо ее расчета по свободной памяти. Поскольку измерять больше нечего, исчезает и почва для гонки за ресурсы.
- –gpu-memory-utilization 0.30 по-прежнему необходим. Даже при фиксированном кэше KV vLLM при запуске проверяет, покрывает ли свободная память целевой показатель использования, который по умолчанию составляет 90% карты. Например, при целевом показателе в 92%, как только один сервер запущен, эта проверка для следующего завершается ошибкой: «Free memory on device cuda:0 (17.96/22.06 GiB) on startup is less than desired GPU memory utilization (0.92, 20.29 GiB).» Установка целевого показателя на 35% позволяет каждому серверу запускаться при уже работающих соседних экземплярах.
С обоими флагами все три движка запускаются одновременно и полностью проходят лабораторную работу.
GPU как свойство лаборатории
Со стороны платформы автор лабораторной работы не касается конфигурации GPU. В лабораторной работе объявляется образ с поддержкой GPU; служба среды Learning Labs планирует его на пул узлов GPU и освобождает сегмент по окончании сеанса. Учащиеся просто запускают nvidia-smi и начинают работу.
Создание с помощью ИИ, проверенное экспертами
Мы создали черновики обеих лабораторных работ с использованием навыка создания лабораторий на базе ИИ, который кодирует структуру Learning Lab и стиль создания контента DevNet, а эксперты по безопасности проверили и доработали их. Мы зафиксировали каждый ожидаемый вывод в лабораториях на основе реального запуска на GPU; ничто из этого не было сгенерировано.
Что дальше
- Foundation-sec-8b: следующая лаборатория будет запущена на той же инфраструктуре GPU и использовать модель кибербезопасности от Cisco.
Попробуйте лабораторные работы и расскажите нам, что бы вы хотели увидеть в следующий раз.
- Начало работы с Antares: developer.cisco.com/learning/labs/antares-getting-started
- Antares CLI:
- Все лабораторные работы Learning Labs: developer.cisco.com/learning
Спасибо Дидье Шапоте (Didier Chapoteau) и Барри Юаню (Barry Yuan) за рецензирование и доработку материалов лаборатории, Мэтту Шуштари (Matt Shooshtari) за настройку GPU и CUDA, Джерри Чангу (Jerry Chang) за автоматизацию кластера GPU и Анжелли Ли (Angellee Li) за поддержку платформы Learning Labs.