По мере роста ИИ-приложения его эмбеддинги могут быстро стать одним из самых требовательных к памяти компонентов. Большее количество документов, более мелкие фрагменты и более сложные модели эмбеддингов — всё это увеличивает объем векторных данных, которые ваша база данных должна обрабатывать при поиске. Поддержание высокой скорости поиска по мере роста коллекции может потребовать значительных затрат на оперативную память.
Бинарная квантованная индексация с повторным ранжированием (rescored binary quantization) меняет этот баланс. Она значительно сокращает объем занимаемой памяти, сохраняя при этом скорость и точность поиска в гораздо более широком диапазоне.
Бинарная квантованная индексация с повторным ранжированием меняет этот баланс. Она значительно сокращает объем занимаемой памяти, сохраняя при этом скорость и точность поиска в гораздо более широком диапазоне.
Согласно нашим тестам, Neo4j 2026.09 обеспечивает примерно пятикратное увеличение пропускной способности и снижение задержки запросов по сравнению с Neo4j 2026.08. В предстоящей статье с результатами тестирования будут описаны методология и полученные данные.
В Neo4j 2026.09 Aura, EE и CE бинарная квантованная индексация с повторным ранжированием является настройкой по умолчанию для вновь создаваемых векторных индексов.
Как работает бинарная квантованная индексация с повторным ранжированием
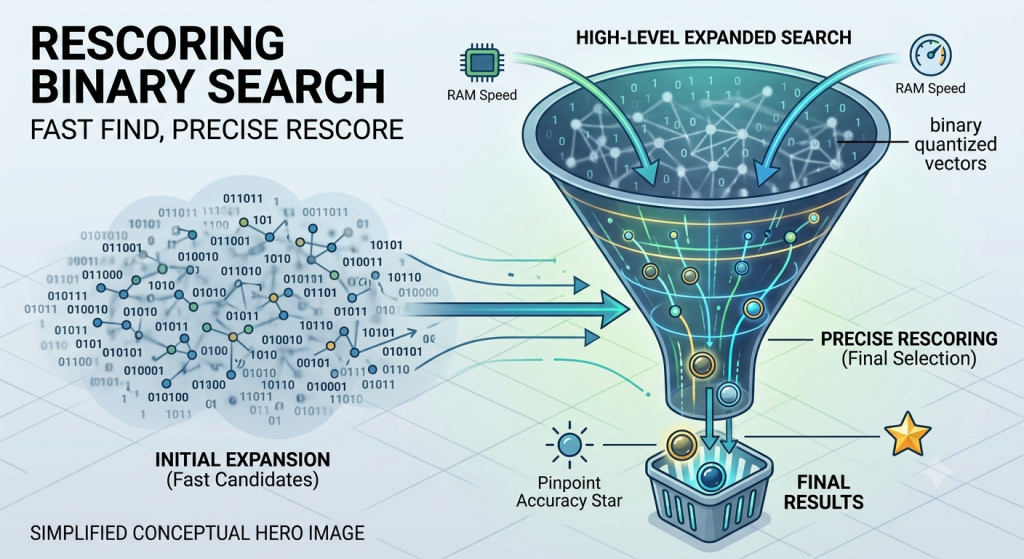
Общий подход, лежащий в основе этого метода, заключается в следующем:
- выполнение начального расширенного поиска с использованием сильно сжатых векторов (бинарно квантованных векторов) для получения списка кандидатов.
- затем кандидаты повторно ранжируются с использованием их полноразмерных векторов.
Это позволяет нам хранить в оперативной памяти только небольшой граф HNSW (Hierarchical Navigable Small World) и сжатые векторы, считывая лишь небольшое количество полноразмерных векторов с диска для повторного ранжирования.
Под капотом применяется множество других методов, но это высокоуровневое описание охватывает самые важные аспекты. Если вам интересны подробности, Neo4j разработала метод, который она называет High Fidelity Quantized (HFQ) векторный поиск, вдохновленный работой над RaBitQ в Наньянском технологическом университете и, позднее, реализацией BBQ в Lucene.
Для 768-мерных эмбеддингов Float32 (по сравнению с нашей предыдущей стандартной скалярной (8-битной) квантованной индексацией) в тот же бюджет памяти для графа HNSW и квантованных значений векторов помещается примерно в четыре раза больше векторов.
Приведенный ниже пример объясняет, почему общее сокращение составляет четыре раза, а не восемь по сравнению со скалярной квантованной индексацией.
Когда использовать бинарную квантованную индексацию с повторным ранжированием
Neo4j v2026.09 предлагает параметры, управляющие квантованием и повторным ранжированием. На практике это означает, что у вас обычно есть выбор между тремя режимами работы:
- Rescored binary — квантование: бинарное (1 бит), коэффициент расширения поиска: 3.0
- Scalar — квантование: скалярное (8 бит), коэффициент расширения поиска: 1.0
- Full-precision — квантование: отсутствует, коэффициент расширения поиска: 1.0
Мы рекомендуем бинарную квантованную индексацию с повторным ранжированием в качестве отправной точки для большинства рабочих нагрузок. В наших тестах она достигает полноты (recall), сопоставимой со скалярной квантованной индексацией, при схожей задержке и пропускной способности, а также значительно меньшем объеме памяти для структур поиска.
Скалярная квантованная индексация может обеспечить немного меньшую задержку (до 30%), когда её более крупные структуры поиска помещаются в память. Если ваш приоритет — минимально возможная задержка, а память не является критическим ограничением, сравните скалярный и полноразмерный поиск для вашей рабочей нагрузки.
На графике ниже показана задержка для скалярной квантованной индексации и бинарной квантованной индексации с повторным ранжированием по мере роста набора данных, измеренная по размеру исходных эмбеддингов Float32. Обе конфигурации работают на одном и том же оборудовании и достигают одинаковой полноты поиска.
Как попробовать бинарную квантованную индексацию с повторным ранжированием
Чтобы создать векторный индекс в режиме бинарной квантованной индексации с повторным ранжированием, вам просто нужно создать новый векторный индекс, не переопределяя параметры vector.quantization.type и vector.default_search_expansion_factor по умолчанию. Чтобы сделать это явно, вы можете использовать приведенный ниже код Cypher.
Параметр default_search_expansion_factor играет важную роль в повторном ранжировании. Он указывает индексу, насколько сильно нужно расширить начальный поиск.
Если он установлен на 3.0, и вы ищете 10 лучших результатов, начальный поиск выдаст 30 лучших кандидатов на основе их бинарно квантованных эмбеддингов, а затем повторно ранжирует и отфильтрует их до 10 лучших.
В наших тестах коэффициент расширения 3.0 обеспечивает хорошую полноту, сопоставимую со скалярной квантованной индексацией. Подходящее значение зависит от ваших эмбеддингов и целевой полноты.
Чтобы вручную улучшить полноту для фиксированного количества конечных результатов, вы можете запросить больше результатов из векторного индекса, а затем вернуть только совпадения с наивысшим баллом. В примере ниже $fetch_count управляет количеством, запрашиваемым из SEARCH, а $top_k управляет количеством, возвращаемым приложению. Увеличение $fetch_count также увеличивает количество кандидатов, рассматриваемых для повторного ранжирования.
Например, при $fetch_count = 30, $top_k = 10 и коэффициенте расширения поиска 3.0, расширенный поиск нацелен на 90 кандидатов для повторного ранжирования, SEARCH возвращает до 30, а приложение получает до 10. Установите $fetch_count как минимум равным $top_k.
Перестройте свой индекс
Бинарная квантованная индексация с повторным ранжированием была представлена в качестве предварительной версии в Neo4j 2026.06 и стала общедоступной в 2026.07. С тех пор её производительность значительно улучшилась.
Чтобы убедиться, что существующий индекс использует все улучшения в Neo4j 2026.09, перестройте его после обновления.
Регулярные обновления могут позволить существующему индексу со временем получить преимущества, но перестроение — это надежный способ гарантировать, что весь индекс получит все улучшения.
Используйте следующий запрос, чтобы получить и сохранить оператор CREATE индекса. Проверьте его конфигурацию перед повторным использованием: воссоздание индекса с явными старыми настройками сохранит эти настройки, а не примет новые значения по умолчанию. Для бинарной квантованной индексации с повторным ранжированием выберите бинарное квантование и коэффициент расширения поиска 3.0, либо полагаясь на значения по умолчанию, либо явно объявив их.
Удалите существующий индекс, затем выполните сохраненный оператор CREATE с любыми необходимыми изменениями конфигурации. Индекс будет недоступен для векторных запросов, пока перестроение не завершится и его состояние не станет ONLINE.
Оценка требований к памяти
Чтобы оценить память, необходимую для эффективного поиска, мы рассматриваем две часто используемые структуры: квантованные значения векторов и граф HNSW. Бинарное квантование делает значения векторов намного меньше, но не обеспечивает такого же сокращения самой структуры графа HNSW индекса. Следовательно, граф HNSW составляет большую долю общего объема памяти.
В следующем примере оценивается общий объем памяти для одного миллиона 768-мерных эмбеддингов Float32 с использованием HNSW M = 16. Цифры указаны в десятичных МБ и ГБ и не включают дополнительные метаданные и накладные расходы.
Формулы следующие:
- 8-битные скалярно квантованные значения векторов ≈ 4 байта на измерение x количество измерений x количество векторов / 4
- 1-битные бинарно квантованные значения векторов ≈ 4 байта на измерение x количество измерений x количество векторов / 32
скалярно квантованные значения векторов ≈ 3.072 ГБ / 4 = 768 МБ, бинарно квантованные значения векторов ≈ 3.072 ГБ / 32 = 96 МБ
Размер графа HNSW можно оценить следующим образом:
- Размер графа HNSW ≈ 8 байт x количество векторов x HNSW_M
При M = 16 оценочный размер графа HNSW составляет 128 МБ.
В совокупности мы рассчитываем следующие объемы памяти:
- бинарно квантованный индекс с повторным ранжированием: 96 МБ + 128 МБ = 224 МБ
- скалярно квантованный индекс: 768 МБ + 128 МБ = 896 МБ
Это показывает, почему пересчитанные бинарные (1-битные) индексы не уменьшают объем занимаемой памяти в восемь раз по сравнению со скалярными (8-битными) квантованными индексами.
Полное описание конфигурации памяти и требований к дисковому пространству приведено в руководстве по эксплуатации Neo4j. См. «Конфигурация памяти векторного индекса — Руководство по эксплуатации».
Конфигурации Aura, оптимизированные для векторов
Для рабочих нагрузок векторного поиска в Aura мы рекомендуем конфигурацию, оптимизированную для векторов, которая выделяет больше памяти вашего экземпляра для векторных индексов. Мы также рекомендуем выбирать максимально доступный размер диска (1:16), чтобы в полной мере использовать преимущества пересчитанного бинарного формата: его меньший объем памяти позволяет экземпляру эффективно искать по значительно большему количеству векторов, но эти векторы все равно должны помещаться на диске, включая значения полной точности, сохраняемые для пересчета. См. документацию по оптимизации векторов Aura для получения рекомендаций по конфигурации и определению размера.
Улучшения производительности в версии 2026.09
Первоначальный выпуск пересчитанного бинарного формата/HFQ в версии 2026.06 показал себя намного лучше, чем скалярная квантование, но не так хорошо, как мы ожидали. Поэтому в течение последних нескольких месяцев мы углубленно занимались бенчмаркингом векторных индексов. В результате мы значительно улучшили наше понимание и производительность индекса.
На графике ниже показано, как улучшилась производительность с момента первоначального выпуска. Он также сравнивает Neo4j с диапазоном производительности, наблюдаемым в протестированных нами аналогичных реализациях. При использовании графа HNSW и бинарно-квантованных векторов, размещенных в памяти, наши результаты показывают, что Neo4j 2026.09 соответствует этим реализациям или превосходит их на показанных рабочих нагрузках. В предстоящей статье о бенчмаркинге будут подробно описаны методология, конфигурации и результаты.
Заключение
Пересчитанный бинарный формат позволяет практически искать по большему количеству векторов с имеющимся объемом памяти, сохраняя при этом высокую полноту поиска за счет пересчета с полной точностью. Благодаря улучшениям производительности в Neo4j 2026.09, это наша рекомендуемая отправная точка для большинства рабочих нагрузок векторного поиска.
Попробуйте использовать его со своими данными и дайте мне знать, как он работает. Я буду рад получить отзывы о ваших результатах, компромиссах, с которыми вы столкнулись, и о том, что сделало бы векторный поиск в Neo4j более полезным для вас.
Rescored binary vector search in Neo4j: search more with less memory была первоначально опубликована в Neo4j Developer Blog на Medium, где люди продолжают обсуждать эту историю, читая и отвечая на нее.