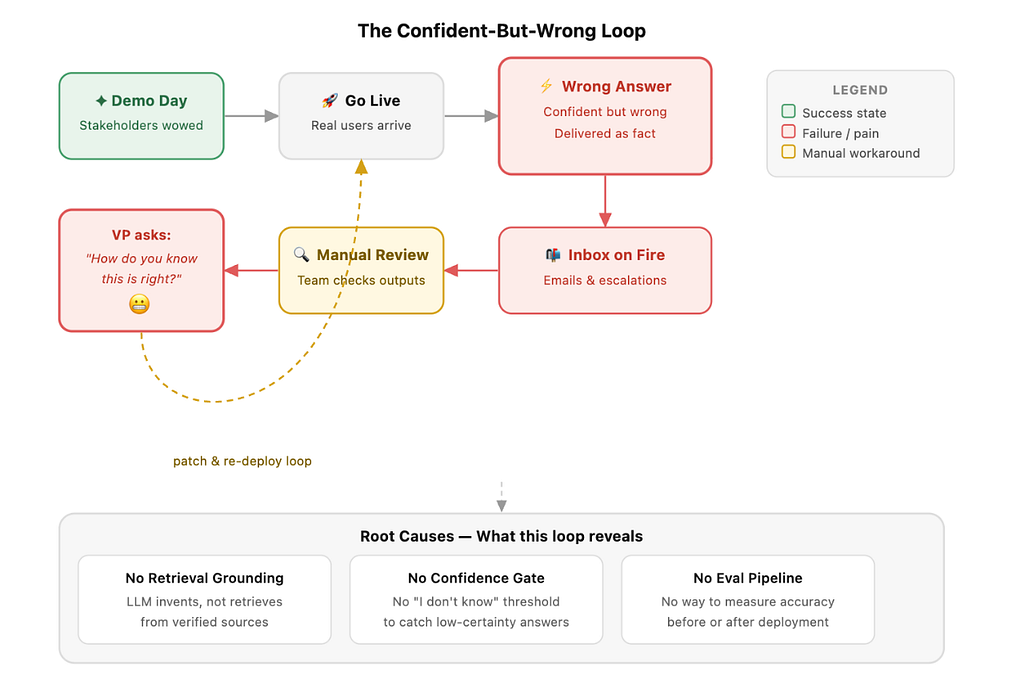
Демонстрация выглядела отлично. Заинтересованные стороны были впечатлены. Затем кто-то задал чат-боту реальный вопрос — и он дал уверенный, но неверный ответ. Теперь вы разгребаете электронную почту, ваша команда вручную проверяет результаты, а вопрос, которого вы боитесь больше всего, — это тот, который постоянно задает ваш вице-президент: «Откуда вы знаете, что это правильно?»
Это проблема контроля. И именно ее мы в Neo4j решили устранить.
Почему важна опора на факты (grounding)
ИИ, который генерирует ответы, не опираясь на проверенные знания, не просто допускает ошибки. Он подрывает доверие пользователей, создает нагрузку в виде ручной проверки и оставляет вас ответственными за ответы, которые вы никак не могли проконтролировать.
Цель состоит в том, чтобы дать модели базу знаний, из которой она может черпать информацию, и создать цикл обратной связи, чтобы вы могли со временем измерять, становится ли она лучше или хуже. Такова архитектура.
Как это работает
Технологический стек Neo4j позволяет объединить возможности рассуждения LLM со структурированными знаниями графовых баз данных для создания систем, предлагающих высокоточные и проверяемые ответы.
В техническом обзоре ниже рассматривается, как Neo4j решает бизнес-задачу внутри своей организации, создавая инфраструктуру генеративного ИИ на базе Neo4j для получения точных и обоснованных ответов.
- Уровень данных (на базе Neo4j Aura): Для обеспечения безопасности, производительности и разделения ответственности архитектура опирается на граф знаний (Knowledge Graph): он выступает в качестве единственного источника истины для агента. Это высокоструктурированная архитектура, содержащая векторы и уровень сущностей, включающий типы сущностей (такие как «Документ», «Продукт», «Уровень цен», «Регион» и «Концепция»). Эта структура позволяет агенту следовать концептуальным связям, а не просто сопоставлять ключевые слова.
- Пакет Neo4j GraphRAG для Python: Библиотека Python, позволяющая создавать приложения GenAI. Она поддерживает создание графа знаний через конвейер, который извлекает сущности из неструктурированного текста, генерирует эмбеддинги и создает граф в Neo4j. Пакет также предоставляет ряд инструментов поиска для графового поиска, векторного поиска, интеграции с векторными базами данных и вызова агентских инструментов.
- Neo4j Needle StarterKit: Neo4j Needle StarterKit 2.1 дает командам готовый фронтенд с самого начала. Он поставляется со встроенным компонентом чат-бота, шаблонами для конкретных доменов и интеграцией с пакетом GraphRAG — так что ваша команда пропускает этап «чистого листа» и тратит время на реальную проблему, а не на техническую обвязку. А поскольку он модульный, вы можете обновлять пользовательский интерфейс независимо от уровня знаний, что сохраняет ту же безопасность итераций, которая пронизывает остальную часть этой архитектуры.
- Фреймворк GenAI Eval: Фреймворк DeepEval, автоматизированный набор тестов, который постоянно запускает вопросы, оцененные экспертами, против работающего бэкенда, чтобы оценивать ответы на предмет правильности, достоверности и качества рассуждений.
1. Трек структурированных данных (верхний уровень)
Этот трек обрабатывает предсказуемые, отформатированные данные (например, CSV, SQL-таблицы или JSON-записи).
- Обработка данных: Структурированные данные проходят фазу извлечения и преобразования (Extract and Transform). Руководствуясь предопределенной схемой графа (которая определяет, как соединяются категории данных), система отображает структурированные данные в узлы и связи.
- Загрузка: Загрузчик данных берет эти преобразованные данные и отправляет их непосредственно в Neo4j Aura.
2. Трек неструктурированных данных (нижний уровень)
Этот трек обрабатывает необработанные, неформатированные данные (например, PDF-файлы, статьи или транскрипты) и использует модели машинного обучения для извлечения смысла.
Фаза 1: Обработка данных и модели
- Разбиение текста (Text Chunker): Разбивает длинные блоки неструктурированного текста на более мелкие, читаемые фрагменты.
- Извлечение сущностей: Использует LLM и схему графа для идентификации конкретных людей, мест, вещей или концепций (сущностей) внутри фрагментов текста и определения того, как они связаны друг с другом.
- Текстовый эмбеддер: Пропускает текст через модель эмбеддингов для преобразования слов в числовые векторы, фиксируя их семантическое значение.
- Примечание: В блоке моделей также есть узел распознавания изображений, что подразумевает, что конвейер может обрабатывать мультимодальные данные, если это необходимо.
Фаза 2: Загрузка
- Числовые векторы отправляются через загрузчик данных в векторное хранилище (которое может быть размещено внутри Neo4j или рядом с ним) для поиска по сходству.
- Извлеченные связи сущностей отправляются в Neo4j для построения структурного графа знаний.
Фаза 3: Постобработка
Как только необработанные данные попадают в граф, они проходят этапы уточнения:
- Разрешение сущностей (Entity Resolver): Идентифицирует дубликаты (например, понимая, что «Neo4j Inc.» и «Neo4j» относятся к одной и той же сущности) и объединяет их.
- Связывание сущностей (Entity Linker): Соединяет недавно извлеченные сущности с существующими узлами в графе, чтобы обеспечить единство сети.
Фаза 4: Валидация
- Валидатор извлечения: Выполняет финальную проверку качества, чтобы гарантировать, что данные, извлеченные LLM, точны, правильно отформатированы в соответствии со схемой и свободны от галлюцинаций перед окончательным сохранением.
Что это значит для дорожной карты вашего приложения: Каждая фаза поставляется независимо и имеет четкую передачу результатов. Вы можете проверить уровень загрузки данных до того, как агент рассуждений будет готов, и итерировать критерии оценки, не блокируя ни один из рабочих потоков. Для TPM, управляющего кросс-функциональной доставкой, это поэтапный план развертывания, а не запуск «большого взрыва».
Что мы построили, а затем перестроили, чтобы улучшить показатели:
Чат-бот версии v1 представлял собой простой конвейер векторного RAG + расширение через граф: эмбеддинг вопроса, извлечение 10 наиболее похожих фрагментов из Neo4j, расширение на 1 переход через графовый запрос и передача их в LLM с промптом, который вежливо просил ее не галлюцинировать. Граф почти не был задействован — поиск выдавал соседние ID сущностей как «голые» строки, без типов связей и контекста сущностей. И, что критически важно, не было никакой оценки: ни тестового набора, ни скоринга, ни способа понять, улучшило ли изменение промпта ситуацию или ухудшило.
Версия V2 (ниже) претерпела 3 архитектурных изменения, объясняющих прирост производительности, и каждое из них соответствует конкретной метрике.
1. Граф знаний, построенный по строгой схеме.
Вместо произвольного извлечения, конвейер загрузки v2 извлекает сущности в соответствии с доменной схемой типов узлов (Продукт, Уровень цен, Функция, Механизм безопасности, Регион, Уровень поддержки) и типов связей (ИМЕЕТ_УРОВЕНЬ, ДОСТУПЕН_НА_УРОВНЕ, СЕРТИФИЦИРОВАН, ОБЕСПЕЧИВАЕТ_БЕЗОПАСНОСТЬ). Каждый извлеченный факт должен соответствовать определенной нами форме, с каноническими значениями, принудительно заданными во время извлечения — «BC», «AuraDB BC» и «Business Critical» — все они разрешаются в один и тот же узел. Эта структурная дисциплина и обеспечивает точность: модель не может смешивать уровни цен или сертификаты безопасности, когда они являются отдельными типизированными узлами.
2. Поиск стал агентским и графо-ориентированным.
В V1 использовалась одна фиксированная стратегия поиска для каждого вопроса. V2 запускает агент ReAct с двумя инструментами на выбор: поисковик «вектор плюс граф», который отслеживает связи от найденных фрагментов (возвращая контекст сущностей, типы связей и исходные документы, а не просто похожий текст), и поисковик Text2Cypher, который преобразует точные вопросы («какие регионы поддерживают X?») в прямые графовые запросы. Общие вопросы получают семантический поиск, основанный на контексте графа; для фактических запросов извлекаются точные ответы из графа. Именно это повысило релевантность и сохранило достоверность на уровне 100% — каждый ответ прослеживается до извлеченного, проверяемого контекста.
3. Оценка стала частью архитектуры, а не второстепенной задачей.
V2 поставляется с набором инструментов для автоматизированной оценки: 80 вопросов, отобранных экспертами и охватывающих реальные категории поддержки (безопасность, ценообразование, разработка, инфраструктура, GenAI), каждый из которых имеет ожидаемый ответ и инструмент поиска, который должен использовать агент. Каждый запуск прогоняет полный набор через работающий бэкенд и оценивает четыре метрики с помощью LLM-судьи: правильность (соответствует ли ответ экспертному?), релевантность ответа, достоверность (подтверждается ли каждое утверждение извлеченным контекстом?) и правильность выбора инструмента (выбрал ли агент верную стратегию поиска?). Результаты попадают в базу данных оценки Neo4j с приложенной полной конфигурацией запуска, поэтому любые два запуска можно сравнить, а панель мониторинга отслеживает тенденции, сбои по конкретным вопросам, стоимость запуска и регрессии.
Архитектура V2 является надежной, поскольку автоматизированный набор тестов запускает вопросы, оцененные экспертами, против работающего бэкенда, оценивая каждый ответ на правильность, достоверность и качество рассуждений. Вы задаете вопросы. Вы устанавливаете стандарты оценки. И вы видите результаты.
Оценка доказывает, что система работает, но именно граф знаний Neo4j выполняет основную тяжелую работу. Заставляя LLM извлекать данные из строгой типизированной схемы, а не из массива необработанных текстовых векторов, мы снизили способность модели к догадкам.
Когда мы внедрили эту архитектуру по сравнению с V1, вот что произошло с нашими метриками и реальным влиянием на работу:
- Частота прохождения/непрохождения: 68,75% → 100% (+31 пункт)
- Правильность: 64,75% → 97,88% (+33 пункта)
- Релевантность: 86% → 97,34% (+11 пунктов)
- Достоверность исходному материалу: 100%
Только за первую неделю система обработала 1500 сообщений пользователей без необходимости ручной проверки. Это тот сигнал принятия, который имеет значение: пользователи доверяли ответам настолько, что продолжали задавать вопросы.
Заключение
Для лица, принимающего решения, выбор Neo4j означает, что вам не нужно создавать систему GraphRAG с нуля. Благодаря AuraDB, пакету GraphRAG Python и Needle StarterKit ваши команды начинают работу с уже настроенной инфраструктурой, что позволяет вам полностью сосредоточиться на качестве данных и внедрении среди пользователей.
Поэтому, когда ваш вице-президент спросит: «Откуда вы знаете, что это правильно?», у вас наконец-то будет архитектурный ответ: «Наша LLM извлекает факты из графа знаний Neo4j, где каждая сущность и связь строго отображены, и мы постоянно доказываем его точность с помощью автоматизированных оценок по стандарту прохождения».
Авторы –
- Морган Сенешаль, главный архитектор профессиональных услуг, Neo4j
- Сумит Топрани, руководитель стратегических программ, Neo4j
AI-приложение, за которое ваша команда действительно может поручиться было первоначально опубликовано в Neo4j Developer Blog на Medium, где люди продолжают обсуждение, рассказывая эту историю.