Оптимизация секционирования графа для импорта на основе воркеров и алгоритма k-1 раскраски.
Эта статья является обобщением подхода, разработанного Эриком Монком в его статье «Mix and batch: a technique for fast, parallel relationship loading in Neo4j». В ней объясняются теоретические основы и идеи. В следующей статье будет показано практическое применение и предоставлен репозиторий с исходным кодом.
Mix and batch: a technique for fast, parallel relationship loading in Neo4j – Neo4j Graph Intelligence Platform
Его подход использует последние цифры идентификаторов исходных и целевых узлов для создания непересекающихся разделов, а затем группирует полученные ячейки матрицы вдоль циклических диагоналей в последовательные пакеты, которые можно загружать параллельно без одновременного доступа к одним и тем же наборам узлов. У этого подхода есть два основных ограничения:
- Получение разделов из последних цифр ID узлов не позволяет адаптировать количество разделов к доступным воркерам;
- Диагональное пакетирование небезопасно, когда исходные и целевые узлы не являются непересекающимися (например, если вы создаете отношения между узлами Person).
Вот почему мы предлагаем следующие улучшения для преодоления предыдущих ограничений:
- Вычисление разделов на основе количества воркеров с использованием хеш-функции;
- Новая функция для импорта отношений, где исходные и целевые узлы принадлежат одному и тому же набору (то есть они не являются непересекающимися);
- Использование алгоритма K-1 раскраски для вычисления пакетов разделов, которые можно импортировать параллельно.
Вычисление разделов
Как правило, при загрузке данных пакетами существуют одна таблица для узлов и одна таблица для отношений. Этот шаг состоит в вычислении нового столбца (называемого export_part) для этих таблиц.
Как правило, при загрузке данных пакетами существуют одна таблица для узлов и одна таблица для отношений. Этот шаг состоит в вычислении нового столбца (называемого export_part) для этих таблиц.
Вместо использования последней части идентификатора узла, как в оригинальной статье, можно использовать элегантный метод, предложенный Матье Эплени, в котором разделы ваших исходных таблиц вычисляются по приведенной ниже формуле.
Для оптимального импорта значение partition_count равно количеству воркеров сервера, выделенных для импорта данных. Это обеспечивает достаточный объем независимой работы для загрузки пула воркеров без жесткого кодирования границ разделов в исходных данных.
Для узлов
SQL-выражение в Snowflake принимает вид:
Если partition_count = 5, таблица узлов содержит до 5 значений разделов, от 0 до 4.
Для отношений
SQL-выражение в Snowflake принимает вид:
Если partition_count = 5, таблица отношений содержит до 5²=25 значений разделов, от 0 – 0 до 4 – 4.
Этот метод является детерминированным и гарантирует получение непересекающихся разделов. Однако он не гарантирует, что разделы будут одинакового размера, так как это зависит от структуры данных.
Теперь необходимо ответить на вопрос: какие разделы мы можем импортировать параллельно?
Теперь необходимо ответить на вопрос: какие разделы мы можем импортировать параллельно?
Импорт узлов
Для таблиц узлов это тривиально, так как будет загружаться один раздел на воркер. Следовательно, все разделы будут импортироваться одновременно.
Импорт отношений
Для таблиц отношений все немного сложнее, так как это зависит от того, являются ли исходные и целевые узлы непересекающимися или пересекающимися.
Для этого нам нужно построить квадратную матрицу размером, равным количеству разделов; в нашем примере это 5.
Это позволит нам узнать, какие разделы можно импортировать параллельно, и максимально эффективно использовать воркеры.
Между непересекающимися узлами
Диагональный метод, используемый в «Mix and batch: a technique for fast, parallel relationship loading in Neo4j», хорошо работает, когда исходные и целевые узлы не принадлежат одному и тому же набору. Действительно, после вычисления разделов мы можем создать матрицу, в которой каждая ячейка содержит раздел. Каждая диагональ матрицы соответствует пакету разделов, которые можно загружать параллельно.
Каждый цвет представляет пакет, содержащий разделы, которые можно импортировать параллельно без взаимных блокировок и конкуренции за ресурсы.
Например, разделы D3 можно импортировать параллельно без взаимных блокировок или конкуренции за ресурсы, как показано на следующем изображении:
Код на Python
Наборы исходных и целевых узлов не пересекаются, и каждый набор разделен на ``partition_count`` разделов. Их комбинации образуют квадратную матрицу, содержащую ``partition_count ** 2`` пар разделов «источник-цель».
Функция делит эту матрицу на ``partition_count`` циклических диагоналей. Каждая циклическая диагональ представляет собой пакет разделов, которые можно обрабатывать параллельно. Внутри пакета каждый исходный раздел и каждый целевой раздел появляются ровно один раз, предотвращая одновременный доступ параллельных задач к одному и тому же разделу.
Аргументы: partition_count: Количество разделов в каждом наборе узлов.
Возвращает: Список параллельных пакетов. Каждый пакет представляет собой циклическую диагональ и содержит пары разделов в формате ``"source - target"``. """ return [ [ f"{(diagonal_index + target_partition) % partition_count}" f" - {target_partition}" for target_partition in range(partition_count) ] for diagonal_index in range(partition_count) ]
Между пересекающимися узлами
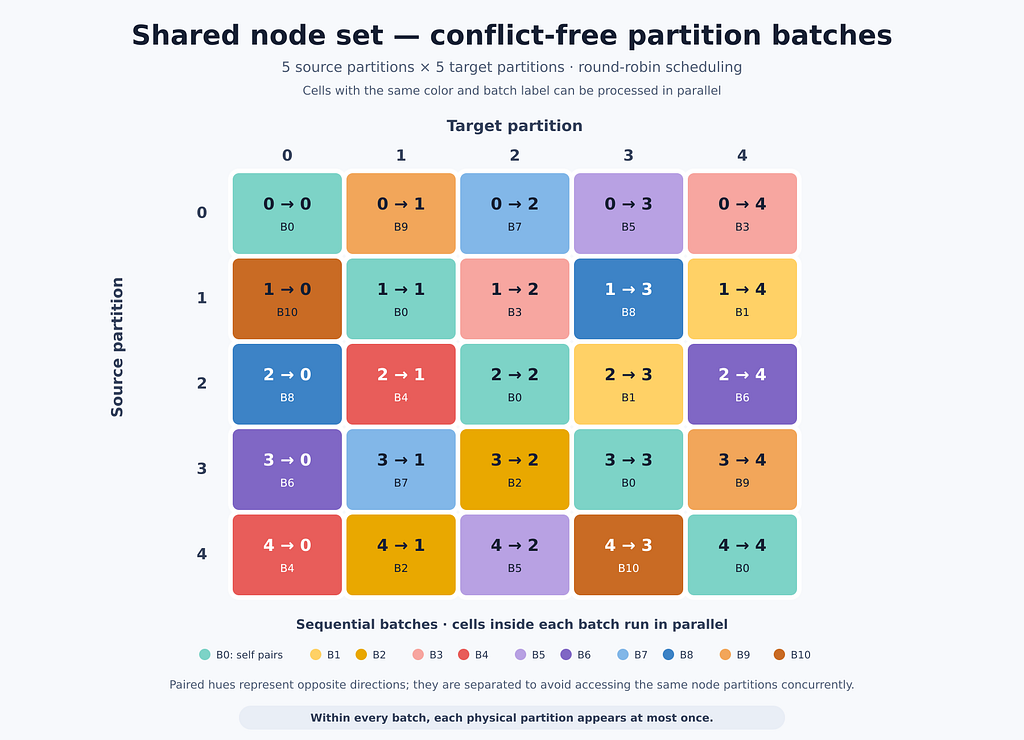
Однако, если вы хотите импортировать отношения между узлами, принадлежащими одному и тому же набору, вы получите ошибки взаимной блокировки. Вот почему нам нужна другая функция, определенная ниже, для обработки этого случая с использованием циклического алгоритма (round-robin).
Здесь также каждый цвет представляет пакет разделов, которые можно импортировать параллельно без взаимных блокировок или конкуренции за ресурсы. Единственное отличие заключается в уменьшенном количестве разделов на пакет, что подразумевает меньше шагов обработки, чем для пакетов, созданных диагональной функцией.
Например, разделы B5 можно импортировать параллельно без взаимных блокировок или конкуренции за ресурсы, как показано на следующем изображении:
Код на Python
Исходные и целевые узлы принадлежат одному и тому же набору узлов, который разделен на ``partition_count`` разделов. Их комбинации образуют квадратную матрицу, содержащую ``partition_count ** 2`` пар разделов «источник-цель».
Каждый пакет содержит пары, которые не разделяют ни одного раздела. Следовательно, все пары в одном пакете можно обрабатывать параллельно без одновременного доступа к одному и тому же разделу узлов.
Пакеты генерируются с использованием циклического алгоритма (round-robin). Прямые и обратные пары помещаются в отдельные пакеты, поскольку они обращаются к одним и тем же разделам.
Аргументы: partition_count: Количество разделов в наборе узлов.
Возвращает: Список параллельных пакетов, содержащих пары разделов в формате ``"source - target"``. """ # Самоссылающиеся пары используют отдельные разделы и поэтому могут # обрабатываться вместе. batches = [ [ f"{partition} - {partition}" for partition in range(partition_count) ] ]
partitions = list(range(partition_count))
# Для циклического сопряжения требуется четное количество значений. Для нечетного количества # разделов None представляет раздел, который отдыхает во время раунда. if partition_count % 2: partitions.append(None)
# Оставляем один раздел фиксированным, вращая все остальные вокруг него. # Фиксированный раздел выступает в качестве якоря и предотвращает повторное создание одних и тех же пар при вращении. fixed_partition = partitions[0] rotating_partitions = partitions[1:]
# Фиксация одного значения и вращение остальных значений позволяет создать # каждую возможную неупорядоченную пару разделов ровно один раз. for _ in range(len(partitions) - 1): current_partitions = [ fixed_partition, # Распаковка вращающихся разделов для формирования текущего раунда пар. *rotating_partitions ]
# Соединяем значения, расположенные в противоположных позициях в текущем раунде. # Каждый реальный раздел может появиться не более чем в одной паре. pairs = [ (current_partitions[index], current_partitions[-1 - index]) for index in range(len(current_partitions) // 2) if current_partitions[index] is not None and current_partitions[-1 - index] is not None ]
# Прямые пары не имеют общих физических разделов и поэтому могут # обрабатываться параллельно. batches.append([ f"{source_partition} - {target_partition}" for source_partition, target_partition in pairs ])
# Обратные пары должны быть помещены в отдельный пакет, поскольку они используют # те же физические разделы, что и соответствующие им прямые пары. batches.append([ f"{target_partition} - {source_partition}" for source_partition, target_partition in pairs ])
# Вращаем все разделы, кроме фиксированного якоря. Последний вращающийся # раздел перемещается в начало для следующего раунда. rotating_partitions = [ rotating_partitions[-1], *rotating_partitions[:-1], ]
return batches
Таким образом, импорт связей пакетами с использованием разделов, вычисленных с помощью этих функций, помогает избежать взаимоблокировок и конфликтов блокировок.
Универсальная функция с использованием алгоритма K-1 Coloring
Ранее мы использовали две функции Python для определения того, какие разделы можно импортировать параллельно. Они были разработаны для вычисления оптимальных пакетов разделов из матрицы (поскольку связь создается между двумя узлами). Теперь представьте, что вам нужно вычислить пакеты разделов из более сложного графа, такого как симплициальный комплекс. Это граф высокого уровня, где связи могут соединять x узлов.
Здесь вы можете использовать алгоритм K-1 Coloring из библиотеки Neo4j Graph Data Science для вычисления пакетов разделов. Мы моделируем каждую пару разделов «источник-цель» как узел и соединяем два узла, когда их связь загружает хотя бы один общий раздел узла. K-1 coloring присваивает разные цвета соседним узлам, позволяя каждой цветовой группе сформировать параллельный пакет без конфликтов (при условии, что алгоритм сошелся), в то время как разные цветовые группы обрабатываются последовательно.
Поскольку алгоритм не является детерминированным, у вас будет рабочее решение, но оно не будет оптимальным (с точки зрения скорости в нашем контексте).
Поскольку алгоритм не является детерминированным, у вас будет рабочее решение, но оно не будет оптимальным (с точки зрения скорости в нашем контексте).
Чтобы проиллюстрировать это, следующие запросы Cypher создают предыдущую матрицу разделов и применяют алгоритм K-1 Coloring для вычисления пакетов разделов.
Запросы для очистки
// Удаление узловMATCH (n:Partition)CALL (n) { DELETE n} IN TRANSACTIONS OF 1000 ROWSFINISH;
Создание графа
// Запрос для создания сетки узловWITH $grid AS gridUNWIND range(0, grid - 1) AS sourcePartitionUNWIND range(0, grid - 1) AS targetPartitionCALL (grid, sourcePartition, targetPartition) { MERGE (p:Partition { grid: grid , id: toString(sourcePartition) + "-" + toString(targetPartition) }) SET p.sourcePartition = sourcePartition , p.targetPartition = targetPartition}FINISH;
// Запрос для создания связей между разделамиMATCH (a:Partition {grid: $grid})MATCH (b:Partition {grid: $grid})WHERE a < bCALL (a, b) { // Когда узлы не являются непересекающимися (исходный и целевой узлы принадлежат одному и тому же набору) WITH a, b WHERE a.sourcePartition = b.sourcePartition OR a.sourcePartition = b.targetPartition OR a.targetPartition = b.sourcePartition OR a.targetPartition = b.targetPartition MERGE (a)-[r:SHARES_PARTITION_NOT_DISJOINT]->(b) UNION // Когда узлы являются непересекающимися (исходный и целевой узлы принадлежат разным наборам) WITH a, b WHERE a.sourcePartition = b.sourcePartition OR a.targetPartition = b.targetPartition MERGE (a)-[r:SHARES_PARTITION_DISJOINT]->(b)}FINISH;
Запуск K-1 Coloring
// Запуск алгоритма K-1 Coloring (потоковый режим)CALL gds.k1coloring.stream('grid', {maxIterations: 100, concurrency: 4})YIELD nodeId, colorRETURN color, collect(gds.util.asNode(nodeId).id) AS partitions;
// Удаление проекции графа из памятиCALL gds.graph.drop('grid', false)YIELD graphNameRETURN graphName;
Результирующие пакеты, когда узлы являются непересекающимися (табличный и графический вид):
Результирующие пакеты, когда узлы не являются непересекающимися (табличный и графический вид):
Как видите, решения, предоставляемые K-1 Coloring, не так оптимальны, как решения, полученные с помощью функций Python. Тем не менее, это предлагает эффективную альтернативу в сложных случаях распараллеливания.
Каждый цвет представляет собой пакет разделов, которые можно импортировать параллельно. Например, с цветом 2 один рабочий будет импортировать связи, где раздел равен 0 – 2, в то время как другой рабочий будет импортировать связи, где раздел равен 4 – 4.
Заключение
В заключение, в этой статье предлагается универсальное и оптимальное решение для секционирования ваших таблиц данных (представляющих узлы и связи), а затем вычисления пакетов разделов, которые можно импортировать в Neo4j параллельно без взаимоблокировок или конфликтов блокировок.
Эта статья применима к случаям, когда узлы и связи импортируются пакетами с использованием любых драйверов.
Наслаждайтесь миром без взаимоблокировок и конфликтов блокировок во время импорта!
Massive Parallel Imports in Neo4j Without Deadlock and Lock Contention была первоначально опубликована в Neo4j Developer Blog на Medium, где люди продолжают обсуждение, рассказывая об этой истории.