Основные выводы
Кластер HGX B300 состоит из одного или нескольких узлов, каждый из которых оснащен восемью графическими процессорами Blackwell Ultra с 288 ГБ памяти HBM3e (всего 2,30 ТБ на узел) на базе NVLink-фабрики с пропускной способностью 14,4 ТБ/с, а также двумя отдельными сетевыми фабриками и плоскостью управления. На этой странице собраны все необходимые данные для масштабирования — от объема памяти GPU до количества узлов плоскости управления — в виде единой таблицы.
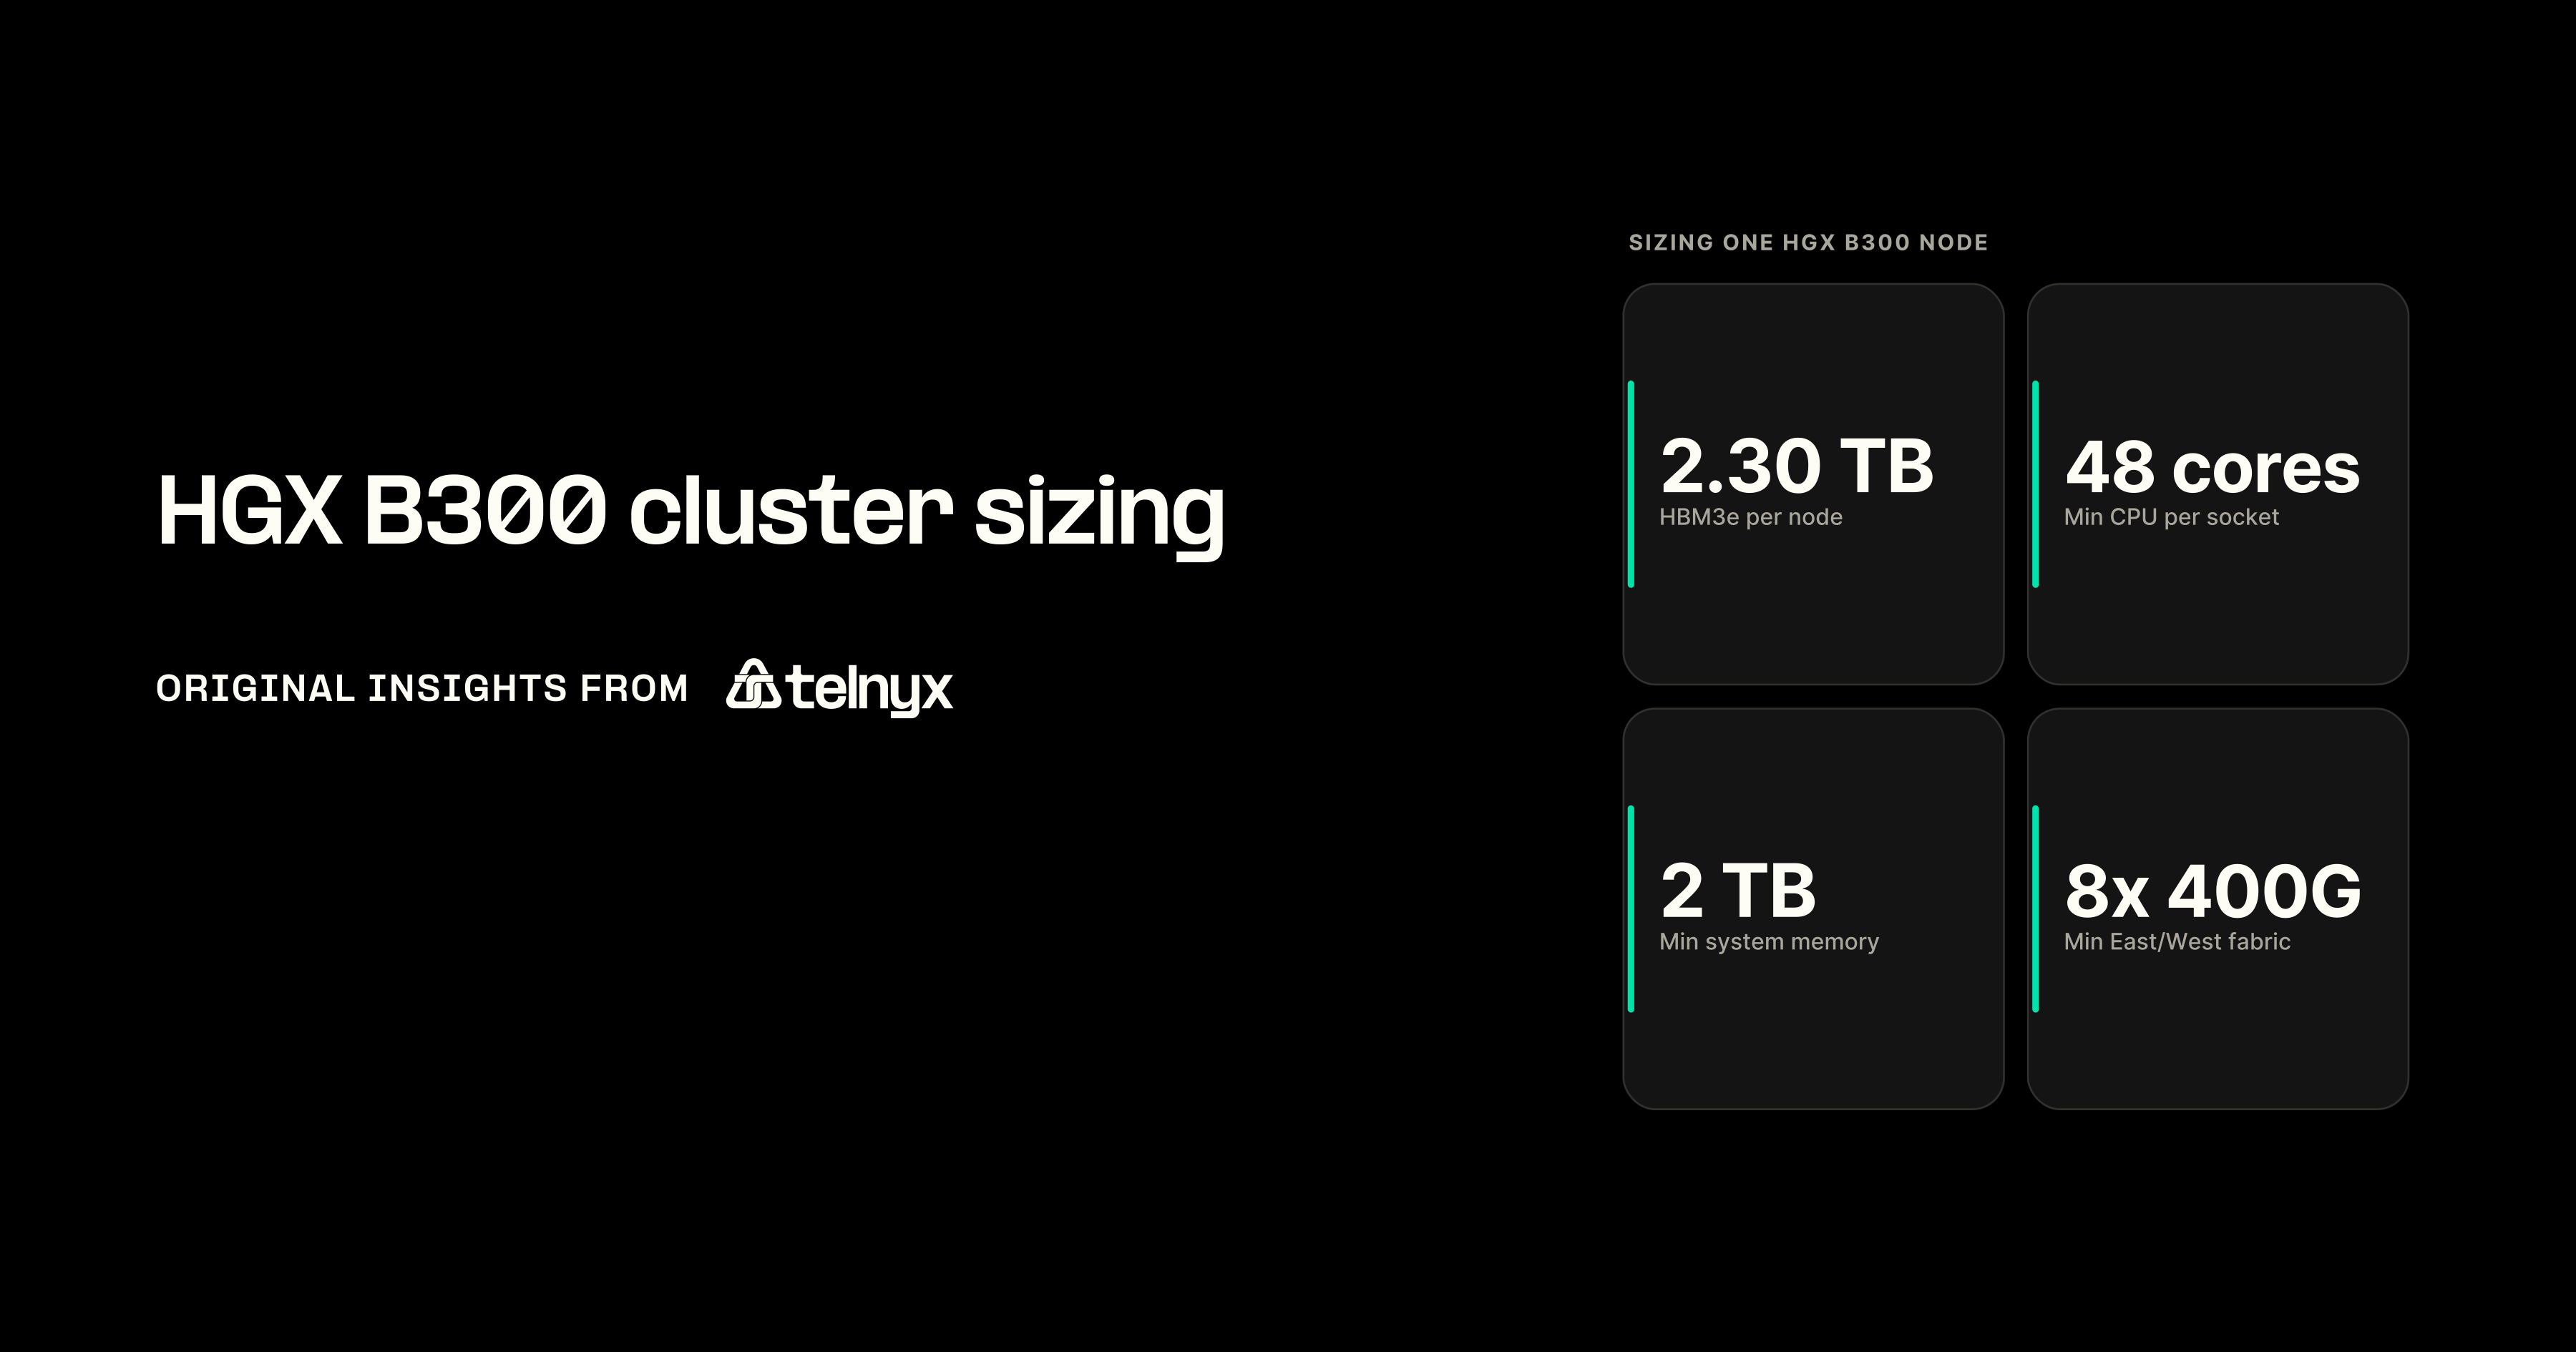
- Согласно эталонной архитектуре NVIDIA, каждый узел должен иметь не менее 48 физических ядер CPU на сокет, 2 ТБ системной памяти и загрузочный NVMe-накопитель объемом 1 ТБ.
- Предусматривается создание двух фабрик: вычислительной сети «восток-запад» с пропускной способностью не менее 8x 400 Гбит/с на узел и сети «север-юг» для хранения данных и управления через один DPU BlueField-3 на сервер.
- Спецификации, в которых указано 2,1 ТБ или NVL16, описывают одну и ту же восьмипроцессорную плату. NVL16 учитывает кристаллы GPU вместо корпусов GPU, а 2,1 ТБ — это консервативный показатель полезного объема.
Что такое кластер GPU NVIDIA HGX B300?
Кластер GPU NVIDIA HGX B300 — это набор сертифицированных NVIDIA серверов, каждый из которых построен на одной базовой плате HGX B300 и объединен сетью Ethernet или InfiniBand, что позволяет выполнять одну задачу на множестве узлов.
Какой узел GPU выбрать для вашей рабочей нагрузки по инференсу?
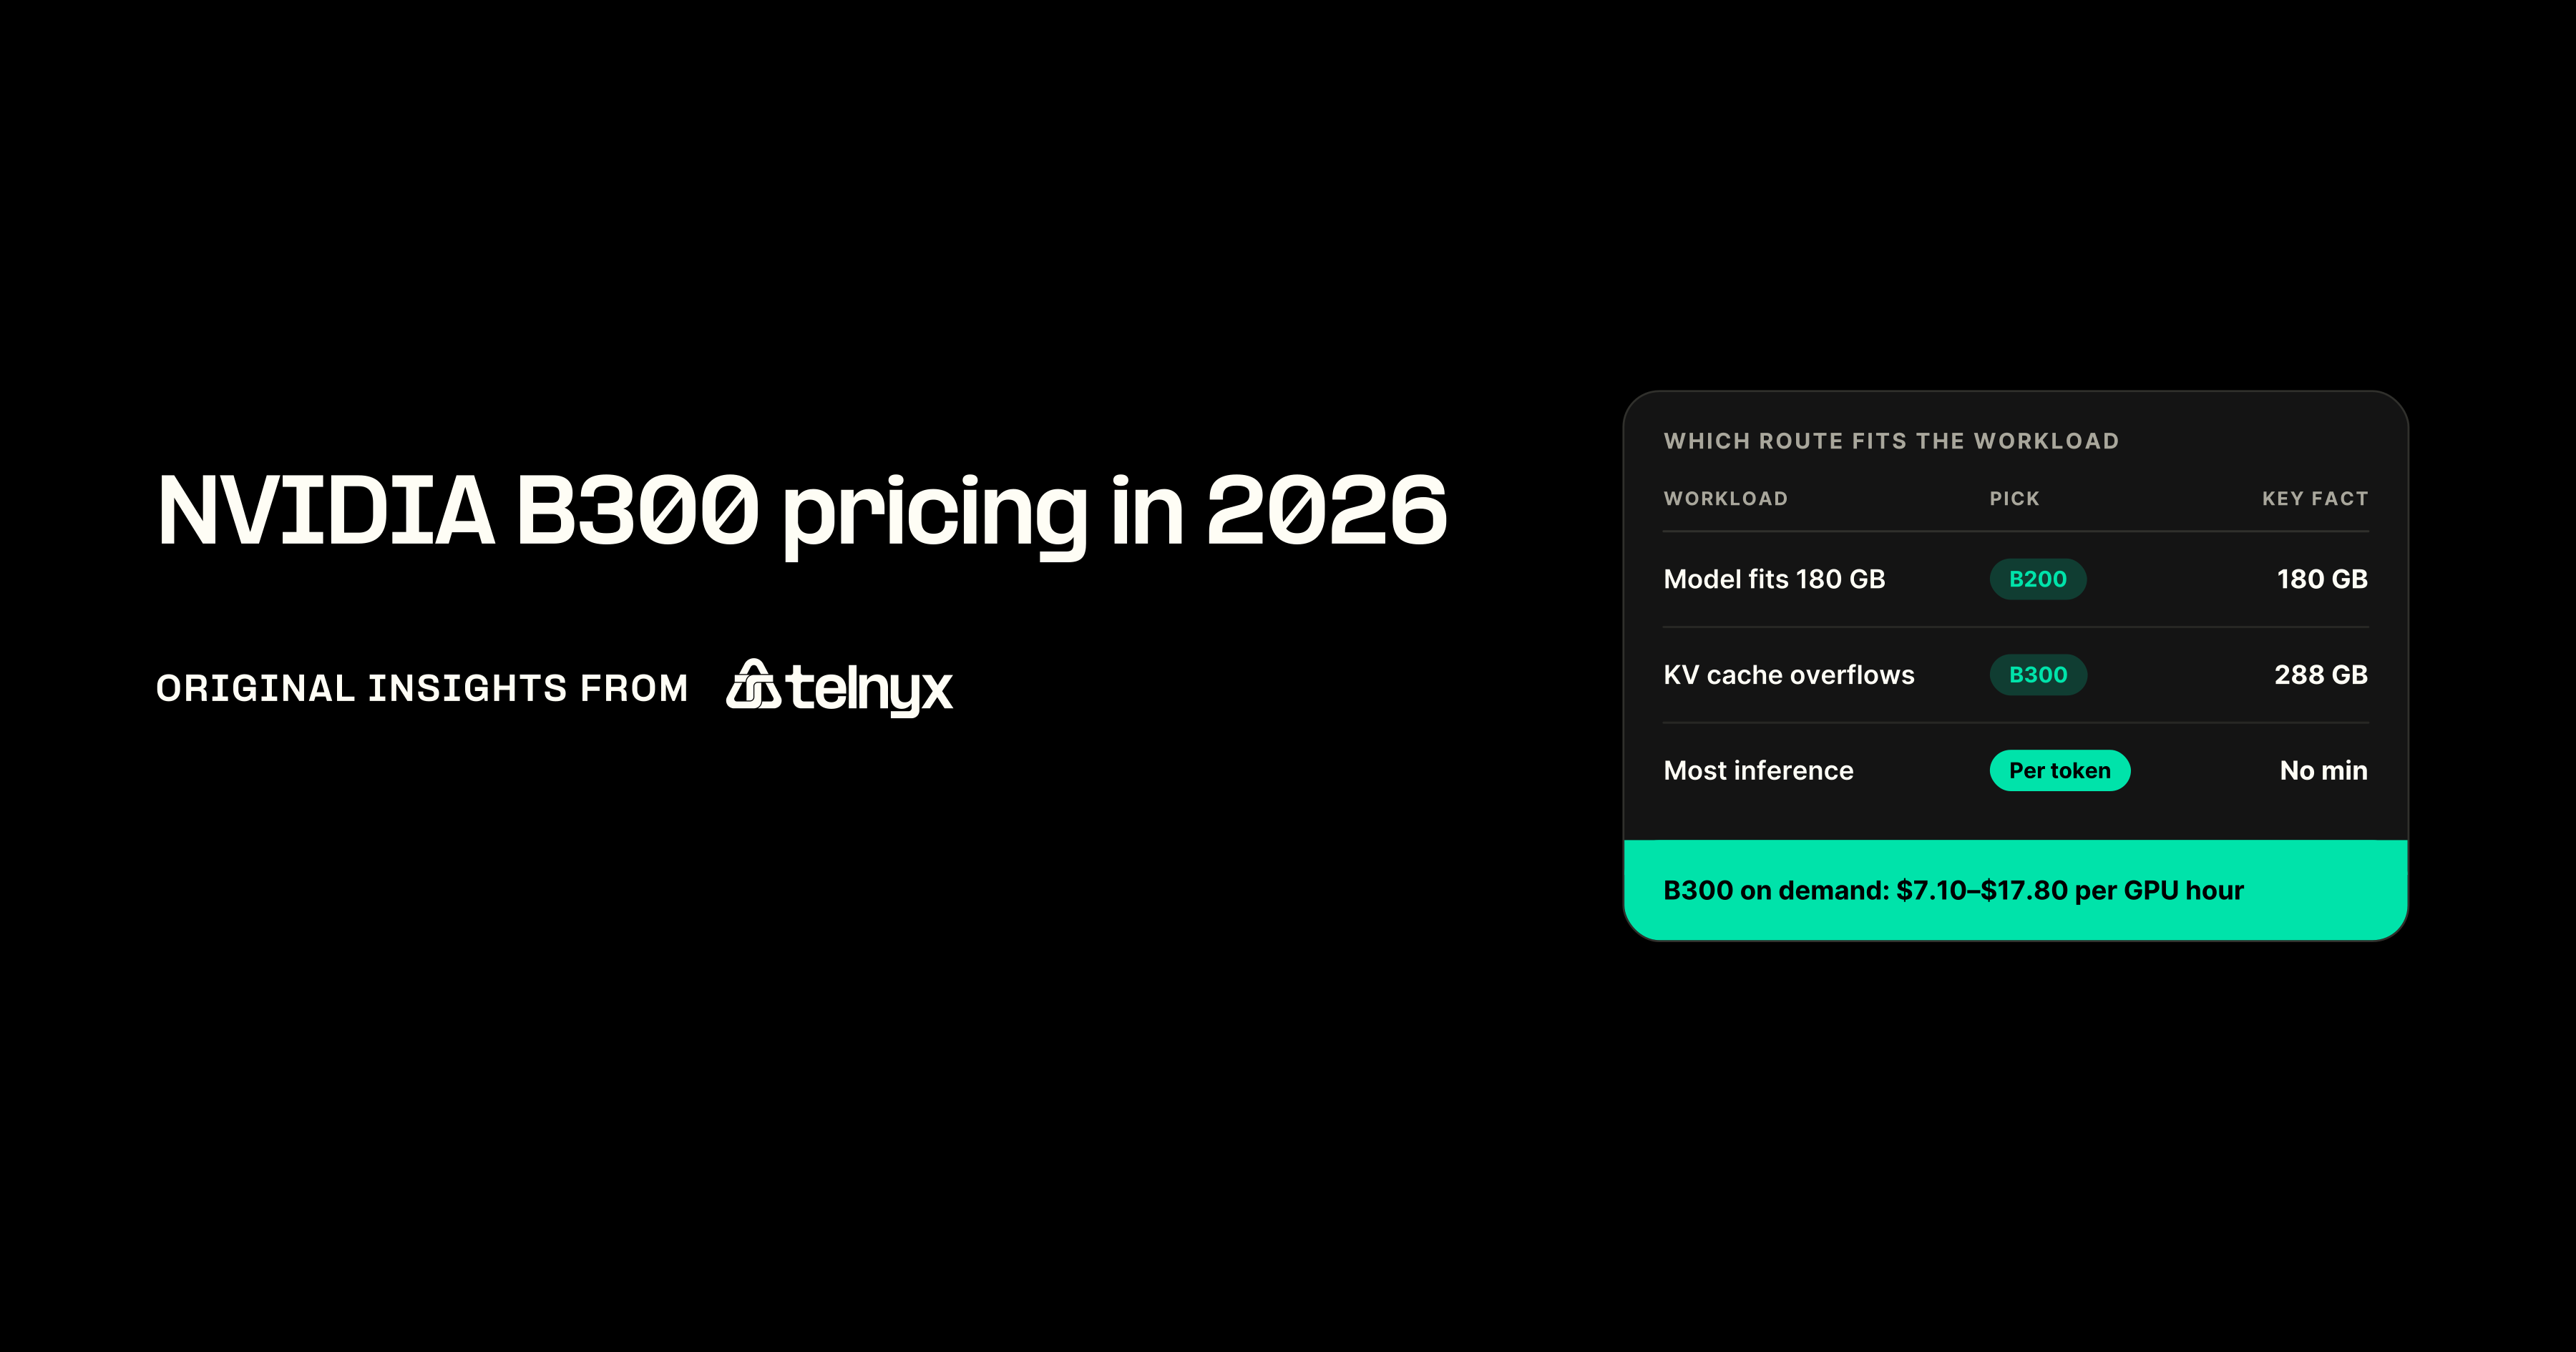
- Если модель вместе с KV-кэшем превышает 180 ГБ на GPU: выбирайте узлы HGX B300. 288 ГБ на GPU и 2,30 ТБ на узел позволяют хранить веса и кэш в памяти без выгрузки.
- Если модель помещается, а узким местом является скорость токенов: оставайтесь на B200. Он достигает той же пиковой пропускной способности 8 ТБ/с, что и B300, поэтому дополнительная память почти не увеличивает скорость.
- На H200 длинные контексты вытесняются в хост-память: переходите на B300. Память на GPU увеличивается со 141 ГБ до 288 ГБ, а пропускная способность — с 4,80 ТБ/с до 8 ТБ/с.
- Хотите инференс без развертывания кластера: используйте Telnyx Inference. Он работает на GPU, принадлежащих Telnyx, которые размещены в той же сети, поэтому данные остаются в пределах региона.
Если вы работали с узлами H100 или H200, вы уже знаете, где они достигают предела. Длинные контексты и высокая конкурентность заполняют память GPU KV-кэшем, и как только кэш вытесняется в хост-память или сетевое хранилище, целевой показатель задержки перестает соблюдаться. B300 поднимает этот потолок. Большая часть модели и KV-кэша остается в памяти GPU, поэтому инференс с длинным контекстом и высокой конкурентностью может выполняться без выгрузки.
Что находится на базовой плате HGX B300
Базовая плата — это фиксированная часть каждого узла. Независимо от того, какой OEM-производитель собирает ваш сервер, эти пять показателей из эталонной архитектуры NVIDIA остаются неизменными:
- GPU: восемь графических процессоров Blackwell Ultra SXM, каждый с 288 ГБ памяти HBM3e.
- Память на узел: 2,30 ТБ HBM3e (2304 ГБ) с пропускной способностью памяти до 8 ТБ/с на GPU.
- NVLink: NVLink и NVSwitch пятого поколения с совокупной пропускной способностью 14,4 ТБ/с и 1800 ГБ/с между GPU.
- Сеть: восемь плат ConnectX-8 SuperNIC на плате, по одной на каждый GPU, со скоростью 800 Гбит/с (2 x 400 Гбит/с) каждая.
- Вычисления: до 144 петафлопс на базовую плату.
SuperNIC — это компонент, который больше всего влияет на вашу сборку. В предыдущих поколениях HGX вы покупали и устанавливали вычислительные сетевые карты самостоятельно. В B300 они поставляются на базовой плате в соотношении 1:1 (GPU к NIC), что определяет количество портов «восток-запад» еще до того, как вы откроете каталог коммутаторов.
Как HGX B300 соотносится с H200 и B200
B300 — это прежде всего обновление памяти. Узел H200 содержит 141 ГБ на GPU и 1,1 ТБ на узел при пропускной способности HBM 4,80 ТБ/с на GPU. Узел B200 содержит 180 ГБ на GPU и 1,44 ТБ на узел при скорости до 8 ТБ/с. Узел B300 содержит 288 ГБ на GPU и 2,30 ТБ на узел, также при скорости до 8 ТБ/с.
Прочитайте эти цифры вместе, и логика покупки станет простой. Переход с B200 на B300 дает вам на 60% больше памяти на GPU при той же пиковой пропускной способности памяти. Если ваше узкое место — размещение модели и ее KV-кэша, B300 решает эту проблему. Если ваше узкое место — скорость потоковой передачи токенов из памяти, B200 работает в том же диапазоне. Наша статья о сети GPU для инференса объясняет, почему пропускная способность памяти часто определяет темп генерации токенов.
Прочитайте о запуске GPU в Дубае, чтобы узнать, как Telnyx выполняет инференс на собственных GPU, размещенных в своей сети, чтобы данные оставались в пределах региона.
Почему поставщики указывают 2,1 ТБ, 2,30 ТБ, NVL16 и восемь GPU для одной и той же платы
Три страницы об одной и той же базовой плате могут содержать противоречивые данные о памяти, количестве GPU и поколении PCIe. Ни одна из них не описывает разное оборудование.
Чтение противоречивых спецификаций B300: эталонная архитектура NVIDIA указывает 2304 ГБ (2,30 ТБ) на узел. Некоторые материалы OEM указывают 2,1 ТБ на систему, а как минимум один — 270 ГБ на GPU. Разница возникает из-за единиц измерения и зарезервированной памяти: 2304 ГБ — это примерно 2,1 ТБ в двоичных терабайтах. Планируйте емкость исходя из 2,1 ТБ, а 2304 ГБ считайте потолком. NVL16 учитывает 16 кристаллов GPU, связанных через NVLink, по два на корпус в восьми модулях SXM, поэтому NVL16 и «восемь GPU» — это одна и та же плата. Для планирования слотов PCIe следуйте эталонной архитектуре: восемь линий Gen5 x16 на базовую плату и одна линия Gen5 x16 на DPU или адаптер.
То же предостережение относится к заявлениям о производительности. Показатели ускорения NVIDIA для B300 — это значения «до», полученные в оптимизированных тестах. Относитесь к ним как к потолку и тестируйте свою собственную модель при своей длине контекста, прежде чем планировать масштабирование на их основе.
Свяжитесь с нашим отделом продаж, чтобы рассчитать ваш кластер HGX B300, от объема памяти GPU до количества узлов плоскости управления.
Как создать или приобрести кластер HGX B300?
Вы масштабируете кластер HGX B300 по пяти уровням: хост вокруг каждой базовой платы, вычислительная фабрика «восток-запад», фабрика хранения «север-юг», плоскость управления и инфраструктура объекта. Таблица ниже представляет собой лист масштабирования, составленный на основе минимумов и рекомендаций эталонной архитектуры NVIDIA.
Лист масштабирования кластера HGX B300
Масштабирование хоста для каждого узла HGX B300
Задача хоста — обеспечивать работу восьми GPU. Каждый узел HGX B300 требует не менее 48 физических ядер CPU на сокет с базовой частотой 2,0 ГГц (рекомендуется 56), а также не менее 2 ТБ системной памяти с пропускной способностью 500 ГБ/с. NVIDIA требует, чтобы эта память была равномерно распределена по сокетам и полностью заполнена на каждом канале памяти, так как несбалансированная компоновка замедляет работу GPU на одной стороне платы.
Локальное хранилище зависит от задачи. Планируйте загрузочный NVMe-накопитель объемом 1 ТБ, затем 1 ТБ NVMe на сокет CPU для серверов инференса и HPC или 2 ТБ на сокет для серверов обучения. Добавьте модуль TPM 2.0 для безопасной загрузки и один DPU BlueField-3 на сервер.
Две фабрики: вычислительная «восток-запад» и хранилище «север-юг»
Две фабрики передают разный трафик, поэтому их масштабируют отдельно. «Восток-запад» передает коллективные операции между узлами во время обучения и дообучения на нескольких узлах. «Север-юг» передает все остальное: оркестрацию, удаленное хранилище, доступ пользователей и интернет-трафик.
Сеть «восток-запад» работает через восемь встроенных плат ConnectX-8 SuperNIC. Минимум составляет 8x 400 Гбит/с на узел, рекомендуется 16x 400 Гбит/с с использованием разветвления (breakout).
Пропускная способность «восток-запад» в одной единице: NVIDIA указывает минимум как «400 ГБ/с (8x 400 Гбит/с Ethernet NIC)». Оба варианта описывают один и тот же бюджет канала, один раз в байтах, другой — в битах. В терминах портов коммутатора это восемь портов по 400 Гбит/с на узел, или 3,2 Тбит/с. Рекомендуемая конфигурация — шестнадцать портов по 400 Гбит/с, или 6,4 Тбит/с. Считайте порты коммутатора в Гбит/с, умножайте на количество узлов и добавляйте ваши аплинки.
Трафик North/South проходит через DPU BlueField-3. NVIDIA рекомендует использовать B3240 с двухпортовым 400GbE вместо B3220, применяемого в системах H100, H200 и B200. Причина — инференс. Распределенный инференс, который выгружает KV-кэш в сетевое хранилище, требует более высокой пиковой пропускной способности ввода-вывода на GPU, чем типичное обучение. Также проверьте бюджет мощности: некоторые конфигурации BlueField-3 потребляют более 75 Вт и требуют дополнительного разъема питания PCIe мощностью не менее 75 Вт.
Что касается выбора между InfiniBand и Ethernet, в эталонной архитектуре NVIDIA задокументирован дизайн Spectrum-X Ethernet. InfiniBand по-прежнему оправдан там, где коллективная хвостовая задержка (tail latency) доминирует в очень крупных задачах обучения. Ethernet имеет смысл, когда вы хотите использовать единую модель управления для вычислений и хранения данных, а также иметь более широкий выбор поставщиков коммутаторов.
Узлы плоскости управления для кластера HGX B300
Плоскость управления запускает программное обеспечение, которое планирует задачи и управляет кластером. Эталонный дизайн поддерживает до восьми узлов плоскости управления. Пример NVIDIA с использованием Base Command Manager, Slurm и Kubernetes требует семи:
- Base Command Manager: два узла, настроенные для обеспечения высокой доступности.
- Slurm: два головных узла.
- Kubernetes: три узла плоскости управления.
Каждый узел плоскости управления в этом примере имеет два 32-ядерных процессора (Intel Xeon Gold 6448Y или AMD EPYC 9354), не менее 256 ГБ памяти DDR5, загрузочный NVMe-накопитель объемом 1 ТБ, 4 ТБ локальной NVMe-памяти и DPU BlueField-3 B3220. Если в вашей среде еще нет плоскости управления, NVIDIA рекомендует использовать один комплект с высокой доступностью на кластер.
Питание, охлаждение и плотность размещения в стойке
Охлаждение определяет, сколько GPU поместится в стойку. Система HGX B300 высотой 8U с воздушным охлаждением от Supermicro вмещает до четырех систем на стойку, или 32 GPU и 9,2 ТБ HBM3e. Ее liquid-cooled 4U system вмещает до 64 GPU в стандартную 19-дюймовую стойку, или 18,4 ТБ HBM3e. Supermicro оценивает TDP каждого GPU B300 в 1100 Вт, поэтому жидкостное охлаждение удваивает плотность, а не просто добавляет запас по мощности.
Местоположение кластера так же важно, как и способ его охлаждения. Для рабочих нагрузок в реальном времени расстояние между GPU и запросом добавляет задержку, которую не устранит ни одна спецификация. Именно поэтому Telnyx размещает GPU в своих точках присутствия (PoP), как в случае с развертыванием GPU в Сиднее.
Чего нет ни в одной публичной спецификации: общая потребляемая мощность узла в кВт при постоянной нагрузке, стоимость одного GPU-часа и сроки поставки. TDP GPU публикуется, но процессоры, DPU, NVMe, вентиляторы и насосы увеличивают общую мощность узла. Потребуйте от своего OEM-производителя и поставщика все три цифры в письменном виде, прежде чем подписывать договор.
Когда кластер HGX B300 — неудачная покупка
Кластер B300 — неудачная покупка, если память не является вашим ограничением. Если ваша модель вместе с KV-кэшем помещается в 180 ГБ на GPU при целевой длине контекста, узел B200 обеспечит вам ту же пиковую пропускную способность памяти за меньшие деньги. То же самое касается небольших моделей, умеренных размеров пакетов и легкой донастройки (fine-tuning), где дополнительные 108 ГБ на GPU будут простаивать.
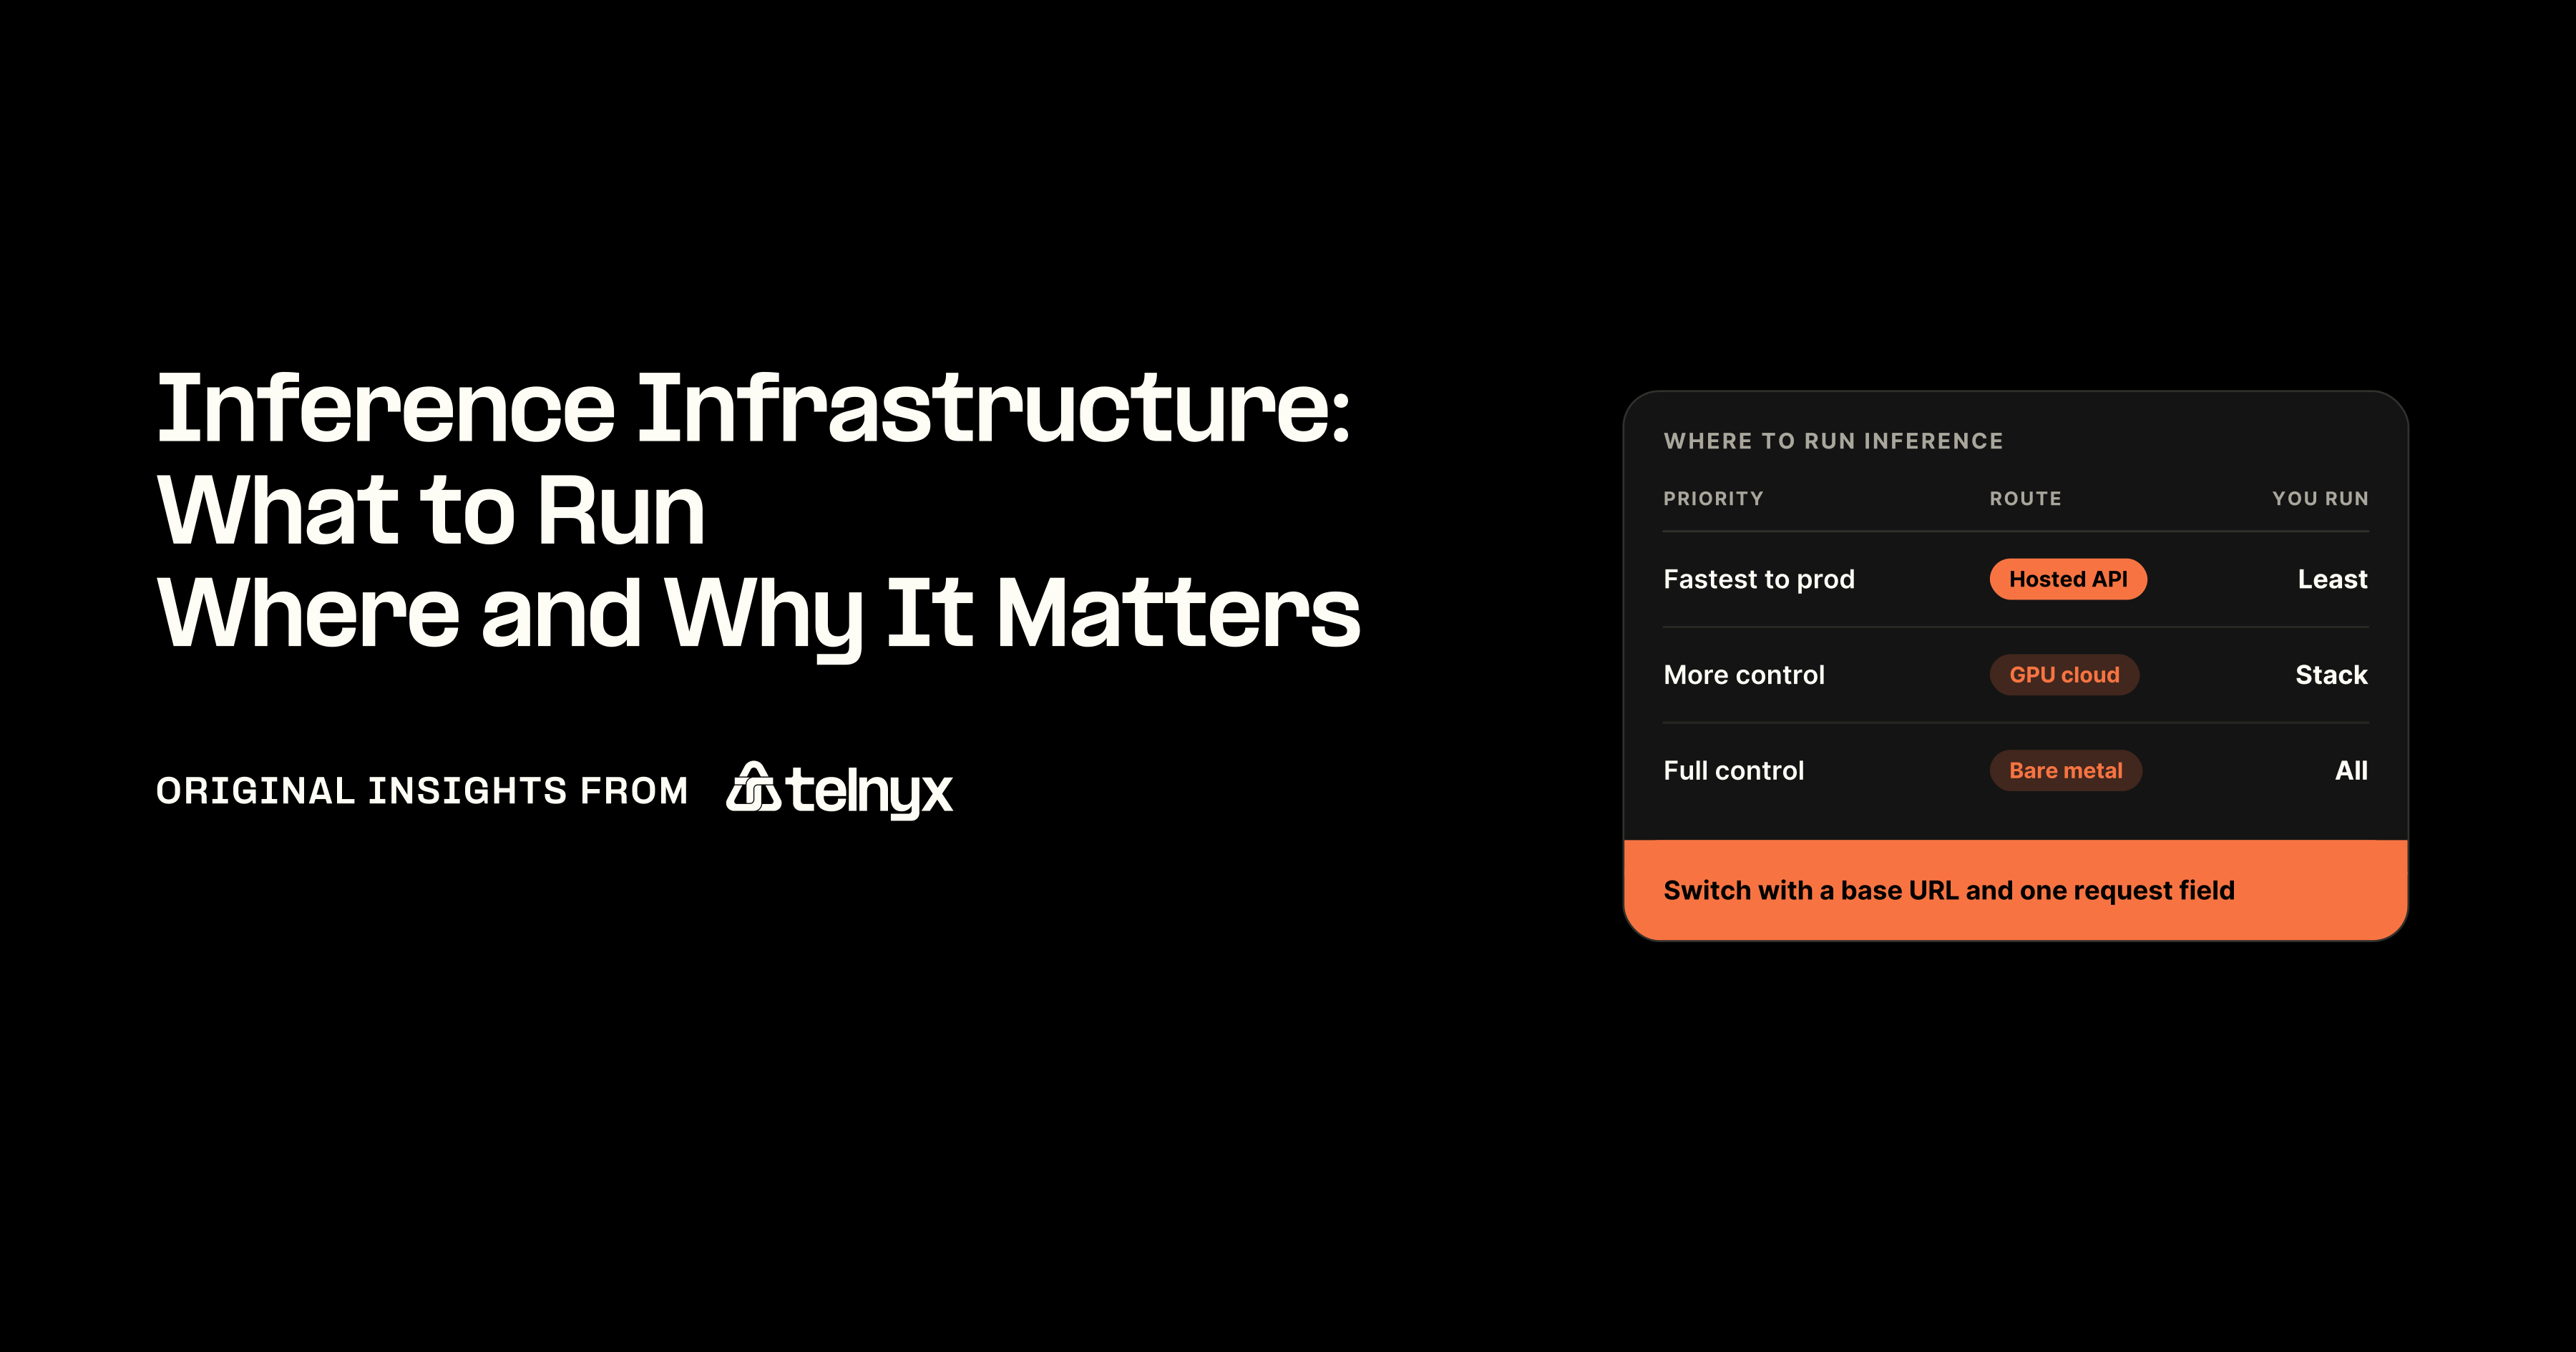
Это также неудачная покупка, если вам вообще не нужно владеть кластером. Если ваша цель — обслуживание моделей с открытыми весами, а не их обучение, Telnyx Inference запускает модели через API, совместимый с OpenAI, на GPU, принадлежащих Telnyx, без необходимости закупки оборудования. Если вы все еще сравниваете семейства ускорителей, наше руководство по сравнению TPU и GPU поможет понять, что и когда лучше подходит.
Часто задаваемые вопросы
В чем разница между HGX B300 и DGX B300?
HGX B300 — это базовая плата, которую OEM-производители, такие как Supermicro и ASUS, встраивают в свои серверы, самостоятельно выбирая процессоры, память, хранилище и корпус. DGX B300 — это собственная предварительно собранная и протестированная система NVIDIA. Обе используют восемь GPU Blackwell Ultra. Выбирайте HGX, если хотите сами подобрать конфигурацию хоста и поставщика, и DGX, если вам нужна готовая сертифицированная система от NVIDIA.
Что выбрать для кластера: B300 или B200?
Выбирайте B300, если узким местом является память. Он содержит 288 ГБ на GPU против 180 ГБ у B200 при той же пиковой пропускной способности до 8 ТБ/с. Если ваша модель и KV-кэш помещаются в 180 ГБ на GPU при целевой длине контекста и уровне параллелизма, узел B200 обеспечит аналогичную пропускную способность токенов за меньшую цену.
Почему HGX B300 в одних спецификациях указан как NVL16, а в других — как восемь GPU?
Оба названия описывают одну и ту же плату. NVL16 учитывает вычислительные кристаллы, соединенные через NVLink: восемь модулей SXM, каждый из которых содержит двухкристальный GPU Blackwell Ultra, что в сумме дает шестнадцать кристаллов. «Восемь GPU» — это количество корпусов (пакетов). При планировании памяти, сети и слотов ориентируйтесь на восемь GPU, так как соотношение сетевых карт и показатели памяти указываются на каждый пакет.
Требуется ли жидкостное охлаждение для кластера HGX B300?
Нет. Существуют системы HGX B300 высотой 8U с воздушным охлаждением, и Supermicro размещает до четырех таких систем в стойке, что дает 32 GPU. Жидкостное охлаждение удваивает это число до 64 GPU в стандартной 19-дюймовой стойке. Поскольку TDP каждого GPU составляет до 1100 Вт, выбор сводится к тому, сколько места в стойке и какой мощностью охлаждения объекта вы располагаете.
Какие ошибки при развертывании HGX B300 встречаются чаще всего?
Обычно это расчет коммутаторов East/West исходя из маркировки 400 ГБ/с без пересчета в порты 400 Гбит/с, повторное использование DPU B3220 от старых узлов, неравномерное распределение системной памяти по сокетам и пропуск дополнительного разъема питания, который нужен некоторым картам BlueField-3. Регулируемым организациям, создающим ИИ для здравоохранения, также следует спланировать изоляцию и резидентность данных до выбора площадки.
Рассчитайте параметры кластера, а затем обсудите с нами емкость GPU
Теперь у вас есть лист расчета для кластера HGX B300, от памяти GPU до узлов плоскости управления. Приходите к нашей команде, чтобы обсудить доступность GPU на инфраструктуре, принадлежащей Telnyx.
Связаться с нашей командой