Основные выводы
Инфраструктура вывода — это уровень обслуживания, который превращает обученную модель в работающий сервис: ускорители, движок обслуживания, сетевой путь к пользователю, автоматическое масштабирование и API перед ним. Решения, влияющие на задержку и стоимость, зависят от того, где размещен GPU для каждой рабочей нагрузки и на каком уровне обслуживания она работает, что важнее, чем то, какой кластер арендует команда.
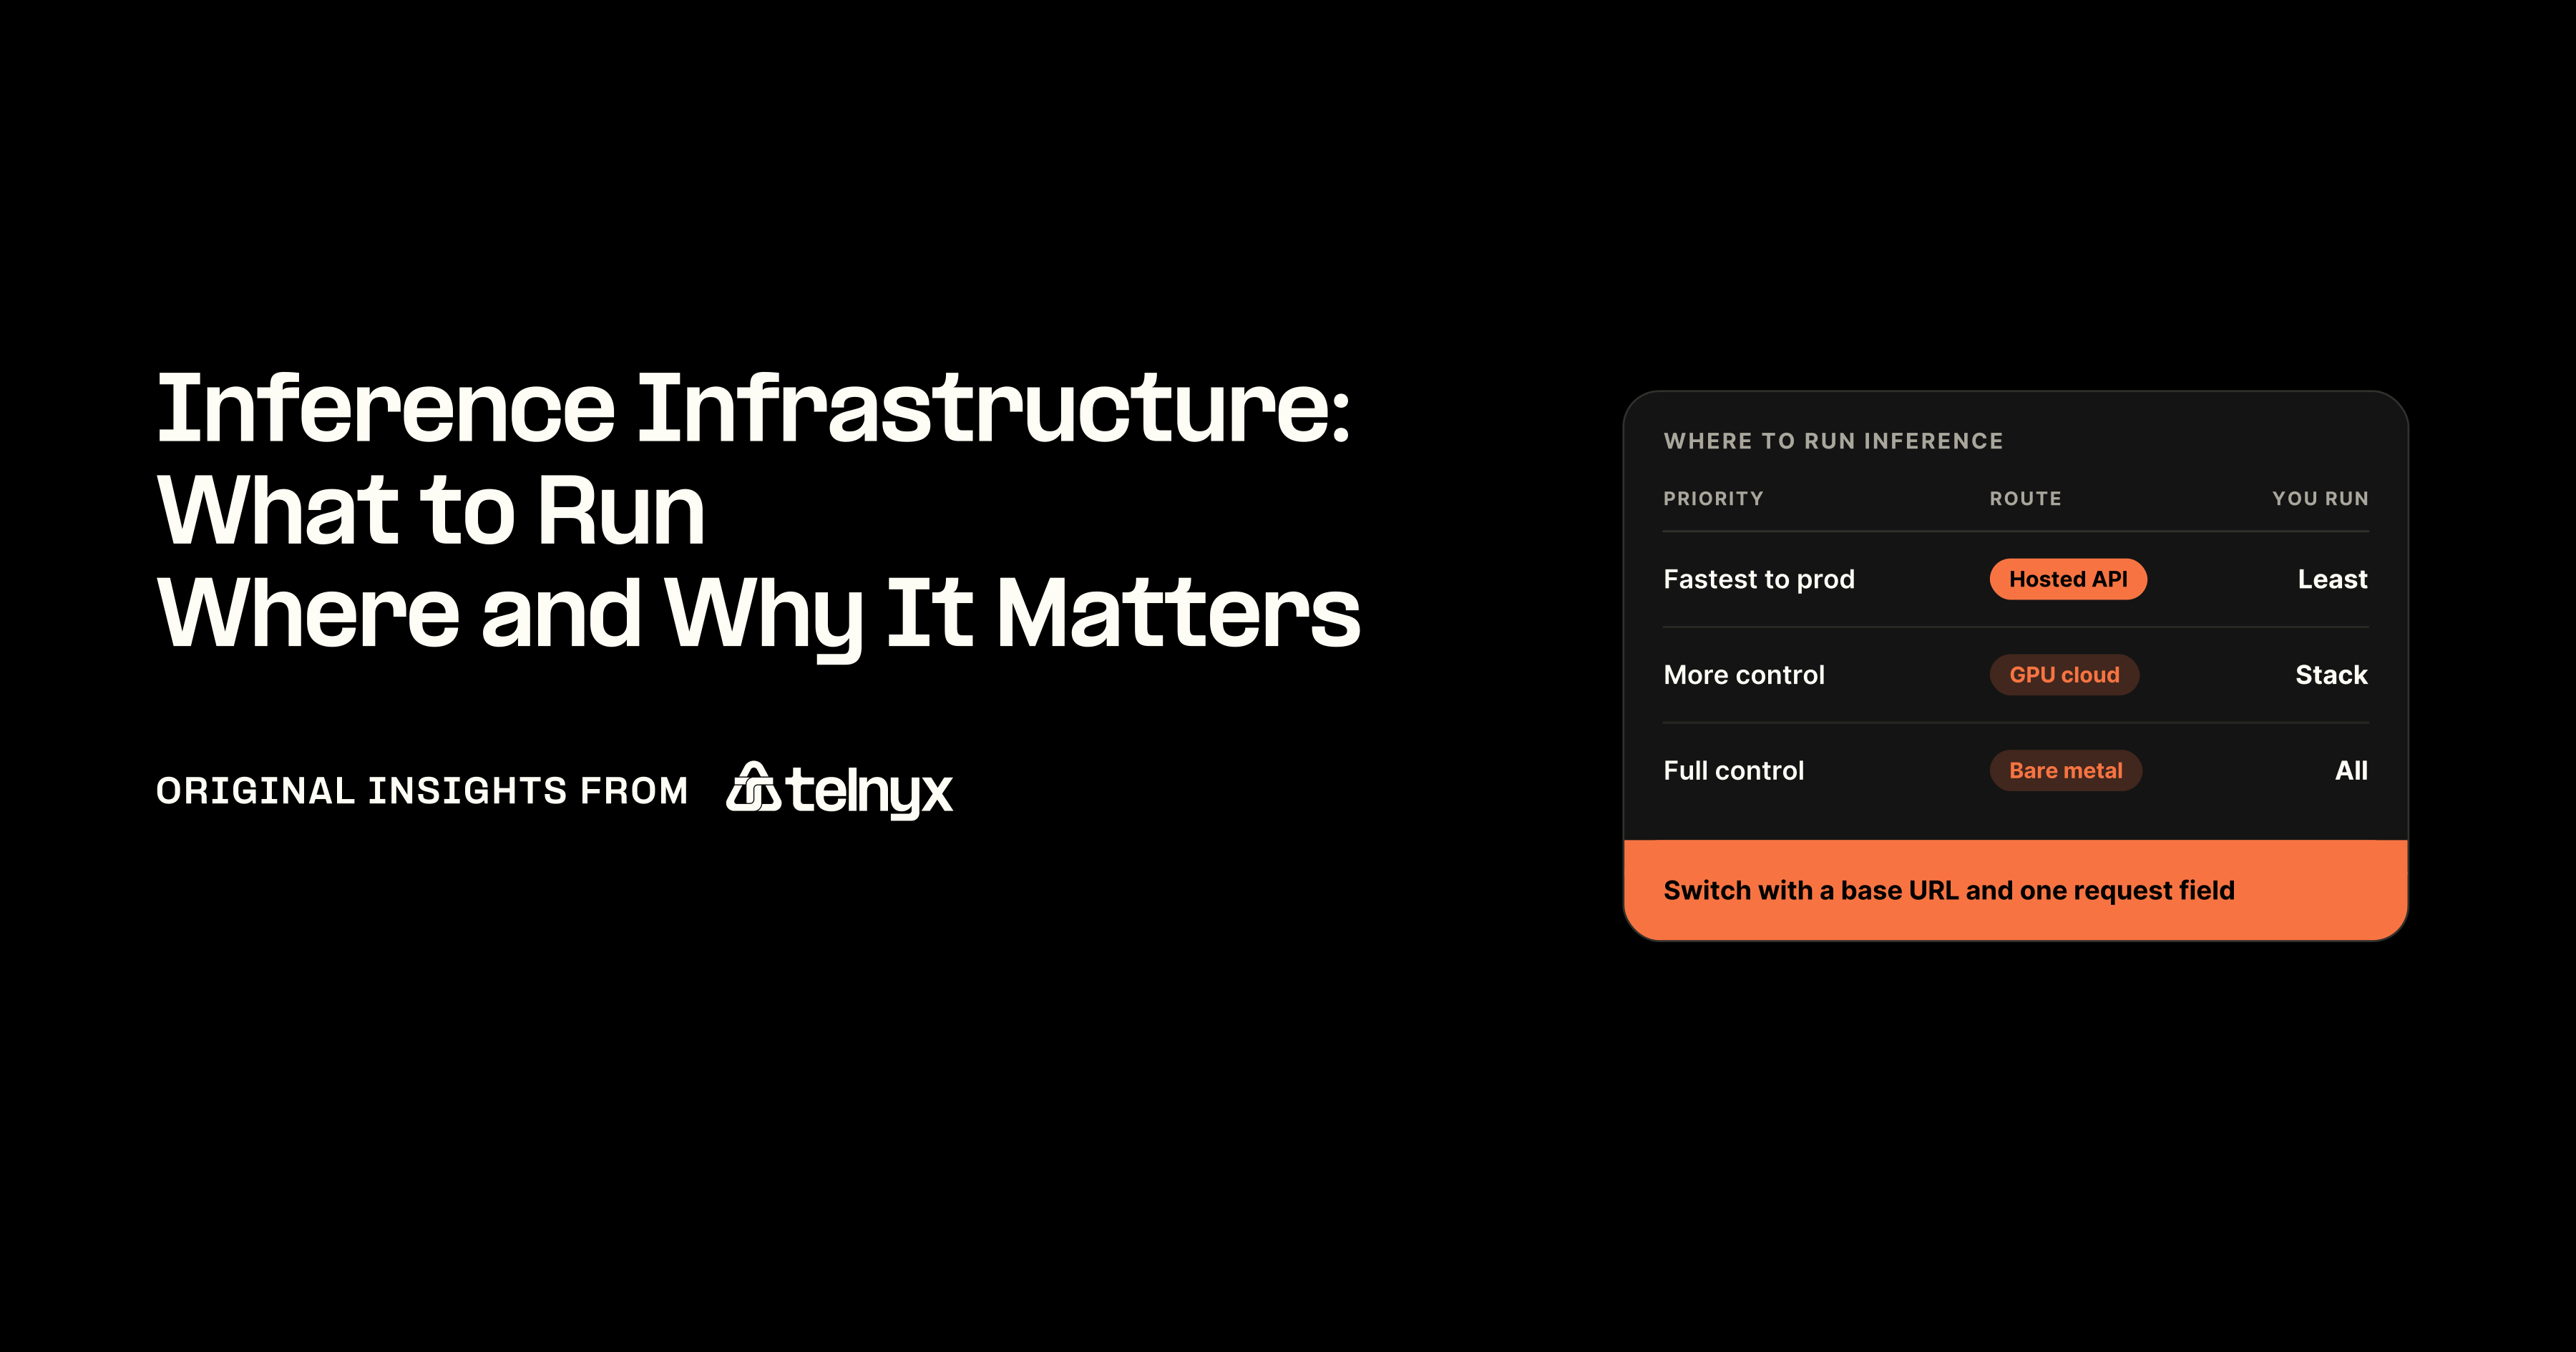
- У команд есть три реалистичных пути: размещенный API вывода на GPU провайдера (самый быстрый путь к продакшену, минимум операций), облако GPU от гиперскейлера (больше контроля, плюс лимиты квот и необходимость обслуживать стек) или самостоятельное управление «железом» (полный контроль и полная операционная нагрузка).
- Задержка — это бюджет, состоящий из сетевого обмена данными, постановки в очередь, времени до получения первого токена и декодирования. Сетевой переход — это часть, которую большинство бенчмарков никогда не измеряют.
- Размещенный API с GPU в том же регионе и уровнями обслуживания для каждого запроса позволяет команде изменить базовый URL и одно поле запроса вместо найма целой платформенной команды.
Вывод — это прямой проход, который превращает новые входные данные в выходные: промпт поступает на вход, токены выходят. Инфраструктура вывода — это все, что заставляет этот проход отвечать на живой запрос быстро, надежно и с предсказуемой стоимостью, от GPU, на котором работает модель, до API, к которому обращается ваше приложение.
Обучение, дообучение, вывод и обслуживание
Обучение создает веса модели в рамках крупной задачи, которая в конечном итоге завершается. Дообучение адаптирует эти веса к более узкой задаче, также в виде ограниченной по времени задачи. Вывод и обслуживание никогда не заканчиваются, пока пользователи продолжают отправлять запросы, поэтому емкость должна следовать за спросом пользователей, а не за графиком проекта.
Это единственное различие объясняет большинство решений по инфраструктуре вывода ИИ. Система рассчитывается на пики, которые никто не может запланировать, оценивается по задержке и стоимости за токен и поддерживается в рабочем состоянии бесконечно.
Слои между GPU и ответом
Каждый запрос на вывод проходит через пять слоев в следующем порядке:
- Ускоритель и память: GPU хранит веса модели и KV-кэш, который сохраняет промежуточные результаты внимания для каждого активного запроса.
- Движок обслуживания: программное обеспечение, такое как vLLM, TensorRT-LLM или Triton, объединяет запросы в пакеты и управляет памятью KV-кэша. В документации vLLM рассматриваются непрерывная пакетная обработка, кэширование префиксов и PagedAttention, а наш разбор движков вывода прослеживает происхождение этих технологий.
- Сетевой путь: маршрут между GPU и пользователем, включая каждую границу провайдера, которую пересекает запрос.
- Автомасштабирование: логика, которая добавляет и удаляет емкость по мере изменения трафика.
- API: конечная точка, аутентификация и формат запроса, от которых зависит ваш код.
Вывод больших языковых моделей также проходит в две фазы. Prefill обрабатывает весь промпт и создает первый токен. Затем Decode генерирует каждый последующий токен по одному, и каждая метрика задержки далее в этой статье зависит от этого разделения.
Telnyx Inference — это один полный экземпляр этого стека. Это совместимый с OpenAI API вывода, который запускает курируемую библиотеку моделей с открытыми весами на GPU, принадлежащих Telnyx, без хранения данных и необходимости для клиента управлять инфраструктурой.
Попробуйте Telnyx Inference для обслуживания моделей на региональных GPU с уровнями обслуживания для каждого запроса через размещенный API.
Сравнение лучших решений для инфраструктуры вывода ИИ
Существует три реалистичных пути для запуска вывода в продакшене, и они различаются главным образом тем, кто управляет каждым слоем стека выше.
Какой путь вывода подходит моей команде?
- Скачкообразный трафик, стандартная модель с открытыми весами: используйте Telnyx Inference и платите за токен. Емкость масштабируется от 0 до тысяч запросов в секунду, без минимумов и платы за аренду GPU.
- Регулируемые данные, пользователи за пределами США: используйте Telnyx Inference в регионе пользователя. GPU работают в Северной и Южной Америке, Европе, на Ближнем Востоке и в Азиатско-Тихоокеанском регионе без хранения данных.
- Модель с проприетарными правами, которую планируют вывести из эксплуатации: переходите на Telnyx Inference и измените базовый URL. Модели с открытыми весами за API, совместимым с OpenAI, стоят до 75% меньше за токен.
- Собственное дообучение, есть платформенная команда: арендуйте GPU у гиперскейлера и запускайте vLLM или TensorRT-LLM самостоятельно. Вы получаете контроль, но наследуете лимиты квот на GPU и необходимость обслуживать стек.
- Необходимо владеть каждым слоем, есть соответствующий операционный персонал: выбирайте самостоятельное управление «железом». Вы контролируете ускорители, сетевой путь и автомасштабирование, а также несете полную операционную нагрузку по всем пяти слоям.
Размещенные API вывода на GPU провайдера
Размещенный API вывода — это путь, который большинство команд уже используют, обычно с проприетарным поставщиком моделей. Приложение отправляет HTTP-запрос и получает токены обратно, а провайдер управляет каждым слоем под ним. Удобство очевидно. Риск заключается в дорожной карте модели поставщика: когда проприетарная модель выводится из эксплуатации, у каждой команды, использующей ее, появляется крайний срок.
Размещенный API, обслуживающий модели с открытыми весами, сохраняет удобство и снижает этот риск, поскольку форма API остается стандартной, а модели не привязаны к одной лаборатории. В Telnyx цена за токен до 75% ниже, чем у проприетарных альтернатив, нет минимумов, а также нет платы за аренду GPU или дополнительных сборов за вычисления. Емкость автоматически масштабируется от 0 до тысяч запросов в секунду, а вывод выполняется в регионах Северной и Южной Америки, Европы, Ближнего Востока и Азиатско-Тихоокеанского региона без хранения данных.
Этот путь также подходит для команд, которые сохраняют собственную оркестрацию. Они могут вызывать конечную точку размещенной LLM наряду с конечными точками преобразования речи в текст и текста в речь, не заменяя платформу, которую они уже используют.
Облака GPU от гиперскейлеров и управляемый Kubernetes
Второй путь — аренда экземпляров GPU или использование управляемого сервиса Kubernetes от крупного облачного провайдера и запуск движка обслуживания поверх него. Команда получает контроль над выбором модели, настройками пакетной обработки и топологией развертывания.
Это также влечет за собой работу: запрос квот на GPU, выбор типов экземпляров, управление движком обслуживания и оплата простаивающих мощностей почти по той же ставке, что и занятых. Путь от выделенных GPU до первого запроса в продакшене требует реального инженерного времени, а сетевой путь все равно проходит от облачного региона до того места, где находится пользователь.
Самостоятельное управление «железом»
Третий путь — владение или прямая аренда оборудования. Он предлагает полный контроль над каждым слоем и самую низкую удельную стоимость при высокой и стабильной загрузке.
Цена этого — команда владеет всем: подготовкой кластера, жизненным циклом Kubernetes, драйверами GPU, высокопроизводительной сетью, хранилищем моделей, автомасштабированием и обновлениями. Руководство Kubernetes по планированию GPU в Kubernetes показывает только начальную точку: установите драйверы поставщика на каждый узел, запустите плагин устройства и запрашивайте GPU как планируемый ресурс.
Лучшая ИИ-инфраструктура для быстрого вывода: куда уходят миллисекунды
Один запрос на вывод тратит время в шести местах, и размещение GPU меняет лишь некоторые из них.
Бюджет сквозной задержки
Каждый запрос проходит через одну и ту же последовательность:
- Сетевой обмен данными от клиента к API
- Очередь, пока провайдер объединяет запросы в пакеты
- Prefill, который заканчивается временем до первого токена (TTFT)
- Decode, который стоит времени на каждый выходной токен, умноженного на длину вывода
- Пост-обработка
- Обратный путь к пользователю
Время выполнения модели на шагах три и четыре масштабируется в зависимости от длины подсказки (промпта) и вывода. Сетевое время на шагах один и шестой фиксировано для каждого перехода (хопа), поэтому путь между регионами или несколькими провайдерами увеличивает его в два и более раз. Для коротких интерактивных ответов сеть может занимать большую долю бюджета, чем сама модель. Наше руководство по задержкам при инференсе подробно описывает каждый компонент и включает скрипт для измерения задержки из региона ваших пользователей.
«Мы часто зацикливаемся на скорости инференса LLM, но в голосовом ИИ сеть часто оказывается скрытым убийцей». Иэн Рейтер (Ian Reither), операционный директор Telnyx
Почему локальные GPU меняют результат
Telnyx запускает модели на GPU, размещенных в той же сети, которая обслуживает пользователя, непосредственно в регионах по всей Америке, Европе, Ближнему Востоку и АТР (APAC). Запросы не делают промежуточных переходов между провайдерами и межграничной маршрутизации, что исключает лишние сегменты сети из бюджета без изменения времени работы модели.
Для интерактивных задач уровень Priority (Приоритетный) выбирает более высокую емкость обслуживающих мощностей для рабочих нагрузок с низкой задержкой, включая голосовую оркестрацию, без изменения модели или контекстного окна. Четыре измерения показывают, как любой провайдер будет вести себя в продакшене:
- Время до первого токена (TTFT): то, чего ждет пользователь чата или звонящий, прежде чем что-либо появится
- Время на один токен вывода: скорость стриминга остальной части ответа
- P99 сквозной задержки при одновременной нагрузке: самые медленные запросы, измеряемые с разной длиной входа, которые скрывают средние значения бенчмарков
- Время голосового отклика: от конца речи звонящего до первого синтезированного аудио
Говорим голосом в реальном времени: три хопа инференса за один цикл
Голосовой агент выполняет распознавание речи (STT), запуск LLM и синтез речи (TTS) в рамках одного диалогового цикла, а затем возвращает аудио звонящему. Когда каждый компонент поступает от отдельного вендора, каждая передача добавляет сетевой раунд-трип (round trip) и собственный джиттер.
Команды, которые запускают собственную оркестрацию, все равно могут сократить эти хопы, разместив эндпоинт LLM в той же сети, что и телефония со службой распознавания речи. Наша статья об инфраструктуре совмещенного голосового ИИ объясняет, как удержание аудио, транскрипции, модели и речи в одной сети позволяет удерживать время отклика от голоса до голоса в пределах секунды.
Наиболее эффективная ИИ-инфраструктура для инференса под нагрузкой
Эффективность инференса — это в первую очередь проблема использования ресурсов, а во вторую — проблема соответствия уровню обслуживания, и Telnyx предоставляет оба варианта на выбор для каждого запроса.
Утилизация определяет стоимость одного токена
Стоимость простоя GPU почти такая же, как и при активной работе, а спрос на инференс возникает вместе с пользователями. Отдельная команда редко загружает выделенный кластер круглосуточно, поэтому большая часть счета уходит на оплату времени ожидания.
Полезной мерой является количество обслуженных токенов на доллар. Хостинг-провайдер, объединяющий трафик множества клиентов на принадлежащих ему GPU, достигает уровня утилизации, недоступного одному арендатору, что отражается на цене за токен. Наше руководство по оптимизации затрат на инференс разбирает полный пример, в котором ежемесячный счет в 50 000 долларов сокращается примерно до 12 400 долларов.
Соотнесите уровень обслуживания с рабочей нагрузкой
Платить за низкую задержку имеет смысл только там, где задержка приносит доход. Telnyx предлагает три уровня обслуживания на одном OpenAI-совместимом эндпоинте, которые выбираются с помощью поля service_tier в каждом запросе.
Уровни обслуживания инференса Telnyx
Поскольку уровень обслуживания задается одним полем в теле запроса, команда может направить голосового агента на уровень Priority, а задачу ночной суммаризации — на уровень Flex, не добавляя второго провайдера инференса.
Масштабирование без планирования емкости
Собственная инфраструктура GPU масштабируется от 0 до тысяч запросов в секунду без планирования емкости. Оплата производится за токен, поэтому малообъемные и скачкообразные рабочие нагрузки платят только за то, чем пользуются, без каких-либо минимальных требований. Повторяющиеся промпты, такие как системные промпты и шаблоны few-shot, получают кэшированный ввод со скидкой до 88%.
Структурное ценообразование: до 75% дешевле проприетарных альтернатив, кэшированный ввод со скидкой до 88%, а также отсутствие платы за аренду GPU, надбавок за вычисления и минимальных лимитов. Ставки за токен зависят от модели и уровня обслуживания, и каждый тариф указан на странице цен API инференса.
Самая надежная инфраструктура для ИИ-инференса в продакшене
Надежная инфраструктура инференса обеспечивает четыре вещи: емкость при скачках трафика, отсутствие штрафа за холодный старт, вывод, который приложение может парсить каждый раз, и API, который переживает вывод модели из эксплуатации.
Что ломается после запуска
Бенчмарки редко показывают сбои, с которыми команды сталкиваются в продакшене. Холодный старт превращает быстрый вызов в многосекундное ожидание. Всплеск трафика исчерпывает зарезервированные мощности, а «шумные соседи» увеличивают задержку P99.
Пробелы в наблюдаемости скрывают, какой именно слой дал сбой. Затем провайдер объявляет устаревшей модель, от которой зависит приложение, и устанавливает дедлайн миграции всего через несколько недель.
«Качество моделей — это решенная проблема у нескольких провайдеров. Самое сложное — запустить эти модели на периферии (edge), совмещенно с телефонией, чтобы вся цепочка (от STT до инференса, TTS и сетевой доставки) оставалась на одной инфраструктуре. Никто другой не запускает всю цепочку от начала до конца. Vapi, Retell, Bland — они перепродают чужие TTS и STT, что означает множество вендоров, множество хопов и суммарную задержку. Мы размещаем семь движков TTS на собственных GPU (Natural, NaturalHD, Ultra, Kokoro, Qwen3TTS, xAI Grok, Inworld) и маршрутизируем еще на семь через тот же API. Сама модель — это простая часть. Инфраструктура под ней — вот что делает ее готовой к продакшену». Доктор Сонам Гупта (Dr. Sonam Gupta), разработчик-евангелист в Telnyx
Собственные мощности, отсутствие холодных стартов, структурированный вывод
Telnyx справляется с первыми двумя проблемами с помощью собственной инфраструктуры GPU, которая обслуживает одновременные запросы и масштабируется автоматически, без планирования емкости и холодных стартов. Структурированный вывод с режимом JSON и ограничениями на основе регулярных выражений удерживает каждый ответ в рамках схемы приложения, поэтому нижестоящий (downstream) код никогда не разбирает произвольный текст. Вычисления остаются в регионе без сохранения данных, а Telnyx не обучает модели на данных клиентов.
Вывод модели из эксплуатации — это инфраструктурный риск
Дорожная карта моделей является частью инфраструктуры. Telnyx обслуживает модели с открытыми весами от z.ai, DeepSeek, Minimax и других через единый OpenAI-совместимый API, поэтому замена устаревшей модели сводится к изменению ее имени в запросе. Любого провайдера, включая текущего, можно проверить по тому же контрольному списку:
- Емкость масштабируется вместе с одновременными запросами без резервирования
- Первый запрос после периода простоя не несет штрафа за холодный старт
- Вывод может быть ограничен с помощью режима JSON или регулярных выражений
- Библиотека моделей и структура API переживают вывод из эксплуатации отдельной модели
- Данные остаются в регионе без сохранения
Практики инфраструктуры ИИ-инференса
Шесть практик охватывают большинство решений в этом руководстве:
- Измеряйте перед выбором. Зафиксируйте TTFT, время на один токен вывода и P99 под нагрузкой для каждого типа рабочей нагрузки.
- Сохраняйте структуру API. OpenAI-совместимый интерфейс превращает смену провайдера или модели в изменение базового URL и имени модели.
- Выбирайте уровень обслуживания для каждого запроса. Default, Priority и Flex заменяют отдельный кластер для каждой рабочей нагрузки.
- Ограничивайте вывод. Режим JSON или ограничения по регулярным выражениям останавливают ошибки парсинга до того, как они дойдут до приложения.
- Держите инференс в регионе. Размещайте вычисления там, где уже находятся пользователи и данные.
- Планируйте ротацию моделей. Рассматривайте выбор моделей как инфраструктурный рычаг и тестируйте новые релизы с открытыми весами по мере их выхода.
Измеряйте, прежде чем выбирать
Запускайте одни и те же промпты для каждого кандидата с машины в регионе ваших пользователей при реалистичном уровне параллелизма и длине промптов. График задержки, измеренный рядом с GPU, упускает из виду сетевой хоп, за который на самом деле платят ваши пользователи.
Сохраняйте структуру API, меняйте базовый URL
Запрос ниже представляет собой документированный вызов Telnyx Inference к /v2/ai/chat/completions. Существующий SDK OpenAI обращается к тому же эндпоинту при изменении базового URL и учетных данных.
Оболочка
curl -i -X POST "https://api.telnyx.com/v2/ai/chat/completions" \ -H "Authorization: Bearer $TELNYX_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "moonshotai/Kimi-K3", "messages": [{"role": "user", "content": "Hello, World!"}] }'
Пропуск параметра service_tier приводит к использованию значения по умолчанию (Default). Добавление «service_tier»: «priority» или «service_tier»: «flex» в тело JSON позволяет выбрать другие уровни с тем же идентификатором модели moonshotai/Kimi-K3.
Размещайте инференс там, где уже работает остальной конвейер
Инференс в той же сети, что и распознавание и синтез речи, устраняет лишние пересылки данных для рабочих нагрузок с голосовыми и аудиоданными. Проект ai-podcast-producer-python в репозитории примеров кода Telnyx демонстрирует этот паттерн: он записывает подкаст с несколькими ведущими во время конференц-связи, транскрибирует каждого спикера с помощью преобразования речи в текст, генерирует заметки к выпуску и главы с помощью инференса, а также создает заставки в начале и конце с помощью синтеза речи. Команды с собственной оркестрацией могут применять этот подход, внедряя его по одному эндпоинту за раз.
«Мы видим четкий путь развития: команды приходят к инференсу ради моделей и экономической выгоды, а затем понимают, что на той же инфраструктуре уже работают STT, TTS и телефония. Стоимость интеграции для перехода от текстового инференса к голосовым агентам равна нулю, поскольку это та же сеть. Мы намеренно не делаем на этом акцент в продукте инференса, потому что люди приходят не за этим. Но это то, почему они остаются». Режис Давид Соуза (Regis David Souza), старший инженер-программист в Telnyx
Часто задаваемые вопросы
Проприетарная модель, от которой мы зависим, выводится из эксплуатации через несколько недель. Как перейти на другую инфраструктуру инференса без переписывания приложения?
Перейдите на совместимого с OpenAI провайдера, который обслуживает модели с открытыми весами, а затем измените базовый URL, учетные данные и название модели в существующем SDK. Перед переключением протестируйте вызовы инструментов, структурированный вывод и длину контекста на новой модели, поскольку эти параметры различаются в зависимости от модели. Telnyx Inference использует ту же структуру запроса chat completions, поэтому код самого приложения остается прежним.
Можем ли мы использовать провайдера инференса только для LLM, распознавания и синтеза речи, сохранив собственную оркестрацию?
Да. Размещенный API инференса представляет собой набор HTTP-эндпоинтов, поэтому он подключается к уже используемой вами оркестрации. Telnyx запускает инференс LLM, распознавание речи и синтез речи в одной сети, и каждый из них может вызываться отдельно. Сохранение всех трех компонентов в одном регионе исключает пересылки между вендорами на каждом речевом шаге без необходимости заменять ваш уровень оркестрации.
Мы сталкиваемся с ограничениями по задержке и пропускной способности токенов на эндпоинте нашего текущего облачного провайдера. Что на самом деле меняется при запуске инференса на GPU в вашем регионе?
Меняются две вещи. GPU в том же регионе устраняют межрегиональные и межпровайдерные сетевые хопы, которые часто определяют задержку коротких интерактивных ответов. Автомасштабирование на собственных мощностях избавляет от необходимости резервировать пропускную способность до появления спроса. Время вычислений модели остается примерно прежним, поэтому измеряйте TTFT и P99 из региона ваших пользователей, чтобы увидеть реальную разницу для вашей рабочей нагрузки.
Что такое инференс в ИИ и какие инфраструктурные решения из него вытекают?
Инференс — это запуск обученной модели на новых входных данных для получения результата, такого как генерация ответа на промпт. Поскольку он выполняется каждый раз, когда пользователь отправляет запрос, вытекающие из него решения касаются обслуживания: где находится GPU относительно пользователей, как емкость масштабируется в зависимости от трафика, во сколько обходится каждый токен и от какой структуры API зависит приложение.
Чем инференс ИИ отличается от обучения и почему для них требуется разная инфраструктура?
Обучение настраивает веса модели на больших наборах данных в рамках задачи, которая в конечном итоге завершается, поэтому для нее требуется максимальная вычислительная мощность в течение фиксированного периода. Инференс использует готовые веса для ответа на запросы в реальном времени и никогда не завершается, пока пользователи продолжают их отправлять. Инфраструктура для обучения рассчитывается под конкретную задачу. Инфраструктура для инференса рассчитывается под непредсказуемый спрос и оценивается по задержке и стоимости токена.
Выбирайте уровень и регион для каждой рабочей нагрузки
Предоставьте каждой рабочей нагрузке тот уровень обслуживания и GPU в регионе, которые ей необходимы, вместо того чтобы арендовать кластер для всех сразу. Перенесите существующее приложение на базе SDK OpenAI на Telnyx Inference, изменив базовый URL, с экономией до 75% по сравнению с проприетарными моделями.
Начать разработку