Основные выводы
Вычисления с помощью vLLM — это процесс развертывания LLM с открытыми весами через vLLM, проект с открытым исходным кодом, который предоставляет API, совместимый с OpenAI. В этом руководстве показано, как запустить такую модель на одном графическом процессоре и сделать изменение в одну строку для переноса того же клиента на управляемую конечную точку.
- PagedAttention хранит кэш ключей и значений (KV-кэш) в блоках по 16 токенов, а непрерывный батчинг (continuous batching) позволяет диспетчеру объединять этапы префилла и генерации (decode) за один шаг работы движка.
- Один контейнер Docker — самый быстрый способ первого развертывания. Размер модели и параметр gpu_memory_utilization определяют, сможет ли она запуститься, а параметр --enforce-eager влияет на время запуска.
- Несколько параметров конфигурации позволяют балансировать между задержкой и пропускной способностью, а формула расчета блоков KV-кэша помогает узнать, сколько последовательностей поместится на вашем GPU.
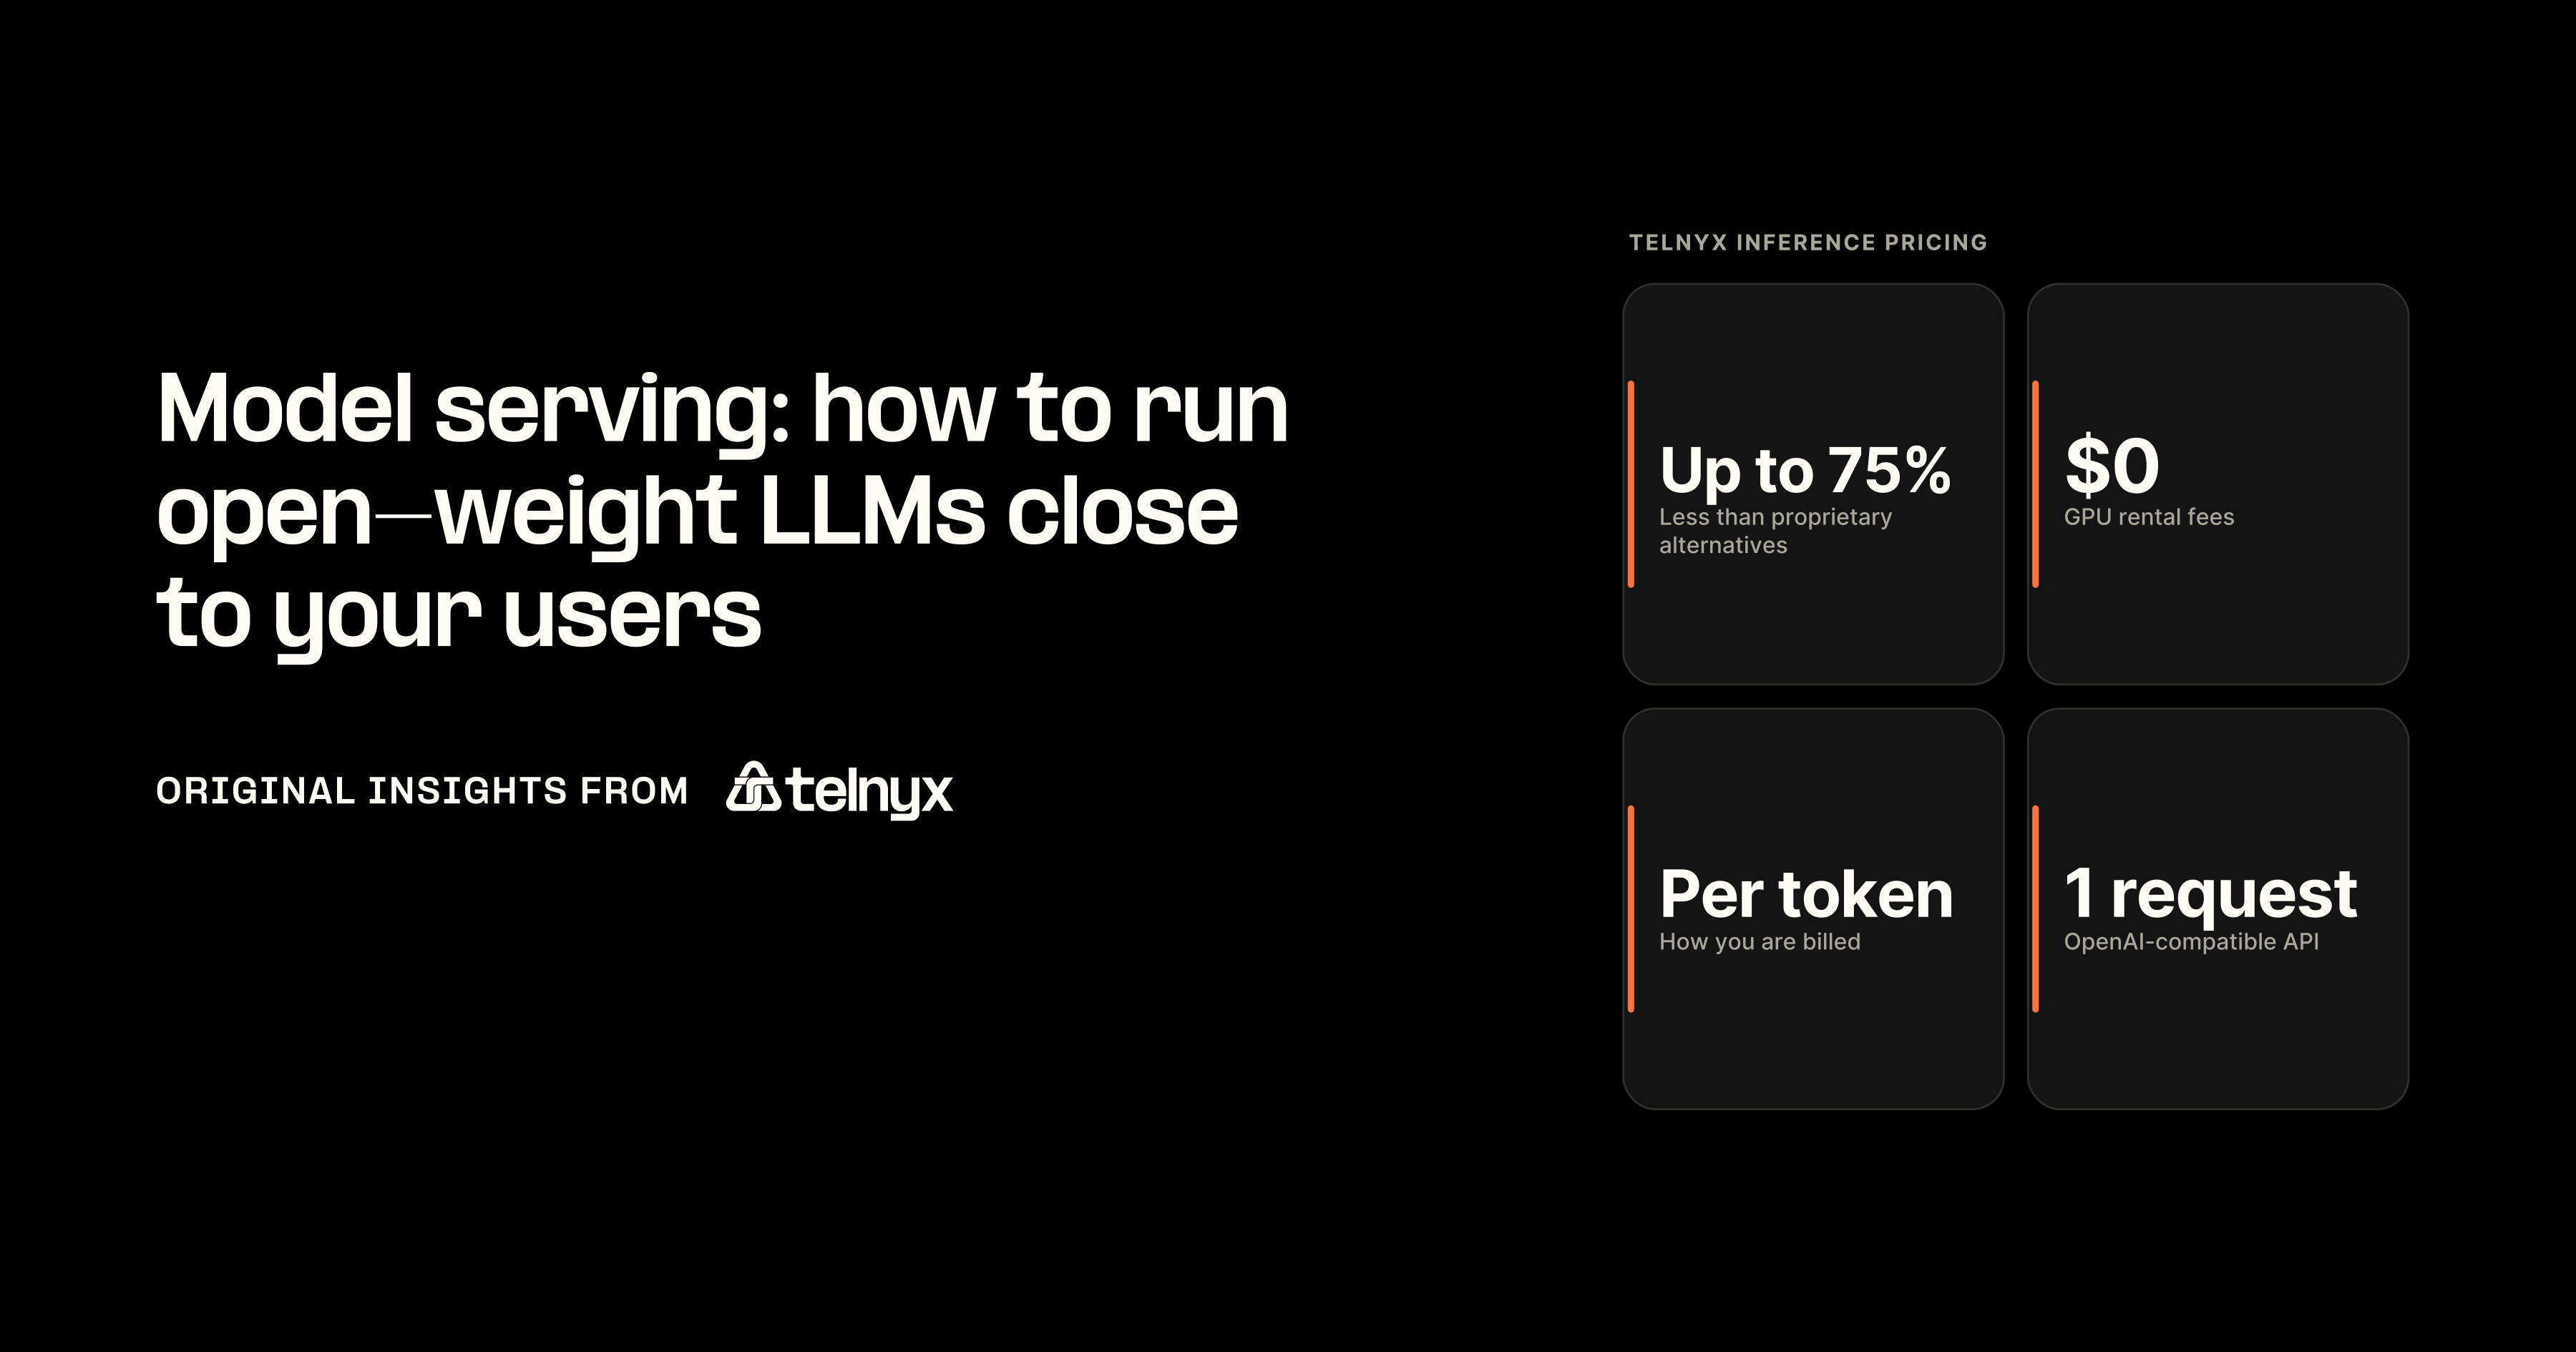
- Когда содержание собственных GPU перестает быть выгодным, тот же OpenAI-совместимый клиент может обращаться к управляемой конечной точке через Telnyx Inference: GPU в нужном регионе, до 75% дешевле проприетарных альтернатив и полное отсутствие необходимости администрировать железо.
Что такое инференс на vLLM и зачем он нужен
Инференс на vLLM означает запуск большой языковой модели с открытыми весами через движок vLLM, который планирует запросы, управляет памятью GPU для KV-кэша и возвращает токены через сервер, совместимый с OpenAI. Вы предоставляете GPU, а vLLM превращает их в эндпоинт, к которому может обращаться ваше приложение.
Если вы хотите использовать те же модели с открытыми весами, не владея этим оборудованием, Telnyx Inference запускает их на GPU, принадлежащих Telnyx, в различных регионах Северной и Южной Америки, Европы, MENA и APAC, избавляя вас от необходимости управлять инфраструктурой.
Что такое vLLM? vLLM — это движок инференса с открытым исходным кодом, который объединяет запросы в батчи, разбивает KV-кэш на страницы и предоставляет API чата (chat completions), совместимый с OpenAI, для языковых моделей с открытыми весами. Это программное обеспечение, которое вы запускаете на собственных GPU, а не хостинговый API.
vLLM — это движок инференса, а не модель и не платформа
vLLM начинался как исследовательский проект в Лаборатории Sky Computing Калифорнийского университета в Беркли и теперь является поддерживаемым проектом PyTorch Foundation. Его задача узко специализирована: взять чекпоинт модели, загрузить его на ускорители и выдавать токены так эффективно, как позволяет аппаратное обеспечение. Red Hat использует расширенное название «virtual large language model», хотя сам проект редко использует полную форму.
Две границы, в которых часто путаются:
- vLLM не является слоем оркестрации. Такие проекты, как llm-d, запущенный Red Hat в мае 2025 года совместно с Google Cloud, IBM Research, NVIDIA и CoreWeave, располагаются поверх vLLM для управления планированием Kubernetes и маршрутизацией между множеством инстансов. Это отдельные проекты, а не функции vLLM.
- vLLM не является хостинговым сервисом. Вы выделяете GPU, выбираете модель, рассчитываете объем памяти и поддерживаете ее работу. Эта операционная работа и составляет реальные затраты, а остальная часть этого руководства показывает, из чего они складываются. Более широкое представление о том, как движки обслуживания встраиваются в стек, см. в нашем руководстве по движку инференса.
На чем работает инференс vLLM
vLLM поддерживает текстовые, мультимодальные модели, эмбеддинги и модели оценки (reward models) на широком спектре оборудования:
- GPU NVIDIA: основная цель развертывания с наилучшей поддержкой ядер.
- GPU AMD Instinct: поддерживаются через ROCm, есть официальные образы Docker.
- Google TPU: поддерживаются через специализированный бэкенд TPU.
- AWS Trainium и Inferentia: поддерживаются через бэкенд Neuron.
- Intel Gaudi и XPU: поддерживаются, есть официальные образы XPU.
- ЦП (x86, ARM): подходят для тестирования, но не для промышленного развертывания.
Попробуйте Telnyx Inference, чтобы перенаправить ваш существующий OpenAI-совместимый клиент vLLM на управляемый эндпоинт с помощью изменения всего одной строки кода.
Как архитектура vLLM обрабатывает запрос
Каждый стек обслуживания, включая GPU за управляемым API, должен корректно реализовывать эти механизмы. Пользователи видят их только как время до первого токена и количество токенов в секунду, поэтому они имеют критическое значение для задержки инференса.
Шаг движка: планирование, прямой проход, постобработка
vLLM выполняет цикл. Каждая итерация, или шаг движка, делает три вещи:
- Планирование: выбор запросов для выполнения на этом шаге и выделение памяти под них.
- Прямой проход (Forward pass): однократный запуск модели по всем запланированным токенам и сэмплирование следующего токена для каждого запроса.
- Постобработка: добавление новых токенов, детюкенизация и проверка завершенности каждого запроса.
Планировщик удерживает очередь ожидания и очередь выполнения, обслуживая их в порядке поступления (FIFO) или по приоритету. Запрос завершается при срабатывании одного из четырех условий остановки:
- Достигнут max_model_len или собственный лимит max_tokens запроса.
- Сэмплирован токен конца последовательности (если не задан ignore_eos, что полезно для бенчмаркинга фиксированной длины вывода).
- Сэмплирован токен из списка stop_token_ids. Этот токен остается в выводе.
- Результат совпадает со стоп-строкой. Стоп-строка удаляется из вывода.
Эти четыре правила объясняют большинство тикетов в стиле «почему генерация остановилась преждевременно».
PagedAttention и пул блоков KV-кэша
Трансформер хранит вектор ключей и значений для каждого уже обработанного токена. Этот KV-кэш растет с каждым выходным токеном, и его хранение в виде единого непрерывного блока памяти на каждый запрос приводит к неэффективному использованию памяти из-за выравнивания и фрагментации.
Вместо этого PagedAttention хранит KV-кэш в блоках фиксированного размера (по умолчанию 16 токенов в блоке). При заполнении vLLM делит зарезервированную память GPU на пул свободных блоков, которых может быть сотни тысяч в зависимости от объема VRAM. Запросы заимствуют блоки по мере роста и возвращают их по завершении. Когда пул истощается, планировщик вытесняет запросы с более низким приоритетом и пересчитывает их позже.
Математика блоков: каждый блок для каждого слоя занимает 2 × block_size (по умолчанию 16) × num_kv_heads × head_size × dtype_bytes, где dtype_bytes равен 2 для bf16. Промпту из 17 токенов требуется ceil(17/16) = 2 блока, поэтому второй блок остается пустым на 15/16 до тех пор, пока генерация не заполнит его.
Пул KV-кэша на основе страниц теперь является стандартным для основных движков обслуживания. Разница между движками заключается в планировании: как они смешивают задачи, расставляют приоритеты для запросов и повторно используют кэшированные блоки. Статья об анатомии vLLM от команды vLLM подробно описывает внутреннее устройство движка V1.
Префилл, генерация и непрерывный батчинг
Инференс состоит из двух фаз с противоположными узкими местами:
- Префилл обрабатывает все токены промпта одновременно. Он ограничен производительностью вычислений (compute-bound), а его стоимость растет с увеличением длины промпта. Он определяет время до первого токена.
- Генерация (decode) обрабатывает по одному новому токену за раз для каждого запроса. Она ограничена пропускной способностью памяти (memory-bandwidth-bound), поскольку GPU перезагружает все веса модели для создания всего одного токена. Она определяет количество токенов в секунду.
Планировщик V1 объединяет обе фазы на одном шаге и в первую очередь обслуживает запросы генерации, поэтому пользователи потоковой передачи продолжают получать токены, пока принимаются новые промпты. Более старый движок V0 мог выполнять только одну фазу за шаг.
Непрерывный батчинг делает это возможным. vLLM объединяет каждую запланированную последовательность в одну длинную последовательность, а индексы позиций и маски внимания гарантируют, что каждый запрос обращается только к собственным токенам. Новые запросы присоединяются между шагами, и никому не приходится ждать самый медленный запрос в фиксированном батче.
Кэширование префиксов, сегментированный префилл и спекулятивный инференс
Три расширения дополняют пул блоков:
- Кэширование префиксов хеширует каждый полный 16-токеновый блок промпта. Когда более поздний запрос разделяет этот префикс, например длинный системный промпт, vLLM повторно использует кэшированные блоки вместо их повторного вычисления. Эта функция включена по умолчанию и ускоряет только предварительное заполнение (prefill), но не декодирование.
- Предварительное заполнение блоками (chunked prefill) ограничивает количество токенов промпта, которое один запрос может пропустить за один шаг. Установите положительное целое число для параметра long_prefill_token_threshold, и промпт на 50 000 токенов больше не сможет блокировать всех остальных.
- Директивное (спекулятивное) декодирование предлагает несколько черновых токенов с минимальными затратами и проверяет их за один проход вперед. Движок V1 поддерживает пропозеры n-gram, EAGLE и Medusa.
Примеры инференса vLLM: автономный режим, сервер и клиент, совместимый с OpenAI
Поскольку и vLLM, и Telnyx Inference поддерживают формат чат-комплитов OpenAI, клиент во втором примере — это тот же клиент, что и в третьем, но с другим базовым URL и ключом API.
Пример автономного инференса vLLM на Python
Наименьшая полная программа на vLLM загружает модель и генерирует текст для списка промптов. Используйте этот паттерн для пакетных заданий и бенчмарков, а не для обслуживания пользователей.
Python
from vllm import LLM, SamplingParamsprompts = [ "Explain PagedAttention in one sentence.", "What does a KV cache store?",]sampling_params = SamplingParams(temperature=0.7, max_tokens=128)llm = LLM(model="Qwen/Qwen3-0.6B")outputs = llm.generate(prompts, sampling_params)for output in outputs: print(output.outputs[0].text)
vllm serve и запрос, совместимый с OpenAI
Команда vllm serve запускает тот же движок за HTTP-сервером, совместимым с OpenAI. Любой SDK OpenAI работает с ним, как только вы укажете базовый URL SDK для вашего хоста.
Shell
vllm serve Qwen/Qwen3-0.6Bcurl http://localhost:8000/v1/chat/completions \ -H "Content-Type: application/json" \ -d '{ "model": "Qwen/Qwen3-0.6B", "messages": [{"role": "user", "content": "Hello, World!"}] }'
Тот же запрос к Telnyx Inference
Вот тот же запрос чат-комплитов, отправленный в Telnyx, в точности так, как он опубликован на странице продукта:
Shell
curl -i -X POST "https://api.telnyx.com/v2/ai/chat/completions" \ -H "Authorization: Bearer $TELNYX_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "moonshotai/Kimi-K3", "messages": [{"role": "user", "content": "Hello, World!"}] }'
Изменились только три вещи: базовый URL, учетные данные и название модели. Массив сообщений, структура запроса и ваш SDK остаются прежними.
При самостоятельной хостинге часто возникают два параметра переключения движка. Чтобы отключить кэширование префиксов, например, когда вам нужны полностью холодные измерения:
Python
llm = LLM(model="Qwen/Qwen3-0.6B", enable_prefix_caching=False)
Чтобы попробовать спекулятивное декодирование n-gram, которое наиболее полезно, когда выходы повторяют фрагменты промпта, такие как изменения кода или извлечение документов:
Python
speculative_config = {"method": "ngram", "prompt_lookup_max": 5, "prompt_lookup_min": 3, "num_speculative_tokens": 3}llm = LLM(model="Qwen/Qwen3-0.6B", speculative_config=speculative_config)
Структурированный вывод работает для каждого запроса на сервере vLLM. В Telnyx Inference режим JSON и ограничения по регулярным выражениям выполняют ту же задачу.
Быстрый старт vLLM Docker: один GPU, один контейнер, один эндпоинт
Если нужная вам модель уже есть в библиотеке Telnyx, ваш быстрый старт — это команда curl выше. Этот раздел предназначен для случаев, когда вам нужны собственные веса или собственное железо.
Почему мой контейнер vLLM не запускается?
Выберите ошибку или симптом, которые вы видите в логах контейнера.
Веса сами по себе превышают бюджет памяти GPU
Веса BF16 занимают около 2 байт на параметр, поэтому модели 8B требуется примерно 16 ГБ до появления какого-либо кэша KV. При значении gpu_memory_utilization по умолчанию, равном 0.9, карта на 24 ГБ выделяет vLLM около 21.6 ГБ, что оставляет всего около 5 ГБ для кэша и активаций. Модель 70B размером около 140 ГБ вообще не поместится на одном GPU с 80 ГБ.
Переключитесь на 4-битный чекпоинт AWQ или GPTQ, который составляет примерно четверть размера BF16, или разделите модель между картами с помощью параметра --tensor-parallel-size.
До: BF16 Llama 3.1 70B на одном 80 ГБ H100 падает при загрузке. После: 4-битная сборка AWQ той же модели, около 40 ГБ весов, запускается на этой карте с запасом для кэша.
Ограничьте длину контекста тем, что вмещает кэш
vLLM отказывается запускаться, если один запрос с полной длиной контекста не может поместиться в кэш KV. Для моделей Llama 3.1 контекст по умолчанию составляет 131072 токена, что карта на 24 ГБ при работе с моделью 8B не может вместить. Сообщение об ошибке выводит точное количество токенов, которое может сохранить ваш кэш.
Установите --max-model-len на уровне или ниже этого выведенного числа либо увеличьте --gpu-memory-utilization до 0.95, если ничто другое не делит GPU. Большинство рабочих нагрузок чата никогда не приближаются к 131072 токенам, поэтому более низкое ограничение ничего не стоит вам на практике.
До: контекст по умолчанию 131072 токена, сбой запуска. После: --max-model-len 16384, сервер запускается и обслуживает больше последовательностей одновременно.
Другой процесс уже занимает память GPU
gpu_memory_utilization — это доля от общей памяти карты, а не от того, что в данный момент свободно. Если блокнот или второй контейнер уже занимают 6 ГБ на карте с 24 ГБ, значение по умолчанию 0.9 запрашивает 21.6 ГБ, которых больше не существует.
Запустите nvidia-smi, чтобы найти процесс и остановить его, или уменьшите долю, чтобы запрос поместился. Два экземпляра vLLM, совместно использующие один GPU, должны иметь собственную долю, и оба значения в сумме должны быть меньше 1.0.
До: 6 ГБ используется Jupyter, vLLM при 0.9 падает. После: --gpu-memory-utilization 0.7 запрашивает 16.8 ГБ и запускается без проблем.
Примите лицензию и передайте токен
Llama, Gemma и несколько чекпоинтов Mistral заблокированы на Hugging Face. В контейнере по умолчанию нет учетных данных, поэтому загрузка завершается ошибкой, даже если имя модели указано правильно.
Примите лицензию на странице модели с помощью своей учетной записи Hugging Face, а затем передайте свой токен в контейнер. Также смонтируйте каталог кэша Hugging Face, чтобы 16 ГБ весов для модели 8B загружались один раз, а не при каждом перезапуске.
До: docker run --gpus all vllm/vllm-openai --model meta-llama/Llama-3.1-8B-Instruct. После: добавьте -e HF_TOKEN=$HF_TOKEN -v ~/.cache/huggingface:/root/.cache/huggingface к той же команде.
Происходит захват графов CUDA, это не зависание
После загрузки vLLM выполняет профилирование памяти, компилирует модель и захватывает графы CUDA для диапазона размеров батчей. При первом запуске это может занять несколько минут без новых строк в логах, что выглядит как зависание, но им не является.
Параметр --enforce-eager пропускает захват графов, поэтому эндпоинт поднимается быстрее, ценой более медленного декодирования каждого токена. Используйте его для циклов разработки и отключайте для продакшна. Монтирование ~/.cache/vllm сохраняет кэш компиляции между перезапусками, что сокращает время последующих запусков даже при включенных графах.
До: каждый перезапуск контейнера повторяет полный шаг компиляции. После: -v ~/.cache/vllm:/root/.cache/vllm повторно использует кэшированный результат компиляции при следующем запуске.
Выберите модель, которая помещается на GPU
Прежде чем контейнер запустится, веса должны поместиться. В формате FP16 или BF16 веса занимают около 2 байт на параметр. Квантование INT4 сокращает это примерно до половины байта на параметр плюс некоторые накладные расходы:
- Модель 70B: около 140 ГБ в FP16, поэтому ей требуется более одного GPU с 80 ГБ, если она не квантована.
- Модель 72B: около 144 ГБ в FP16 или менее 48 ГБ в INT4, что помещается на одну карту с 80 ГБ.
- Модель с 176 млрд параметров: около 352 ГБ в FP16, что требует тензорного параллелизма на нескольких GPU.
Эти цифры относятся только к весам. Кэшу KV требуется дополнительное пространство, поэтому оставляйте запас. Предпочитайте чекпоинт, который поставщик модели уже квантовал, вместо квантования при загрузке, которое увеличивает время запуска и нагрузку на CPU и GPU.
Запуск Docker-образа vLLM
Официальный образ vllm/vllm-openai запускает OpenAI-совместимый сервер. Это команда из документации vLLM Docker с добавленным параметром --gpu-memory-utilization после тега образа, куда, согласно документации, помещаются дополнительные аргументы движка:
Shell
docker run --runtime nvidia --gpus all \ -v ~/.cache/huggingface:/root/.cache/huggingface \ --env "HF_TOKEN=$HF_TOKEN" \ -p 8000:8000 \ --ipc=host \ vllm/vllm-openai:latest \ --model Qwen/Qwen3-0.6B \ --gpu-memory-utilization 0.8
Монтирование кэша Hugging Face сохраняет загруженные веса между перезапусками контейнеров, а флаг --ipc=host предоставляет PyTorch общую память, используемую между процессами. Как только в логах появится информация о том, что сервер запущен, локальный запрос curl из предыдущего раздела начинает работать с localhost:8000. Для модели, которой требуется несколько GPU на одном узле, добавьте --tensor-parallel-size с указанием количества GPU.
Почему первый запрос выполняется медленно и когда происходит сбой запуска
При запуске vLLM проверяет, достаточно ли на GPU свободной видеопамяти для доли gpu_memory_utilization (0.8 означает 80% от общего объема VRAM). Она загружает веса, выполняет тестовый проход вперед (dummy forward pass) и делает снимок памяти, чтобы подсчитать, сколько блоков KV поместится. Затем она захватывает CUDA-графы для диапазона размеров батча, что снижает накладные расходы на запуск ядра во время обслуживания.
Устранение неполадок при запуске
- Нехватка памяти при запуске: веса плюс зарезервированная доля превышают возможности карты. Уменьшите --gpu-memory-utilization или выберите меньший квантованный чекпоинт.
- Медленный первый запрос: это прогрев (warmup). Исключайте его из любых бенчмарков и измеряйте время до первого токена (TTFT) отдельно от общей задержки.
- Медленный запуск: --enforce-eager пропускает захват CUDA-графов. Запуск ускоряется, но обработка каждого токена становится немного медленнее.
- trust_remote_code: этот параметр выполняет код из репозитория модели с полными правами. Включайте его только для источников, которым доверяете.
Конфигурация vLLM: параметры, влияющие на задержку и пропускную способность
В Telnyx Inference эти параметры сводятся к одному полю запроса — service_tier. При самостоятельной хостинге вы настраиваете их сами.
Параметры памяти и батчей
Каждый параметр здесь использует тот же пул блоков KV, который зарезервирован с помощью gpu_memory_utilization. Большее количество одновременных последовательностей при более длинном контексте означает больше блоков, а размер пула фиксируется при запуске.
- gpu_memory_utilization: доля VRAM, которую vLLM резервирует под веса и кэш KV. Более высокое значение означает больше блоков и выше параллелизм, оставляя меньше места для всего остального на карте.
- max_model_len: максимальный контекст, который может использовать один запрос. Увеличение этого параметра снижает количество запросов максимальной длины, которые помещаются одновременно.
- max_num_seqs: ограничение на количество одновременно выполняющихся запросов. Его увеличение жертвует задержкой отдельного запроса в пользу общей пропускной способности, пока пул блоков не исчерпается и не начнется вытеснение (preemption).
- max_num_batched_tokens: ограничение на количество токенов, обрабатываемых за один шаг движка. Оно ограничивает объем работы префилла, который может вклиниться в шаг наряду с декодированием.
- --enforce-eager: пропускает захват CUDA-графов. Быстрее запуск, медленнее токены.
- enable_prefix_caching: включено по умолчанию. Оставляйте этот параметр включенным, когда запросы используют общие длинные промпты.
- long_prefill_token_threshold: положительное целое число включает сегментированный префилл (chunked prefill), благодаря чему длинные промпты перестают монополизировать шаги.
Для оценки емкости умножьте размер одного блока из раздела об архитектуре на количество слоев, разделите оставшуюся после загрузки весов зарезервированную VRAM на это число, и вы получите пул блоков. Разделите пул на max_model_len / 16, чтобы узнать, сколько последовательностей с полным контекстом поместится.
Бэкенд внимания и квантование
vLLM выбирает ядро внимания в соответствии с позиционным кодированием модели. FlashAttention — стандартный быстрый путь для моделей на базе RoPE, таких как Qwen, в то время как другие бэкенды поддерживают модели ALiBi. Вы можете изменить ядро во время работы сервера, но не механизм внимания модели, поэтому перед принудительным изменением проверьте матрицу поддержки бэкендов внимания vLLM.
Для квантования действует правило из раздела о размерах: предварительно квантованный чекпоинт запускается быстрее и предсказуемее, чем квантование во время загрузки.
Параллелизм: сначала тензорный, затем конвейерный, а остальное — реплики
Когда веса не помещаются на один GPU:
- Тензорный параллелизм разделяет каждый слой между GPU на одном узле. Используйте его в первую очередь, так как пропускная способность внутри узла намного выше, чем между узлами.
- Конвейерный параллелизм разделяет слои между узлами. Используйте его, когда одного узла все еще недостаточно.
- Реплики масштабируют пропускную способность. Встроенный в vLLM параллелизм данных поддерживает синхронизацию реплик, выполняя фиктивные шаги на простаивающих репликах, что требуется только для моделей типа «микросхема экспертов» (MoE). Для плотных моделей запускайте независимые экземпляры vLLM за балансировщиком нагрузки.
Чем управляемый эндпоинт заменяет эти параметры
В Telnyx Inference одно поле в каждом запросе определяет емкость обслуживания:
- Default: стандартная емкость по стандартным тарифам. Если пропустить service_tier, вы получите именно это.
- Priority: более быстрая емкость обслуживания для интерактивных задач по другой цене. Это не меняет модель или окно контекста.
- Flex: самые низкие тарифы для фоновых заданий, где допустима задержка в несколько минут от конца до конца.
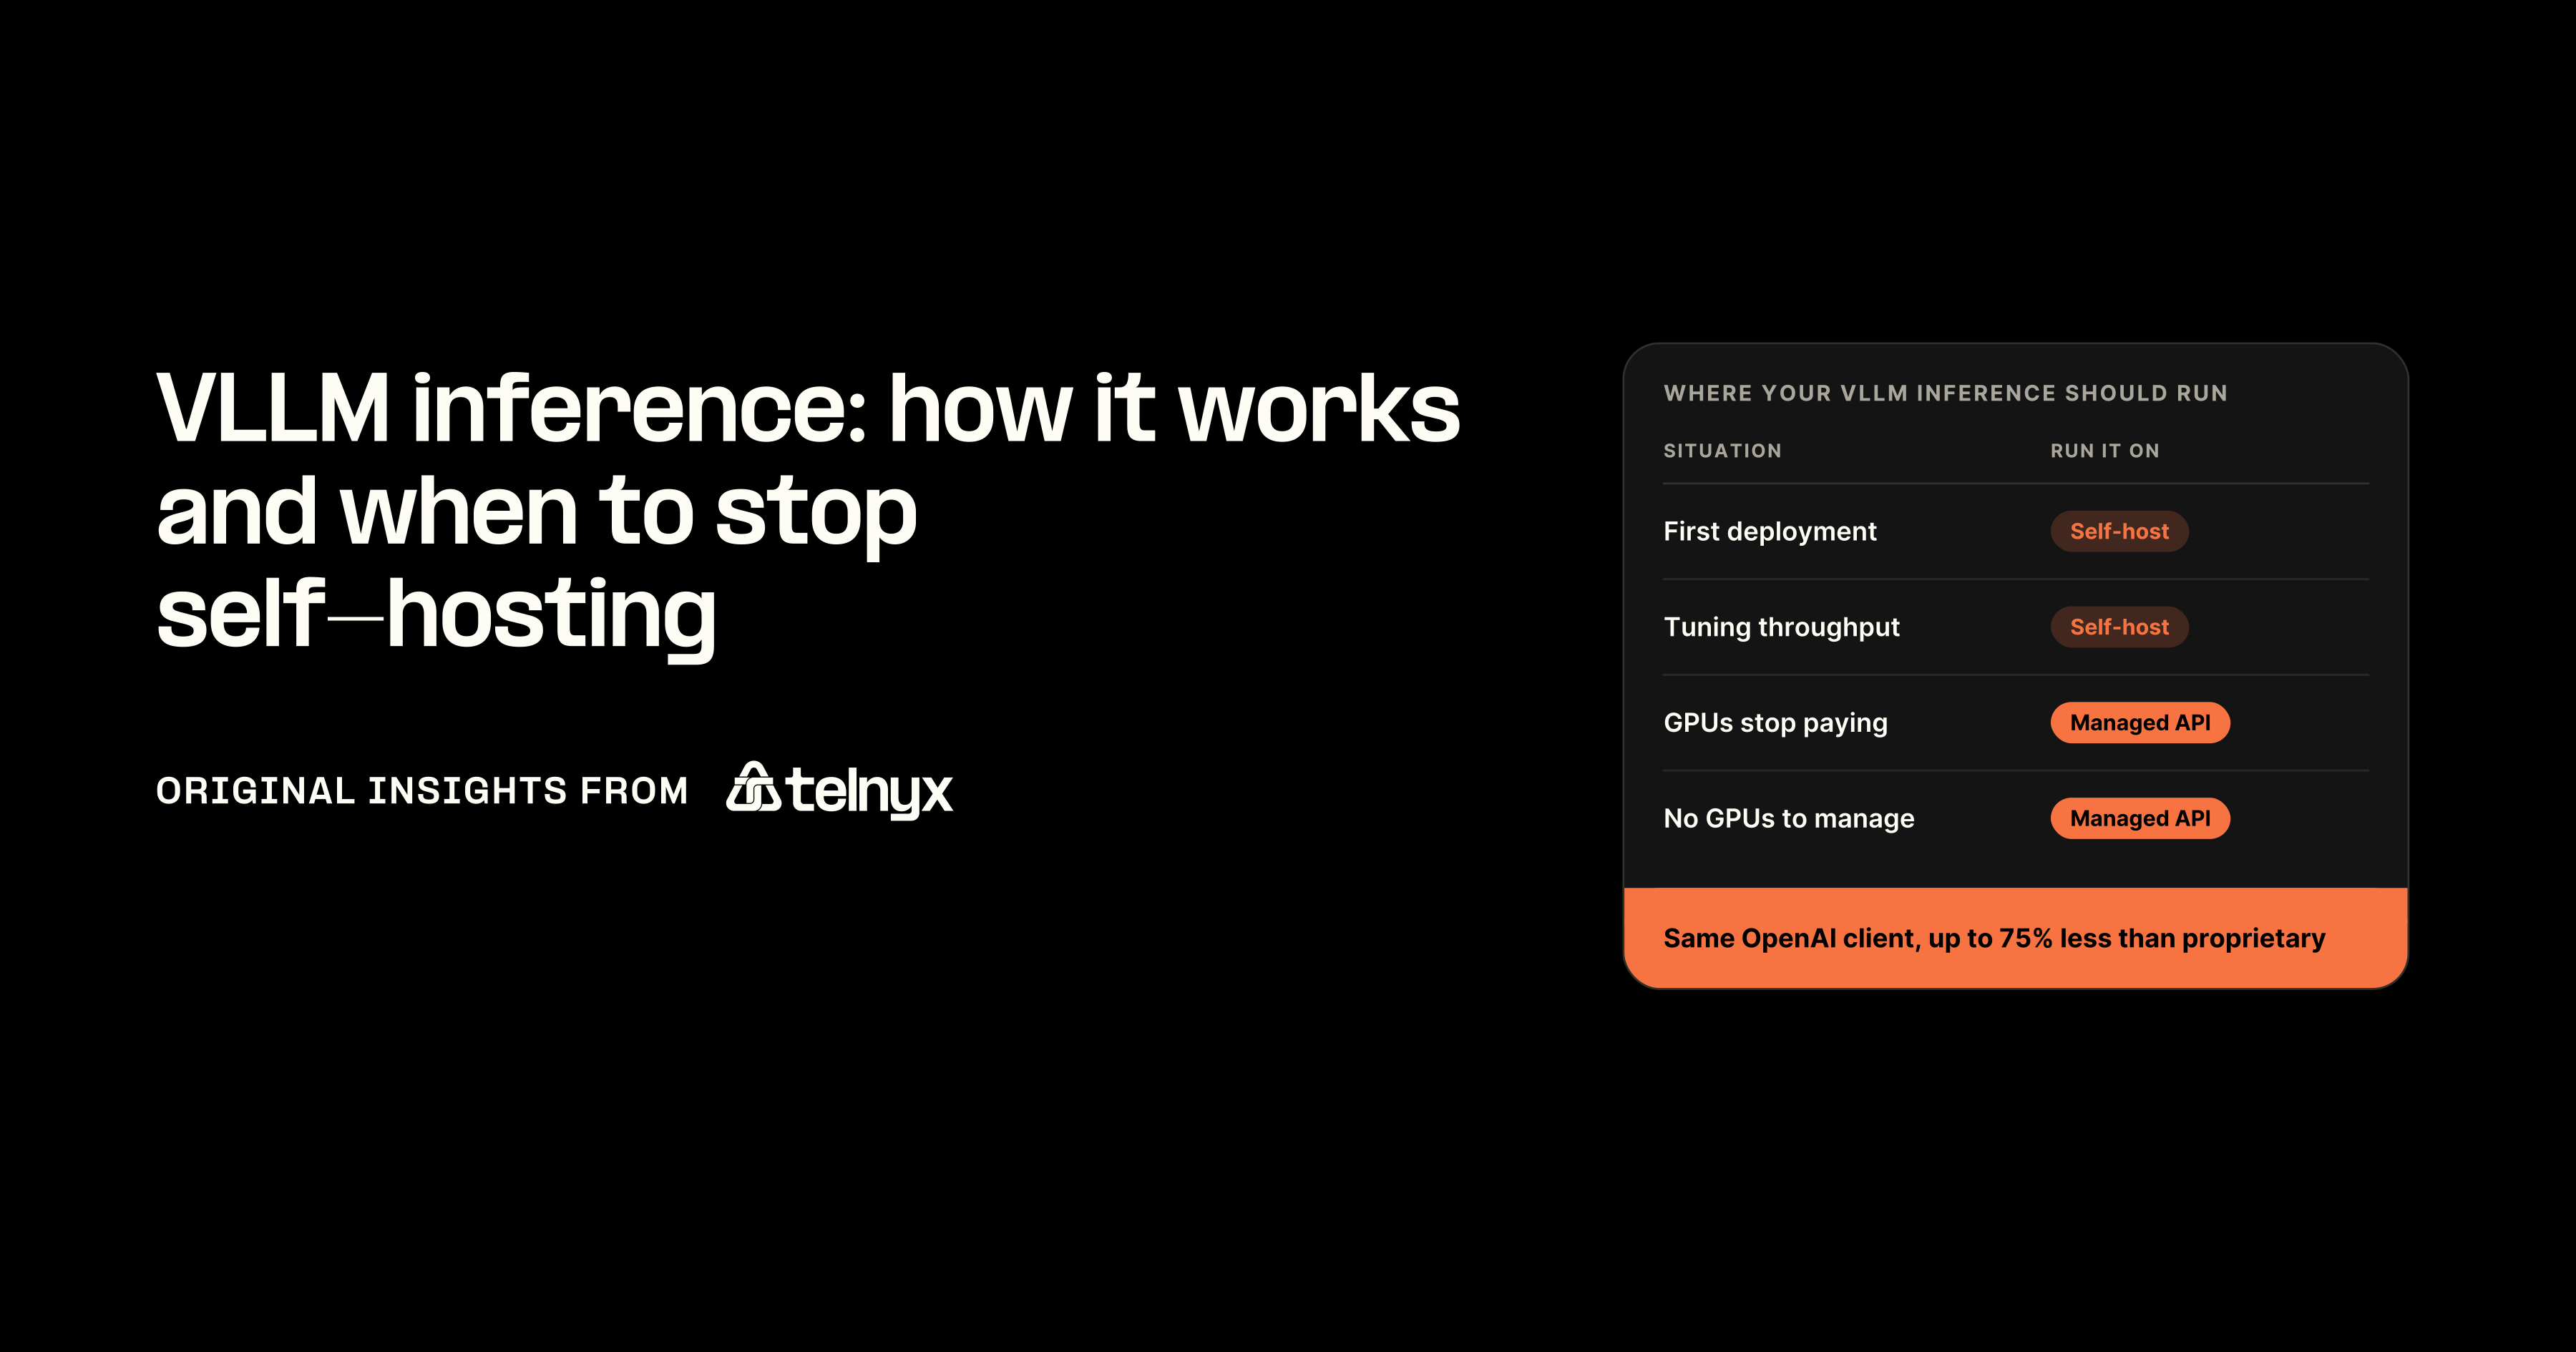
Инференс vLLM против управляемого API: когда самостоятельный хостинг перестает быть выгодным
Telnyx Inference предоставляет тщательно подобранную библиотеку моделей с открытыми весами на GPU, принадлежащих Telnyx, через OpenAI-совместимые эндпоинты, доступ к которым получается простым изменением базового URL. Цены указаны за токен и на 75% ниже проприетарных альтернатив, с кэшированием входящих данных со скидкой до 88% и без платы за аренду GPU, надбавок за вычисления или минимальных платежей.
Что вы берете на себя при самостоятельном хостинге инференса vLLM
Все, о чем говорилось ранее в этом руководстве, становится вашей заботой:
- Оценка соответствия моделей объему VRAM и резервирование правильной доли gpu_memory_utilization.
- Ожидание прохода профилирования и прогрева CUDA-графов при каждом новом экземпляре.
- Мониторинг вытеснения с пересчетом (recompute preemption), когда пул блоков исчерпывается под нагрузкой.
- Шардинг с помощью тензорного параллелизма, когда веса перестают помещаться на одну карту.
- Выделение GPU перед каждым пиком нагрузки и оплата их простоя.
Именно последняя строка обычно меняет математику расчетов. Наше руководство по оптимизации затрат на инференс рассказывает о том, как время простоя GPU формирует реальную стоимость одного токена.
Что меняется при использовании эндпоинта Telnyx
Управляемый подход избавляет от хлопот с управлением GPU, но не от важных выборов. Инференс выполняется в регионах по всему миру: в Америке, Европе, MENA и APAC (регион LATAM появится в ближайшее время) — на сети GPU Telnyx. Данные остаются в регионе без их сохранения и использования для обучения. Емкость автоматически масштабируется от нуля до тысяч запросов в секунду без холодного старта.
От чего вы отказываетесь, очевидно в равной степени. Вы не можете загрузить свои собственные дообученные веса или веса LoRA, а также не контролируете железо.
Решение в одной таблице
Самостоятельно развернутый vLLM по сравнению с Telnyx Inference
Сравнения цен относятся к уровню Default. Тарифы за токен различаются в зависимости от модели и уровня; актуальный список см. в разделе цен на API инференса.
Переход — это тот запрос, который у вас уже есть. Укажите базовый URL вашего SDK OpenAI для Telnyx, установите ключ API Telnyx, сохраните массив сообщений и выберите модель на странице цен. Установите для параметра service_tier значение Priority для интерактивного трафика или Flex для фоновых задач.
Что такое vLLM?
vLLM — это движок выводов с открытым исходным кодом для больших языковых моделей. Он планирует запросы, управляет памятью GPU с помощью PagedAttention и предоставляет сервер API, совместимый с OpenAI. Проект зародился в Калифорнийском университете в Беркли и теперь является хостинговым проектом PyTorch Foundation.
Как PagedAttention в vLLM выделяет блоки кэша KV?
При запуске vLLM резервирует часть видеопамяти (VRAM) и делит ее на фиксированные блоки по 16 токенов каждый. Каждый запрос берет блоки из общего пула по мере роста контекста и возвращает их по завершении. Если пул исчерпывается, планировщик вытесняет запросы с более низким приоритетом и пересчитывает их позже.
Как работает кэширование префиксов в vLLM и как его отключить?
vLLM хеширует каждый полный 16-токенный блок промпта. Когда новый запрос начинается с тех же блоков, vLLM повторно использует сохраненный кэш KV вместо его пересчета, что ускоряет префилл. Оно включено по умолчанию; установите enable_prefix_caching=False, чтобы отключить его.
Какие стратегии параллелизма поддерживает vLLM и когда каждую из них следует использовать?
vLLM поддерживает тензорный параллелизм, конвейерный параллелизм, параллелизм данных и экспертный параллелизм. Сначала используйте тензорный параллелизм на GPU одного узла, конвейерный параллелизм между узлами, когда одного узла недостаточно, и независимые реплики за балансировщиком нагрузки для дополнительной пропускной способности на плотных моделях. Встроенный параллелизм данных важен главным образом для моделей со смесью экспертов (MoE).
На каком «железе» работает vLLM?
vLLM работает на GPU NVIDIA и AMD, TPU Google, чипах AWS Trainium и Inferentia, ускорителях Intel Gaudi и XPU, а также на CPU. GPU NVIDIA имеют самую полную поддержку; CPU подходят для тестирования, но не являются целевой платформой для развертывания.
Запускайте модели с открытыми весами без использования GPU
Теперь у вас есть сервер vLLM на одном GPU и изменение в одну строку, которое переносит тот же клиент на GPU, размещенные в Telnyx. Зарегистрируйтесь, чтобы протестировать модели с открытыми весами на локальных GPU по цене до 75% ниже, чем у проприетарных альтернатив, без необходимости управлять инфраструктурой. Начните разработку с Telnyx Inference
Перенесите клиент vLLM на управляемую конечную точку
Когда эксплуатация собственных GPU перестает окупаться, укажите тот же OpenAI-совместимый клиент на Telnyx и получите локальные GPU по цене до 75% ниже, чем у проприетарных альтернатив.
Попробуйте Telnyx Inference