Основные выводы
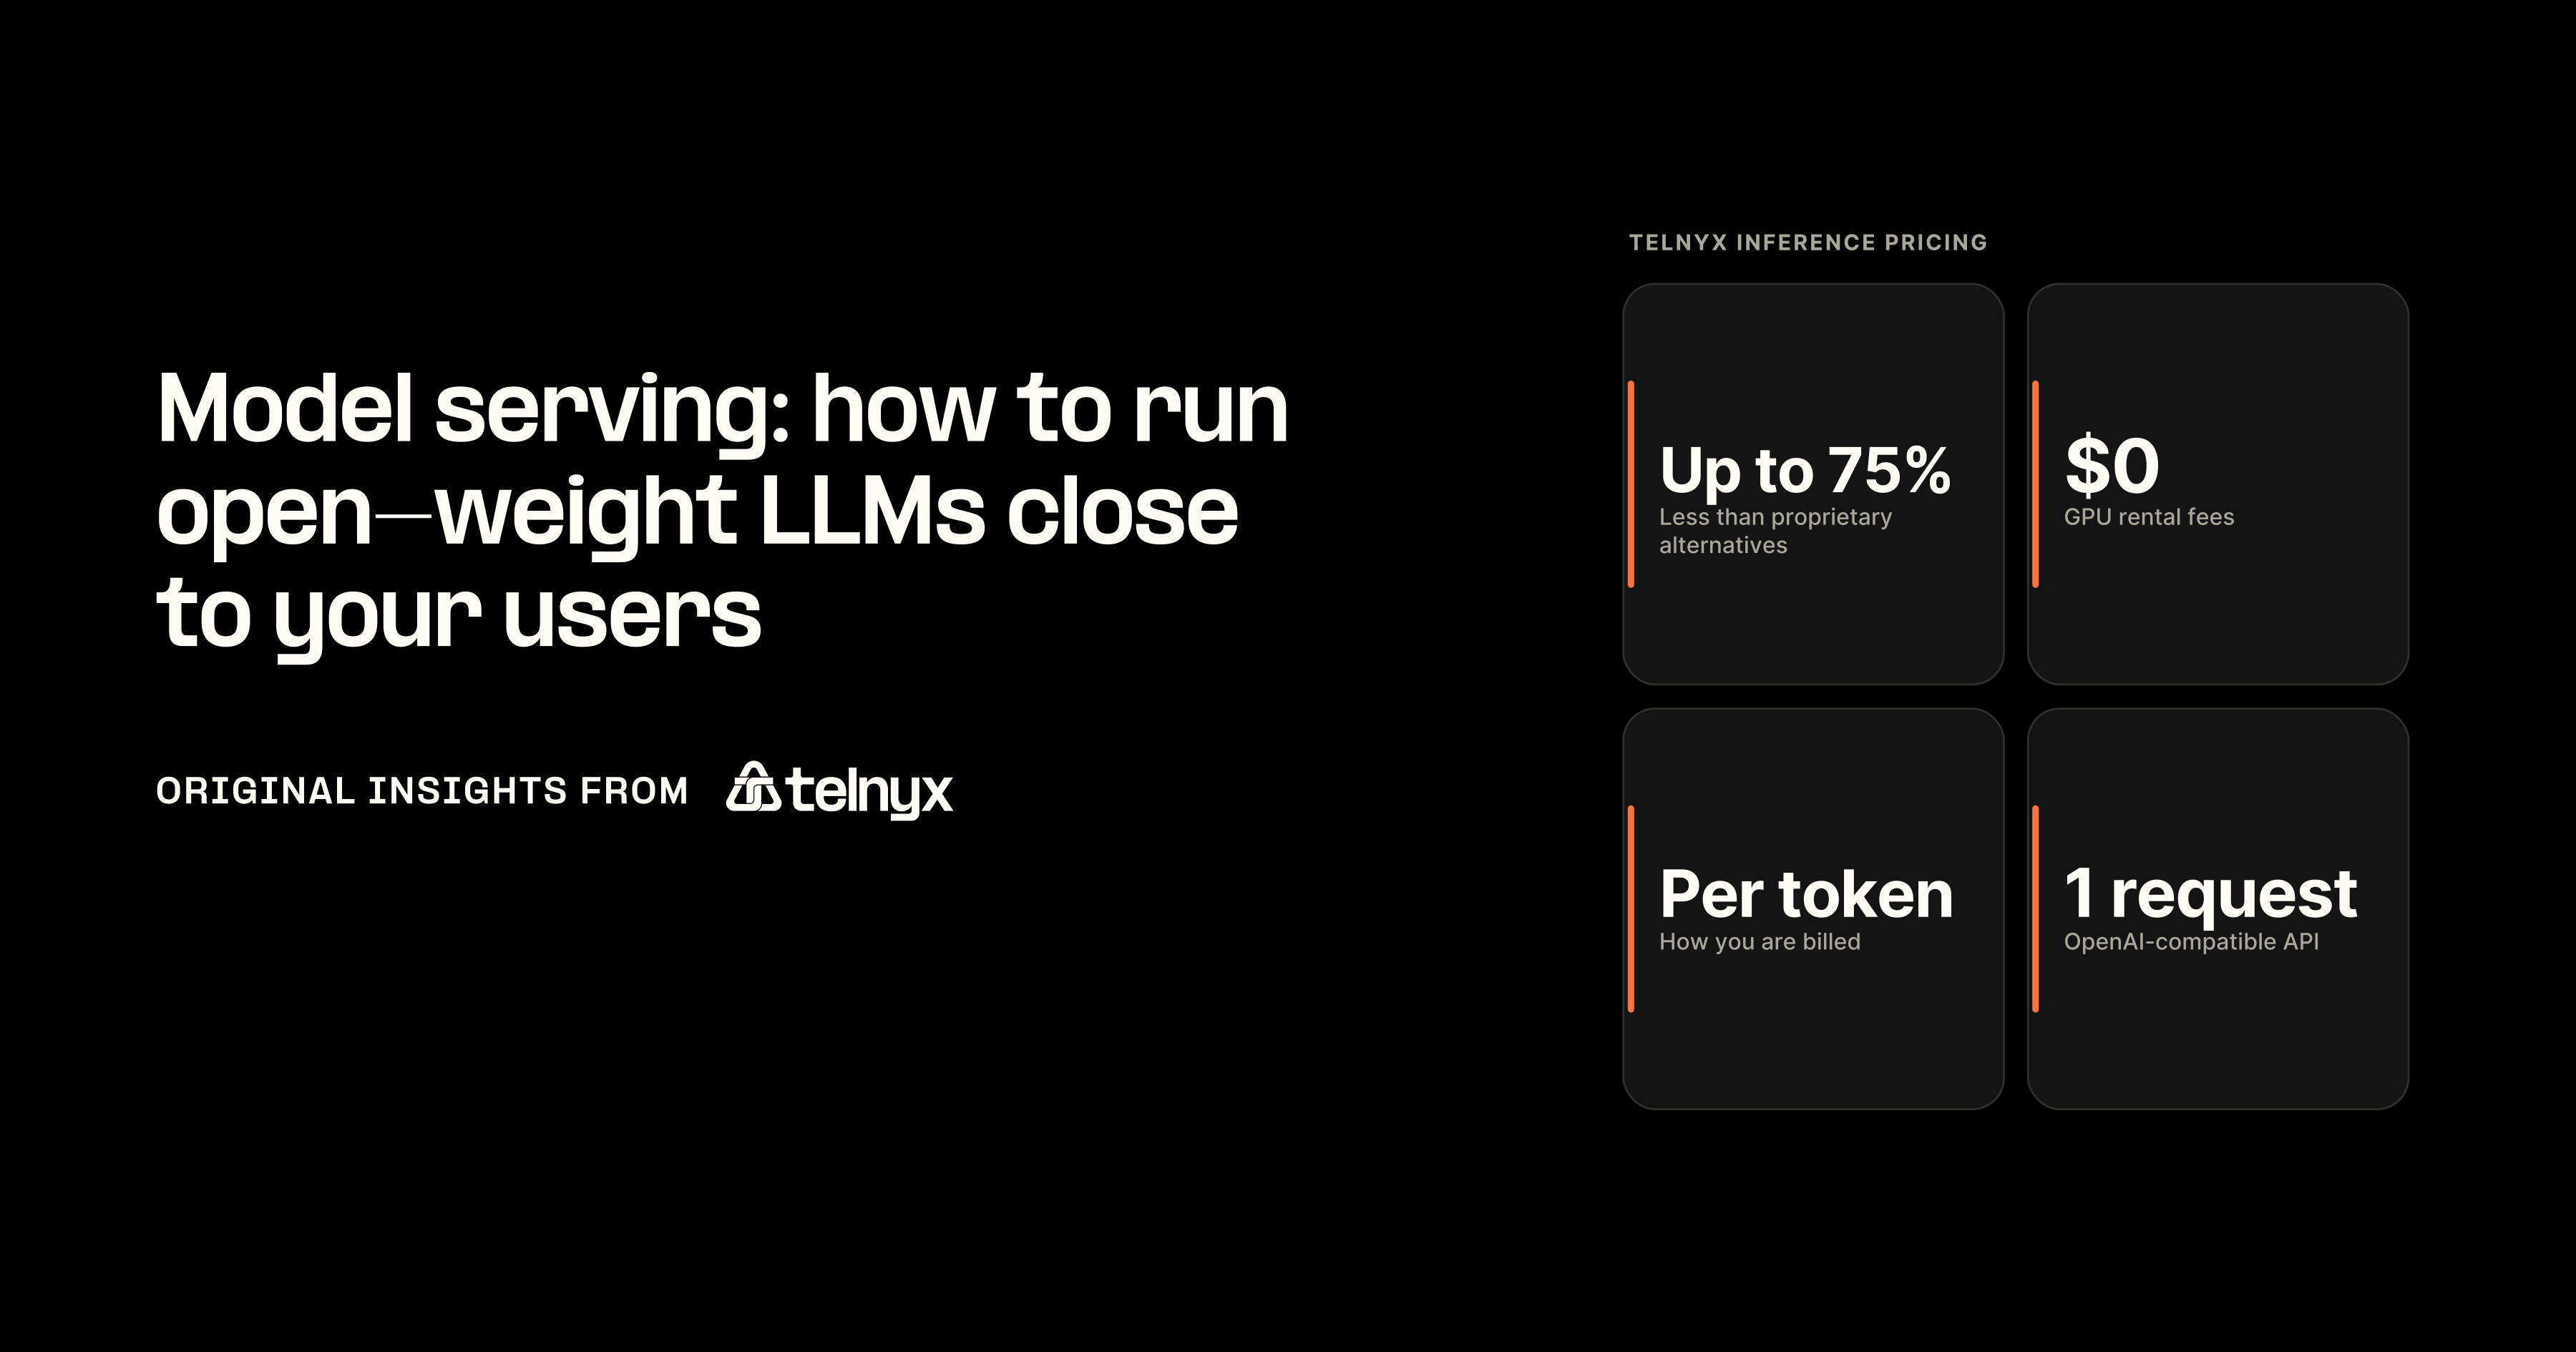
Обслуживание моделей заключается в удержании обученной модели на GPU и обработке запросов через API. В Telnyx это один OpenAI-совместимый запрос к моделям с открытыми весами на собственных GPU рядом с вашими пользователями.
- Каждый стек обслуживания LLM состоит из трех уровней: движок инференса, который генерирует токенов, уровень обслуживания, который предоставляет API, и уровень оркестрации, который масштабирует и маршрутизирует.
- Место запуска модели и уровень обслуживания, используемый запросом, влияют на задержку так же сильно, как и сама модель.
- Telnyx Inference тарифицируется за токен без платы за аренду GPU и стоит до 75% дешевле проприетарных альтернатив.
Что такое обслуживание моделей и почему его сложно запускать
Обслуживание моделей — это процесс удержания обученной модели загруженной на GPU и обработки запросов от приложений через API. Telnyx Inference выполняет эту работу для тщательно подобранной библиотеки моделей с открытыми весами, размещенных на GPU, принадлежащих Telnyx, за OpenAI-совместимым интерфейсом чат-комплитов, без необходимости управлять инфраструктурой.
Заставить модель ответить один раз на одном GPU — это малая часть работы. Поддержание ее ответов для тысяч пользователей при прогнозируемой стоимости — это то, что превращается в батчинг, автоскейлинг, маршрутизацию, региональное размещение и дежурства на телефоне.
Тренировка, инференс и обслуживание — это три разные задачи
Эти три термина часто используются взаимозаменяемо, но каждый из них описывает разную работу, которая происходит в разное время и требует разного оборудования.
- Тренировка производит веса модели. Она происходит один раз для каждой версии модели и требует тренировочного кластера.
- Инференс — это один прогон модели на одном входе. Он происходит при каждом запросе и требует загруженной модели.
- Обслуживание отвечает на множество запросов одновременно через API. Оно работает постоянно и требует GPU, API перед моделью и средство масштабирования.
Обслуживание — это шаг, который превращает развертывание модели в работающий продукт. Это также шаг без финишной прямой: модель должна оставаться загруженной, быстрой и доступной до тех пор, пока кто-то к ней обращается.
Почему обслуживать LLM сложнее, чем обычный API
Типичный веб-API запускается за миллисекунды и обрабатывает каждый запрос индивидуально. Большая языковая модель нарушает оба предположения по трем причинам.
- Размер: веса составляют от нескольких ГБ до десятков ГБ и должны находиться в памяти GPU до того, как придет первый запрос.
- Общая нагрузка: одна обслуживаемая модель обрабатывает множество приложений и пользователей одновременно, поэтому запросы должны батчиться и кешироваться, чтобы GPU не простаивали.
- Параметры времени загрузки: некоторые параметры фиксируются при загрузке модели, поэтому универсальный загрузчик, созданный для небольших моделей, не подходит.
Каждая из этих проблем решается отдельным программным обеспечением. Вот почему обслуживание LLM представляет собой стек слоев, а не единую программу.
Попробуйте Telnyx Inference для запуска моделей с открытыми весами на собственных GPU рядом с вашими пользователями с помощью одного OpenAI-совместимого запроса.
Как работает инфраструктура обслуживания LLM, слой за слоем
В Telnyx вы видите один слой стека: OpenAI-совместимую конечную точку. Telnyx запускает остальные два на собственной GPU-инфраструктуре, которая обрабатывает параллельные запросы и масштабируется автоматически.
Просмотр одного запроса от GPU вверх показывает, что делает каждый слой и что командам, развертывающим все самостоятельно, приходится строить для каждого из них.
Движок инференса
Движок инференса загружает веса в память GPU и генерирует токены. vLLM является наиболее распространенным движком с открытым исходным кодом, и три метода делают такие движки эффективными:
- Непрерывный батчинг позволяет новому запросу присоединиться к уже выполняющемуся батчу, поэтому GPU не простаивает в ожидании завершения самого медленного запроса в батче.
- Кеширование префиксов повторно использует работу, уже проделанную для промптов, начинающихся одинаково, например, общий системный промпт или длинный документ, повторно используемый в разных диалогах.
- Квантование сохраняет веса с меньшей точностью, так что модели требуется меньше памяти GPU, ценой некоторой потери точности.
Движок, настроенный с помощью этих методов, делает один репликат быстрым. Он сам по себе ничего не делает для аутентификации, стриминга клиентам или распределения трафика между множеством репликатов.
Уровень обслуживания и его API
Уровень обслуживания представляет модель в виде эндпоинта, аутентифицирует вызывающих абонентов и возвращает токены по мере их генерации движком. Формат чат-комплитов OpenAI стал здесь стандартом, поэтому существующие SDK работают без изменений с любым совместимым эндпоинтом. KServe является примером с открытым исходным кодом для команд, запускающих собственный стек на Kubernetes.
Это также уровень, по которому большинство команд оценивают провайдера. Вопросы, имеющие значение при выборе LLM API для продакшена, такие как поведение стриминга, лимиты запросов и обработка данных, решаются здесь.
Уровень оркестрации
Уровень оркестрации размещает реплики моделей на GPU, масштабирует их вверх и вниз и маршрутизирует каждый запрос к реплике. Kubernetes является обычной базой для самостоятельно управляемых стеков.
Маршрутизация важна, потому что запрос LLM имеет две фазы с разными потребностями. Префилл обрабатывает весь промпт и является ресурсоемким. Декодирование генерирует токены по одному и чувствительно к задержкам. Маршрутизатор, который знает, какая реплика уже содержит кешированный префикс промпта, может полностью пропустить повторяющуюся работу префилла.
Результат маршрутизации: маршрутизация запросов по кешу вместо кругового перебора (round-robin) обеспечила до ~57 раз более быстрый показатель P90 TTFT и увеличила пропускную способность с ~4 400 до ~8 730 токенов/сек, согласно публикациям проекта llm-d, цитируемым KServe и llm-d.
Движок устанавливает верхний предел для одного репликата. Маршрутизация определяет, насколько близко каждый запрос приближается к этому пределу, поэтому именно оркестрация, а не выбор модели, определяет производительность обслуживания.
Где выполняется обслуживание LLM, определяет, насколько быстрым оно кажется
Telnyx запускает инференс в регионах по всей Америке, Европе, Ближнему Востоку и Африке (MENA), а также в Азиатско-Тихоокеанском регионе (APAC) на GPU, размещенных в том же дата-центре, что и сеть, обслуживающая ваших пользователей, с нулевым хранением данных. Это размещение имеет значение, потому что пользователи ощущают скорость обслуживания через четыре числа, и расстояние проявляется в первом из них.
Четыре показателя, описывающих скорость обслуживания
Четыре метрики описывают скорость обслуживания, и каждая из них соответствует чему-то, что замечает пользователь.
- Время до первого токена (TTFT) измеряет, сколько времени проходит до начала ответа, и когда оно велико, пользователь ждет в тишине.
- Задержка между токенами (ITL) измеряет разрыв между стриминговыми токенами, и когда она высока, ответ заикается на экране или в голосе.
- Пропускная способность измеряет токены в секунду для всех пользователей, и когда она низкая, каждый запрос обходится дороже в обслуживании.
- Хвостовая задержка (P90 или P99) измеряет то, какими кажутся самые медленные запросы, и когда она высока, небольшая доля пользователей получает гораздо худший опыт, чем предполагает среднее значение.
Движки и маршрутизаторы в основном работают над ITL, пропускной способностью и хвостом. TTFT также зависит от того, что никакой движок не может исправить: расстояния между пользователем и GPU.
Обслуживание в том же регионе, что и ваши пользователи
Каждый сетевой круговой путь (round trip) между пользователем и GPU добавляется к TTFT. Модель, обслуживаемая в другом регионе, начинает каждый ответ с опозданием, каким бы быстрым ни был движок. Страница продукта Telnyx прямо описывает этот подход: «Никаких переходов между провайдерами, никакой трансграничной маршрутизации, никакого обучения на ваших данных».
Та же логика побудила Telnyx создать совмещенную инфраструктуру для голосового ИИ, где графические процессоры размещены рядом с ядром телефонии, чтобы аудиоданные никогда не передавались через публичный интернет для достижения модели.
«Но в продакшене задержка часто связана не с одной медленной моделью, а с особенностями архитектуры: где поступает вызов, где закрепляется медиапоток, где запускается STT, где запускается LLM, где запускается TTS и сколько границ вендоров или облаков пересекает аудио по пути». Джеймс Уэдби (James Whedbee), вице-президент по инжинирингу в Telnyx
Преобразование текста в речь, голосовой ИИ и телефония работают на той же инфраструктуре Telnyx, что и инференс. Вызов модели голосового агента остается в той сети, в которую поступил вызов, а не покидает ее ради стороннего вендора инференса.
Выбор емкости обслуживания для каждого запроса
Telnyx выбирает емкость обслуживания для каждого запроса с помощью одного поля в теле запроса — service_tier. Если опустить его, запрос выполняется в режиме Default. Установите значение priority или flex, чтобы сбалансировать цену и задержку исключительно для этого запроса.
- Default: стандартная емкость обслуживания по стандартным тарифам; этот вариант получает каждый запрос, если поле service_tier не указано.
- Priority: емкость, оптимизированная для интерактивных рабочих нагрузок с низким уровнем задержек, включая голосовую оркестрацию. Она сохраняет ту же модель и контекстное окно по другому тарифу и доступна для определенных моделей.
- Flex: самые низкие тарифы, созданные для фоновых задач, таких как автономная оценка, обработка документов и фоновое суммирование, где допустимы минуты сквозной задержки. Все запросы остаются синхронными, а режим Flex доступен в США для выбранных моделей.
Саморазворачиваемый стек получает аналогичное разделение за счет запуска второго пула графических процессоров для интерактивного трафика или очереди для фоновых задач. В Telnyx один и тот же ID модели и тот же эндпоинт могут использоваться для интерактивного голосового диалога и ночной задачи суммирования, а различать их помогает одно поле.
Хостинг моделей ИИ: запуск стека или вызов API
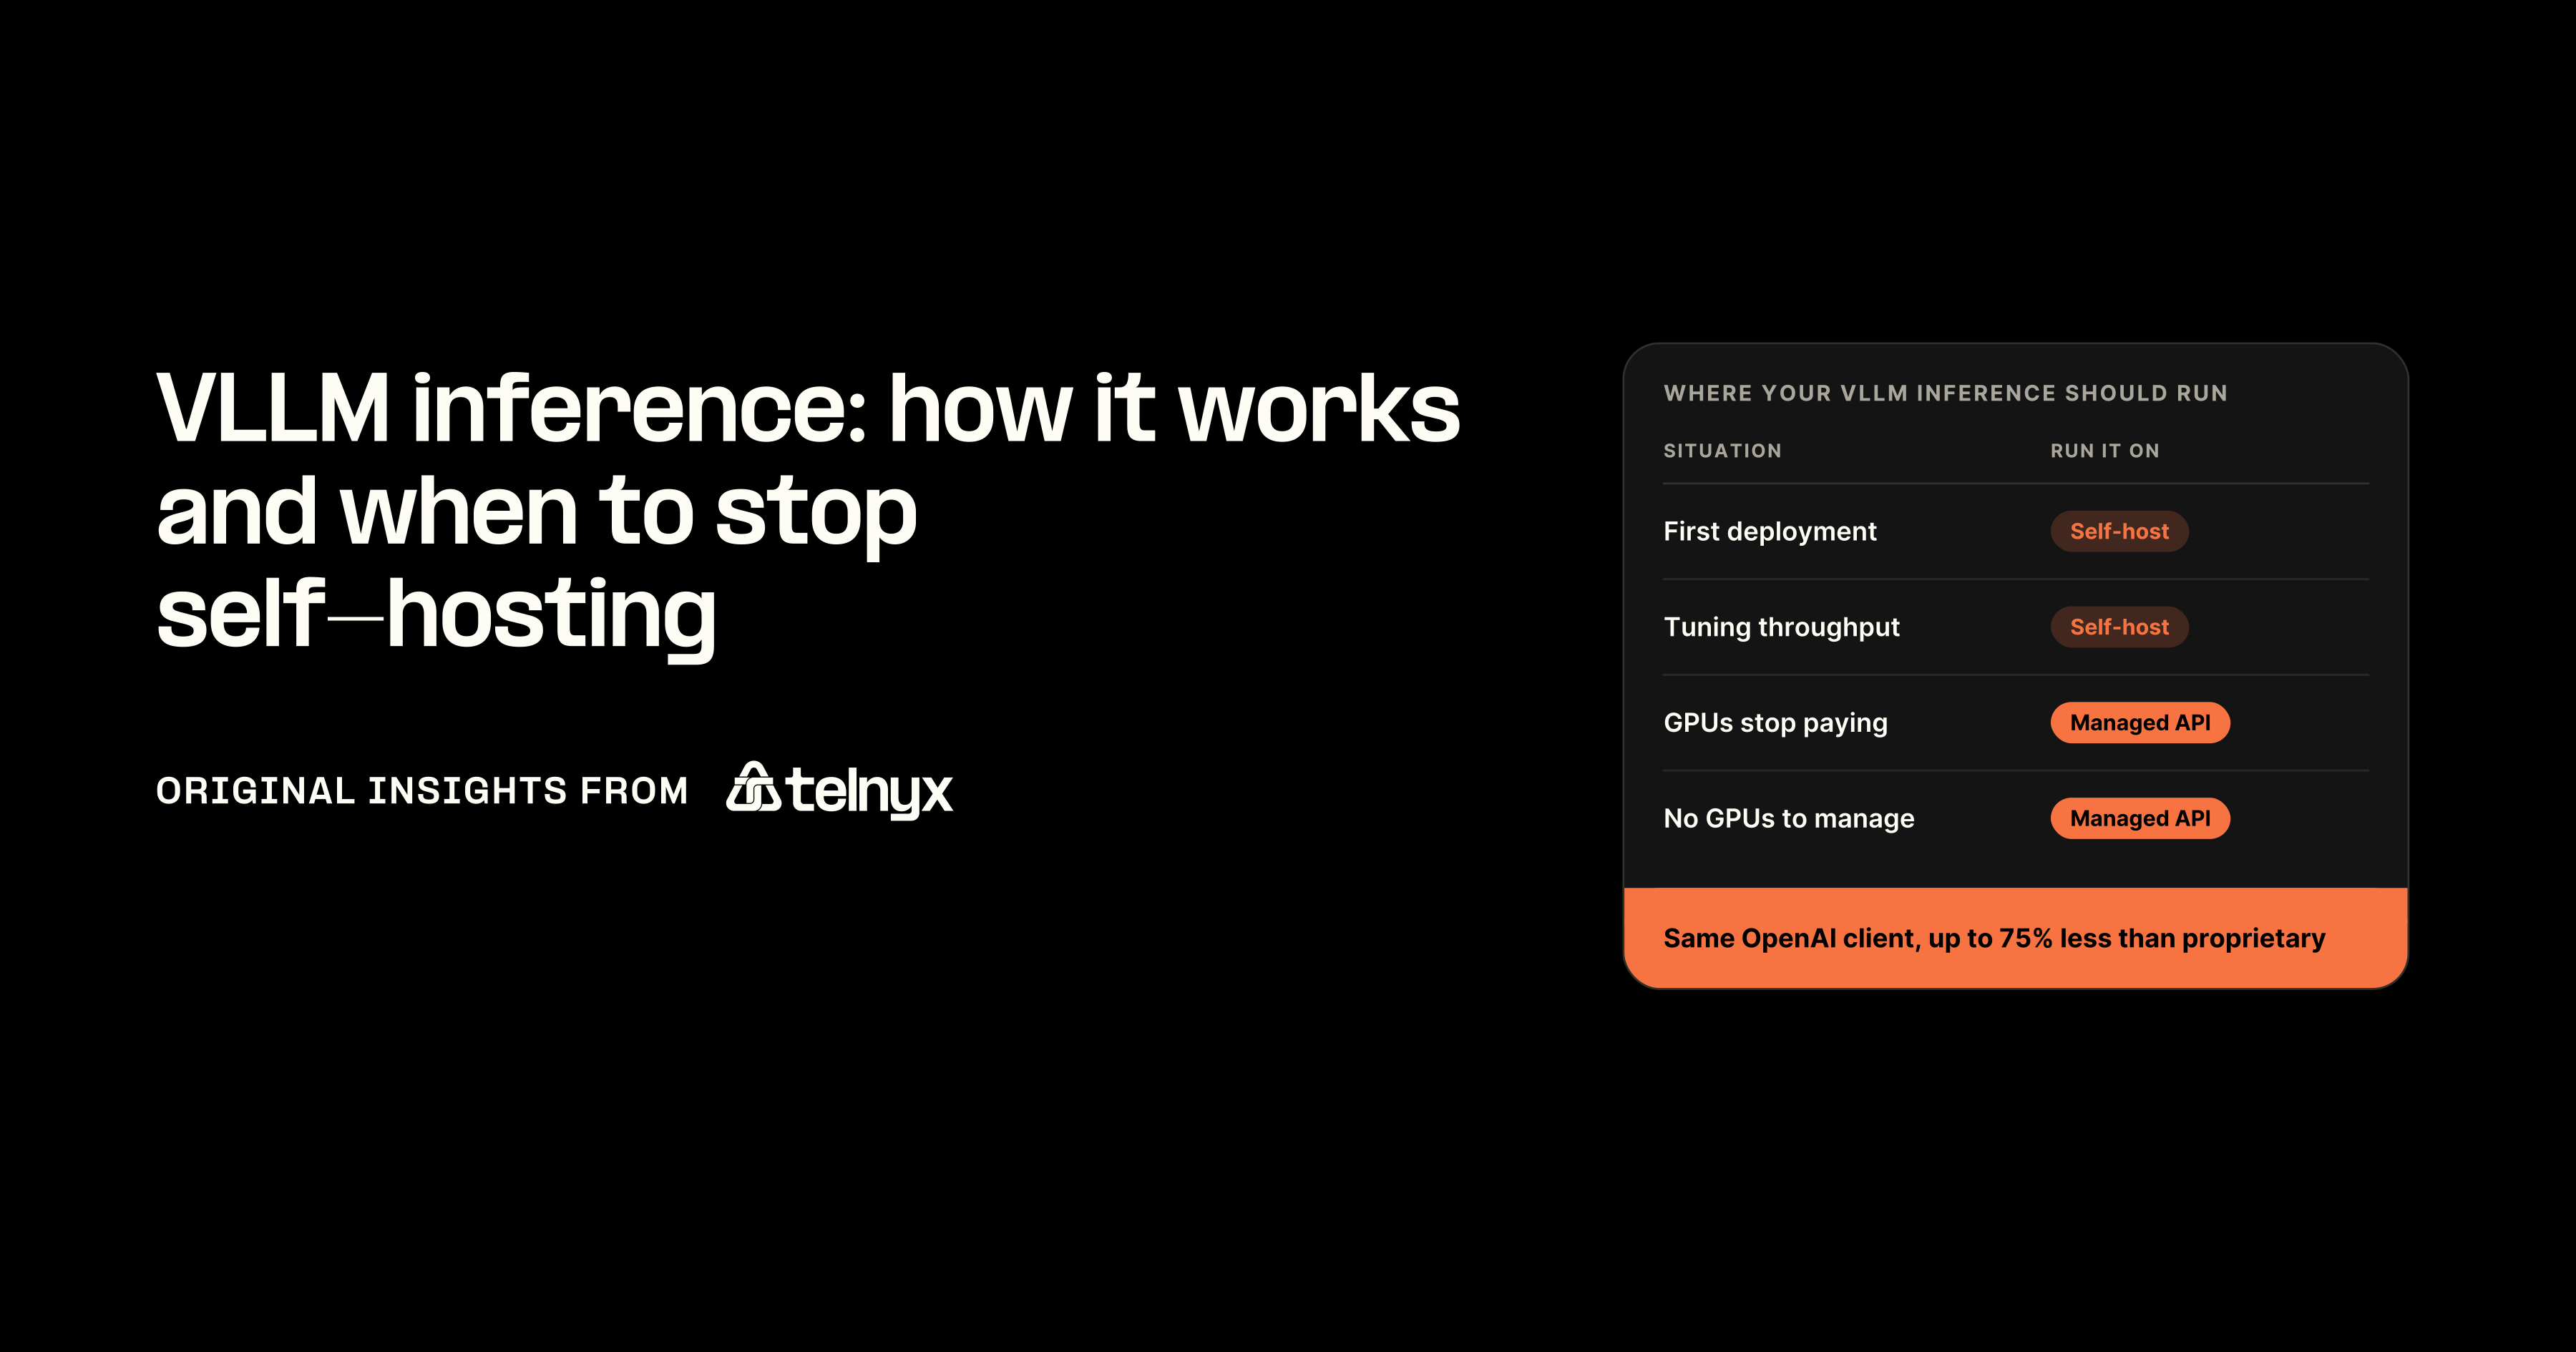
Telnyx Inference — это бессерверный инференс с оплатой за токен. Тарифы до 75% ниже по сравнению с проприетарными альтернативами, а кэшированный ввод дешевле на величину до 88%. Альтернативой является самохостинг, который означает аренду или покупку графических процессоров и самостоятельный запуск всех трех слоев из предыдущего раздела.
Стоит ли запускать собственный стек обслуживания или вызывать API?
Выберите вариант, который соответствует вашему трафику и вашей модели, чтобы понять, в каком направлении двигаться.
Вызывайте API и платите за токен
Саморазворачиваемая реплика выставляет счет за графический процессор каждый час, включая тихие часы между пиковыми нагрузками. При оплате за токен и отсутствии платы за аренду GPU время простоя ничего не стоит. Провайдер также удерживает загруженными от нескольких гигабайт до десятков гигабайт весов, поэтому внезапный всплеск нагрузки не заставляет ждать холодного старта.
До: два графических процессора, зарезервированные круглосуточно для ассистента, который занят всего несколько часов в день. После: счет за токенами, который падает до нуля ночью.
Начинайте с API, тестируйте перед переходом
Владение стеком окупается только тогда, когда графические процессоры загружены круглосуточно. Это единственный случай, когда стоимость часа работы GPU, распределенная по множеству токенов, может оказаться ниже цены за токен. Но даже в этом случае вы берете на себя настройку vLLM, KServe или аналогичного слоя на Kubernetes, автомасштабирование и дежурства.
Сначала измерьте ваш месячный объем токенов при использовании API. Кластер на собственном хостинге должен перекрыть этот счет, а в его стоимость входят инженеры, которые им управляют.
Запускайте собственный стек для кастомных весов
Библиотека готовых решений обслуживает модели, выбранные провайдером, поэтому обученные вами веса в нее не попадут. Для их загрузки вам понадобится такой движок, как vLLM, слой обслуживания для их публикации и оркестрация для масштабирования.
Прежде чем принимать решение, проверьте, не окажется ли стандартная модель с открытыми весами и сильной системной подсказкой достаточно близкой по качеству. Кэширование префиксов делает длинный общий системный промпт дешевым для повторного использования в каждом запросе, и это часто устраняет разрыв без дообучения (fine-tuning).
Самостоятельный хостинг: граница API как главное препятствие
Если политика безопасности запрещает покидать инфраструктуру, находящуюся под вашим контролем, любой хостинговый эндпоинт не пройдет проверку, независимо от его цены и задержки. Планируйте все три слоя. Заложите в бюджет память GPU для хранения от нескольких гигабайт до десятков гигабайт весов на модель, а также запас для непрерывной пакетной обработки (continuous batching).
В любом случае используйте формат чата OpenAI (chat completions) на вашем внутреннем эндпоинте. Если политика впоследствии смягчится, переход к хостинговому провайдеру сведется к изменению базового URL-адреса вместо полного переписывания кода.
Замените базовый URL и имя модели
Поскольку эндпоинт совместим с OpenAI, ваши существующие SDK, код потоковой передачи (streaming) и логика повторных попыток остаются прежними. Меняются только конфигурация клиента и строка модели.
Перед переводом продакшн-трафика запустите одинаковые тестовые запросы для обеих моделей. Модель с открытыми весами может отвечать иначе, даже если структура API идентична.
До: OpenAI(api_key=OPENAI_KEY) с закрытой моделью. После: OpenAI(api_key=TELNYX_API_KEY, base_url="https://api.telnyx.com/v2/ai") с моделью с открытыми весами из библиотеки.
Выбор редко касается самой модели. Оба пути могут обслуживать одни и те же открытые веса, поэтому решение сводится к тому, кто берет на себя операционную работу.
Что включает в себя хостинговый инференс на Telnyx
Приведенное ниже сравнение охватывает затраты, которые команда несет после того, как первая модель начинает отвечать, строка за строкой.
Сравнение LLM-хостинга своими силами с Telnyx Inference
Модель ценообразования — это параметр, который сильнее всего влияет на составление бюджета. Почасовая оплата GPU стоит одинаково, обслуживает ли она один запрос или десять тысяч, в то время как цены за токен меняются в зависимости от реального использования.
Ценообразование: Никакой платы за аренду GPU, никаких надбавок за вычисления, никаких минимальных платежей. Тарифы за токен зависят от модели и уровня обслуживания. Актуальные тарифы для каждой модели указаны на странице цен на инференс.
Как принять решение
Четыре вопроса определяют большинство решений о хостинге. Ответьте на них, прежде чем сравнивать тарифы за токен с ценами за час работы GPU.
- Есть ли у вас специалисты для круглосуточного обслуживания движка, слоя API и оркестратора? Если нет, хостинговый эндпоинт избавляет от дежурств, которые требуются при самостоятельном хостинге.
- Является ли ваш трафик достаточно стабильным, чтобы арендованные GPU были постоянно загружены? Почасовая оплата GPU окупается только при постоянной нагрузке, а скачкообразный трафик заставляет вас платить за простаивающие мощности между пиками.
- Где должны обрабатываться запросы ваших пользователей? Если данные должны оставаться в определенном регионе, убедитесь, что провайдер запускает инференс именно там, а не только хранит данные.
- Как часто вы будете менять модели? Если лучшая модель для вашей рабочей нагрузки часто меняется, изменить поле в запросе намного дешевле, чем переразвертывать и перенастраивать кластер.
Команды с выделенной инфраструктурной группой, стабильной нагрузкой и необходимостью модифицировать веса имеют веские основания для самостоятельного хостинга. Командам, у которых отсутствует хотя бы одно из этих условий, следует рассчитать стоимость дежурств и управления емкостью, прежде чем предполагать, что часы работы GPU — это более дешевый путь.
Обслуживание LLM с открытыми весами с помощью одного запроса
В Telnyx обслуживание одной из хостинговых моделей с открытыми весами выполняется посредством POST-запроса на https://api.telnyx.com/v2/ai/chat/completions с указанием имени модели в теле запроса. Движок, слой API и оркестрация за этим URL уже запущены.
Запрос, который заменяет стек
Запустите это из терминала, предварительно установив ваш API-ключ Telnyx в качестве переменной окружения TELNYX_API_KEY:
Shell
curl -i -X POST "https://api.telnyx.com/v2/ai/chat/completions" \ -H "Authorization: Bearer $TELNYX_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "moonshotai/Kimi-K3", "messages": [{"role": "user", "content": "Hello, World!"}] }'
Запрос состоит из трех частей. Bearer-ключ в заголовоке Authorization идентифицирует вашу учетную запись. Поле model выбирает модель — в данном случае moonshotai/Kimi-K3 от Moonshot AI. Массив messages использует формат чата OpenAI, поэтому существующие SDK OpenAI будут работать, как только базовый URL будет указывать на Telnyx. Не нужно скачивать модели, резервировать GPU или настраивать количество реплик.
Переключение моделей без переписывания кода
Смена модели означает изменение строки с ее названием. Telnyx добавляет модели с открытыми весами от z.ai, DeepSeek, Minimax и других по мере их выхода, а актуальный список представлен на странице цен на инференс.
«Конкуренция в сфере связи жесткая, но я рад, что не участвую в битве платформ базовых моделей. Каждую неделю в лидеры выбивается новый претендент. В мире ИИ нет преданности». Дэвид Казем, генеральный директор Telnyx
Когда лучшая модель меняется так часто, стек, настроенный под одну конкретную модель, становится уязвимостью. Хранение модели в виде простой строки в запросе позволяет команде протестировать новый релиз в день его выхода. Для структурированного вывода режим JSON и ограничения на основе регулярных выражений заставляют ответ соответствовать определенной схеме, что важно, когда результат парсит другая программа.
Путь от первого запроса до рабочих настроек состоит из четырех шагов:
- Отправьте приведенный выше запрос со своим API-ключом Telnyx.
- Измените строку модели для переключения, используя список на странице цен.
- Оставьте service_tier пустым для выбора стандартной емкости (Default) или установите значение priority или flex.
- Включите режим JSON или ограничение по регулярному выражению, когда вывод должен соответствовать схеме.
Часто задаваемые вопросы
Что такое архитектура обслуживания моделей?
Архитектура обслуживания моделей — это организация трех слоев, которая принимает запрос к загруженной модели и возвращает токены. Инференс-движок генерирует токены на GPU, слой обслуживания предоставляет API и потоковую передачу ответов, а слой оркестрации размещает реплики, масштабирует их и маршрутизирует запросы. В Telnyx все три компонента находятся за единой конечной точкой, совместимой с OpenAI.
В чем разница между синхронным и асинхронным обслуживанием моделей?
Синхронное обслуживание означает, что клиент удерживает соединение открытым и получает ответ, обычно передаваемый токен за токеном. Асинхронное обслуживание ставит задачу в очередь и возвращает результат позже, что подходит для пакетной обработки. В Telnyx уровень Flex охватывает фоновые задачи по самым низким тарифам, но все запросы остаются синхронными, поэтому не нужно интегрировать отдельную очередь.
Как выбрать между vLLM, SGLang и TensorRT-LLM?
Сравнивайте их на своем «железе» и для своих рабочих нагрузок, а не по главным бенчмаркам. vLLM работает на оборудовании от нескольких производителей. SGLang автоматически повторно использует общие префиксы промптов, что помогает в работе чатов и агентов с повторяющимся контекстом. TensorRT-LLM — это библиотека NVIDIA, работающая только на GPU от NVIDIA. На размещенном эндпоинте, таком как Telnyx Inference, движок выбирается и настраивается за вас.
Какая инфраструктура необходима для обеспечения высокой доступности обслуживания моделей?
Самостоятельно развертываемое решение требует более одной реплики на модель, проверки работоспособности (health checks), которые исключают сбойные реплики из работы, и автомасштабирования, привязанного к нагрузке по запросам. Ему также необходим резерв мощности для пиков трафика, так как загрузка большой модели на новый GPU может занять минуты. В Telnyx инфраструктура собственных GPU обрабатывает параллельные запросы и масштабируется автоматически, без планирования емкости и «холодных стартов».
Как оптимизировать затраты на обслуживание LLM при сохранении производительности?
При самостоятельном хостинге два главных рычага — это максимальная загрузка GPU с помощью батчинга (пакетной обработки) и кэширования, а также уменьшение простаивающих мощностей при падении трафика. Направление запросов с общими префиксами на одну и ту же реплику также сокращает повторную работу по префиллингу. В Telnyx уровень Flex предлагает самые низкие тарифы для фоновых задач, кэшированный ввод дешевле до 88%, а цены на услуги до 75% ниже по сравнению с проприетарными альтернативами.
Запускайте модели с открытыми весами без необходимости администрировать стек
Отправляйте один совместимый с OpenAI запрос и запускайте модели с открытыми весами в регионе ваших пользователей на GPU, принадлежащих Telnyx, без необходимости чем-либо управлять. Стоимость до 75% ниже по сравнению с проприетарными альтернативами при нулевом удержании данных.
Начать разработку
Запускайте LLM с открытыми весами рядом с вашими пользователями
Telnyx Inference запускает тщательно подобранную библиотеку моделей с открытыми весами на GPU, принадлежащих Telnyx, с оплатой за токен без платы за аренду графических процессоров и без необходимости управлять инфраструктурой.
Начать разработку