В течение многих лет индустрия наблюдаемости была сосредоточена на одной главной цели: сборе большего объема телеметрии. Организации инвестировали в метрики, логи, трассировки, события и все более сложные платформы мониторинга, чтобы улучшить видимость своих систем. Эти инвестиции окупились. Современные инженерные команды теперь могут наблюдать практически за каждым компонентом распределенного приложения: от кластеров Kubernetes и облачной инфраструктуры до API, баз данных и отдельных микросервисов.
Однако, несмотря на эту беспрецедентную видимость, остается одна фундаментальная проблема. Во время инцидента в рабочей среде инженерные команды часто тратят гораздо больше времени на попытки понять, что происходит, чем на фактическое устранение проблемы.
Проблема не в недостатке информации. Во многих организациях ее даже слишком много. Одна проблема, с которой сталкивается клиент, может вызвать десятки оповещений в приложениях, инфраструктуре, облачных сервисах, базах данных, сетевых компонентах и системах безопасности. Каждое оповещение может быть точным. Каждое может указывать на реальный симптом. Но перед специалистами по реагированию по-прежнему стоит сложная задача: определить, какие оповещения связаны между собой, какие являются просто вторичными эффектами и с чего на самом деле следует начинать расследование.
Это одна из определяющих операционных проблем, стоящих перед современными инженерными организациями. Следующий этап эволюции наблюдаемости заключается не в сборе большего объема телеметрии. Он заключается в преобразовании этой телеметрии в операционное понимание.
Операционное понимание — это способность выйти за рамки изолированных сигналов и увидеть полную операционную картину. Оно позволяет инженерным командам быстро распознавать, как кажущиеся независимыми события связаны друг с другом, понимать масштаб инцидента и уверенно приступать к устранению первопричины. По мере того как организации продолжают внедрять операции с поддержкой ИИ и, в конечном итоге, автономные операции, это понимание становится все более важным. Системы ИИ, как и инженеры, могут принимать правильные решения только тогда, когда они начинают с ясной и связной картины того, что происходит на самом деле.
Вот почему New Relic считает, что операционное понимание представляет собой следующий критически важный уровень в эволюции интеллектуальной наблюдаемости.
Скрытые издержки фрагментированных операций
Современные программные системы никогда не проектировались так, чтобы выходить из строя простыми способами. Сегодняшние приложения состоят из сотен взаимосвязанных сервисов, работающих в нескольких облачных провайдерах, кластерах Kubernetes, контейнерах, API, базах данных и сторонних сервисах. Хотя такая архитектура позволяет организациям быстрее внедрять инновации и эффективнее масштабироваться, она также создает совершенно новый уровень операционной сложности.
Подумайте, что происходит, когда в одном сервисе, с которым взаимодействует клиент, начинает наблюдаться повышенная задержка. В течение нескольких секунд системы мониторинга могут обнаружить увеличение времени отклика, использование инфраструктуры, неудачные транзакции, исключения в приложениях, ограничения ресурсов Kubernetes, снижение производительности базы данных и сетевые аномалии. Каждое правило мониторинга работает именно так, как задумано, генерируя оповещение. С точки зрения платформы мониторинга все работает правильно.
Однако с точки зрения инженера, получающего эти оповещения, ситуация выглядит совсем иначе.
Вместо того чтобы сразу понять операционную проблему, специалист по реагированию сталкивается с растущей коллекцией независимых уведомлений, которые необходимо оценить, сравнить и упорядочить, прежде чем можно будет начать значимое расследование. Разные команды могут получать разные оповещения, описывающие разные симптомы одной и той же основной проблемы. Часто несколько инженеров начинают отдельные расследования, каждый из которых работает только с частью доступной информации. Драгоценное время тратится на сбор истории воедино, а не на решение проблемы.
Этот скрытый операционный налог редко измеряется напрямую, но он затрагивает почти каждую инженерную организацию. Он увеличивает среднее время устранения (MTTR), дублирует усилия по расследованию, замедляет совместную работу и потребляет инженерные ресурсы, которые в противном случае могли бы быть потрачены на повышение надежности или предоставление новых возможностей клиентам.
Многие организации вполне обоснованно называют это «усталостью от оповещений». На самом деле проблема гораздо глубже.
Проблема не просто в том, что оповещений слишком много. Проблема в том, что недостаточно операционного понимания, связывающего эти оповещения в значимую картину.
Лучшие сигналы — это лишь часть ответа
За последние несколько лет индустрия наблюдаемости добилась значительного прогресса в улучшении качества отдельных оповещений. Динамические пороги, обнаружение аномалий, машинное обучение и рекомендации с поддержкой ИИ помогли организациям сократить количество ненужных уведомлений, создавая при этом более значимые операционные сигналы.
Это важный шаг вперед. Более качественные оповещения позволяют инженерным командам сосредоточиться на событиях, которые действительно требуют внимания, вместо того чтобы постоянно фильтровать ложные срабатывания и малоценные уведомления.
Однако улучшение отдельных сигналов решает лишь часть более масштабной операционной проблемы.
Даже когда каждое оповещение точно, специалисты по реагированию все равно должны определить, как эти оповещения связаны друг с другом. Объясняет ли оповещение базы данных замедление работы приложения, или это просто еще один симптом? Описывают ли оповещения инфраструктуры то же самое влияние на клиента, которое уже было выявлено в другом месте? Какие сигналы представляют собой основную проблему, а какие просто отражают последствия?
Эти вопросы по-прежнему требуют значительных человеческих усилий, поскольку большинство систем мониторинга представляют оповещения по отдельности, а не коллективно.
Это различие становится все более важным в рамках стратегии интеллектуальной наблюдаемости New Relic.
Smart Alerts фокусируется на улучшении качества операционных сигналов. Помогая организациям создавать более эффективные условия оповещения и интеллектуально выявлять пробелы в мониторинге, Smart Alerts снижает ненужный шум, повышая уверенность в том, что важные операционные события обнаруживаются быстро и точно.
Эта более прочная основа сигналов необходима. Но одни лишь надежные сигналы не создают автоматически надежного понимания.
Инженерным командам по-прежнему нужен способ собрать эти сигналы в связную операционную картину, прежде чем начнется расследование.
Создание фундамента для автономных операций
Именно здесь начинается следующая эволюция автономных операций.
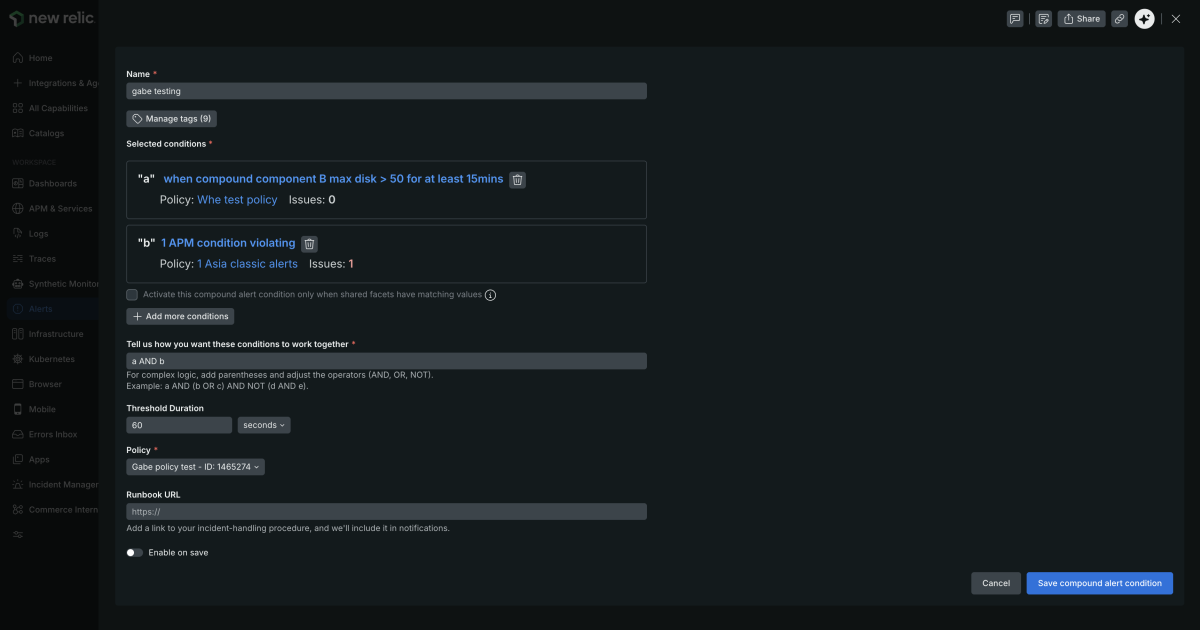
Вместо того чтобы просить специалистов по реагированию вручную определять, какие оповещения относятся друг к другу, сама платформа наблюдаемости должна помогать собирать операционную картину. Связанные условия оповещения больше не должны появляться как изолированные события, требующие независимого расследования. Вместо этого они должны интеллектуально коррелироваться в действенные проблемы, которые представляют более широкую операционную ситуацию, с которой сталкивается инженерная команда.
Операционный контекст ценен для современных инженерных команд, но его важность становится еще выше по мере того, как организации внедряют ИИ во все свои операционные рабочие процессы.
Искусственный интеллект превосходно справляется с анализом информации, выявлением закономерностей и ускорением принятия решений. Однако системы ИИ сталкиваются с той же проблемой, что и люди-операторы, когда им предоставляются фрагментированные операционные данные. Если общую картину приходится сначала восстанавливать из десятков независимых оповещений, ни люди, ни агенты ИИ не смогут эффективно анализировать проблему.
Поэтому для автономных операций требуется нечто большее, чем просто интеллектуальные агенты. Требуется прогрессивно повышающееся качество операционной аналитики на каждом этапе рабочего процесса.
New Relic рассматривает это развитие как непрерывную эволюцию, а не как набор независимых продуктов.
Телеметрия фиксирует происходящее в приложениях, инфраструктуре, сервисах и облачных средах. Smart Alerts преобразует эту телеметрию в надежные операционные сигналы, заслуживающие внимания. Compound Alerts опирается на эти надежные сигналы для формирования операционного понимания путем корреляции связанных условий оповещения в решаемые проблемы. Ground Truth обогащает эти проблемы надежным операционным контекстом, полученным из всей технологической среды. Наконец, Autopilot использует это понимание и контекст, чтобы помогать инженерам в расследовании сегодня, закладывая основу для все более автономных операционных рабочих процессов в будущем.
Каждый уровень повышает качество операционной аналитики перед передачей ее на следующий уровень.
Рассматриваемые по отдельности, каждая из этих возможностей приносит значимую ценность для клиентов. Рассматриваемые вместе, они представляют собой новый подход к интеллектуальной наблюдаемости — подход, который фокусируется не просто на сборе большего объема операционных данных, а на постоянном улучшении качества операционного понимания.
Следующая глава интеллектуальной наблюдаемости
Наблюдаемость уже изменила то, как организации понимают свои системы. Эра «сверхчеловеческих» возможностей — это следующая возможность изменить то, как они понимают операционные проблемы.
Поскольку сложность сред продолжает расти, а ИИ становится фундаментальным компонентом инженерных операций, преуспеют не те организации, которые собирают больше всего телеметрии. Преуспеют те, кто сможет преобразовать эту телеметрию в понимание, контекст и, в конечном итоге, в действия.
Вот почему New Relic рассматривает Compound Alerts как нечто большее, чем просто еще одну функцию оповещения. Это важный шаг в эволюции отрасли от сбора сигналов к операционному пониманию. Помогая инженерным командам начинать каждое расследование с более ясной картины проблемы, Compound Alerts снижает операционные трения сегодня, закладывая фундамент для систем автономных операций завтрашнего дня.
Будущее наблюдаемости будет определяться не объемом собираемых нами данных. Оно будет определяться тем, насколько эффективно мы преобразуем эти данные в понимание, которому люди, а все чаще и ИИ, могут доверять, на основе которого могут рассуждать и уверенно действовать. Это будущее, к которому стремится New Relic, слой за слоем внедряя интеллектуальные решения.
Даг Браун — менеджер по продуктовому маркетингу в New Relic, специализирующийся на AIOps и агентной наблюдаемости. Он тесно сотрудничает с командами по продуктам и разработке, помогая организациям повышать надежность, снижать операционную сложность и превращать данные наблюдаемости в практические результаты. Даг обладает глубоким опытом в области кибербезопасности, облачных платформ и операций на базе ИИ, а также увлечен переводом сложных технологий на понятный, ориентированный на клиента язык.
Мнения, выраженные в этом блоге, принадлежат автору и не обязательно отражают взгляды New Relic. Любые решения, предложенные автором, зависят от конкретной среды и не являются частью коммерческих решений или поддержки, предлагаемых New Relic. Пожалуйста, обращайтесь исключительно в Explorers Hub (support.newrelic.com) по вопросам и поддержке, связанным с этой публикацией в блоге. Этот блог может содержать ссылки на контент сторонних сайтов. Предоставляя такие ссылки, New Relic не принимает, не гарантирует, не одобряет и не поддерживает информацию, мнения или продукты, доступные на таких сайтах.