Оценка робототехнической фундаментальной модели в замкнутом цикле на Ray — это отработанный шаблон. Он включает в себя один сервис политики, симуляторы в качестве задач Ray и сотню запусков из одного скрипта. Мы описали это в статье «Масштабируемая оценка политики роботов с помощью Ray». Этот пост о том, что можно узнать, когда оценка становится настолько дешевой.
Мы берем замороженную VLA-политику (зрение-язык-действие), обученную на реальных данных — чекпоинт pi0.5 для складывания белья из LeRobot — и запускаем ее внутри физического двойника робота, на котором она обучалась. Затем мы используем этого двойника как инструмент. Мы проводим быстрые, контролируемые эксперименты, изменяя один параметр между запусками и измеряя, как меняются решения замороженной политики. Это позволяет ответить на два вопроса одновременно. На что на самом деле обращает внимание дообученная политика? И что именно должно быть правильно реализовано в симуляторе, конвейере сбора данных или синтетических данных, чтобы политика продолжала работать?
Механика здесь проста для демонстрации, но эффективна. Мы берем наблюдение, которое политика видела в двойнике, заменяем одно из трех его изображений на реальный кадр из той же фазы задачи, оставляем все остальное идентичным и подсчитываем, что планирует политика. Это позволило локализовать решение политики «поднять или отпустить» в нескольких сотнях пикселей на кончиках захватов ее наручных камер. Это подсказало нам, как должен выглядеть захват двойника. И это привело к нашим первым zero-shot результатам складывания рубашки замороженной VLA-политикой в симуляции, без реальных пикселей и без дообучения. Все исследование представляет собой одну программу на Ray, а наш блокнот воспроизводит его суть за шесть минут на четырех L4.
Ссылка: Проблема
У вас есть VLA-модель, которая работает на реальной установке. Вы перемещаете камеру или помещаете ее в симулятор, и она перестает работать, и никто не может сказать вам, какие пиксели имели значение. Дообучение на больших данных — обычный ответ, но он «слепой». В конечном счете, вы не знаете, что именно нужно собирать. Бенчмарки, такие как LIBERO-Plus, показывают сбой (изменения точки обзора или начального состояния снижают успех с 95% до менее чем 30%), но не причину Fu et al., 2025.
Ответом отрасли за последние восемнадцать месяцев было вскрытие «черного ящика» одним из двух способов. Работа на уровне активаций дает вам направление в 2000-мерном пространстве. Работа на уровне поведения в симуляторах дает вам коэффициент успеха. Ни то, ни другое не дает инженеру по оборудованию решения о том, куда поставить камеру, и ни то, ни другое не отвечает на вопрос, который первым задает инженер-симуляторщик: «что должно измениться в сцене, чтобы замороженная политика продолжала выполнять свою работу?». Для этого нужен контролируемый эксперимент. Эксперимент, который использует то же состояние, те же изображения и возможность изменить одну вещь, чтобы затем проанализировать, что делает политика. Реальный робот не может дать вам этого, потому что нет двух одинаковых сбросов. Что позволяет это сделать, так это физический двойник. Где в сети живет решение — это другой вопрос, и инструменты уровня активации — следующий шаг после появления двойника (см. ссылки в разделе «Дальнейшее чтение»).
Видео-двойники и сплэт-двойники не могут обеспечить такую контрфактическую проверку для ткани, потому что в них нет физики захвата. Более того, ничто не говорит вам, что делает ткань между захватами, когда рука поднимается. А стирка — это то место, где оценка жестких объектов перестает работать. У рубашки 25 000 степеней свободы, и каждый захват меняет ее форму. Поэтому мы создали физического двойника собственной установки этой политики, используя кадры из набора данных.
Ссылка: Настройка: замороженная pi0.5 и двойник ее собственной установки
Политика — это lerobot/folding_latest, pi0.5, дообученная LeRobot на реальном бимануальном складывании футболок OpenArm. Это 3B-параметрическая VLM PaliGemma с экспертом действий 300M flow-matching. Она видит три камеры (головная камера 640 x 480 и две наручные камеры 1280 x 720), 16-мерное состояние суставов и инструкцию «Сложи футболку правильно». Мы никогда не модифицируем и не дообучаем ее. Каждый вызов — это публичный чекпоинт в bf16.
Двойник — это Isaac Lab 3.0 с физическим движком Newton. Два манипулятора OpenArm — это артикуляции MJWarp из URDF поставщика. Напечатанные захваты и крышки LeRobot взяты из их опубликованных деталей. Три камеры набора данных были размещены путем подгонки их проекции к позициям пикселей, считанным вручную из кадров. Стол — их, а рубашка — это ткань Newton VBD с 25 610 узлами. Политика работает в замкнутом цикле на частоте 30 Гц, используя отрендеренные изображения и состояние суставов двойника. Ни один реальный пиксель никогда не попадает в наблюдение, которое потребляет запуск.
Есть один прокси, и он важен. Захват. Фрикционный зажим на симулированной ткани такой толщины не держится, и все опубликованные результаты симулированного складывания избегают этого так же, как и мы. Когда захват закрывается, узлы ткани между подушечками прикрепляются к раме захвата и переносятся. Наш метод добавляет складку захвата. Ткань, лежащая поперек открытых захватов, складывается в пучок между подушечками, потому что именно это должна видеть наручная камера (мы дойдем до того, почему). Зафиксированный захват всегда держится, поэтому двойник проверяет достижение, стратегию складывания и визуомоторный контроль, а не надежность захвата. Это предложение появляется в блокноте, где представлен прокси.
Ссылка: Архитектура: один сервис политики, три двойника, один блокнот
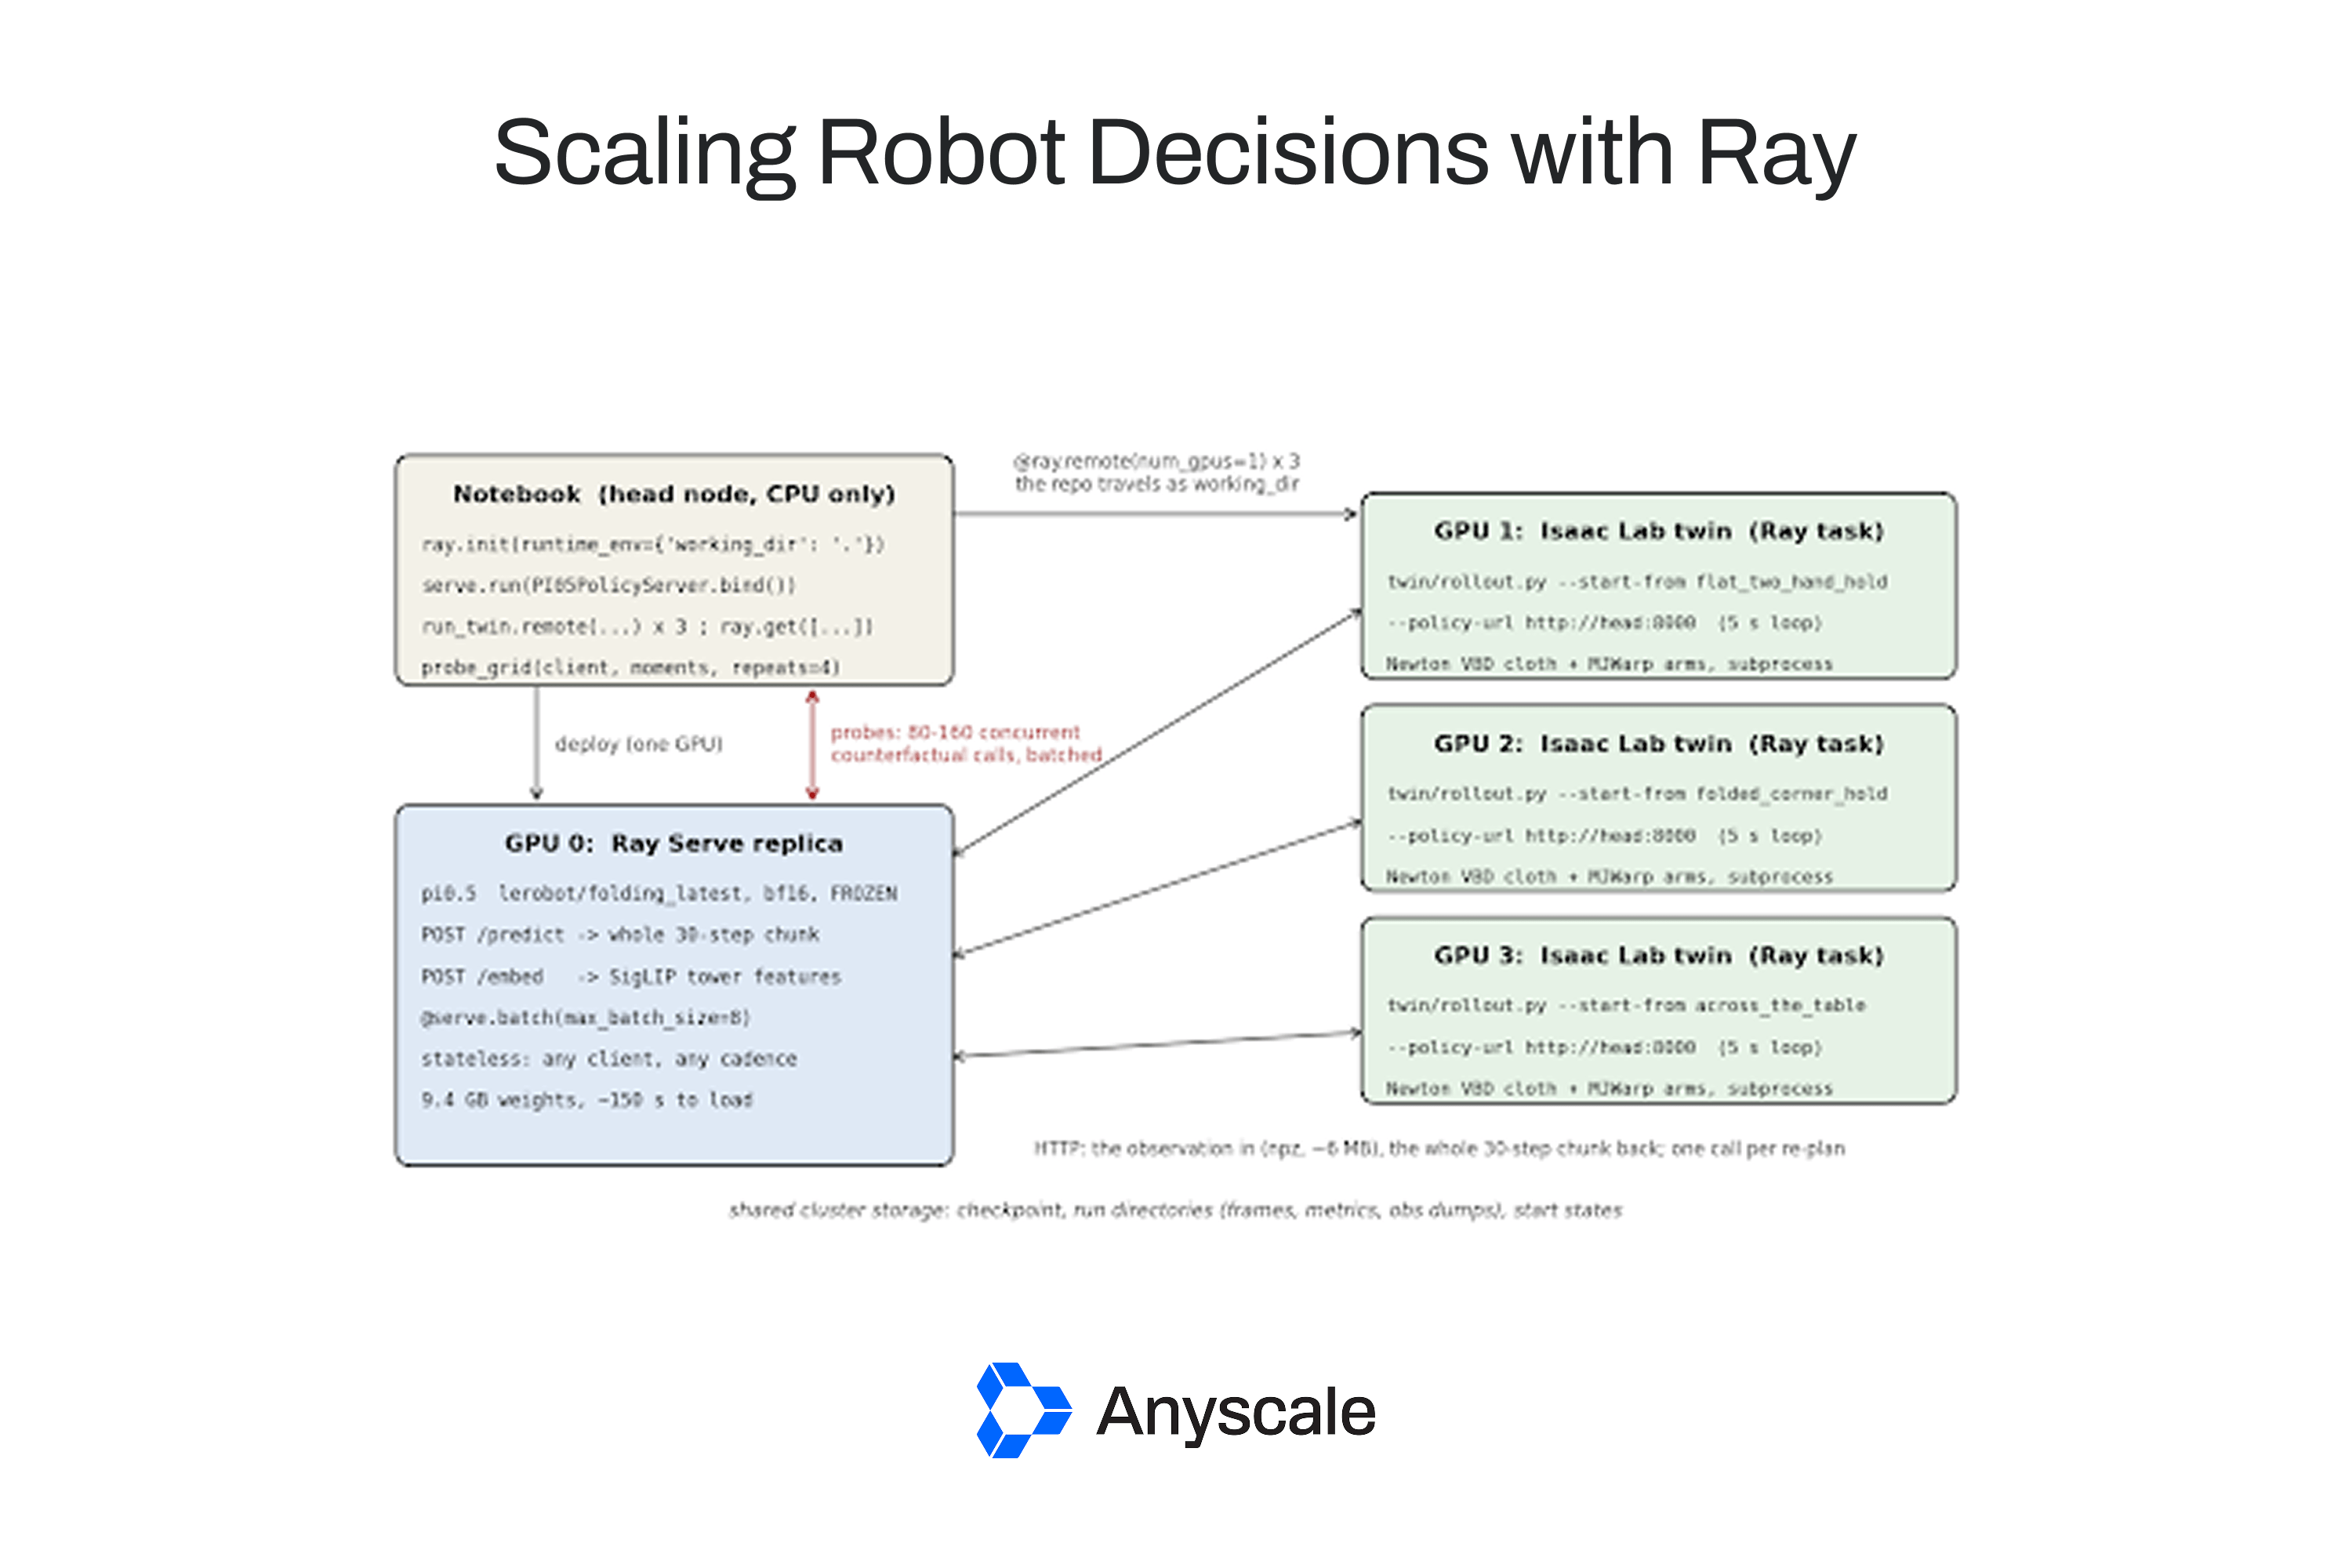
Все нижеперечисленное — это один блокнот на одном кластере. Сервис политики на одном GPU, три двойника на трех GPU и зонды как параллельные клиенты одного и того же сервиса. Архитектура взята из «Масштабируемой оценки политики роботов с помощью Ray», где более подробно объясняется, почему симулятор и политика не могут совместно использовать процесс или GPU. Кратко рассмотрим ниже:
Политика как сервис. Здесь реплика отвечает на каждый запрос полным чанком действий из 30 шагов и не хранит состояние для каждого клиента:
Чанки без сохранения состояния — это то, что позволяет многим клиентам использовать одну реплику. Каждый клиент сам применяет развернутый ритм (выполняет шаги с 3 по 18 чанка, затем делает повторный запрос, ровно то, что делал цикл внутри процесса). Параллельные вызовы, будь то от трех симуляторов или от зонда, выдающего восемьдесят запросов сразу, пакетируются через один прямой проход. Без общей реплики три симулятора загружали бы по 3B параметров на свой собственный GPU, а один 24 ГБ L4 не может вместить Isaac Sim, решатель ткани и политику вместе.
Двойники как задачи. Каждый двойник — это задача Ray, занимающая один GPU. Сам двойник работает как подпроцесс, потому что цикл событий Isaac Sim Kit не должен находиться внутри воркера Ray:
ray.init(runtime_env={"working_dir": "."}) отправляет весь репозиторий каждому воркеру, включая вендорного двойника, его активы и сохраненные состояния. max_retries=0 выбрано намеренно. Молча перезапущенный двойник перезапустился бы с нуля, перезаписывая свои собственные кадры.
Сохраненные состояния. Загрузка двойника стоит минуту или три (Kit, сцена USD, построение ткани, прогрев RTX). Установившаяся рубашка стоит еще двести шагов симуляции, а шаг управления этой тканью стоит около секунды физики на A100. Поэтому двойники в блокноте запускаются из сохраненных состояний, с точно восстановленными позициями узлов ткани, состоянием манипулятора, закрепленными узлами и гистерезисом захвата.
Захваты были выбраны потому, что обе руки были зафиксированы, что означает, что прокси-сервер прикрепил тканевые узлы к каждому захвату, а виды с запястий выглядели корректно на глаз. Более поздний, более строгий тест проверяет, действительно ли челюсть находилась над тканью в момент закрытия. Только левая челюсть проходит проверку в поставляемых состояниях. У правой руки узлы крепления были прикреплены с расстояния в несколько сантиметров, что допускает прокси, но не может сделать реальный захват. Это известная ошибка прокси-сервера контактов, и именно поэтому эти сегменты задействуют путь восстановления и общую реплику, но не являются доказательством захвата двумя руками.
Тот же скрипт также воспроизводит записанную последовательность действий (--replay-from actions.npy). Это цикл исследования с вариациями физики, двойное изменение, повторно протестированное на записанной траектории за восемь минут вместо тридцатиминутного развертывания политики. Воспроизведение — это не то, как были сделаны захваты. При работе с тканью из 25 000 узлов воспроизведение с разомкнутым контуром отклоняется от работы с замкнутым контуром в течение нескольких секунд, и первая попытка привела к тому, что закрепленные узлы отставали от челюсти на 17–46 см, что было отклонено правилом «челюсть на ткани».
Зонд. В сохраненный момент у нас есть точные входные данные, которые политика видела в двойнике. Мы заменяем одно изображение реальным кадром из той же фазы реальной задачи (эпизод 0 на 17,5–20 с, обе руки держат), сохраняем состояние и два других изображения такими, какими они были, и многократно опрашиваем сервис. Чтобы уточнить, что здесь означает «реальный», реальный кадр — это не та же поза или форма рубашки, что в момент с двойником. Идентично все остальное внутри момента, поэтому замена — единственное различие между условиями, а счетчики поглощают случайность сэмплера. Это несоответствие является ограничением, и именно поэтому на следующем шаге замена сужается до нескольких сотен пикселей на кончиках челюстей:
Каждый возвращенный фрагмент оценивается по двум показателям. Разжатие — это команда захвату на угол менее -20 градусов в любой точке фрагмента. Запланированный подъем — это высота руки по прямой кинематике не менее 20 см над столом в конце фрагмента без разжатия. Второе — это утверждение о плане политики, о том, что она дает команду поднять руку с обоими закрытыми захватами, а не о ткани. Фрагмент не может сказать вам, поднимется ли рубашка. Это измеряют только двойники с замкнутым контуром ниже. Считайте, а не полагайтесь на один вызов. Фрагмент pi0.5 — это выборка согласования потоков, и первый эксперимент в блокноте запрашивает один и тот же момент четыре раза и строит четыре разные траектории движения рук, иногда на расстоянии десятков сантиметров друг от друга. Правило исследования заключалось в получении не менее 12 выборок для каждого условия, прежде чем было написано какое-либо утверждение о политике.
Результаты ссылок: политика считывает кончики челюстей
Вот сетка для четырех захватов из конфигурации складывания (обе руки зафиксированы, с учетом оговорки о правой руке выше), 16 выборок на условие, из запуска блокнота для этого поста:
Читайте построчно. С собственными изображениями двойника политика отпускает (14 из 16 разжатий, 0 запланированных подъемов). Замените на реальный кадр с головной камеры, и ничего не изменится. Замените на оба реальных кадра с запястий, и вы получите 13 из 16 запланированных подъемов и ни одного разжатия. Замените только на реальный кадр с левого запястья, и левая рука никогда не разжимается (0 из 16), в то время как правая все еще разжимается (16 из 16). Замените только на правое запястье, и картина зеркально отражается (левая 16 из 16, правая 7 из 16). Собственный вид левой руки определяет левое разжатие. Цифры исследования по другим моментам совпадают. С запястьями двойника запланированные подъемы 0 из 16, а разжатия от 8 до 16 из 16. С реальными запястьями запланированные подъемы от 11 до 16 из 16, а разжатия от 0 до 3. Реальный кадр отличается от кадра двойника не только пучком, поэтому эта сетка лишь локализует решение на камерах запястий. Следующий эксперимент изолирует, что именно в кадре.
Что в кадре запястья? Реальный кадр при захвате показывает зажатый пучок ткани между кончиками челюстей. Кадр двойника показывал тонкую полоску. Возьмите реальный кадр и удалите только пучок (зазор), и запланированный подъем исчезнет (0 из 16 в запуске блокнота, 0 из 8 в исследовании). Оставьте только реальный фрагмент кончика челюсти, несколько сотен пикселей, внутри кадра двойника (realjaw), и он планирует подъемы так же, как полный реальный кадр (11 из 16 против 12 из 16, и 6 из 8 против 5 из 8 в исследовании). Тридцать вариантов рендеринга (освещение, материалы, камера, размытие, контраст) изменили расстояние энкодера менее чем на 0,03 (от 0,167 до 0,198 против 0,073 для реальных кадров), а 18 вариантов на уровне изображения, которые мы оценили по количеству подъемов (цвет, резкость, дисторсия объектива, кадрирование, силуэты челюстей, закрашенные зазоры и комки, формы ворса), планировали от 0 до 3 подъемов из 12 каждый, против 0–1 для неотредактированного кадра двойника. Реальный пучок, обесцвеченный, затемненный, размытый или сплющенный, все равно планировал от 9 до 12 из 12. Подсказка — это геометрия, а не текстура. Решение живет во фрагменте кончика челюсти, для каждой руки, и подсказка — это пучок ткани между подушечками.
Собственный энкодер политики подтверждает это детерминированно. Встройте кроп кончика челюсти с помощью визуальной башни SigLIP внутри pi0.5, выполните mean-pool и вычислите косинусное расстояние до реальных кадров захвата. Реальные кадры захвата в исследовании находятся на уровне 0,073, другие реальные моменты — от 0,09 до 0,15, наши рендеры — от 0,15 до 0,22. Кропы левого запястья в блокноте показывают: двойник 0,166, реальный 0,086, фрагмент кончика челюсти 0,089, пучок удален 0,166. По 65 вариантам изображений запястий с не менее чем 8 выборками каждое, это расстояние ранжирует показатели подъема вариантов с корреляцией Спирмена -0,82. Детерминированное число, которое предсказывает стохастический счет, — это то, что превращает сканирование в поиск. Блокнот вычисляет его через маршрут /embed той же реплики.
Две вещи, которые нужно извлечь из сетки. Одна геометрическая подсказка решила больше, чем тридцать вариантов рендеринга, поэтому проверяйте, что считывает политика, прежде чем платить за точность. Более того, собственный энкодер политики дает детерминированное расстояние, которое ранжирует варианты, поэтому поиск может выполняться без развертывания.
От поиска к складыванию: что изменилось в двойнике
Этот вывод является одновременно фактом оборудования и фактом двойника. Складка-зажим у челюстей существует благодаря этому. Ткань, лежащая поперек открытых челюстей, при закрытии захвата складывается в пучок между подушечками, и камера запястья затем видит то же, что и реальная. Еще два изменения произошли в результате наблюдения, а не зондирования. Ткань не должна двигаться сама по себе. Смоделированная рубашка может трястись без руки рядом с ней. Ее 25 000 узлов сидят на жестких пружинах и перемещаются итеративным решателем с ограниченным количеством итераций, что оставляет остаточную ошибку на каждом подшаге. При достаточно жестких пружинах этот остаток резонирует на собственных частотах сетки, а не затухает, и именно численное демпфирование и крючки rest-sleep удаляют его. Изменение жесткости, из-за которого рукава и воротник колебались со скоростью 12–15 мм/с, было отклонено именно по этой причине. Медианная скорость узла в поставляемой конфигурации составляет 0,0 мм/с, и каждый запуск записывает это, поэтому утверждение измерено, а не определено на глаз. А геометрия и планировка стола взяты из их видеозаписей, а не со стенда.
При такой конфигурации: одна политика, один «двойник» (twin), 42 запуска (seeds) по 120 или 150 секунд, 41 успешный. Обе руки зафиксированы, расправление и выравнивание происходят во всех 41 запуске, где ни одна рука не прошла сквозь стол (этот порог проверяется в каждом запуске; единственный сбой относится к двум запускам вне стола). Момент складывания (площадь проекции 0,70 или менее от площади расправленной рубашки) достигнут в 21 случае. Складка сохраняется в конце в 10 случаях. Рубашка была стянута с ближнего края стола в 2 случаях. Блокнот пересчитывает таблицу на основе сводок по каждому запуску с указанием правила рядом. Правило, основанное только на метриках, дает 22, 11 и 2, а визуальная оценка в исследовании определила одно конечное состояние как смятое. В лучшем запуске рубашка складывается пополам в интервале от 100 до 119 секунд, а типы сбоев представлены в равной степени.
Лучший из 42 запусков (fwsafe_s9) в виде пяти кадров с головной камеры от 0 до 120 с. Правая рука складывает рубашку пополам в интервале от 100 до 119 с.
Несколько слов о том, что такое «подъем» (lift). В экспериментах со стопкой рука поднималась на 30–50 см, в то время как зафиксированная ткань оставалась на столе. Высота руки — это не перенос. Каждый график в блокноте накладывает высоту руки на долю подъема ткани и площадь проекции, а фраза «политика выполнила подъем» всегда относится только к ткани.
Результат: многодневное исследование как одна программа Ray
Это основа статьи, поэтому вот отчет. Многодневное исследование, стоящее за этими цифрами, представляло собой одну программу на одном узле с 8 GPU. Каждый прогон, каждое сканирование подстановок и каждая метрика были задачей Ray, запущенной из одной оболочки с упаковкой working_dir. Это дало нам 42 запуска и десятки вариантов «двойников» за ночь, а воспроизведенная последовательность действий сократила цикл физических вариаций с тридцати минут до восьми. Блокнот использует те же три примитива в учебном масштабе. Один реплика Ray Serve на одном L4 содержит политику. Три «двойника» Isaac Lab на остальных трех L4 работают как задачи, запрашивающие ее по HTTP. Зонды подстановки являются параллельными клиентами той же реплики, и каждый GPU освобождается по завершении своей фазы. Этап оценки выполнил сотню прогонов одной политики. Здесь тот же тип сервиса отвечает на несколько сотен контрфактических запросов и запускает «двойников» по требованию за те же шесть минут на машине для разработки.
Измерено в коде нашего примера блокнота (машина для разработки 8 x A100, с бюджетом для работы на 4 x L4):
Две детали инфраструктуры позволили уложиться в бюджет. Реплика пакетирует параллельные запросы, поэтому восемьдесят вызовов зондов занимают секунды, а не минуты, как потребовали бы восемьдесят последовательных выборок модели с 3 млрд параметров. А «двойники» не делают шагов, пока сервис не ответит на /stats, поэтому загрузка весов, три запуска Kit и зонды перекрываются по времени.
Что это значит для вашей собственной политики
Вывод о кончиках челюстей (jaw-tip) специфичен для этой контрольной точки и этой установки. Способ, которым мы его получили, — нет, и это главный вывод. Прежде чем собирать больше данных, строить симулятор или генерировать синтетические кадры для дообучения, вы можете спросить политику, что она «видит», с помощью нескольких сотен дешевых запросов к обслуживаемой реплике, и позволить цифрам принять решение. Из этого опыта здесь вытекают четыре общих урока, и Ray делает это простым.
Проверяйте, на что обращает внимание политика, прежде чем тратить ресурсы на точность. Тридцать вариантов рендерера ничего не изменили, а один геометрический признак изменил всё. Поканальная подстановка подсказывает вам, какие входные данные несут основное решение, а собственный энкодер политики дает вам детерминированное расстояние для поиска, прежде чем вы заплатите за фотореалистичную сцену или еще одну неделю телеуправления.
Пусть результат определяет приоритеты симулятора и конвейера данных. То, что «читает» политика, — это то, что «двойник» должен воспроизвести правильно и что должны содержать симуляционные или синтетические данные. Для этой политики это то, что видит наручная камера на кончиках челюстей. Для вашей это может быть другая камера, другой фрагмент или канал состояния. Тот же стиль зондирования поможет это найти.
Знайте, что ваш «двойник» может подтвердить. Наш подтверждает достижение, захват и расправление, но пока не может подтвердить взятие из стопки, потому что симулятор ткани не может переносить ткань из стопки. У каждого «двойника» есть такая граница, и зондирование вместе с прогонами с обратной связью показывают, где она находится, чтобы вы знали, каким сбоям в симуляции можно доверять, а какие нужно переносить на реальную установку.
Измерьте базовый уровень перед дообучением. Статистика запусков по одной конфигурации с напечатанным рядом правилом — это число, которое должно превзойти дообучение. Без них фраза «теперь работает лучше» — это просто анекдот.
Ничего из этого не требует конкретного ответа, который нашли мы. Это требует замороженной политики за сервисом, симулятора, который можно запустить как задачу, и цикла, достаточно дешевого, чтобы работать всю ночь.
Запуск на Anyscale
Вместе с этой записью в блоге прилагается запускаемый блокнот, «двойник» со всеми ресурсами, сохраненные захваты, дампы наблюдений, инструментарий зондирования как переиспользуемый инструмент для любой политики LeRobot, таблица из 42 запусков и видео. SETUP.md содержит конфигурацию вычислений Anyscale, которая запускает это примерно за шесть минут на четырех A100. Тот же блокнот работает на восьми A100 при изменении конфигурации, а не кода. Контрольная точка публична. Вам понадобится собственный токен Hugging Face для ограниченного токенизатора PaliGemma.
Вывод о кончиках челюстей и видео складывания — это то, что вы получаете, когда такая рабочая нагрузка становится дешевой для итераций. Замороженная политика с 3 млрд параметров, запрашиваемая десятки тысяч раз, симулятор ткани, запускаемый по требованию, и научный цикл, достаточно быстрый, чтобы работать всю ночь, как одна программа на одном кластере.
Дополнительное чтение
- Масштабирование оценки робототехнических политик с помощью Ray, архитектура, на которой строится эта статья.
Масштабирование оценки робототехнических политик с помощью Ray, архитектура, на которой строится эта статья.
- Конвейеры «зрение-язык-действие» на Ray.
Конвейеры «зрение-язык-действие» на Ray.
- Проект складывания LeRobot, huggingface.co/spaces/lerobot/robot-folding, и контрольная точка .
Проект складывания LeRobot, , и контрольная точка .
- Рецензировано. Häon et al., CoRL 2025 (управление pi0 и OpenVLA через разреженные направления активации). Zhang et al., ICML 2026 (интервенционная атрибуция «зрение-действие»). Li et al., SIMPLER, CoRL 2024 (оценка «реальность-в-симуляцию»).
Рецензировано. (управление pi0 и OpenVLA через разреженные направления активации). (интервенционная атрибуция «зрение-действие»). (оценка «реальность-в-симуляцию»).
- Препринты, цитируемые как таковые. Buurmeijer et al. 2026. Shi et al. (VLA-Trace) 2026. Kim and Park (IMPACT-VLA) 2026. Jin et al. 2026. Bhardwaj et al. 2026. Liao and Cao 2026 по замороженным VLA. Fu et al. (LIBERO-Plus) 2025. Zhang et al. 2025 (splat-двойники мягких тел). Abou-Chakra et al. 2025 (Real-is-Sim).
Препринты, цитируемые как таковые. Buurmeijer et al. 2026. Shi et al. (VLA-Trace) 2026. Kim and Park (IMPACT-VLA) 2026. Jin et al. 2026. Bhardwaj et al. 2026. по замороженным VLA. Fu et al. (LIBERO-Plus) 2025. Zhang et al. 2025 (splat-двойники мягких тел). Abou-Chakra et al. 2025 (Real-is-Sim).
- Сигналы индустрии. Honda Research Institute's embodied-intelligence research role (механистическая интерпретируемость среди желаемых специализаций). Goodfire Silico для робототехники и зрения.
Сигналы индустрии. (механистическая интерпретируемость среди желаемых специализаций). Goodfire Silico для робототехники и зрения.